Técnicas de preprocesamiento para datos anotados de visión artificial#
El preprocesamiento de datos convierte imágenes sin procesar y anotadas en entradas limpias y coherentes que un modelo de visión artificial necesita para entrenarse correctamente. Con Ultralytics YOLO26, las operaciones esenciales sobre los píxeles —conversión a RGB, escalado a [0, 1] y cambio de tamaño— se ejecutan automáticamente en el proceso de entrenamiento. Por tanto, lo que queda es dividir correctamente el conjunto de datos, equilibrar las clases y elegir las transformaciones. Esta guía trata las técnicas esenciales: cambio de tamaño, normalización, división de conjuntos de datos, aumento de datos y análisis exploratorio de datos (EDA).
Ver: Cómo usar el preprocesamiento y el aumento de datos para mejorar la precisión de los modelos en situaciones reales 🚀
Este paso viene después de definir los objetivos del proyecto y recopilar y anotar los datos, y se sitúa al principio del flujo de trabajo de un proyecto de visión artificial.
Por qué es importante el preprocesamiento#
El preprocesamiento adapta los datos a un formato que reduce la carga computacional y mejora el rendimiento del modelo. Permite abordar tres problemas habituales de los datos sin procesar:
- Ruido: Variaciones irrelevantes o aleatorias en los datos.
- Incoherencia: Variaciones en el tamaño, el formato y la calidad de las imágenes.
- Desequilibrio: Distribución desigual de clases o categorías en el conjunto de datos.
Técnicas de preprocesamiento#
Las principales técnicas son el cambio de tamaño, la normalización, la división del conjunto de datos y el aumento de datos. Con YOLO26, las dos primeras son automáticas, mientras que la división y el aumento son las decisiones que más importan.
Cambio de tamaño de las imágenes#
Muchos modelos requieren un tamaño de entrada uniforme, por lo que cambiar el tamaño de las imágenes las homogeneiza y reduce la complejidad computacional. Dos métodos de interpolación habituales son:
- Interpolación bilineal: Suaviza los valores de los píxeles calculando una media ponderada de los cuatro píxeles más cercanos.
- Vecino más cercano: Copia el valor del píxel más cercano sin calcular la media; es más rápido, pero genera una imagen más pixelada.
Bibliotecas como OpenCV y PIL (Pillow) ofrecen estas funciones, pero con YOLO26 normalmente no tienes que cambiar el tamaño manualmente. El argumento imgsz se encarga de ello. En el flujo de tamaño cuadrado fijo, la validación y la inferencia ajustan las imágenes con letterboxing a una entrada imgsz × imgsz, como 640 × 640, preservando la relación de aspecto y añadiendo relleno gris (valor 114). Las imágenes más grandes se reducen para ajustarse, mientras que las más pequeñas no se amplían si se desactiva el escalado. En el flujo de entrenamiento predeterminado, mosaic=1.0 coloca cuatro imágenes en un lienzo más grande y recorta el resultado a imgsz; cuando close_mosaic desactiva Mosaic durante las últimas épocas, las imágenes se ajustan con letterboxing y después se transforman aleatoriamente, en lugar de pasar directamente sin cambios. Los lotes rectangulares (rect=True) y multi_scale utilizan formas de entrada distintas.
Normalización de los valores de píxel#
La normalización escala los valores de los píxeles a un intervalo estándar, lo que ayuda al modelo a converger más rápido durante el entrenamiento. Dos técnicas habituales son:
- Escalado mín.-máx.: Escala los valores de los píxeles a un intervalo de 0 a 1.
- Normalización Z-score: Escala los valores de los píxeles en función de su media y desviación estándar.
YOLO26 gestiona la normalización automáticamente como parte de su proceso de preprocesamiento: convierte las imágenes a RGB y escala los valores de los píxeles al intervalo [0, 1] dividiéndolos por 255 (escalado mín.-máx.). YOLO no aplica por defecto una normalización de media y desviación estándar al estilo de ImageNet (Z-score), así que no hace falta ningún paso de normalización manual.
División del conjunto de datos#
Dividir los datos en conjuntos de entrenamiento, validación y prueba te permite evaluar el modelo con datos que no ha visto y medir su capacidad de generalización. Una división habitual destina el 70 % al entrenamiento, el 20 % a la validación y el 10 % a las pruebas. Herramientas como scikit-learn o TensorFlow facilitan este proceso.
Ten en cuenta estos aspectos al dividir los datos:
- Mantén la distribución de clases: Asegúrate de que cada clase esté representada proporcionalmente en los conjuntos de entrenamiento, validación y prueba.
- Equilibra las clases: Si los conjuntos de datos están desequilibrados, plantéate sobremuestrear la clase minoritaria o reducir el muestreo de la clase mayoritaria, únicamente en el conjunto de entrenamiento.
Divide el conjunto de datos antes de aplicar cualquier aumento u otro preprocesamiento, y aplica esas transformaciones únicamente al conjunto de entrenamiento. Si aumentas los datos antes de dividirlos, la información de las imágenes de validación o prueba influirá en el entrenamiento y generará puntuaciones engañosamente altas que se desplomarán con datos del mundo real.
Aumento del conjunto de datos#
El aumento de datos incrementa artificialmente el tamaño de un conjunto de datos mediante la creación de versiones modificadas de las imágenes existentes. Ayuda a reducir el sobreajuste y mejora la generalización, además de ofrecer varias ventajas:
- Modelos más robustos: Las variaciones de iluminación, orientación y escala hacen que el modelo resista mejor las distorsiones del mundo real.
- Rentable: Amplías el conjunto de entrenamiento sin recopilar ni etiquetar datos nuevos.
- Mejor aprovechamiento de los datos: Cada imagen anotada proporciona varias variaciones de entrenamiento.
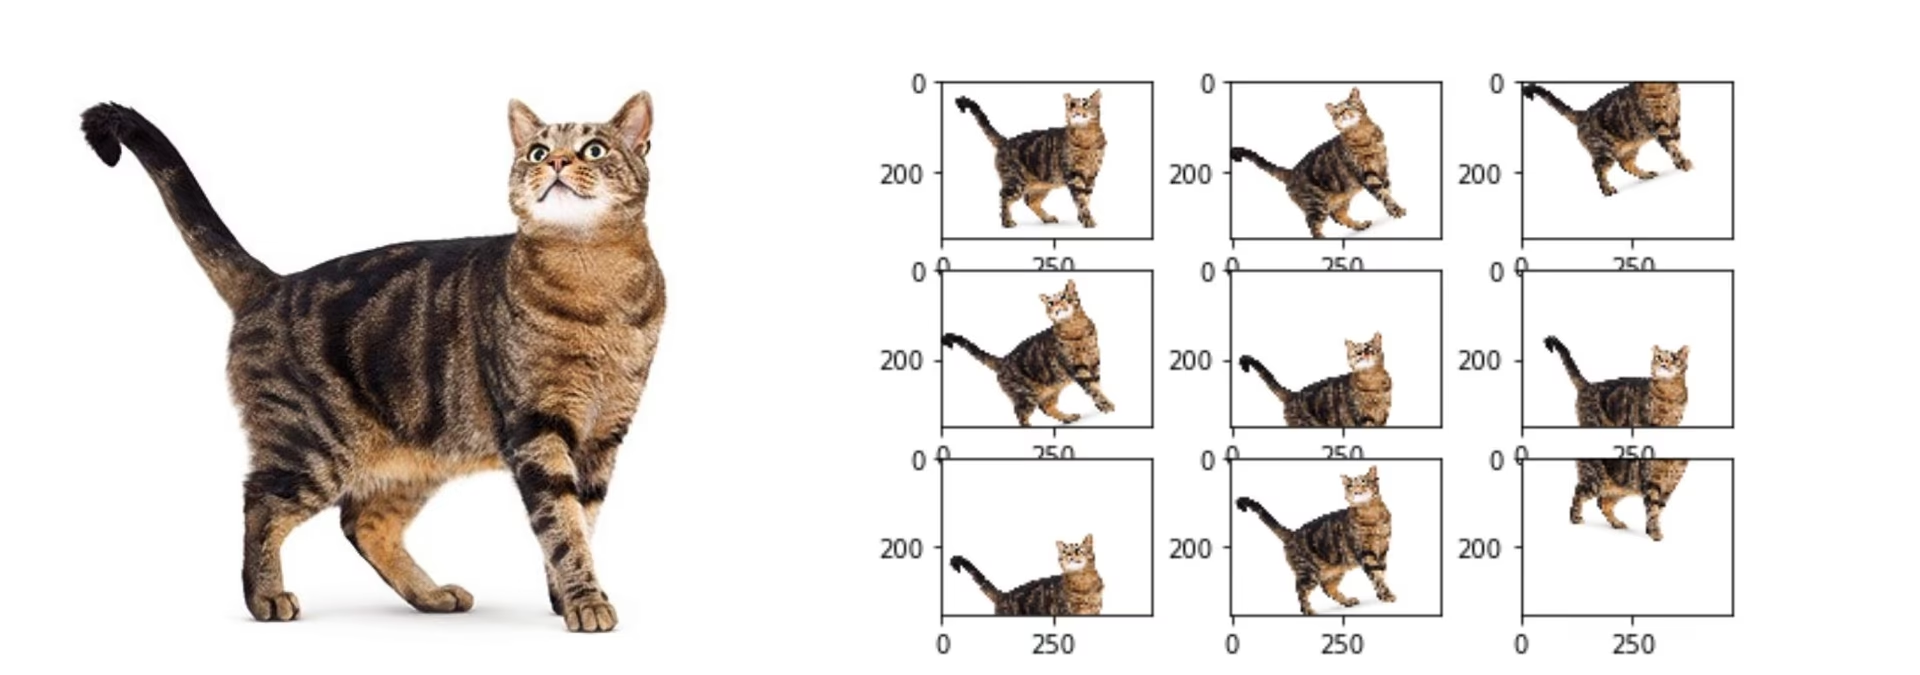
Con YOLO26, la intensidad del aumento se controla mediante los argumentos de entrenamiento que se pasan a model.train() o las opciones equivalentes de la CLI, no editando el YAML del conjunto de datos, que define sus metadatos, como las rutas, los nombres de las clases y las divisiones. La única excepción es flip_idx: los conjuntos de datos de pose lo declaran en el YAML del conjunto de datos para asignar pares de puntos clave izquierdo/derecho, y YOLO desactiva por completo fliplr y flipud si falta. Los aumentos integrados incluyen:
- Mosaic, MixUp y CutMix (
mosaic,mixup,cutmix): Combina varias imágenes en una muestra de entrenamiento. - Volteos (
fliplr,flipud): Refleja las imágenes horizontal o verticalmente. - Transformaciones geométricas (
degrees,translate,scale,shear,perspective): Gira, desplaza, amplía y deforma las imágenes. - Variación de color HSV (
hsv_h,hsv_s,hsv_v): Varía el tono, la saturación y el brillo. - Copiar y pegar (
copy_paste): Pega copias adicionales de objetos segmentados, reflejados por defecto dentro de la misma imagen o tomados de otra imagen mediantecopy_paste_mode=mixup. - Intercambio de canales (
bgr): Cambia el orden de los canales RGB a BGR. - Transformaciones de clasificación (
auto_augment,erasing): Aplica una política automática de aumento de datos y borrado aleatorio al entrenar un clasificador.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# El aumento de datos se configura con argumentos de entrenamiento, no en el YAML del conjunto de datos
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)
Para consultar la lista completa de argumentos de aumento de datos y sus valores predeterminados, consulta la referencia de configuración de aumento de datos y la guía de aumento de datos de YOLO. Si está instalado el paquete albumentations, YOLO también activa automáticamente sus aumentos integrados basados en Albumentations.
Caso práctico: preprocesamiento para la detección de vehículos#
Imagina un proyecto para detectar y clasificar vehículos en imágenes de tráfico con YOLO26, a partir de imágenes anotadas con cuadros delimitadores y etiquetas. Estas son las decisiones de preprocesamiento:
- Cambio de tamaño: No hace falta hacerlo manualmente; YOLO26 cambia el tamaño a
imgszdurante el entrenamiento. - Normalización: No hace falta hacerlo manualmente; YOLO26 escala automáticamente los valores de los píxeles a
[0, 1]. - División: Divide el conjunto de datos en un 70 % para entrenamiento, un 20 % para validación y un 10 % para pruebas, manteniendo una distribución de clases coherente en todas las divisiones.
- Aumento de datos: Configura argumentos de entrenamiento adecuados para escenas de tráfico; por ejemplo,
fliplrpara la invariancia a la dirección,hsv_vpara la iluminación diurna y nocturna, ymosaicpara distintas densidades de objetos.
Una vez tomadas estas decisiones, el conjunto de datos estará listo para el análisis exploratorio de datos (EDA).
Análisis exploratorio de datos (EDA)#
El EDA utiliza estadísticas y visualizaciones para revelar patrones y distribuciones en los datos, lo que te ayuda a detectar problemas como el desequilibrio de clases o los valores atípicos antes del entrenamiento.
Técnicas estadísticas de EDA#
El EDA estadístico empieza con métricas básicas —media, mediana, desviación estándar y rango— calculadas sobre propiedades como las distribuciones de intensidad de píxeles. Estas métricas ofrecen una visión rápida de la calidad del conjunto de datos y permiten detectar irregularidades desde el principio.
Técnicas visuales de EDA#
Las visualizaciones revelan patrones que las estadísticas resumidas no muestran, como el desequilibrio de clases y los valores atípicos. Algunas herramientas habituales son:
- Histogramas y diagramas de caja: Muestran la distribución de los valores de los píxeles y señalan valores atípicos en las distribuciones de intensidad o características.
- Gráficos de barras: Revelan el desequilibrio de clases al comparar el número de ejemplos de cada clase.
- Diagramas de dispersión: Permiten explorar las relaciones entre características de las imágenes o anotaciones.
- Mapas de calor: Representan las distribuciones de intensidad de píxeles o la distribución espacial de las anotaciones en las imágenes.
Ultralytics Platform para EDA#
Para realizar EDA sin código, sube tu conjunto de datos a Ultralytics Platform. La pestaña Charts del conjunto de datos genera automáticamente visualizaciones clave de EDA: distribución de las divisiones, recuento de las clases principales, histogramas de anchura y altura de las imágenes y mapas de calor 2D de las posiciones de las anotaciones y las dimensiones de las imágenes. La pestaña Images te permite explorar los datos en vistas de cuadrícula, compacta o de tabla, con superposiciones de anotaciones; así podrás detectar fácilmente ejemplos mal etiquetados o clases desequilibradas sin escribir código.
Conclusión#
Dividir, normalizar y aumentar correctamente los datos reduce el ruido y mejora la generalización, y convierte una colección de imágenes sin procesar en un conjunto de entrenamiento fiable. Una vez preprocesado el conjunto de datos, el siguiente paso es entrenar el modelo. Si te surgen dudas, pregunta a la comunidad en el repositorio de Ultralytics en GitHub o en el servidor de Ultralytics en Discord.
Preguntas frecuentes#
El preprocesamiento garantiza que los datos estén limpios, sean coherentes y tengan un formato optimizado para el entrenamiento. Al abordar el ruido, la incoherencia y el desequilibrio de clases de los datos sin procesar, técnicas como el cambio de tamaño, la normalización, el aumento de datos y la división del conjunto de datos reducen la carga computacional y mejoran el rendimiento del modelo. Consulta las etapas de un proyecto de visión artificial para ver cómo encaja en el flujo de trabajo general.
Configura el aumento de datos mediante argumentos de entrenamiento, no en el YAML del conjunto de datos. Pasa argumentos como
fliplr,mosaic,hsv_hydegreesamodel.train()(o las opciones equivalentes de la CLI) para configurar la probabilidad y la intensidad de cada transformación. Estos argumentos se definen en la configuración de aumento de datos y se explican en la guía de aumento de datos de YOLO. Los conjuntos de datos de pose son la excepción: la asignación de puntos claveflip_idxse incluye en el YAML del conjunto de datos, y los volteos se desactivan si falta.Las dos técnicas más habituales son el escalado mín.-máx. (que reescala los píxeles a un intervalo de 0 a 1) y la normalización Z-score (que los reescala en función de la media y la desviación estándar). YOLO26 aplica automáticamente el escalado mín.-máx.: convierte las imágenes a RGB y divide los valores de píxel por 255, así que no necesitas normalizarlos manualmente. Por defecto, no aplica la normalización Z-score.
Una práctica habitual es destinar el 70 % al entrenamiento, el 20 % a la validación y el 10 % a las pruebas. Mantén la distribución de clases en las tres divisiones y evita la fuga de datos aplicando el aumento de datos únicamente al conjunto de entrenamiento después de dividirlo. Herramientas como scikit-learn o TensorFlow gestionan la división de forma eficiente. Consulta la guía de recopilación y anotación de datos para obtener información sobre la preparación previa del conjunto de datos.
Sí. El argumento
imgszcontrola el tamaño de entrada objetivo sin que tengas que hacer nada manualmente. En el flujo de tamaño cuadrado fijo, la validación y la inferencia ajustan las imágenes con letterboxing a la forma especificada, preservando la relación de aspecto; las imágenes más grandes se reducen para ajustarse, mientras que las más pequeñas no se amplían si se desactiva el escalado. Durante el entrenamiento, el aumento Mosaic predeterminado alcanza el tamaño objetivo colocando cuatro imágenes en un mosaico y recortándolo. Los lotes rectangulares (rect=True) ymulti_scaleutilizan formas de entrada distintas. Consulta la documentación de entrenamiento de modelos para obtener más detalles.