Comprender los pasos clave de un proyecto de visión artificial#
Desarrollar un proyecto de visión artificial implica seguir una secuencia clara de etapas: definir los objetivos, recopilar y anotar datos, entrenar y evaluar un modelo e implementarlo y mantenerlo en producción. Esta guía explica cada paso en orden y por qué es importante, para que puedas planificar y llevar a cabo tu propio proyecto con confianza.
La visión artificial es una subdisciplina de la inteligencia artificial (AI) que ayuda a los ordenadores a ver y comprender el mundo como lo hacen las personas. Procesa y analiza imágenes o vídeos para extraer información, reconocer patrones y tomar decisiones basadas en esos datos.
Las técnicas de visión artificial, como la detección de objetos, la clasificación de imágenes y la segmentación de instancias, se pueden aplicar en diversos sectores, desde la conducción autónoma hasta la imagen médica, para obtener información valiosa.
Descripción general de un proyecto de visión artificial#
Antes de analizar en detalle cada paso de un proyecto de visión artificial, veamos el proceso general. Si empezaras hoy un proyecto de visión artificial, seguirías estos pasos:
- Tu primera prioridad es comprender los requisitos de tu proyecto.
- Después, recopila y etiqueta con precisión las imágenes que ayudarán a entrenar tu modelo.
- A continuación, limpia y amplía tus datos para prepararlos para el entrenamiento del modelo.
- Después del entrenamiento, evalúa y prueba el modelo a fondo para asegurarte de que rinde de forma constante en distintas condiciones.
- Por último, implementa el modelo en el mundo real y supervísalo y mantenlo según los nuevos conocimientos y comentarios.
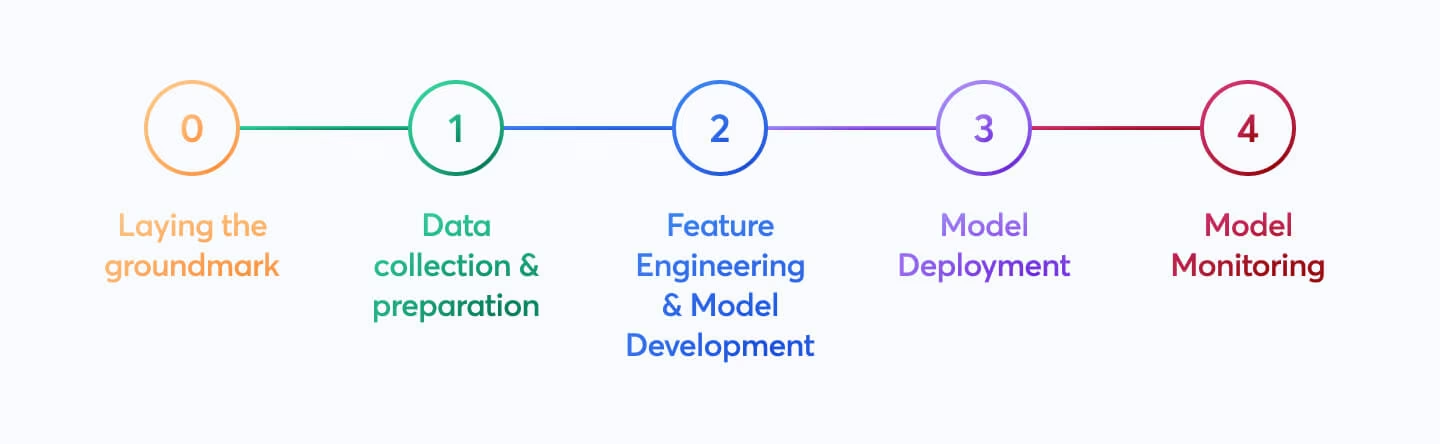
Ahora que ya sabemos qué esperar, veamos los pasos y pongamos en marcha tu proyecto.
Paso 1: Definir los objetivos de tu proyecto#
El primer paso de cualquier proyecto de visión artificial es definir claramente el problema que intentas resolver. Conocer el objetivo final te ayuda a empezar a crear una solución. Esto es especialmente importante en visión artificial, porque el objetivo de tu proyecto influirá directamente en la tarea de visión artificial en la que debes centrarte.
Estos son algunos ejemplos de objetivos de proyecto y de las tareas de visión artificial que pueden utilizarse para alcanzarlos:
-
Objetivo: Desarrollar un sistema capaz de vigilar y gestionar el flujo de distintos tipos de vehículos en autopistas para mejorar la gestión del tráfico y la seguridad.
- Tarea de visión artificial: La detección de objetos es ideal para vigilar el tráfico porque localiza e identifica varios vehículos de forma eficiente. Requiere menos recursos computacionales que la segmentación de imágenes, que proporciona detalles innecesarios para esta tarea, y permite realizar análisis más rápidos en tiempo real.
-
Objetivo: Desarrollar una herramienta que ayude a los radiólogos proporcionándoles contornos precisos, a nivel de píxel, de los tumores en imágenes médicas.
- Tarea de visión artificial: La segmentación de imágenes es adecuada para el diagnóstico por imagen, ya que proporciona límites precisos y detallados de los tumores, fundamentales para evaluar su tamaño y forma, y planificar el tratamiento.
-
Objetivo: Crear un sistema digital que clasifique distintos documentos (p. ej., facturas, recibos y documentos legales) para mejorar la eficiencia organizativa y la recuperación de documentos.
- Tarea de visión artificial: La clasificación de imágenes es ideal en este caso, ya que procesa un documento cada vez sin tener que considerar la posición del documento en la imagen. Este enfoque simplifica y agiliza el proceso de clasificación.
Seleccionar el modelo adecuado y el enfoque de entrenamiento#
Una vez que entiendas el objetivo del proyecto y las tareas de visión artificial adecuadas, una parte esencial para definir el objetivo del proyecto es seleccionar el modelo adecuado y el enfoque de entrenamiento.
Según el objetivo, puedes elegir el modelo primero o después de ver qué datos puedes recopilar en el paso 2. Por ejemplo, supongamos que tu proyecto depende en gran medida de la disponibilidad de tipos de datos específicos. En ese caso, puede ser más práctico recopilar y analizar los datos antes de seleccionar un modelo. Por otro lado, si tienes claros los requisitos del modelo, puedes elegir primero el modelo y, a continuación, recopilar datos que se ajusten a esas especificaciones.
Elegir entre entrenar desde cero o usar transferencia de aprendizaje influye en cómo preparas tus datos. Entrenar desde cero requiere un conjunto de datos diverso para que el modelo desarrolle su comprensión desde el principio. La transferencia de aprendizaje, en cambio, te permite usar un modelo preentrenado y adaptarlo con un conjunto de datos más pequeño y específico. Además, elegir un modelo concreto para entrenarlo determinará cómo debes preparar tus datos, por ejemplo, cambiando el tamaño de las imágenes o añadiendo anotaciones según los requisitos específicos del modelo.
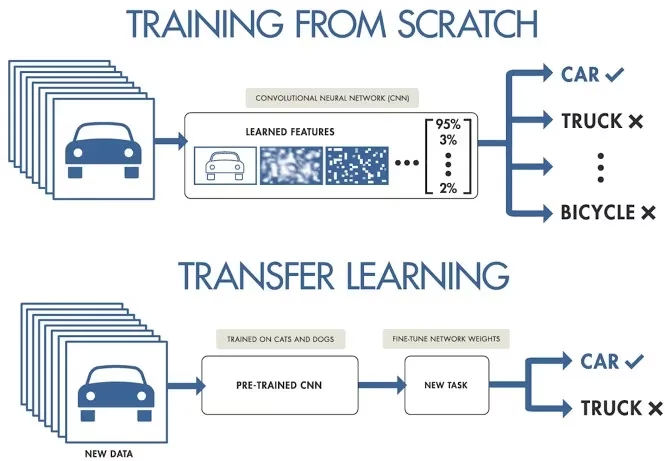
Ten en cuenta el destino de despliegue de un modelo para garantizar la compatibilidad y el rendimiento. Por ejemplo, los modelos ligeros son ideales para la computación en el borde gracias a su eficiencia en dispositivos con recursos limitados.
Para obtener más información, lee nuestra guía sobre cómo definir los objetivos de tu proyecto y seleccionar el modelo adecuado.
Antes de empezar a trabajar en un proyecto de visión artificial, es importante tener claros estos detalles. Antes de pasar al paso 2, comprueba que hayas tenido en cuenta lo siguiente:
- Define claramente el problema que intentas resolver.
- Determina el objetivo final de tu proyecto.
- Identifica la tarea de visión artificial específica que necesitas (p. ej., detección de objetos, clasificación de imágenes o segmentación de imágenes).
- Decide si vas a entrenar un modelo desde cero o a usar transferencia de aprendizaje.
- Selecciona el modelo adecuado para tu tarea y tus necesidades de despliegue.
Paso 2: Recopilación y anotación de datos#
La calidad de tus modelos de visión artificial depende de la calidad de tu conjunto de datos. Puedes recopilar imágenes de Internet, hacer tus propias fotos o usar conjuntos de datos existentes. Aquí tienes algunos recursos excelentes para descargar conjuntos de datos de alta calidad: Google Dataset Search Engine, UC Irvine Machine Learning Repository y Kaggle Datasets.
Algunas bibliotecas, como Ultralytics, ofrecen compatibilidad integrada con diversos conjuntos de datos, lo que facilita empezar a trabajar con datos de alta calidad. Estas bibliotecas suelen incluir utilidades para usar fácilmente conjuntos de datos populares, lo que puede ahorrarte mucho tiempo y esfuerzo en las primeras fases del proyecto.
Sin embargo, si decides recopilar imágenes o hacer tus propias fotos, tendrás que anotar los datos. La anotación de datos es el proceso de etiquetar tus datos para transmitir conocimientos a tu modelo. El tipo de anotación con el que trabajarás depende de la técnica específica de visión artificial que uses. Aquí tienes algunos ejemplos:
- Clasificación de imágenes: Etiquetarás toda la imagen con una sola clase.
- Detección de objetos: Dibujarás cajas delimitadoras alrededor de cada objeto de la imagen y etiquetarás cada caja.
- Segmentación de imágenes: Etiquetarás cada píxel de la imagen según el objeto al que pertenezca, creando límites detallados para los objetos.
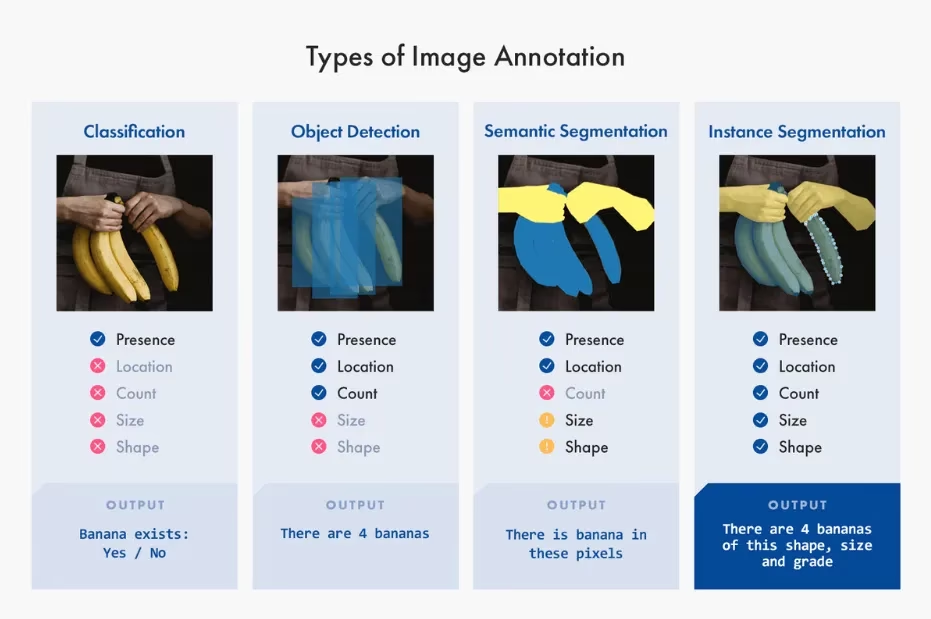
La recopilación y anotación de datos puede requerir mucho trabajo manual y tiempo. Una herramienta de anotación específica agiliza el proceso: Ultralytics Platform ofrece un editor de anotaciones integrado con anotación inteligente basada en SAM para datos de detección, segmentación y OBB, y guarda las etiquetas directamente en formato YOLO.
Paso 3: Aumento de datos y división del conjunto de datos#
Después de recopilar y anotar los datos de imagen, es importante dividir primero el conjunto de datos en conjuntos de entrenamiento, validación y prueba antes de realizar el aumento de datos. Dividir el conjunto de datos antes del aumento es fundamental para probar y validar el modelo con datos originales sin modificar. Esto ayuda a evaluar con precisión lo bien que el modelo generaliza a datos nuevos que no ha visto.
Así puedes dividir los datos:
- Conjunto de entrenamiento: Es la parte más grande de tus datos, normalmente entre el 70 y el 80 % del total, que se utiliza para entrenar el modelo.
- Conjunto de validación: Suele representar entre el 10 y el 15 % de tus datos; se utiliza para ajustar los hiperparámetros y validar el modelo durante el entrenamiento, lo que ayuda a evitar el sobreajuste.
- Conjunto de prueba: El 10-15 % restante de tus datos se reserva como conjunto de prueba. Se utiliza para evaluar el rendimiento del modelo con datos que no ha visto una vez finalizado el entrenamiento.
Después de dividir los datos, puedes realizar un aumento de datos aplicando transformaciones como rotar, cambiar la escala y voltear las imágenes para ampliar artificialmente el conjunto de datos. El aumento de datos hace que el modelo sea más robusto ante las variaciones y mejora su rendimiento con imágenes que no ha visto.
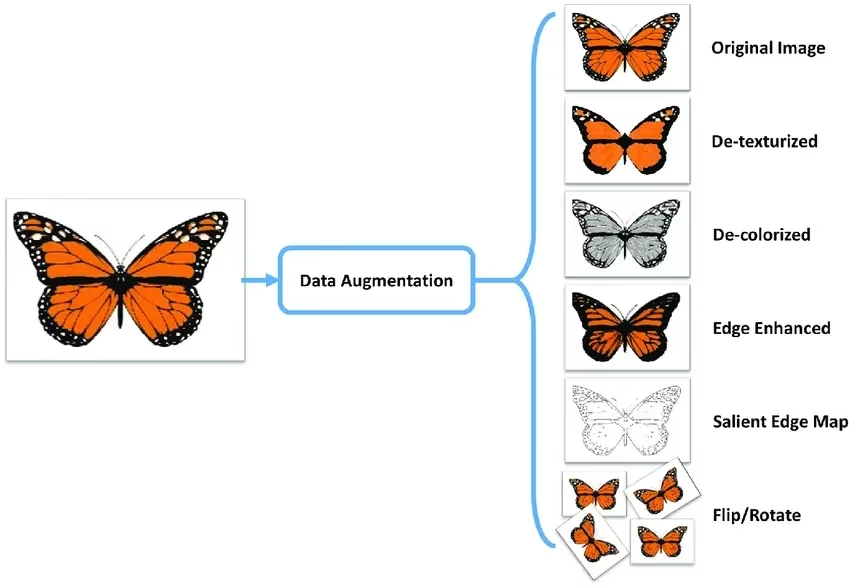
Bibliotecas como OpenCV, Albumentations y TensorFlow ofrecen funciones de aumento flexibles que puedes usar. Además, algunas bibliotecas, como Ultralytics, incluyen ajustes de aumento integrados directamente en su función de entrenamiento del modelo, lo que simplifica el proceso.
Para conocer mejor tus datos, puedes usar herramientas como Matplotlib o Seaborn para visualizar las imágenes y analizar su distribución y características. Visualizar los datos ayuda a identificar patrones, anomalías y la eficacia de las técnicas de aumento. La pestaña Charts de Ultralytics Platform puede mostrarte muchos de estos datos sin necesidad de escribir código, ya que genera automáticamente la distribución de las divisiones, los recuentos por clase, los histogramas de dimensiones de imagen y los mapas de calor de la posición de las anotaciones para cada conjunto de datos que subas.
Si comprendes, divides y aumentas tus datos correctamente, podrás desarrollar un modelo bien entrenado, validado y probado que rinda bien en aplicaciones del mundo real.
Paso 4: Entrenamiento del modelo#
Cuando el conjunto de datos esté listo para el entrenamiento, puedes centrarte en configurar el entorno necesario, gestionar los conjuntos de datos y entrenar el modelo.
En primer lugar, tendrás que asegurarte de que el entorno esté configurado correctamente. Por lo general, esto incluye lo siguiente:
- Instalar bibliotecas y marcos de trabajo esenciales, como TensorFlow, PyTorch o Ultralytics.
- Si usas una GPU, instalar bibliotecas como CUDA y cuDNN ayudará a habilitar la aceleración por GPU y agilizar el proceso de entrenamiento.
A continuación, puedes cargar los conjuntos de datos de entrenamiento y validación en el entorno. Normaliza y preprocesa los datos cambiando el tamaño, convirtiendo el formato o aplicando aumentos. Una vez seleccionado el modelo, configura las capas y especifica los hiperparámetros. Compila el modelo definiendo la función de pérdida, el optimizador y las métricas de rendimiento.
Bibliotecas como Ultralytics simplifican el proceso de entrenamiento. Puedes empezar a entrenar introduciendo datos en el modelo con un mínimo de código. Estas bibliotecas gestionan automáticamente los ajustes de pesos, la propagación hacia atrás y la validación. También ofrecen herramientas para supervisar el progreso y ajustar fácilmente los hiperparámetros. Una vez terminado el entrenamiento, guarda el modelo y sus pesos con unos pocos comandos.
Es importante recordar que una gestión adecuada del conjunto de datos es fundamental para un entrenamiento eficiente. Usa el control de versiones para los conjuntos de datos con el fin de hacer un seguimiento de los cambios y garantizar la reproducibilidad. Herramientas como DVC (Control de versiones de datos) pueden ayudar a gestionar conjuntos de datos grandes.
Paso 5: Evaluación y ajuste fino del modelo#
Es importante evaluar el rendimiento del modelo con distintas métricas y perfeccionarlo para mejorar la precisión. La evaluación ayuda a identificar los aspectos en los que el modelo destaca y aquellos que podrían necesitar mejoras. El ajuste fino garantiza que el modelo esté optimizado para ofrecer el mejor rendimiento posible.
- Métricas de rendimiento: Usa métricas como la exactitud, la precisión, la exhaustividad y la puntuación F1 para evaluar el rendimiento del modelo. Estas métricas permiten saber hasta qué punto el modelo realiza predicciones correctamente.
- Ajuste de hiperparámetros: Ajusta los hiperparámetros para optimizar el rendimiento del modelo. Técnicas como la búsqueda en cuadrícula o la búsqueda aleatoria pueden ayudar a encontrar los mejores valores de hiperparámetros.
- Ajuste fino: Realiza pequeños cambios en la arquitectura del modelo o en el proceso de entrenamiento para mejorar el rendimiento. Esto puede implicar ajustar las tasas de aprendizaje, los tamaños de lote u otros parámetros del modelo.
Para profundizar en las técnicas de evaluación y ajuste fino de modelos, consulta nuestra guía de análisis de evaluación de modelos.
Paso 6: Pruebas del modelo#
Las pruebas del modelo confirman que funciona bien con datos completamente nuevos y verifican que esté listo para el despliegue. La diferencia entre las pruebas y la evaluación del modelo es que las pruebas se centran en verificar el rendimiento del modelo final, en lugar de mejorarlo de forma iterativa.
Es importante probarlo a fondo y depurar los problemas habituales que puedan surgir. Prueba el modelo con un conjunto de datos de prueba independiente que no se haya usado durante el entrenamiento ni la validación. Este conjunto de datos debe representar situaciones del mundo real para garantizar que el rendimiento del modelo sea constante y fiable.
Además, aborda problemas habituales como el sobreajuste, el subajuste y la fuga de datos. Usa técnicas como la validación cruzada y la detección de anomalías para identificar y resolver estos problemas. Para conocer estrategias de prueba exhaustivas, consulta nuestra guía de pruebas de modelos.
Paso 7: Despliegue del modelo#
Cuando hayas probado el modelo a fondo, será el momento de desplegarlo. El despliegue del modelo consiste en ponerlo a disposición para su uso en un entorno de producción. Estos son los pasos para desplegar un modelo de visión artificial:
- Configuración del entorno: Configura la infraestructura necesaria para la opción de despliegue que hayas elegido, ya sea en la nube (AWS, Google Cloud, Azure) o en el borde (dispositivos locales, IoT).
- Exportación del modelo: Exporta el modelo al formato adecuado (p. ej., ONNX, TensorRT o CoreML para YOLO26) para garantizar la compatibilidad con la plataforma de despliegue.
- Despliegue del modelo: Despliega el modelo configurando API o puntos de conexión e integrándolo en tu aplicación.
- Garantía de escalabilidad: Implementa balanceadores de carga, grupos de escalado automático y herramientas de supervisión para gestionar los recursos y atender el aumento de datos y solicitudes de usuarios.
Para obtener instrucciones más detalladas sobre estrategias de despliegue y prácticas recomendadas, consulta nuestra guía de prácticas de despliegue de modelos. Ultralytics Platform también ofrece puntos de conexión de despliegue gestionados, con escalado automático en 42 regiones de todo el mundo y configuración automática de la infraestructura.
Paso 8: Supervisión, mantenimiento y documentación#
Una vez desplegado el modelo, es importante supervisar continuamente su rendimiento, mantenerlo para resolver cualquier problema y documentar todo el proceso para futuras consultas y mejoras.
Las herramientas de supervisión pueden ayudarte a hacer un seguimiento de los indicadores clave de rendimiento (KPIs) y detectar anomalías o caídas en la precisión. Al supervisar el modelo, puedes detectar la deriva del modelo, por la que su rendimiento disminuye con el tiempo debido a cambios en los datos de entrada. Vuelve a entrenar periódicamente el modelo con datos actualizados para mantener su precisión y relevancia.
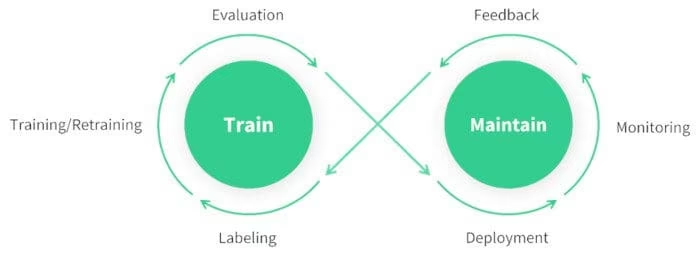
Además de la supervisión y el mantenimiento, la documentación también es fundamental. Documenta a fondo todo el proceso, incluida la arquitectura del modelo, los procedimientos de entrenamiento, los hiperparámetros, los pasos de preprocesamiento de datos y cualquier cambio realizado durante el despliegue y el mantenimiento. Una buena documentación garantiza la reproducibilidad y facilita las actualizaciones futuras o la resolución de problemas. Si supervisas, mantienes y documentas el modelo de forma eficaz, podrás garantizar que siga siendo preciso, fiable y fácil de gestionar durante todo su ciclo de vida.
Participación en la comunidad#
Conectar con una comunidad de entusiastas de la visión artificial puede ayudarte a afrontar con confianza cualquier problema que encuentres al trabajar en tu proyecto de visión artificial. Aquí tienes algunas formas de aprender, resolver problemas y establecer contactos de forma eficaz.
Recursos de la comunidad#
- Problemas de GitHub: Consulta el repositorio de YOLO26 en GitHub y usa la pestaña Issues para hacer preguntas, informar de errores y proponer nuevas funciones. La activa comunidad y las personas responsables del mantenimiento están ahí para ayudarte con problemas concretos.
- Servidor de Discord de Ultralytics: Únete al servidor de Discord de Ultralytics para interactuar con otros usuarios y desarrolladores, recibir ayuda y compartir conocimientos.
Documentación oficial#
- Documentación de Ultralytics YOLO26: Consulta la documentación oficial de YOLO26 para acceder a guías detalladas con consejos útiles sobre distintas tareas y proyectos de visión artificial.
Usar estos recursos te ayudará a superar los retos y a estar al día de las últimas tendencias y prácticas recomendadas de la comunidad de visión artificial.
Próximos pasos#
Ahora tienes una hoja de ruta para cada etapa de un proyecto de visión artificial, desde la definición de objetivos hasta la supervisión de un modelo desplegado. Ponla en práctica entrenando tu primer modelo YOLO o profundiza en cualquiera de las etapas con las guías enlazadas más arriba. Para ejecutar todo el flujo de trabajo sin escribir código, explora Ultralytics Platform.
Preguntas frecuentes#
La elección de la tarea de visión artificial adecuada depende del objetivo final de tu proyecto. Por ejemplo, si quieres supervisar el tráfico, la detección de objetos es adecuada porque puede localizar e identificar varios tipos de vehículos en tiempo real. Para el diagnóstico por imagen, la segmentación de imágenes es ideal porque proporciona límites detallados de los tumores, lo que ayuda en el diagnóstico y la planificación del tratamiento. Obtén más información sobre tareas específicas como la detección de objetos, la segmentación de instancias, la segmentación semántica y la clasificación de imágenes.
La anotación de datos es esencial para enseñar al modelo a reconocer patrones. El tipo de anotación varía según la tarea:
- Clasificación de imágenes: Toda la imagen se etiqueta con una sola clase.
- Detección de objetos: Se dibujan cajas delimitadoras alrededor de los objetos.
- Segmentación de imágenes: Cada píxel se etiqueta según el objeto al que pertenece.
El editor de anotaciones integrado en Ultralytics Platform puede ayudarte con este proceso. Para obtener más información, consulta nuestra guía de recopilación y anotación de datos.
Dividir el conjunto de datos antes del aumento ayuda a validar el rendimiento del modelo con datos originales sin modificar. Sigue estos pasos:
- Conjunto de entrenamiento: entre el 70 y el 80 % de tus datos.
- Conjunto de validación: entre el 10 y el 15 % para el ajuste de hiperparámetros.
- Conjunto de prueba: el 10-15 % restante para la evaluación final.
Después de dividir los datos, aplica técnicas de aumento de datos como la rotación, el cambio de escala y el volteo para aumentar la diversidad del conjunto de datos. Bibliotecas como Albumentations y OpenCV pueden ayudarte. Ultralytics también ofrece ajustes de aumento integrados para mayor comodidad.
Exporta el modelo entrenado con el método
exporty elige un formato que se ajuste al destino de despliegue. Ultralytics es compatible con varios formatos, entre ellos ONNX, TensorRT y CoreML. Para exportar tu modelo YOLO26, sigue estos pasos:- Usa el método
exportcon el parámetro del formato que quieras. - Asegúrate de que el modelo exportado cumpla las especificaciones del entorno de despliegue (p. ej., dispositivos en el borde o la nube).
Para obtener más información, consulta la guía de exportación de modelos.
- Usa el método
La supervisión y el mantenimiento continuos son esenciales para el éxito de un modelo a largo plazo. Implementa herramientas para hacer un seguimiento de los indicadores clave de rendimiento (KPIs) y detectar anomalías. Vuelve a entrenar periódicamente el modelo con datos actualizados para contrarrestar la deriva del modelo. Documenta todo el proceso, incluida la arquitectura del modelo, los hiperparámetros y los cambios, para garantizar la reproducibilidad y facilitar futuras actualizaciones. Obtén más información en nuestra guía de supervisión y mantenimiento.