Distillation des connaissances#
Démarrage rapide#
Entraîne un modèle étudiant plus petit en le guidant à l'aide d'un modèle enseignant plus grand, en ajoutant l'argument distill_model :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
Qu'est-ce que la distillation des connaissances ?#
La distillation des connaissances transfère les connaissances d'un modèle enseignant volumineux et précis vers un modèle étudiant plus petit. Le modèle étudiant apprend à imiter les représentations internes des caractéristiques du modèle enseignant et obtient souvent une meilleure précision qu'un entraînement à partir de zéro.
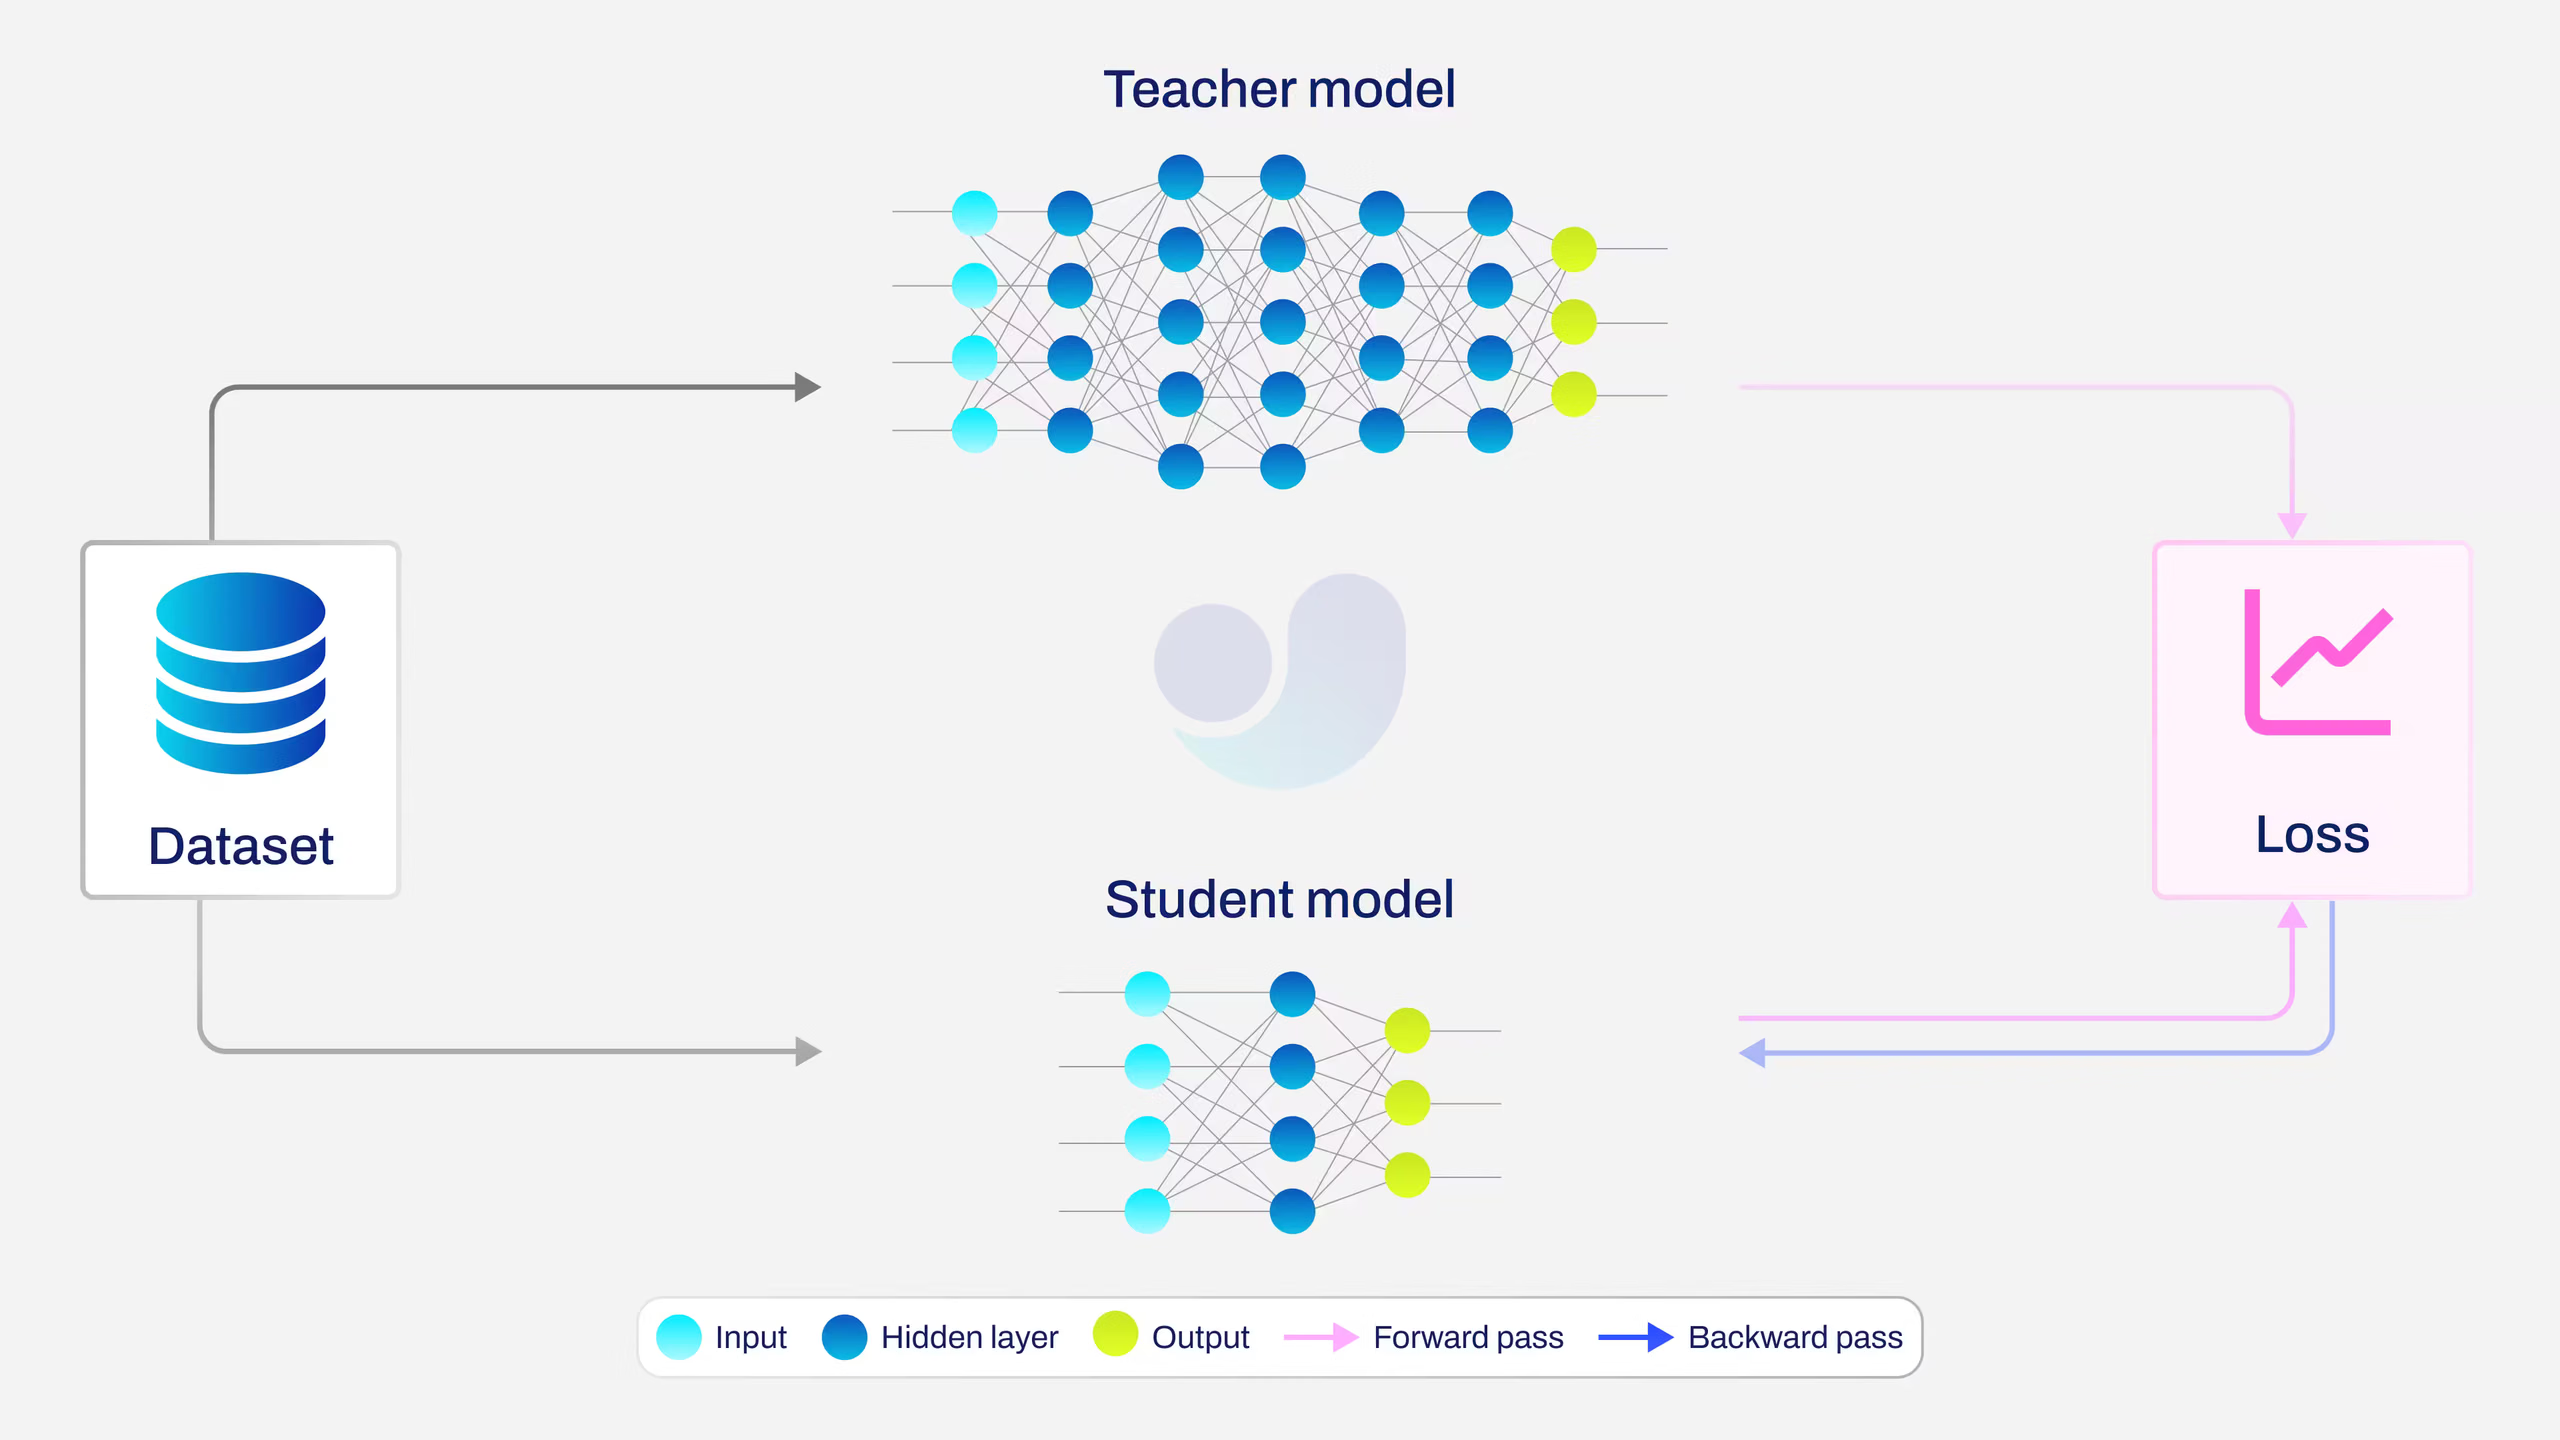
Utilise la distillation si :
- Tu as besoin d'un modèle plus petit et plus rapide pour le déploiement
- Tu disposes d'un modèle enseignant très précis, entraîné sur les mêmes données
- Tu veux obtenir une meilleure précision que celle offerte par un entraînement standard
La distillation des connaissances est implémentée pour les tâches detect, segment, pose et obb. Pour le moment, seule la tâche detect a fait l'objet d'une validation expérimentale des gains de précision.
Performances#
La distillation des connaissances améliore le mAP étudiant pour toute la famille YOLO26 sur COCO, sans coût d'inférence supplémentaire. Le tableau ci-dessous compare les modèles YOLO26 standard (référence) aux mêmes modèles entraînés par distillation à partir de leur modèle enseignant recommandé.
| Modèle | taille (pixels) | mAPval 50-95 référence | mAPval 50-95 distillé | mAPval 50-95 (e2e) référence | mAPval 50-95 (e2e) distillé |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- Les valeurs de mAPval correspondent à une évaluation à échelle unique avec un seul modèle sur le jeu de données COCO val2017.
Reproduis une ligne avec distillation à l'aide deyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0; ajoutenms=Falsepour la colonne e2e. - Les valeurs e2e utilisent le chemin d'inférence sans NMS (
nms=False) ; les valeurs non-e2e utilisent le post-traitement NMS par défaut (nms=None). Consulte Détection de bout en bout pour plus de détails.
Prérequis#
Avant de commencer, vérifie que tu remplis les conditions suivantes :
- Modèle enseignant entraîné : un point de contrôle
.ptde la même famille YOLO que le modèle étudiant. - Tâche identique : utilise un modèle enseignant pour la même tâche que le modèle étudiant et entraîne-le sur des données pertinentes.
- Ressources GPU : suffisamment de mémoire pour héberger les deux modèles ; le modèle enseignant effectue uniquement la passe avant, sans gradient ni état de l'optimiseur.
Paires de modèles recommandées#
| Modèle étudiant | Modèle enseignant recommandé |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
La distillation entre familles différentes (par exemple, un modèle enseignant YOLO11 avec un modèle étudiant YOLO26) n'est pas prise en charge.
Paramètres clés#
| Paramètre | Type | Valeur par défaut | Description |
|---|---|---|---|
distill_model | str | None | Chemin d'accès au fichier du modèle enseignant (par exemple, yolo26x.pt). Sa définition active la distillation des connaissances. |
dis | float | 6.0 | Poids de la fonction de perte de distillation. Il détermine la contribution de cette perte à la perte totale d'entraînement. |
Fonctionnement#
- Le modèle enseignant reste figé en mode
evalet exécute l'inférence sur chaque lot - Le modèle étudiant est entraîné avec les fonctions de perte standard de la tâche et les indications issues de la distillation
- Les caractéristiques sont extraites des deux modèles au niveau des trois couches du col qui alimentent la tête de la famille Detect
- Un projecteur composé de deux convolutions 1×1 avec ReLU adapte chaque carte de caractéristiques de l'étudiant aux canaux du modèle enseignant
- Une perte L2 pondérée par le score compare les caractéristiques projetées de l'étudiant à celles du modèle enseignant, en fonction du niveau de confiance de classification du modèle enseignant
- La perte de distillation est combinée aux pertes standard à l'aide du poids
dis
flowchart TD
    A[Input Image Batch]:::start --> T[Teacher Model<br/>frozen, eval mode]:::extern
    A --> S[Student Model<br/>trainable]:::proc

    T --> |Detect head inputs| TF[Teacher Features]:::extern
    S --> |Detect head inputs| SF[Student Features]:::proc

    SF --> P[1×1 Conv Projector<br/>with ReLU]:::decide
    P --> AF[Aligned Student Features]:::proc

    TF --> SW[Score-weighted L2 Loss]:::proc
    AF --> SW

    S --> D[Detection Head]:::proc
    D --> DL[box_loss + cls_loss + l1_loss]:::proc

    SW --> |× dis| DIS[distillation loss]:::proc
    DL --> TOTAL[Total Loss]:::out
    DIS --> TOTAL

    TOTAL --> BP[Backpropagate<br/>Student + Projector only]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
    classDef out fill:#9C27B0,color:#fff
    classDef extern fill:#607D8B,color:#fff
Prise en charge des tâches#
L'implémentation de la distillation extrait les caractéristiques des trois couches du col qui alimentent la tête de la famille Detect du modèle. Comme les têtes segment, pose et obb héritent de la même architecture Detect, la distillation est également compatible avec ces tâches.
La classification, la segmentation sémantique, l'estimation de profondeur et RT-DETR n'utilisent pas de tête compatible avec la famille Detect et ne sont pas pris en charge.
Seule la tâche detect a été évaluée et validée expérimentalement. Tu peux lancer la distillation pour segment, pose ou obb, mais les gains de précision pour ces tâches n'ont pas encore été validés.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")Entraînement#
Entraînement de base#
L'entraînement avec distillation est identique à l'entraînement standard. Fournis le chemin distill_model pour l'activer :
from ultralytics import YOLO

# Charger un modèle étudiant
student = YOLO("yolo26m.pt")

# Entraîner avec la distillation des connaissances à partir d'un modèle enseignant plus grand
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Ajuster le poids de la perte de distillation#
Le paramètre dis (valeur par défaut : 6.0) détermine la contribution de la perte de distillation :
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Reprendre l'entraînement avec distillation#
L'entraînement avec distillation permet de reprendre à partir de points de contrôle. Le modèle enseignant est automatiquement reconstruit à partir du chemin distill_model enregistré dans le point de contrôle :
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
Sortie de l'entraînement#
Lorsque la distillation est activée, une colonne dis_loss supplémentaire apparaît dans les journaux d'entraînement :
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
Le modèle exporté ne contient que les poids du modèle étudiant : sa taille et sa vitesse d'inférence sont identiques à celles d'un modèle étudiant entraîné normalement.
FAQ#
- Vérifie que le modèle enseignant et le modèle étudiant appartiennent à la même génération YOLO
- Vérifie que le chemin
distill_modelest correct et que le fichier se charge - Essaie d'augmenter
dissi la valeur de la perte est très faible - Vérifie que le modèle enseignant a été entraîné sur le même jeu de données
Ajoute le paramètre
distill_model: tout le reste fonctionne de la même manière. Une perte de distillation supplémentaire est calculée pendant l'entraînement, mais le modèle enregistré reste un modèle YOLO standard, sans surcoût.Oui. Le modèle enseignant effectue une passe avant pour chaque lot ; le surcoût en temps et en mémoire dépend donc de la paire de modèles enseignant et étudiant. Le modèle enseignant fonctionne en mode
eval, sans gradient ni état de l'optimiseur.La distillation des connaissances fonctionne avec les tâches detect, segment, pose et obb, car elle distille les caractéristiques des trois couches du col qui alimentent la tête de la famille Detect. Classify, semantic, depth et RT-DETR ne sont pas pris en charge.
Seul le mode detect a été vérifié expérimentalement pour confirmer des améliorations de précision. Les modes segment, pose et obb sont techniquement compatibles, mais n'ont pas encore été évalués.
Le modèle enseignant et le modèle étudiant doivent appartenir à la même famille YOLO (par exemple, YOLOv8, YOLO11 ou YOLO26). La distillation entre familles différentes (par exemple, un modèle enseignant YOLO11 avec un modèle étudiant YOLO26) n'est pas prise en charge.