Maintenir tes modèles de vision par ordinateur après leur déploiement#
Surveiller et maintenir un modèle de vision par ordinateur consiste à suivre en continu ses prédictions pour repérer la dérive des données et les baisses de précision, à le réentraîner avec des données récentes lorsque ses performances se dégradent, et à documenter chaque changement afin de garantir la reproductibilité du travail. C’est la dernière étape d’un projet de vision par ordinateur, après avoir défini les besoins, annoté les données, entraîné le modèle et l’avoir déployé. C’est ce qui permet au modèle de continuer à répondre aux objectifs de ton projet une fois en production.
À regarder : Comment maintenir les modèles de vision par ordinateur après leur déploiement | Détection de la dérive des données
Dans ce guide, nous allons examiner de plus près comment maintenir tes modèles de vision par ordinateur après leur déploiement. Nous verrons comment la surveillance des modèles peut t’aider à détecter rapidement les problèmes, à maintenir la précision et l’actualité de ton modèle, et pourquoi la documentation est importante pour le dépannage.
Surveillance des modèles#
Il est essentiel de surveiller de près tes modèles de vision par ordinateur déployés. Sans surveillance adéquate, les modèles peuvent perdre en précision. Un problème courant est le décalage de la distribution des données, ou dérive des données, qui se produit lorsque les données rencontrées par le modèle diffèrent de celles utilisées pour son entraînement. Si le modèle doit effectuer des prédictions sur des données qu’il ne reconnaît pas, cela peut entraîner des interprétations erronées et de mauvaises performances. Les valeurs aberrantes, c’est-à-dire les points de données inhabituels, peuvent également nuire à la précision du modèle.
La surveillance régulière des modèles aide les développeurs à suivre les performances du modèle, à repérer les anomalies et à résoudre rapidement les problèmes comme la dérive des données. Elle aide également à gérer les ressources en indiquant quand des mises à jour sont nécessaires, en évitant les refontes coûteuses et en maintenant la pertinence du modèle.
Bonnes pratiques pour la surveillance des modèles#
Voici quelques bonnes pratiques à garder à l’esprit lorsque tu surveilles ton modèle de vision par ordinateur en production :
- Suivre régulièrement les performances : Surveille en continu les performances du modèle afin de détecter leur évolution dans le temps.
- Vérifier la qualité des données : Recherche les valeurs manquantes ou les anomalies dans les données.
- Utiliser des sources de données variées : Surveille les données provenant de diverses sources afin d’obtenir une vue d’ensemble des performances du modèle.
- Combiner les techniques de surveillance : Combine des algorithmes de détection de dérive et des approches fondées sur des règles pour repérer un large éventail de problèmes.
- Surveiller les entrées et les sorties : Surveille à la fois les données traitées par le modèle et les résultats qu’il produit afin de vérifier que tout fonctionne correctement.
- Configurer des alertes : Configure des alertes en cas de comportement inhabituel, comme une baisse des performances, afin de pouvoir prendre rapidement des mesures correctives.
Surveillance avec Ultralytics Platform#
Ultralytics Platform intègre la surveillance des modèles pour les points de terminaison YOLO déployés. Tu peux ainsi surveiller ton modèle en production sans mettre en place une pile de surveillance distincte. Le tableau de bord Deploy suit en temps réel les principaux indicateurs :
- Métriques des requêtes : Volume total des requêtes, taux d’erreur et latence P95 pour chaque point de terminaison, avec des tendances sur 24 heures sous forme de graphiques en courbes dans le tableau de bord et des plages allant d’une heure à 30 jours via l’API de métriques.
- Vérifications de l’état : Vérifications de l’état des points de terminaison qui signalent les déploiements défaillants et indiquent la latence des réponses.
- Journaux : Journaux de requêtes filtrés par niveau de gravité (de DEBUG à CRITICAL) pour diagnostiquer les requêtes ayant échoué et les pics de latence.
- Vue globale : Une carte du monde interactive et des cartes récapitulatives qui présentent tous les déploiements par région dans une seule vue.
Comme la surveillance est accessible via les URL standard des points de terminaison et une vérification /health, tu peux également intégrer ces indicateurs à ta configuration d’observabilité existante pour approfondir l’analyse. Pour les détails de configuration, consulte le guide de surveillance des déploiements.
Détection des anomalies et systèmes d’alerte#
Une anomalie est un point de données ou un motif qui s’écarte considérablement de ce qui est attendu. Pour les modèles de vision par ordinateur, il peut s’agir d’images très différentes de celles utilisées pour entraîner le modèle. Ces images inattendues peuvent signaler des problèmes comme des changements dans la distribution des données, des valeurs aberrantes ou des comportements susceptibles de réduire les performances du modèle. La mise en place de systèmes d’alerte pour détecter ces anomalies est une partie importante de la surveillance des modèles.
En définissant des niveaux de performance de référence et des limites pour les métriques clés, tu peux détecter les problèmes rapidement. Lorsque les performances sortent de ces limites, des alertes sont déclenchées et invitent à appliquer rapidement des correctifs. La mise à jour et le réentraînement réguliers des modèles avec de nouvelles données leur permettent de rester pertinents et précis à mesure que les données évoluent.
Configurer les seuils et les alertes#
Lors de la configuration de tes systèmes d’alerte, garde à l’esprit les bonnes pratiques suivantes :
- Alertes normalisées : Utilise des outils et des formats cohérents pour toutes les alertes, comme les courriels ou les applications de messagerie telles que Slack. La normalisation te permet de comprendre et de traiter rapidement les alertes.
- Préciser le comportement attendu : Les messages d’alerte doivent indiquer clairement ce qui s’est mal passé, ce qui était attendu et la période évaluée. Cela t’aide à évaluer l’urgence et le contexte de l’alerte.
- Alertes configurables : Facilite la configuration des alertes afin qu’elles puissent s’adapter à l’évolution des conditions. Permets-toi de modifier les seuils, de mettre les alertes en veille, de les désactiver ou de les acquitter.
Détection de la dérive des données#
La détection de la dérive des données permet de repérer les changements, au fil du temps, des propriétés statistiques des données d’entrée, qui peuvent dégrader les performances du modèle. Avant de décider de réentraîner ou d’ajuster tes modèles, cette technique t’aide à détecter un problème. La dérive des données concerne les changements de l’ensemble des données au fil du temps, tandis que la détection des anomalies vise à repérer les points de données rares ou inattendus qui peuvent nécessiter une attention immédiate.
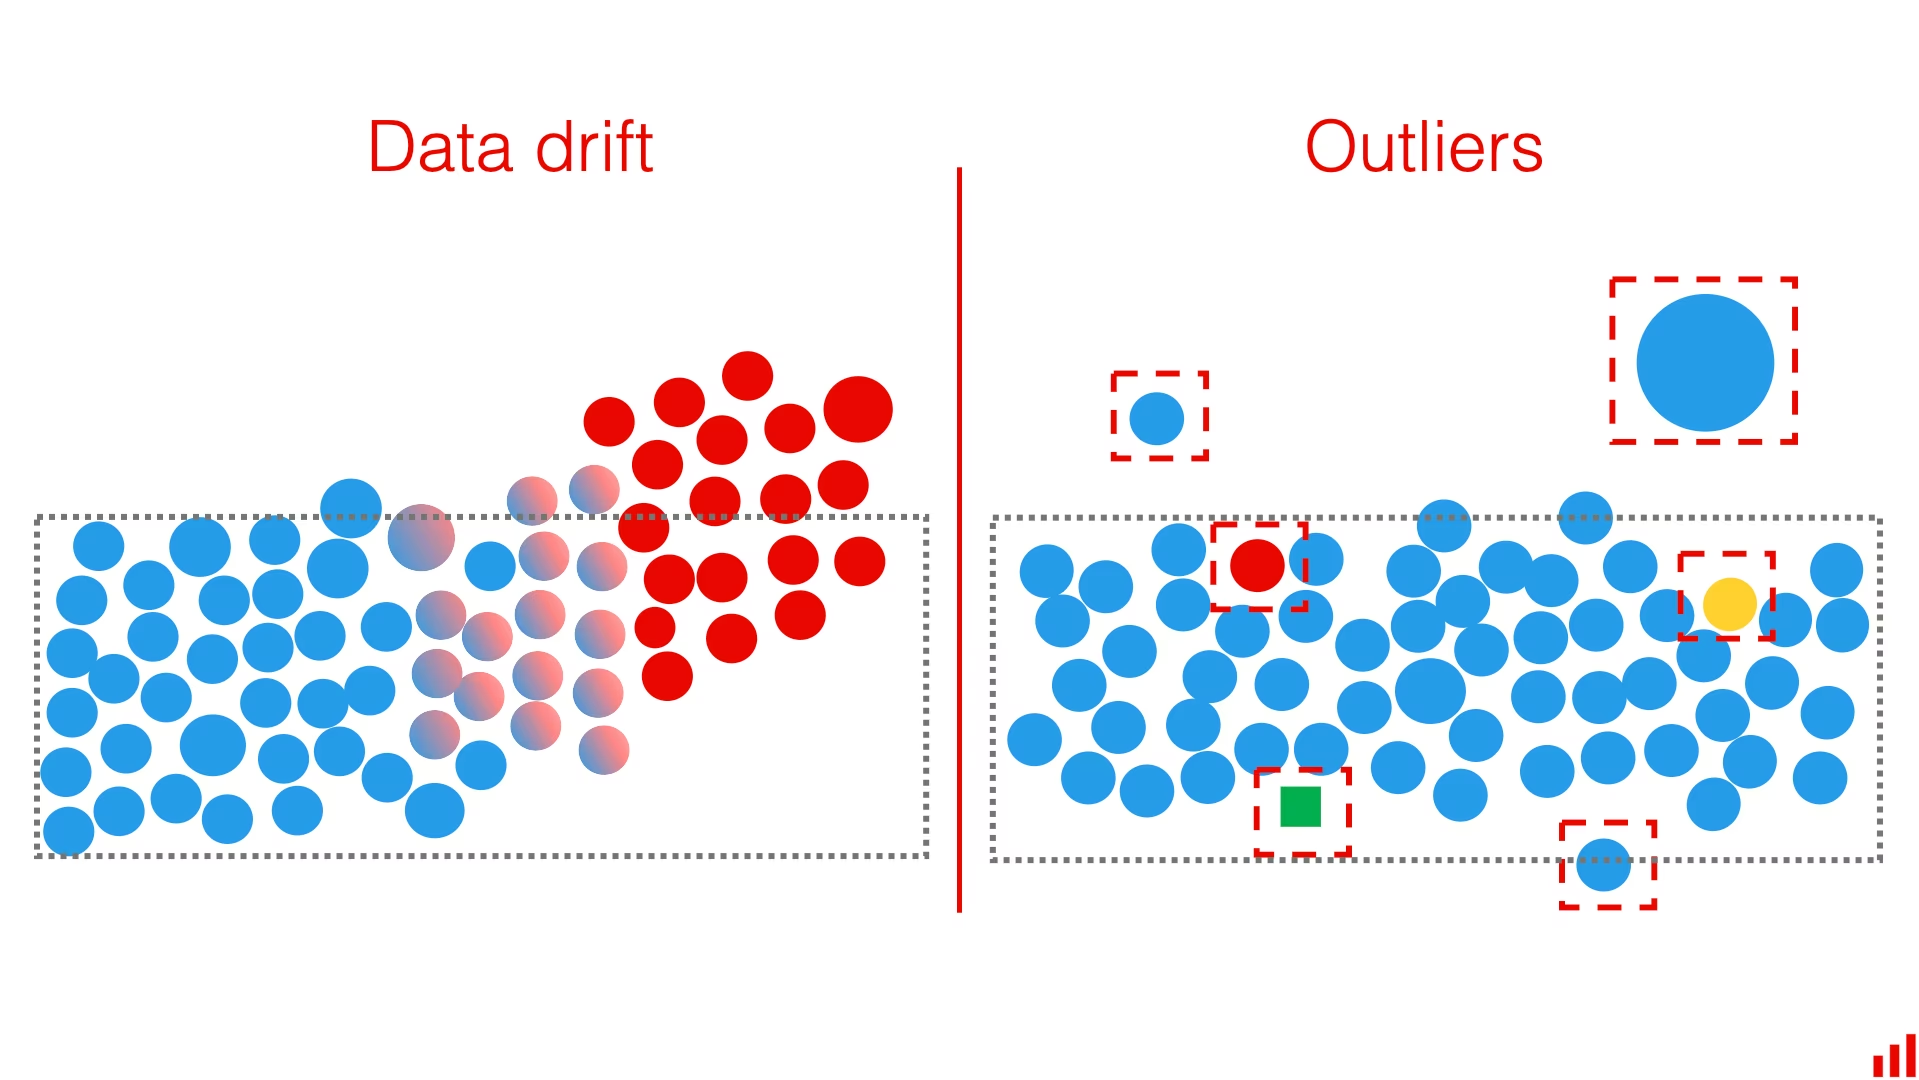
Voici plusieurs méthodes de détection de la dérive des données :
- Surveillance continue : Surveille régulièrement les données d’entrée et les sorties du modèle pour repérer les signes de dérive. Suis les métriques clés et compare-les aux données historiques afin de détecter les changements importants.
- Techniques statistiques : Utilise des méthodes comme le test de Kolmogorov-Smirnov ou l’indice de stabilité de la population (PSI) pour détecter les changements dans les distributions de données. Ces tests comparent la distribution des nouvelles données aux données d’entraînement afin de détecter les différences importantes.
- Dérive des caractéristiques : Surveille la dérive des caractéristiques individuelles. Parfois, la distribution globale des données reste stable, mais certaines caractéristiques dérivent. Repérer les caractéristiques concernées aide à affiner le processus de réentraînement.
Maintenance des modèles#
La maintenance des modèles permet de préserver la précision et la pertinence des modèles de vision par ordinateur au fil du temps en les mettant régulièrement à jour et en les réentraînant, en traitant la dérive des données et en les adaptant à l’évolution des données et des environnements. Elle complète la surveillance : celle-ci suit les performances du modèle en temps réel pour détecter rapidement les problèmes, tandis que la maintenance vise à les résoudre.
Mises à jour et réentraînement réguliers#
Une fois le modèle déployé, tu peux observer, au cours de la surveillance, des changements dans les tendances des données ou dans les performances, signes d’une dérive du modèle. Les mises à jour et le réentraînement réguliers deviennent alors essentiels à la maintenance du modèle, afin de garantir qu’il puisse gérer de nouvelles tendances et de nouveaux scénarios. Tu peux utiliser plusieurs techniques en fonction de l’évolution de tes données.
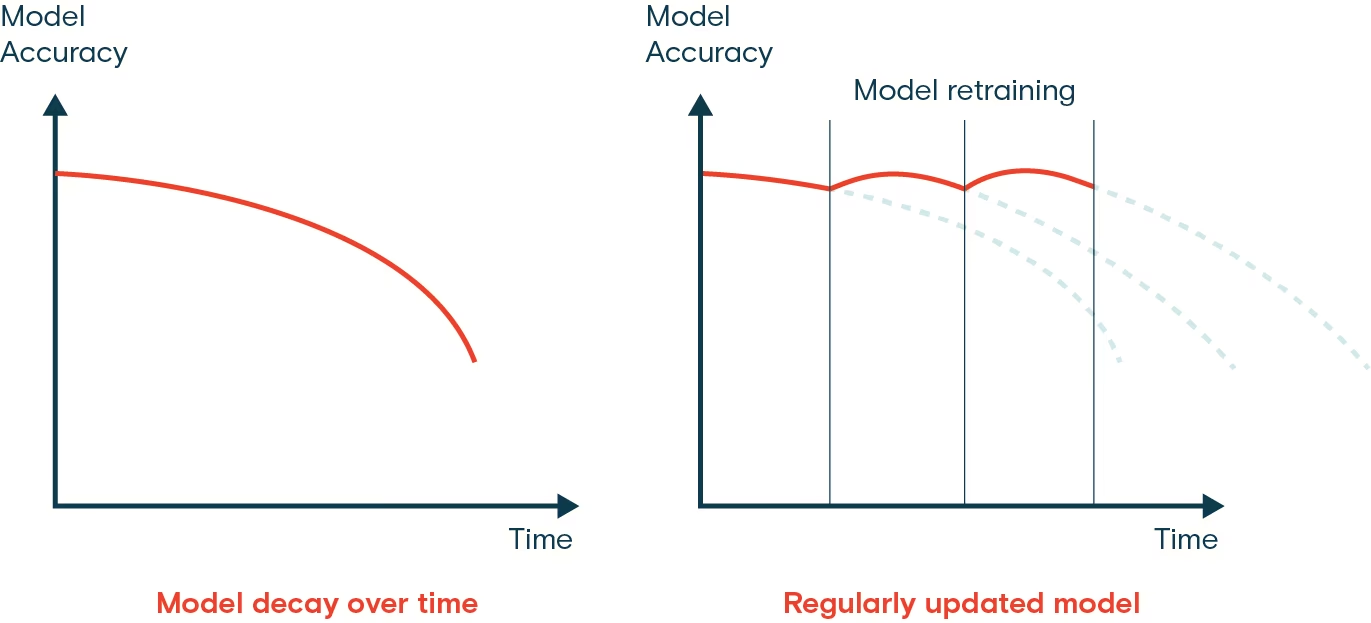
Par exemple, si les données évoluent progressivement au fil du temps, l’apprentissage incrémental est une bonne approche. Il consiste à mettre à jour le modèle avec de nouvelles données sans le réentraîner entièrement depuis zéro, ce qui permet d’économiser du temps et des ressources de calcul. En revanche, si les données ont radicalement changé, un réentraînement complet périodique peut être préférable afin de garantir que le modèle ne surapprenne pas les nouvelles données au détriment des tendances plus anciennes.
Quelle que soit la méthode, la validation et les tests sont indispensables après les mises à jour. Il est important de valider le modèle sur un jeu de données de test distinct afin de vérifier l’amélioration ou la dégradation de ses performances.
Déterminer quand réentraîner ton modèle#
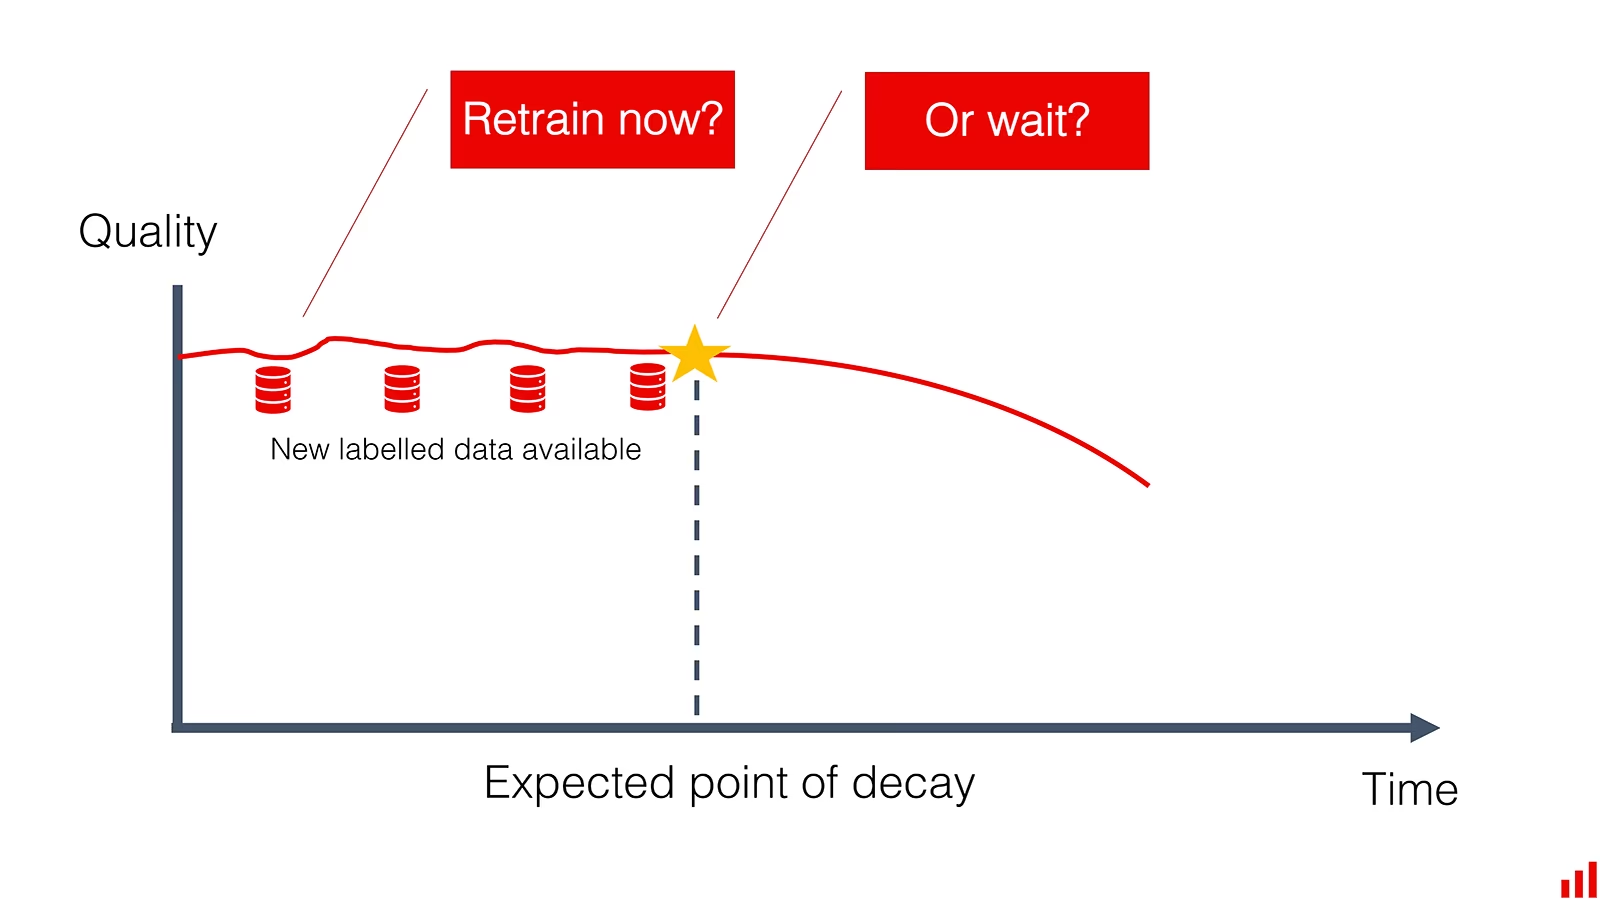
La fréquence de réentraînement de ton modèle de vision par ordinateur dépend de l’évolution des données et des performances du modèle. Réentraîne ton modèle dès que tu observes une baisse importante des performances ou que tu détectes une dérive des données. Des évaluations régulières, qui consistent à tester le modèle sur de nouvelles données, peuvent t’aider à déterminer le calendrier de réentraînement adapté. Le suivi des métriques de performance et des tendances des données te permet de décider si ton modèle doit être mis à jour plus fréquemment pour conserver sa précision.
Documentation#
La documentation d’un projet de vision par ordinateur en facilite la compréhension, la reproduction et la collaboration. Une bonne documentation couvre l’architecture du modèle, les hyperparamètres, les jeux de données, les métriques d’évaluation et bien plus encore. Elle assure la transparence et aide les membres de l’équipe ainsi que les parties prenantes à comprendre ce qui a été fait et pourquoi. Elle facilite également le dépannage, la maintenance et les améliorations futures en fournissant une référence claire sur les décisions et les méthodes antérieures.
Éléments clés à documenter#
Voici quelques-uns des éléments clés à inclure dans la documentation du projet :
- Présentation du projet : Fournis une synthèse générale du projet, notamment la description du problème, l’approche de résolution, les résultats attendus et le périmètre du projet. Explique le rôle de la vision par ordinateur dans la résolution du problème et présente les étapes et les livrables.
- Architecture du modèle : Détaille la structure et la conception du modèle, notamment ses composants, ses couches et ses connexions. Explique les hyperparamètres choisis et les raisons de ces choix.
- Préparation des données : Décris les sources de données, les types, les formats, les tailles et les étapes de prétraitement. Aborde la qualité et la fiabilité des données, ainsi que les transformations appliquées avant l’entraînement du modèle.
- Processus d’entraînement : Documente la procédure d’entraînement, notamment les jeux de données utilisés, les paramètres d’entraînement et les fonctions de perte. Explique comment le modèle a été entraîné et les difficultés rencontrées pendant l’entraînement.
- Métriques d’évaluation : Précise les métriques utilisées pour évaluer les performances du modèle, comme l’exactitude, la précision, le rappel et le score F1. Inclus les résultats de performance et une analyse de ces métriques.
- Étapes de déploiement : Présente les étapes suivies pour déployer le modèle, notamment les outils et les plateformes utilisés, les configurations de déploiement, ainsi que les difficultés ou considérations particulières.
- Procédure de surveillance et de maintenance : Fournis un plan détaillé pour surveiller les performances du modèle après son déploiement. Inclus des méthodes pour détecter et traiter la dérive des données et du modèle, et décris le processus de mise à jour régulière et de réentraînement.
Conclusion#
La surveillance, la maintenance et la documentation de ton modèle permettent à un projet de vision par ordinateur de rester performant longtemps après son déploiement : une surveillance continue détecte rapidement les problèmes, un réentraînement régulier adapte le modèle aux nouvelles données et à la dérive, et une documentation claire facilite chaque mise à jour ultérieure. Considère ce processus comme une boucle continue et reviens sur les étapes de ton projet de vision par ordinateur à mesure que tes données et tes besoins évoluent.
FAQ#
Pour surveiller un modèle de vision par ordinateur déployé, suis en production le volume de requêtes, le taux d’erreur et la latence, tout en détectant les anomalies et la dérive des données qui signalent une baisse de précision. Le tableau de bord Deploy de Ultralytics Platform couvre d’emblée les métriques de production, avec des métriques en temps réel, des contrôles automatiques de l’état du système et des journaux filtrés par niveau de gravité. Surveille régulièrement les entrées et les sorties, configure des alertes en cas de comportement inhabituel et utilise des sources de données variées pour obtenir une vue d’ensemble des performances de ton modèle. Pour en savoir plus, consulte notre section sur la surveillance des modèles.
La maintenance des modèles de vision par ordinateur implique des mises à jour, un réentraînement et une surveillance réguliers afin de garantir une précision et une pertinence durables. Voici quelques bonnes pratiques :
- Surveillance continue : Suis régulièrement les métriques de performance et la qualité des données.
- Détection de la dérive des données : Utilise des techniques statistiques pour repérer les changements dans la distribution des données.
- Mises à jour et réentraînement réguliers : Mets en œuvre un apprentissage incrémental ou un réentraînement complet périodique en fonction des changements dans les données.
- Documentation : Tiens à jour une documentation détaillée sur l’architecture du modèle, les processus d’entraînement et les métriques d’évaluation. Pour en savoir plus, consulte notre section Maintenance des modèles.
La détection de la dérive des données est essentielle, car elle permet de repérer les changements des propriétés statistiques des données d’entrée au fil du temps, susceptibles de dégrader les performances du modèle. Des techniques comme la surveillance continue, les tests statistiques (par exemple, le test de Kolmogorov-Smirnov) et l’analyse de la dérive des caractéristiques peuvent aider à détecter rapidement les problèmes. Le traitement de la dérive des données garantit que ton modèle reste précis et pertinent dans des environnements changeants. Pour en savoir plus sur la détection de la dérive des données, consulte notre section Détection de la dérive des données.
Pour détecter les anomalies dans les modèles de vision par ordinateur, définis des niveaux de performance de référence pour les métriques clés et déclenche des alertes dès que les valeurs dépassent ces limites. Ultralytics Platform prend cette fonctionnalité en charge grâce à des métriques en temps réel du taux d’erreur et de la latence, à des contrôles automatiques de l’état du système et à des journaux filtrés par niveau de gravité qui font rapidement ressortir les comportements inhabituels. Des alertes configurables et des messages standardisés t’aident à réagir rapidement aux problèmes potentiels. Pour en savoir plus, consulte notre section Détection des anomalies et systèmes d’alerte.
La documentation efficace d’un projet de vision par ordinateur doit inclure :
- Présentation du projet : Synthèse générale, description du problème et approche de résolution.
- Architecture du modèle : Détails de la structure du modèle, de ses composants et de ses hyperparamètres.
- Préparation des données : Informations sur les sources de données, les étapes de prétraitement et les transformations.
- Processus d’entraînement : Description de la procédure d’entraînement, des jeux de données utilisés et des difficultés rencontrées.
- Métriques d’évaluation : Métriques utilisées pour évaluer et analyser les performances.
- Étapes de déploiement : Étapes suivies pour le déploiement du modèle et difficultés particulières éventuelles.
- Procédure de surveillance et de maintenance : Plan de surveillance et de maintenance continus. Pour des recommandations plus complètes, consulte notre section Documentation.