Architecture Ultralytics YOLOv5#
YOLOv5 (v6.0/6.1) est un algorithme de détection d’objets développé par Ultralytics. Cet article explique l’architecture de YOLOv5, les stratégies d’augmentation des données, les méthodes d’entraînement et les techniques de calcul de la perte. Leur compréhension t’aidera à appliquer la détection d’objets à des domaines tels que la surveillance, les véhicules autonomes et la reconnaissance d’images.
1. Structure du modèle#
L’architecture de YOLOv5 comprend trois parties principales :
- Backbone : c’est le corps principal du réseau. Pour YOLOv5, le backbone repose sur la structure
CSPDarknet53, une modification de l’architecture Darknet utilisée dans les versions précédentes. - Neck : cette partie relie le backbone à la tête. YOLOv5 utilise les structures
SPPF(Spatial Pyramid Pooling - Fast) etPANet(Path Aggregation Network). - Tête : cette partie est chargée de générer la sortie finale. YOLOv5 utilise
YOLOv3 Headà cette fin.
La structure du modèle est illustrée dans l’image ci-dessous. Tu trouveras les détails de la structure du modèle dans models/yolov5l.yaml.
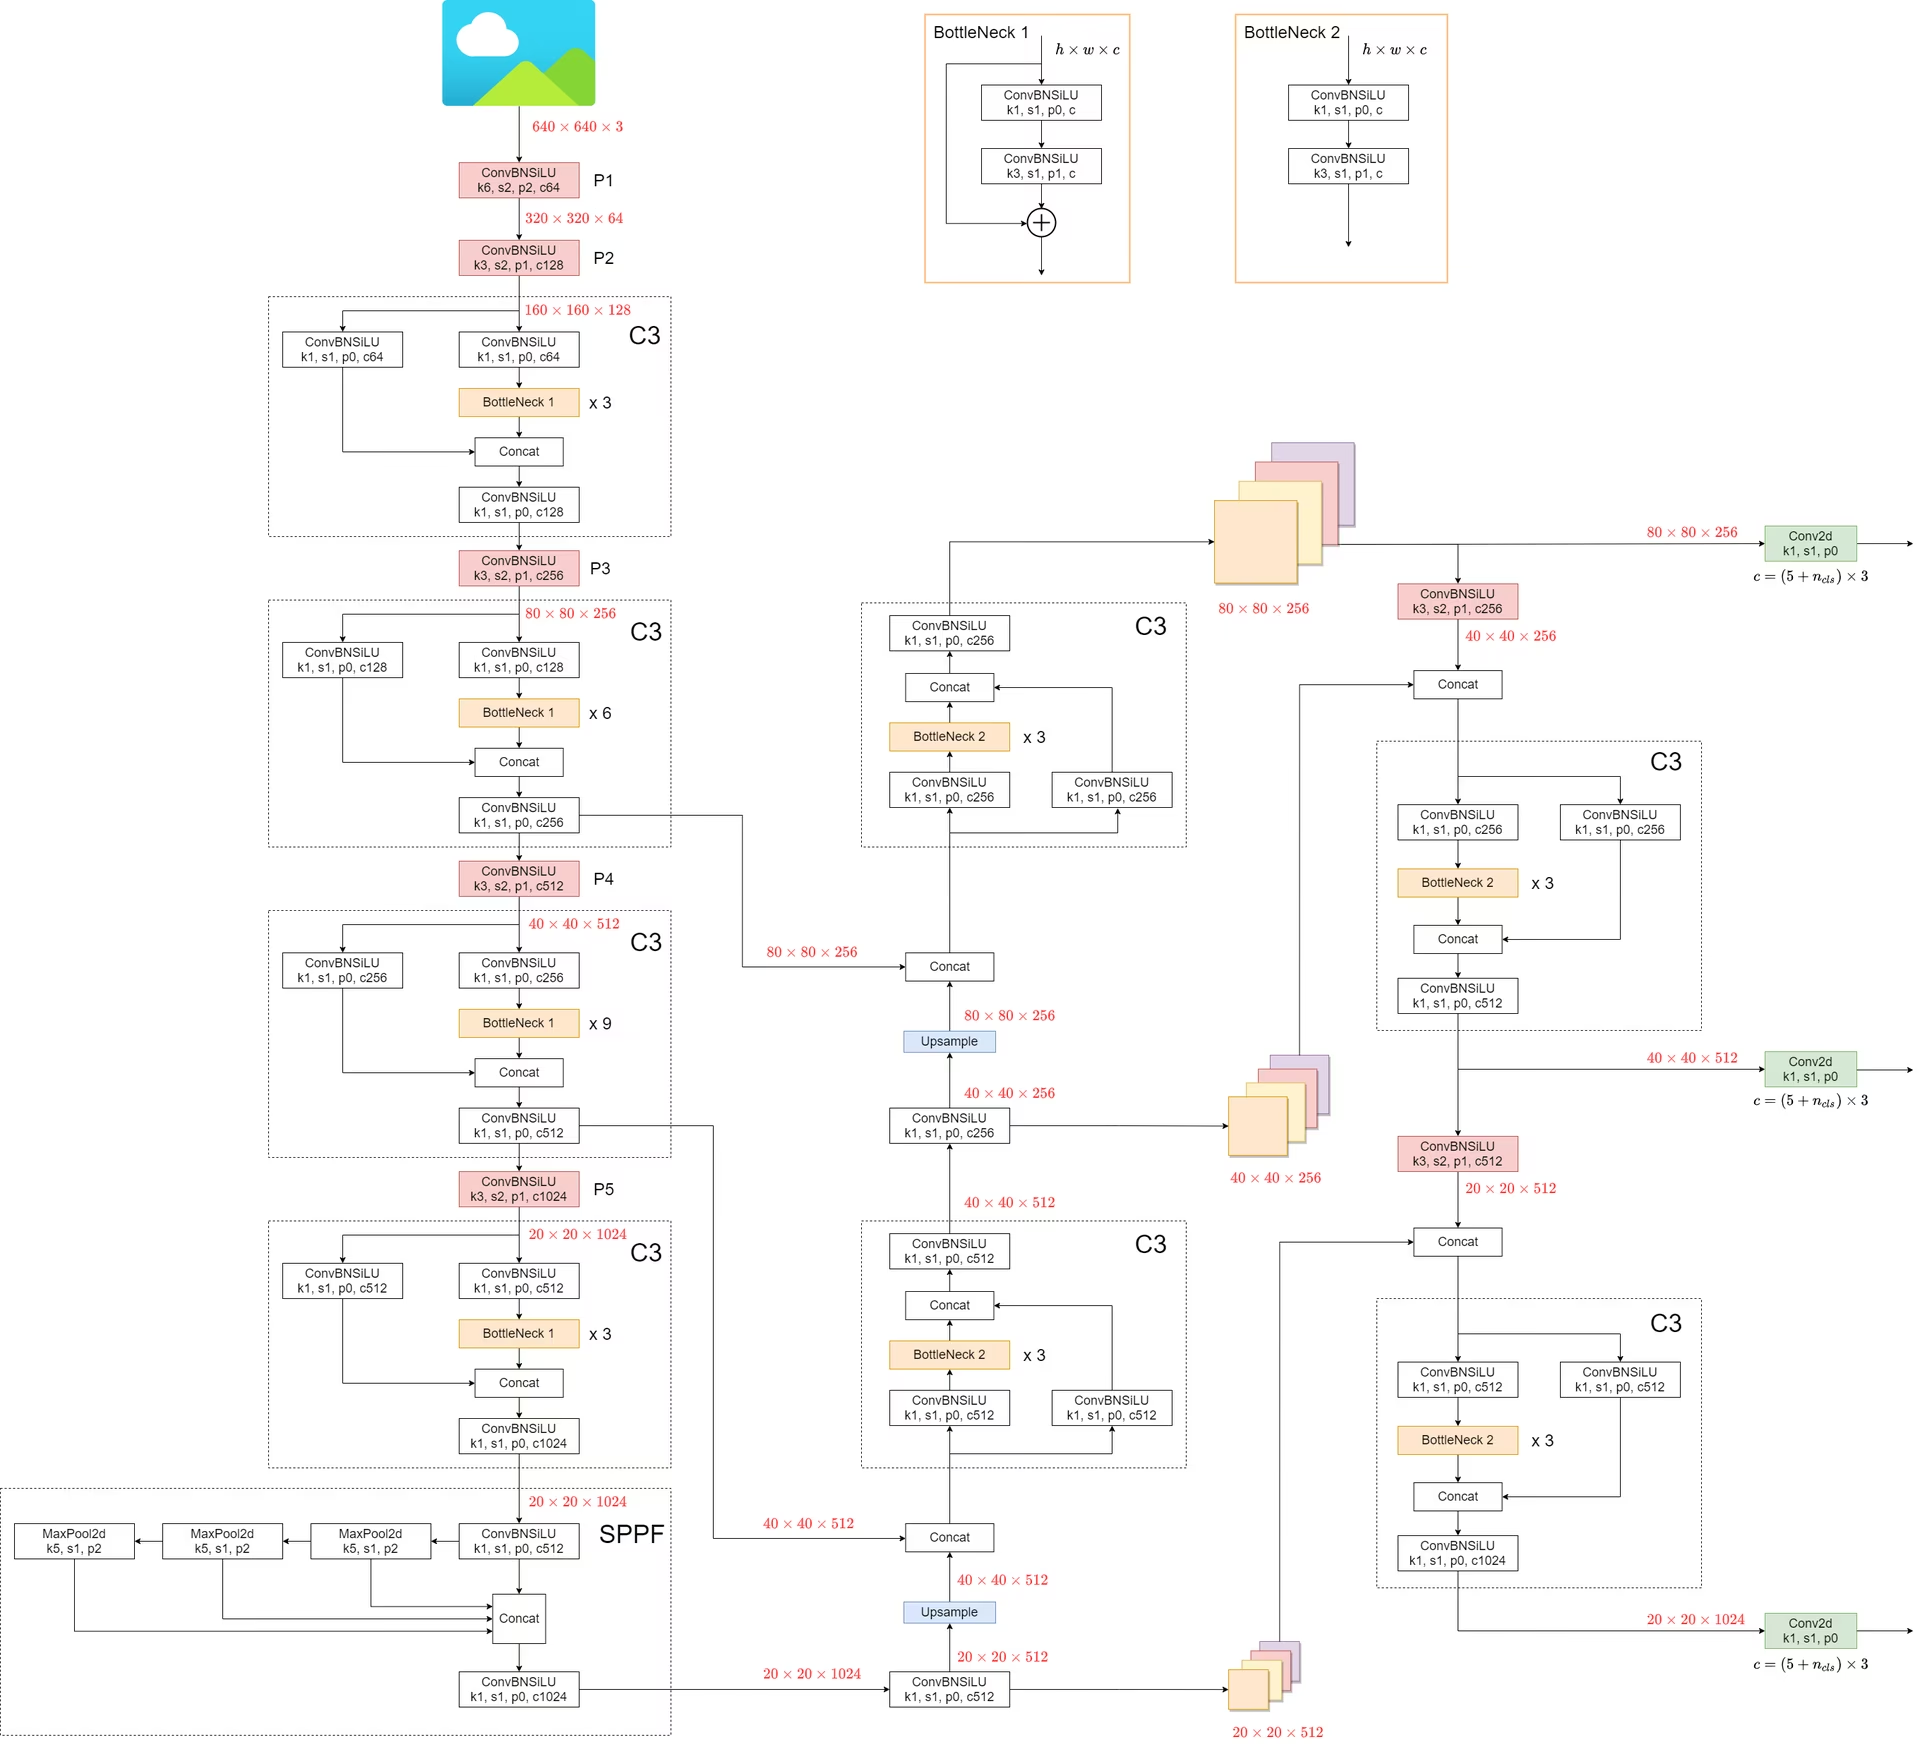
YOLOv5 apporte plusieurs améliorations notables par rapport à ses prédécesseurs :
- La structure
Focus, présente dans les versions précédentes, est remplacée par la structure6x6 Conv2d. Cette modification améliore l’efficacité #4825. - La structure
SPPest remplacée parSPPF. Cette modification fait plus que doubler la vitesse de traitement tout en conservant la même sortie.
Pour tester la vitesse de SPP et de SPPF, tu peux utiliser le code suivant :
Exemple de profilage de la vitesse de SPP par rapport à SPPF (cliquer pour ouvrir)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
Résultat :
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Techniques d’augmentation des données#
YOLOv5 utilise diverses techniques d’augmentation des données pour améliorer la capacité de généralisation du modèle et réduire le surapprentissage. Ces techniques comprennent :
-
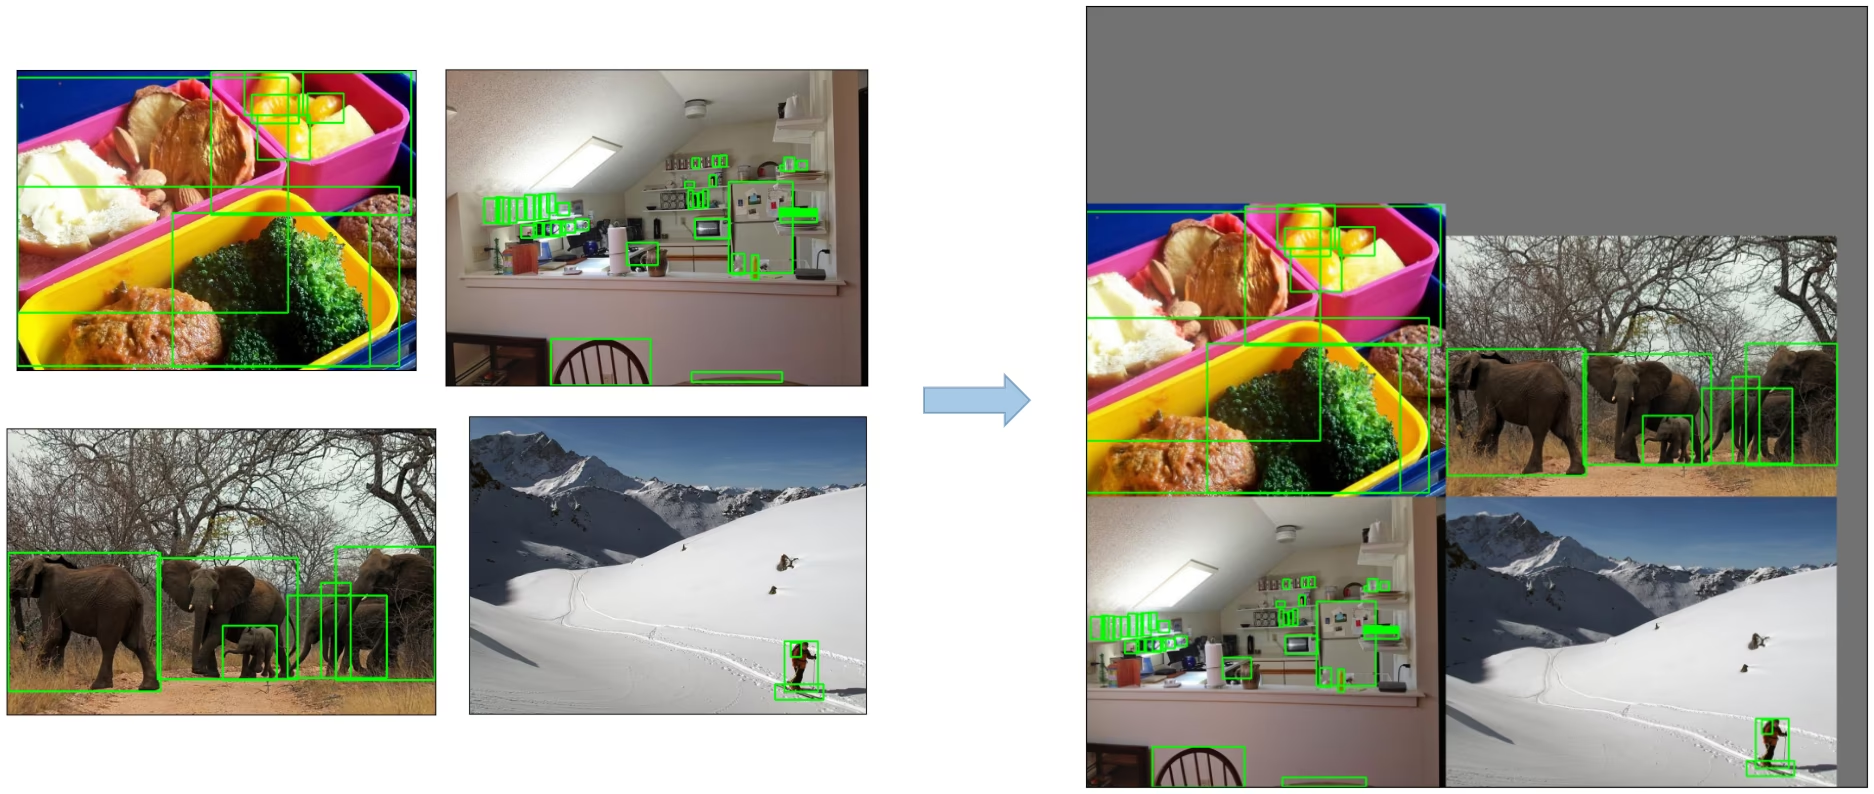
Augmentation Mosaic : technique de traitement d’images qui combine quatre images d’entraînement en une seule afin d’aider les modèles de détection d’objets à mieux gérer différentes échelles et translations d’objets.
-
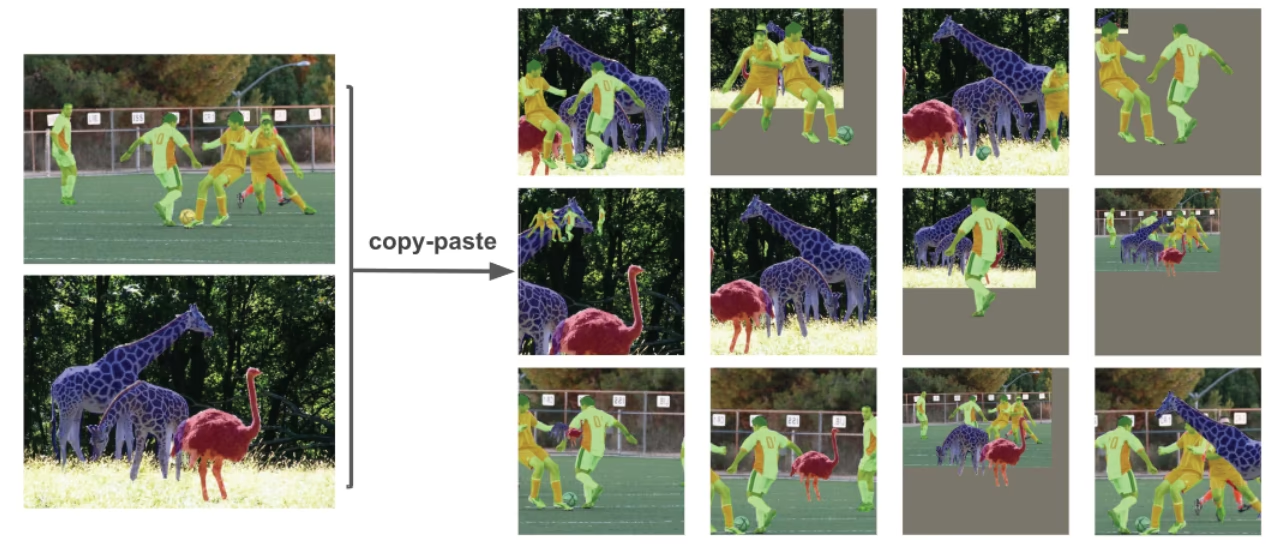
Augmentation Copy-Paste : méthode d’augmentation des données qui copie des instances d’objets à l’aide de leurs masques de segmentation et les colle sur des images d’entraînement pour générer de nouveaux échantillons d’entraînement.
-
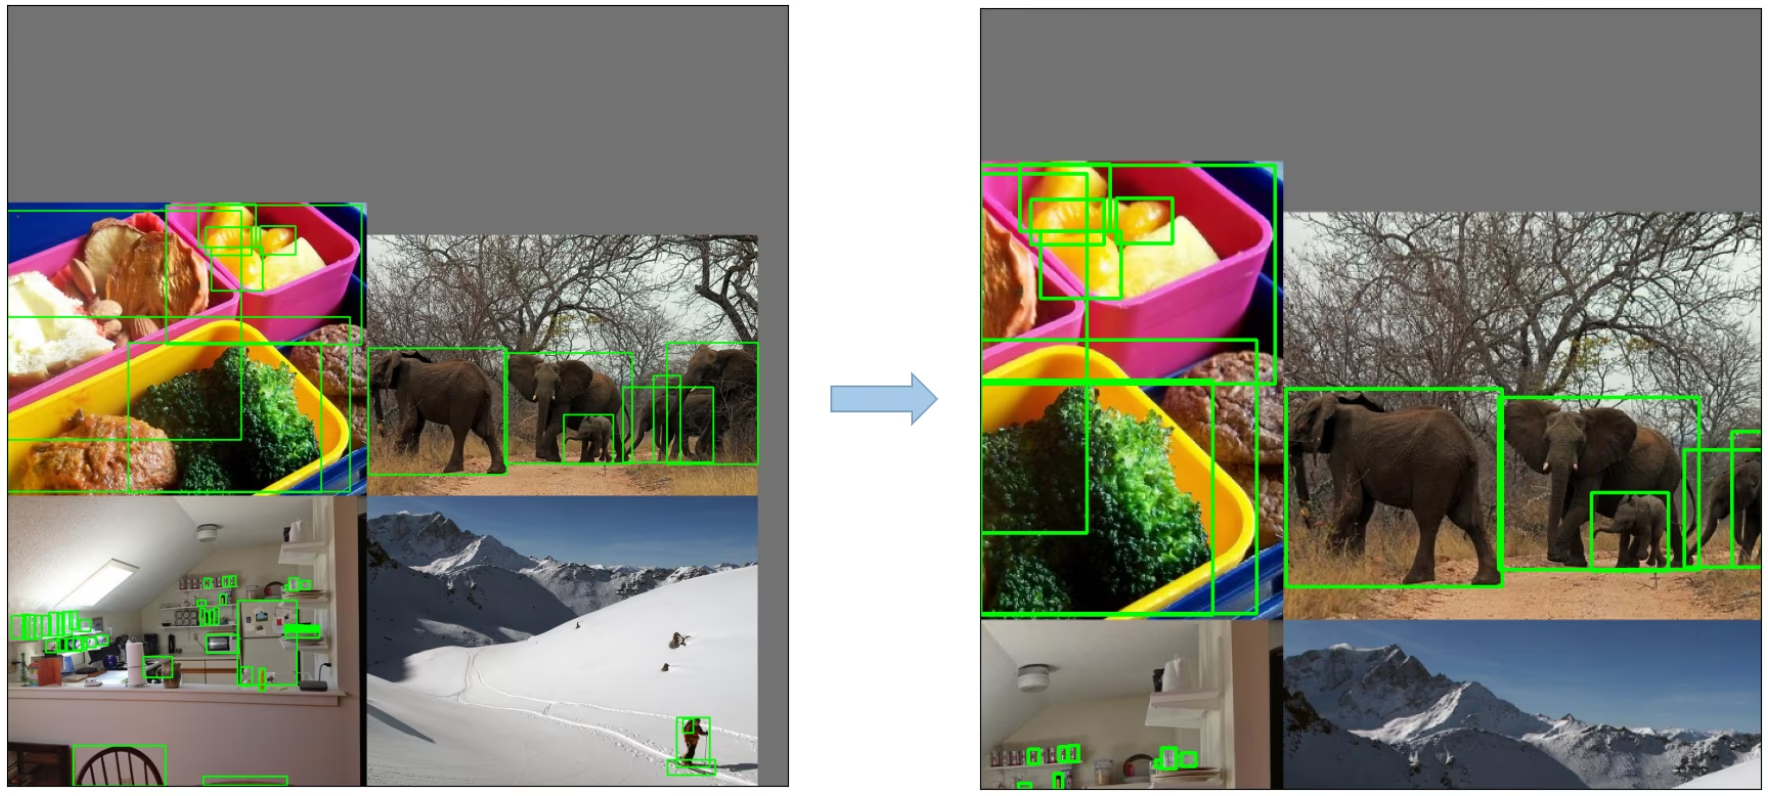
Transformations affines aléatoires : elles comprennent la rotation, le changement d’échelle, la translation et le cisaillement aléatoires des images.
-
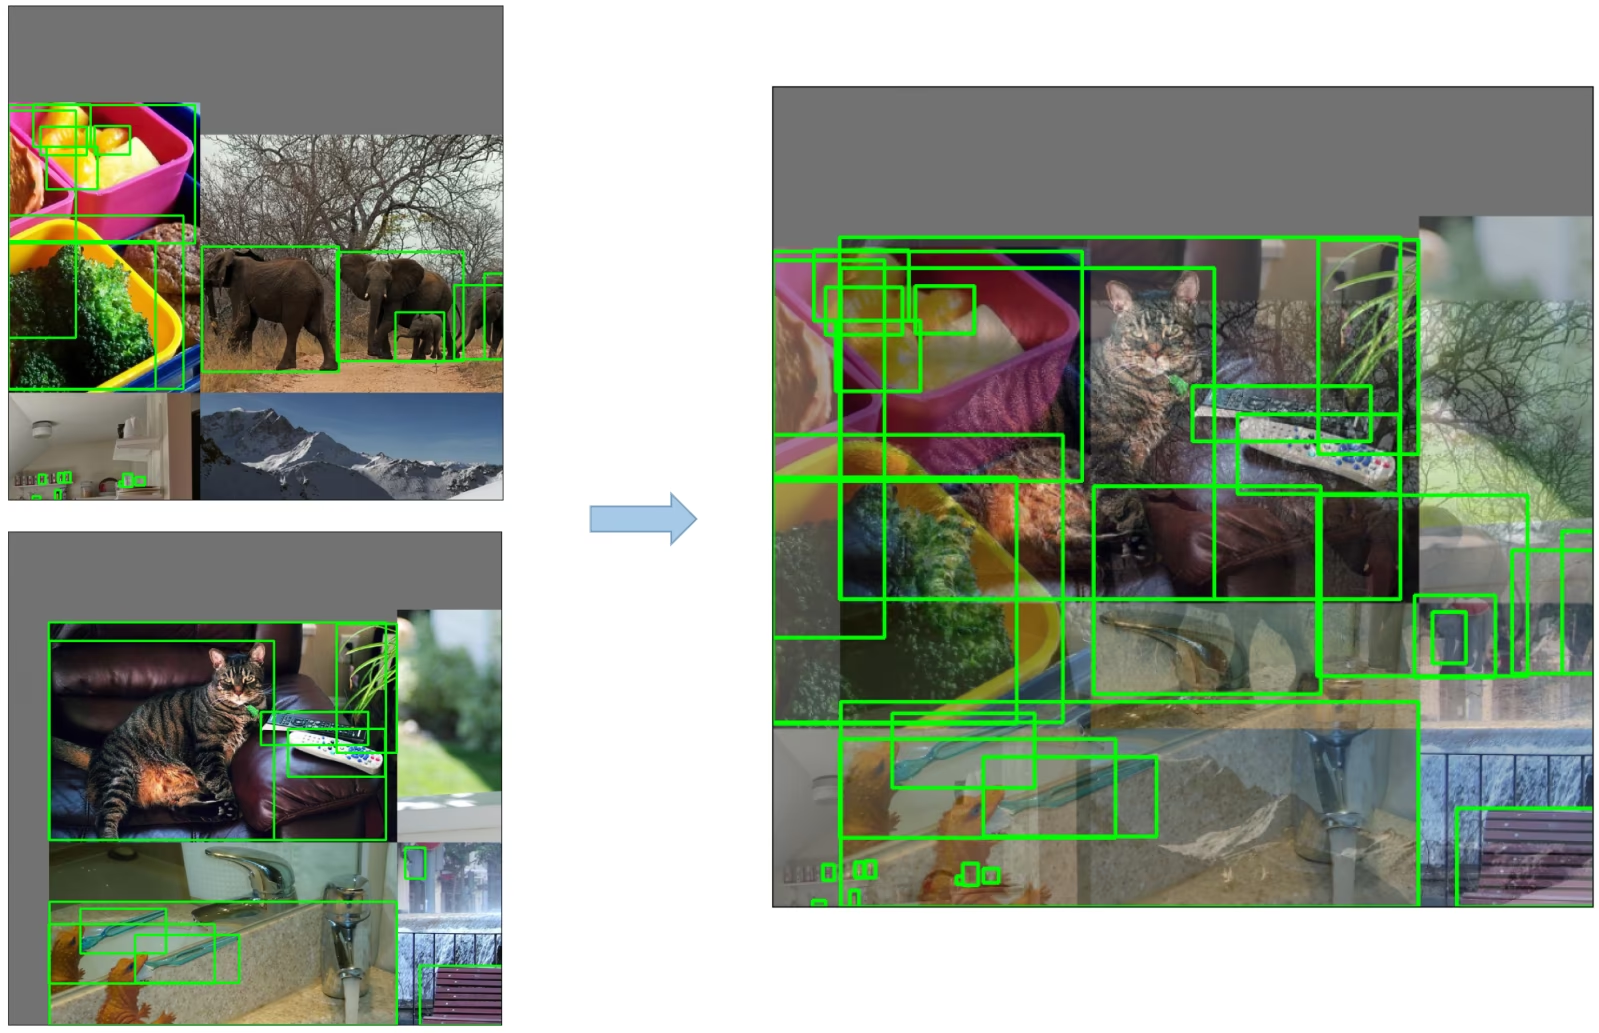
Augmentation MixUp : une méthode qui crée des images composites en combinant linéairement deux images et leurs étiquettes associées.
-
Albumentations : une bibliothèque d’augmentation d’images qui prend en charge une grande variété de techniques d’augmentation.
-
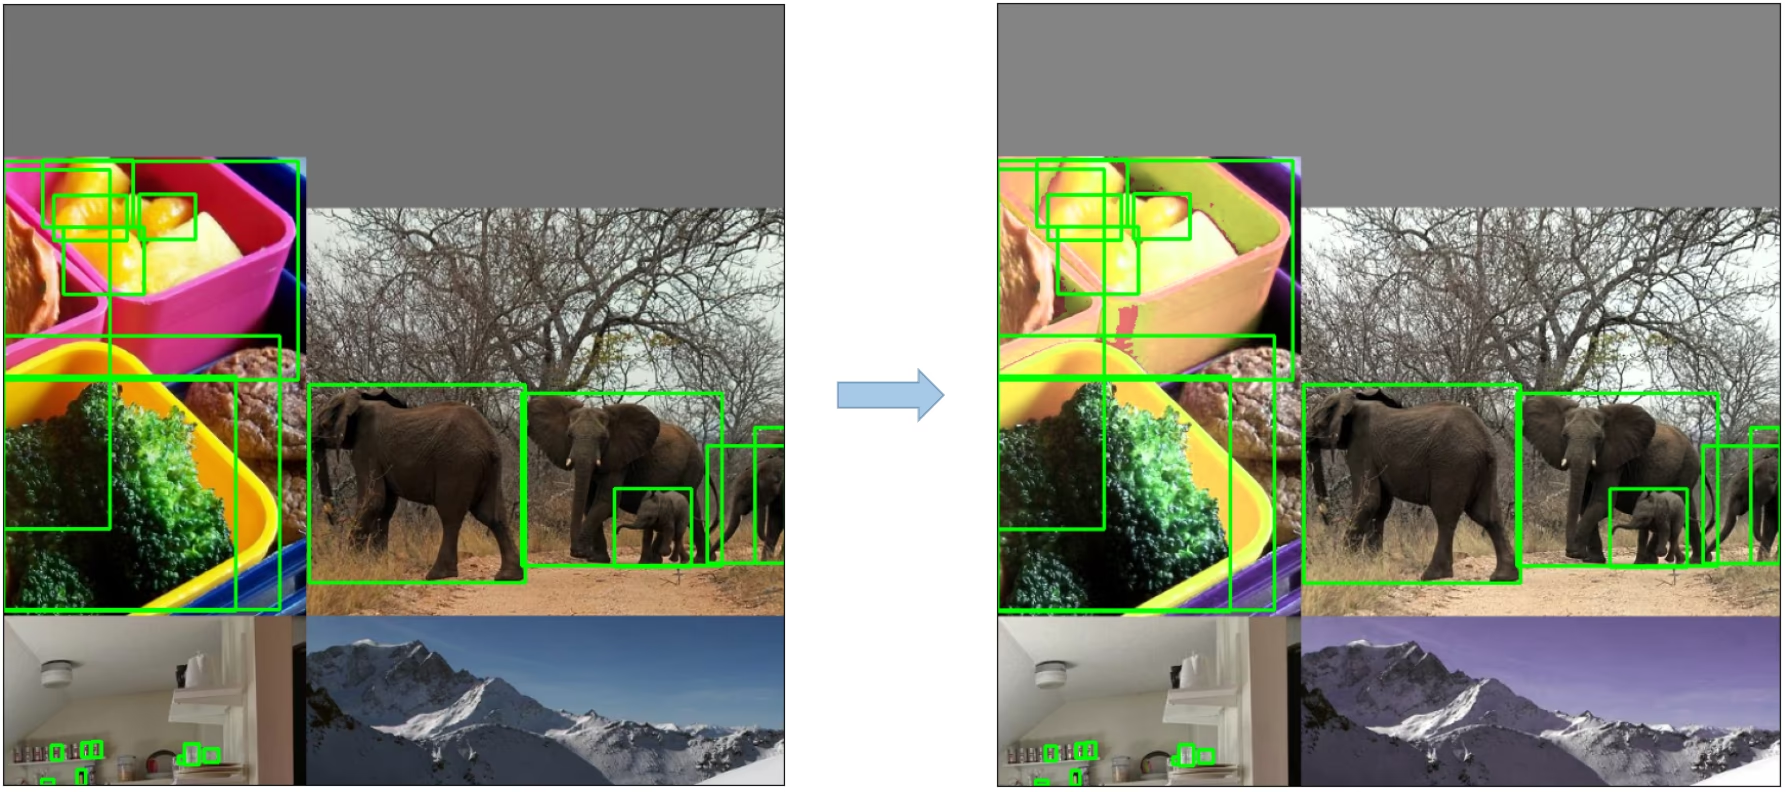
Augmentation HSV : modifications aléatoires de la teinte, de la saturation et de la valeur des images.
-
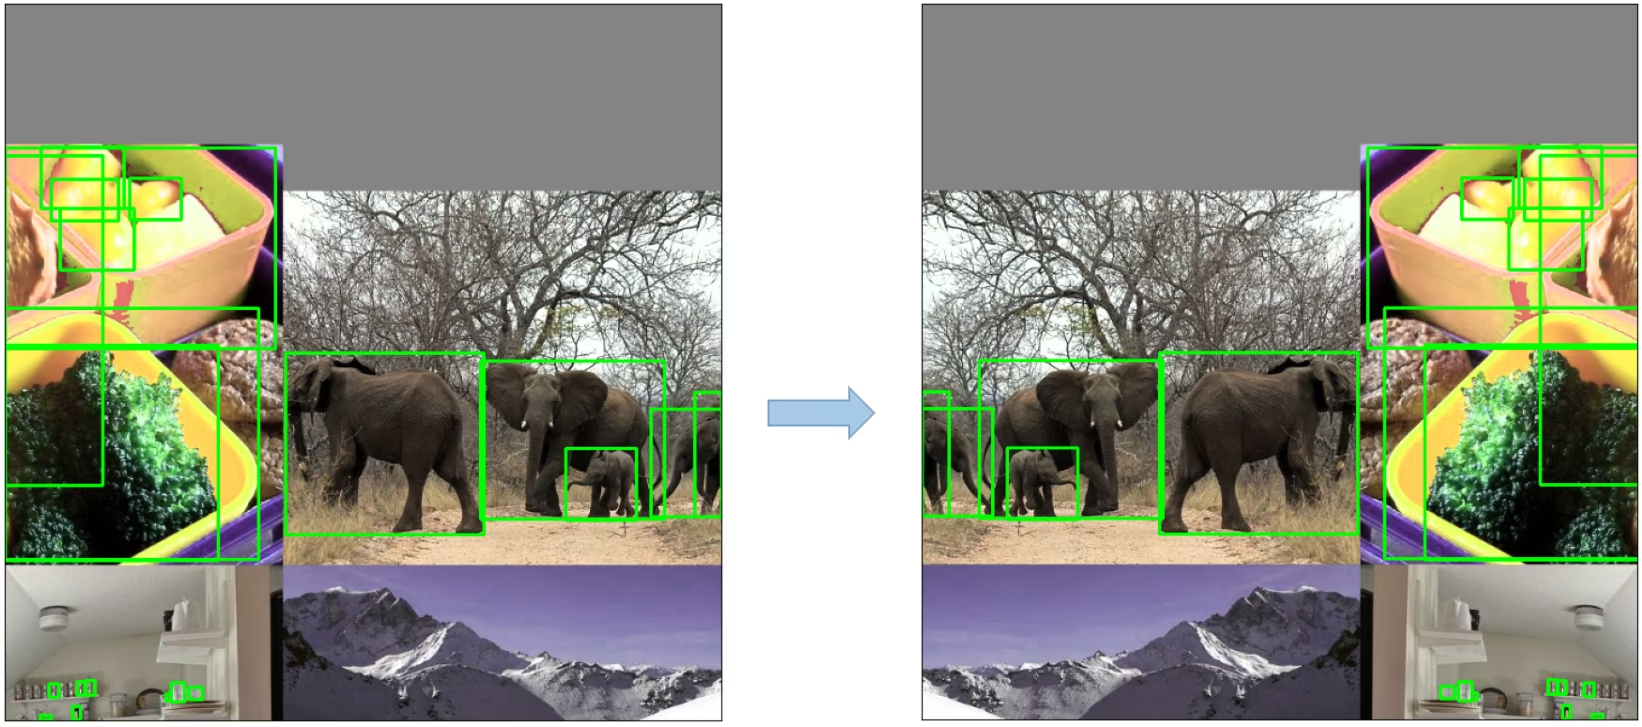
Retournement horizontal aléatoire : une méthode d’augmentation qui retourne aléatoirement les images horizontalement.
3. Stratégies d’entraînement#
YOLOv5 applique plusieurs stratégies d’entraînement pour améliorer les performances du modèle. Elles comprennent :
- Entraînement multi-échelle : pendant l’entraînement, la taille des images d’entrée est redimensionnée aléatoirement dans une plage allant de 0,5 à 1,5 fois leur taille d’origine.
- AutoAnchor : cette stratégie optimise les boîtes d’ancrage a priori afin qu’elles correspondent aux caractéristiques statistiques des boîtes de vérité terrain de tes données personnalisées.
- Planificateur de taux d’apprentissage avec échauffement et décroissance cosinus : méthode permettant d’ajuster le taux d’apprentissage afin d’améliorer les performances du modèle.
- Moyenne mobile exponentielle (EMA) : stratégie qui utilise la moyenne des paramètres sur les étapes précédentes pour stabiliser le processus d’entraînement et réduire l’erreur de généralisation.
- Entraînement en précision mixte : méthode qui effectue les opérations au format demi-précision, réduisant ainsi l’utilisation de la mémoire et augmentant la vitesse de calcul.
- Évolution des hyperparamètres : stratégie qui ajuste automatiquement les hyperparamètres pour obtenir des performances optimales. Consulte le tutoriel sur l’évolution des hyperparamètres.
4. Fonctionnalités supplémentaires#
4.1 Calcul des pertes#
La perte de YOLOv5 est calculée comme la combinaison de trois composantes de perte distinctes :
- Perte de classification (perte BCE) : la perte d’entropie croisée binaire mesure l’erreur de la tâche de classification.
- Perte d’objectness (perte BCE) : une autre perte d’entropie croisée binaire, qui calcule l’erreur de détection de la présence ou de l’absence d’un objet dans une cellule de grille donnée.
- Perte de localisation (perte CIoU) : la perte IoU complète mesure l’erreur de localisation de l’objet dans la cellule de la grille.
La fonction de perte globale est représentée par :
4.2 Équilibrage des pertes#
Les pertes d’objectness des trois couches de prédiction (P3, P4, P5) sont pondérées différemment. Les poids d’équilibrage sont respectivement [4.0, 1.0, 0.4]. Cette approche garantit que les prédictions à différentes échelles contribuent de façon appropriée à la perte totale.
4.3 Élimination de la sensibilité à la grille#
L’architecture de YOLOv5 apporte des changements importants à la stratégie de prédiction des boîtes par rapport aux versions précédentes de YOLO. Dans YOLOv2 et YOLOv3, les coordonnées des boîtes étaient prédites directement à l’aide de l’activation de la dernière couche.

Cependant, dans YOLOv5, la formule de prédiction des coordonnées des boîtes a été mise à jour pour réduire la sensibilité à la grille et empêcher le modèle de prédire des dimensions de boîte non bornées.
Les formules révisées de calcul de la boîte englobante prédite sont les suivantes :
Compare le décalage du point central avant et après la mise à l’échelle. La plage de décalage du point central passe de (0, 1) à (-0.5, 1.5). Le décalage peut donc plus facilement atteindre 0 ou 1.

Compare le rapport de mise à l’échelle de la hauteur et de la largeur (par rapport à l’ancre) avant et après l’ajustement. Les équations originales des boîtes YOLO/Darknet présentent un grave défaut. La largeur et la hauteur ne sont absolument pas bornées, puisqu’elles sont simplement calculées par out=exp(in), ce qui est dangereux, car cela peut entraîner une explosion des gradients, des instabilités, des pertes NaN et, finalement, l’arrêt complet de l’entraînement.

4.4 Construction des cibles#
Le processus de construction des cibles dans YOLOv5 est essentiel à l’efficacité de l’entraînement et à la précision du modèle. Il consiste à attribuer les boîtes de vérité terrain aux cellules de grille appropriées de la carte de sortie et à les associer aux boîtes d’ancrage adéquates.
Ce processus suit les étapes suivantes :
- Calcule le rapport entre les dimensions de la boîte de vérité terrain et celles de chaque modèle d’ancre.

- Si le rapport calculé respecte le seuil, associe la boîte de vérité terrain à l’ancre correspondante.

- Attribue l’ancre correspondante aux cellules appropriées. Note que, du fait de la révision du décalage du point central, une boîte de vérité terrain peut être attribuée à plusieurs ancres : la plage du décalage du point central passe de (0, 1) à (-0.5, 1.5), ce qui permet des correspondances supplémentaires.

Ainsi, le processus de construction des cibles garantit que chaque objet de vérité terrain est correctement attribué et associé pendant l’entraînement, ce qui permet à YOLOv5 d’apprendre plus efficacement la tâche de détection d’objets.
Conclusion#
YOLOv5 marque une étape importante dans l’évolution de la détection d’objets en temps réel. Ses choix architecturaux, ses stratégies d’entraînement et ses améliorations techniques offrent de solides performances et une grande efficacité par rapport aux versions précédentes de YOLO.
Les principales améliorations de YOLOv5 comprennent des affinements de l’architecture, tels que le stem 6x6 Conv2d et SPPF, un vaste ensemble de techniques d’augmentation des données, des stratégies d’entraînement telles qu’AutoAnchor et EMA, ainsi que des ajustements du calcul de la perte et de la construction des cibles. Ensemble, ces améliorations renforcent la précision et l’efficacité de la détection d’objets tout en préservant la vitesse qui fait la réputation des modèles YOLO.
FAQ#
Un backbone CSPDarknet53 extrait les caractéristiques, un neck SPPF et PANet les fusionne à différentes échelles, et une tête de type YOLOv3 prédit les boîtes, l’objectness et les classes aux strides 8, 16 et 32. La liste complète des couches se trouve dans
models/yolov5l.yaml.SPPF enchaîne trois opérations de pooling max 5x5 au lieu d’exécuter en parallèle des opérations de pooling 5x5, 9x9 et 13x13. Le résultat est mathématiquement identique, mais l’exécution est plus de deux fois plus rapide, comme le montre l’extrait de profilage ci-dessus.
Le décalage YOLO d’origine ne pouvait jamais atteindre exactement 0 ou 1, ce qui rendait difficiles les prédictions des objets centrés sur les limites de la grille. La mise à l’échelle de la sigmoïde sur l’intervalle (-0.5, 1.5) élimine cette sensibilité à la grille, et le carré de
2σpour la largeur et la hauteur limite les prédictions à 4x la taille de l’ancre, évitant ainsi les explosions de gradients causées par l’exponentielle non bornée.Toute ancre dont les rapports de largeur et de hauteur par rapport à la boîte respectent
anchor_t(4.0 par défaut) est considérée comme une correspondance, et la plage de décalage étendue permet aussi d’attribuer la boîte aux deux cellules de grille voisines. Un seul objet peut donc générer plusieurs cibles positives, ce qui accélère la convergence.
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un d’autre.