Apprentissage par transfert avec des couches gelées dans YOLOv5#
📚 Ce guide explique comment geler les couches de YOLOv5 🚀 lors de la mise en œuvre de l’apprentissage par transfert. L’apprentissage par transfert est une puissante technique d’apprentissage automatique (ML) qui te permet de réentraîner rapidement un modèle sur de nouvelles données sans réentraîner tout le réseau depuis zéro. En gelant les poids des couches initiales et en mettant à jour uniquement les paramètres des couches suivantes, tu peux réduire considérablement les besoins en ressources de calcul et la durée d’entraînement. Cette approche peut toutefois avoir une légère incidence sur la précision finale du modèle.
Avant de commencer#
Commence par cloner le dépôt YOLOv5 et installer les dépendances nécessaires répertoriées dans requirements.txt. Assure-toi de disposer d’un environnement Python>=3.8.0 avec PyTorch>=1.8 installé. Les modèles préentraînés et les jeux de données nécessaires seront téléchargés automatiquement depuis la dernière version de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
Fonctionnement du gel des couches#
Lorsque tu gèles des couches dans un réseau de neurones, tu empêches la mise à jour de leurs paramètres (poids et biais) pendant l’entraînement. Dans PyTorch, cela consiste à définir l’attribut requires_grad des tenseurs de la couche sur False. Par conséquent, aucun gradient n’est calculé pour ces couches pendant la rétropropagation, ce qui économise du calcul et de la mémoire.
Voici comment YOLOv5 met en œuvre le gel des couches dans son script d’entraînement :
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
        v.requires_grad = False  # Disable gradient calculation for frozen layers
Découvrir l’architecture du modèle#
Il est essentiel de comprendre la structure du modèle YOLOv5 pour décider quelles couches geler. Tu peux examiner les noms de tous les modules et de leurs paramètres à l’aide de l’extrait Python suivant :
# En supposant que « model » soit ton instance de modèle YOLOv5 chargée
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""
L’architecture YOLOv5 comprend généralement un backbone (couches 0 à 9 dans les configurations standard comme YOLOv5s/m/l/x), chargé de l’extraction des caractéristiques, et une tête (les couches restantes) qui effectue la détection d’objets.
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
    # ... subsequent head layers for feature fusion and detection
Options de gel#
Tu peux contrôler les couches gelées à l’aide de l’argument --freeze dans la commande d’entraînement. Cet argument indique l’indice du premier module non gelé ; tous les modules précédant cet indice auront leurs poids gelés. Si tu fournis plutôt plusieurs indices (par exemple, --freeze 0 1 2), seuls ces modules seront gelés. Utilise model.model (un nn.Sequential) pour examiner l’ordre des modules si tu dois vérifier quels indices correspondent à un bloc donné.
Geler uniquement le backbone#
Pour geler tout le backbone (couches 0 à 9), une approche courante pour adapter le modèle à de nouvelles classes d’objets tout en conservant les capacités générales d’extraction des caractéristiques acquises sur un grand jeu de données comme COCO :
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10Cette stratégie est efficace lorsque ton jeu de données cible partage avec les données d’entraînement d’origine (par exemple, COCO) des caractéristiques visuelles de bas niveau similaires, comme les contours et les textures, mais contient des catégories d’objets différentes.
Geler toutes les couches sauf les couches finales de détection#
Pour geler presque tout le réseau en laissant entraînables uniquement les couches de convolution finales qui produisent la sortie (une partie du module Detect, généralement le dernier module, par exemple le module 24 dans YOLOv5s) :
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24Cette approche est utile lorsque tu dois principalement adapter le modèle à un nombre différent de classes de sortie tout en conservant la grande majorité des caractéristiques apprises. Elle nécessite le moins de ressources de calcul pour l’ajustement fin.
Comparaison des performances#
Pour illustrer les effets du gel des couches, nous avons entraîné YOLOv5m sur le jeu de données Pascal VOC pendant 50 époques, en partant des poids officiels préentraînés sur COCO (yolov5m.pt). Nous avons comparé trois scénarios : l’entraînement de toutes les couches (--freeze 0), le gel du backbone (--freeze 10) et le gel de toutes les couches sauf les couches finales de détection (--freeze 24).
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10
Résultats de précision#
Les résultats montrent que le gel des couches peut accélérer considérablement l’entraînement, mais entraîner une légère baisse de la mAP (précision moyenne) finale. L’entraînement de toutes les couches offre généralement la meilleure précision, tandis que le gel d’un plus grand nombre de couches accélère l’entraînement au risque de réduire les performances.
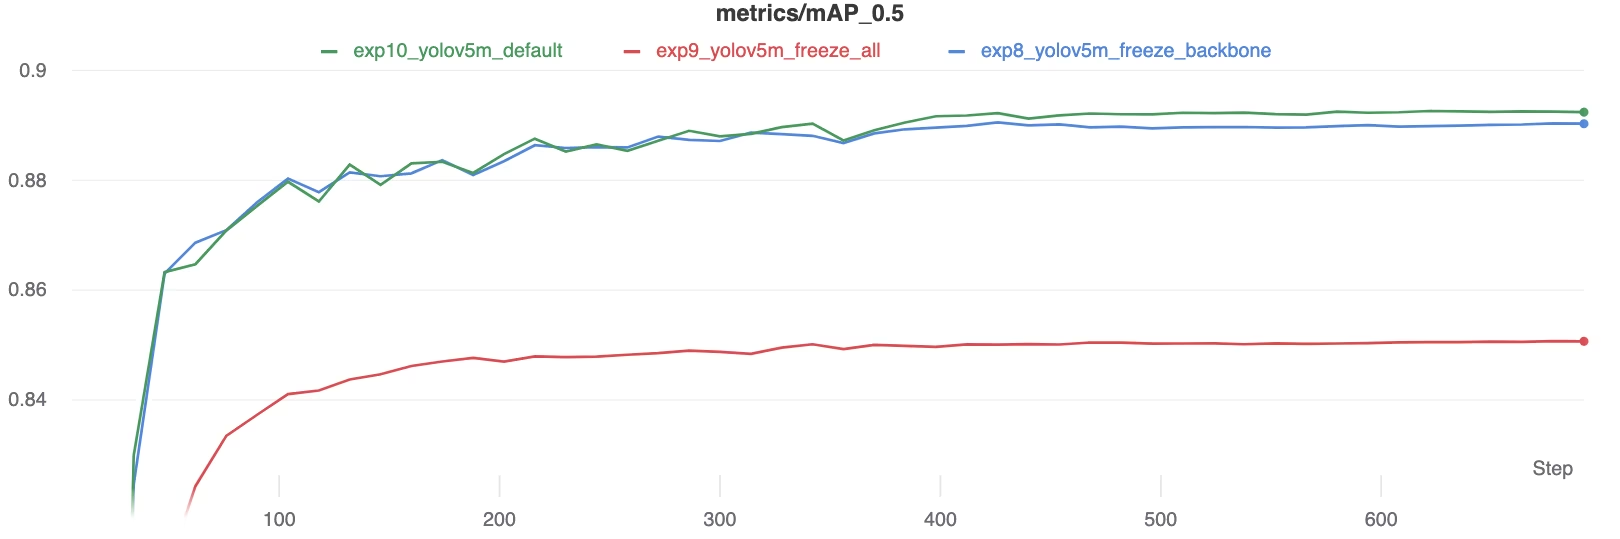 Comparaison de mAP50 pendant l’entraînement
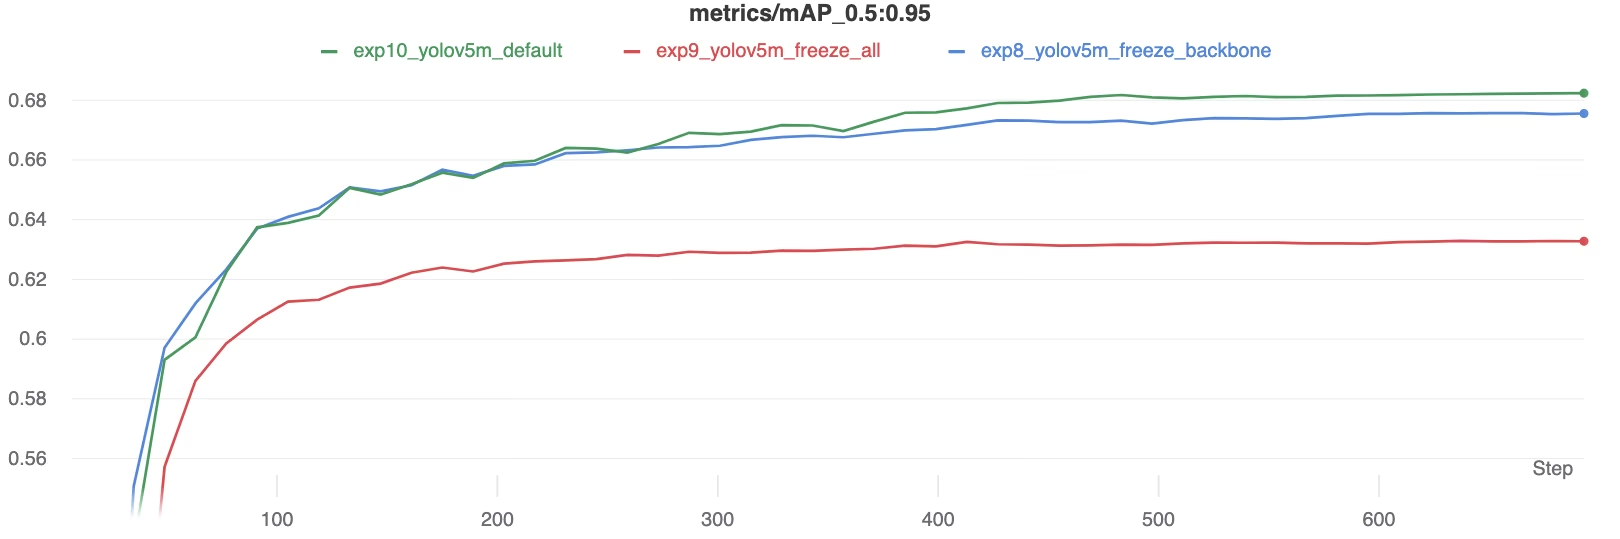 Comparaison de mAP50-95 pendant l’entraînement
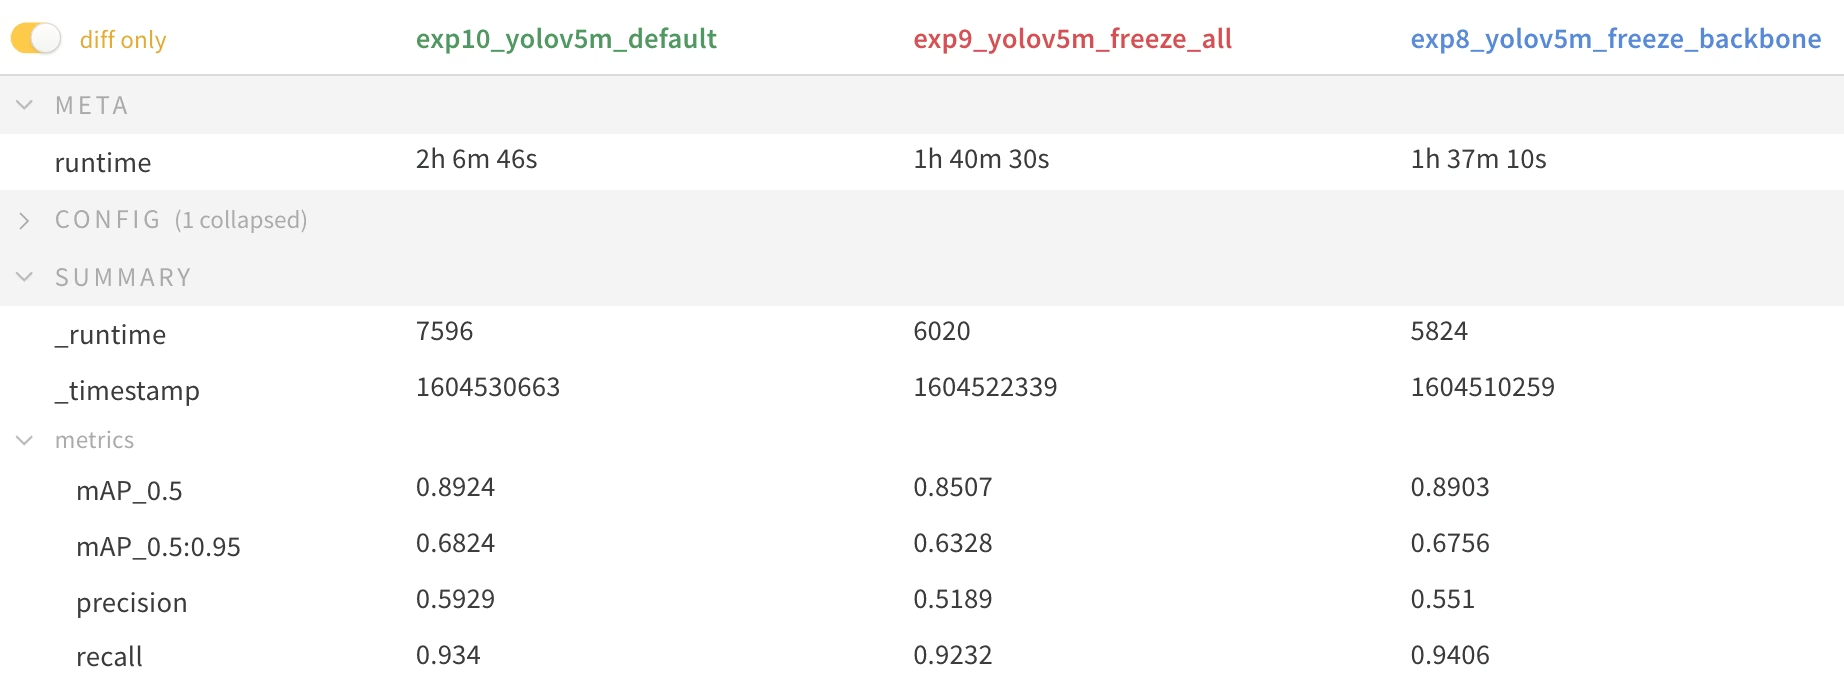 *Tableau récapitulatif des métriques de performance*
Utilisation des ressources#
Geler davantage de couches réduit considérablement les besoins en mémoire GPU et l’utilisation globale des ressources. L’apprentissage par transfert avec des couches gelées est donc une option intéressante lorsque les ressources matérielles sont limitées : tu peux ainsi entraîner des modèles plus grands ou utiliser des images de plus grande taille qu’il ne serait autrement possible.
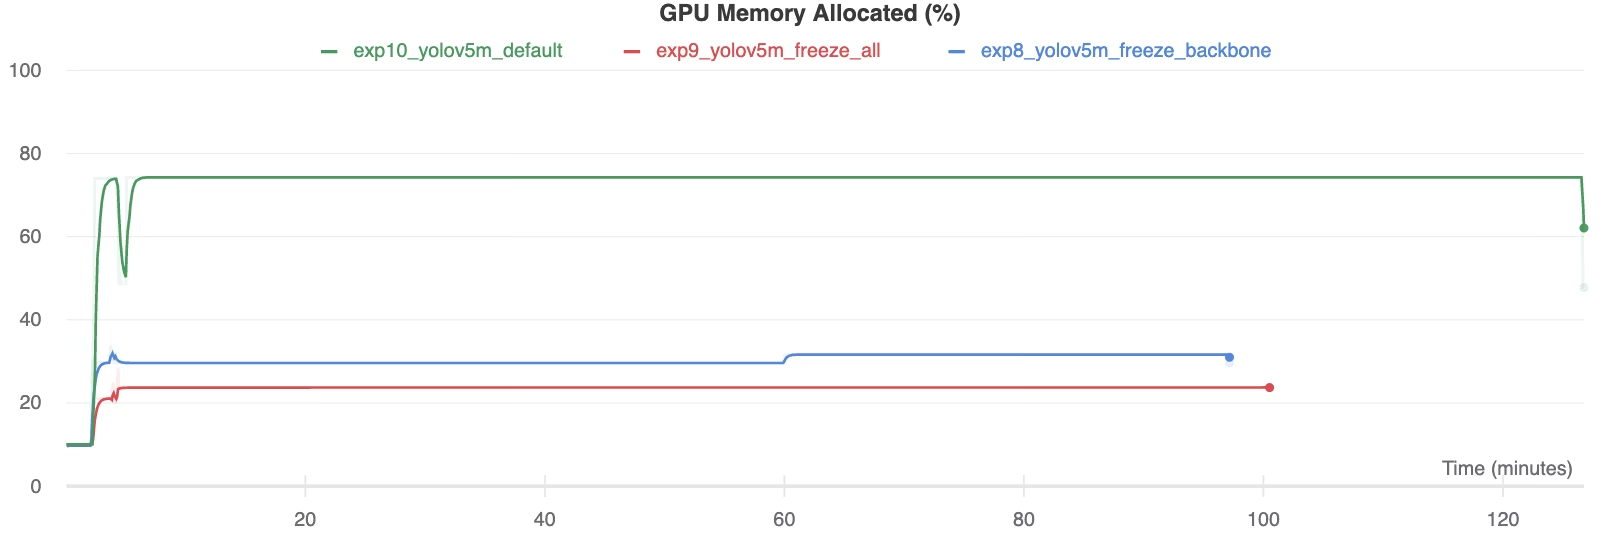 Mémoire GPU allouée (%)
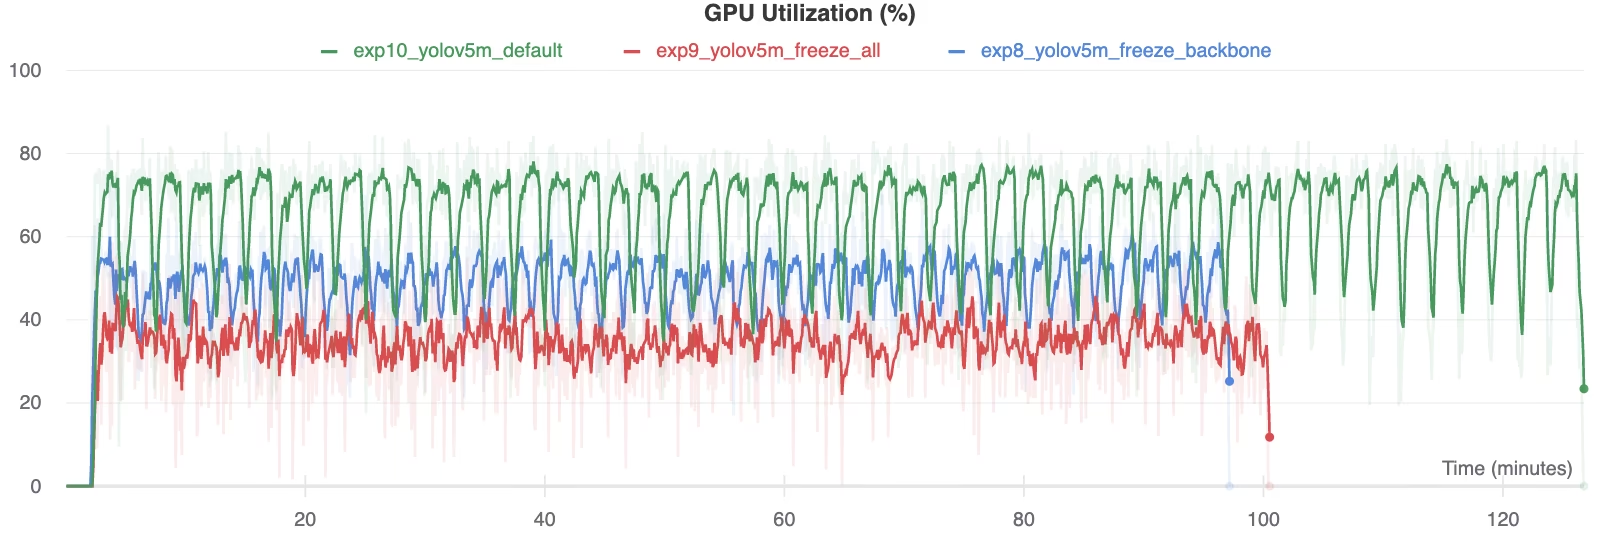 Utilisation du GPU (%)
Quand geler des couches#
Le gel des couches pendant l’apprentissage par transfert est particulièrement avantageux dans plusieurs situations :
- Ressources de calcul limitées : si ta mémoire GPU ou ta puissance de traitement est limitée.
- Petits jeux de données : lorsque ton jeu de données cible est nettement plus petit que le jeu de données de préentraînement d’origine, le gel aide à prévenir le surapprentissage.
- Prototypage rapide : lorsque tu dois adapter rapidement un modèle existant à une nouvelle tâche ou à un nouveau domaine pour une première évaluation.
- Domaines de caractéristiques similaires : si les caractéristiques de bas niveau de ton nouveau jeu de données sont très similaires à celles du jeu de données utilisé pour préentraîner le modèle.
Pour en savoir plus sur les subtilités de l’apprentissage par transfert, consulte notre entrée de glossaire et envisage l’évolution des hyperparamètres pour optimiser les performances.
Environnements pris en charge#
Ultralytics propose divers environnements prêts à l’emploi avec des dépendances essentielles comme CUDA, CuDNN, Python et PyTorch préinstallées.
- Notebooks GPU gratuits :


- Google Cloud : Guide de démarrage rapide GCP
- Amazon : Guide de démarrage rapide AWS
- Azure : Guide de démarrage rapide AzureML
- Docker : Guide de démarrage rapide Docker

État du projet#

Ce badge confirme la réussite de tous les tests d’intégration continue (CI) des GitHub Actions de YOLOv5. Ces tests CI évaluent rigoureusement les fonctionnalités et les performances de YOLOv5 pour des opérations clés : entraînement, validation, inférence, export et tests de performance. Ils garantissent un fonctionnement cohérent et fiable sous macOS, Windows et Ubuntu. Ils s’exécutent automatiquement toutes les 24 heures et à chaque nouvel envoi de code.
FAQ#
Cette option gèle les premiers
Nmodules demodel.model, de sorte que leurs poids restent fixes et ne reçoivent aucun gradient.--freeze 10gèle le backbone, et--freeze 24gèle tout sauf le module finalDetect.Dans l’expérience VOC ci-dessus, l’entraînement de toutes les couches a donné la meilleure mAP, le gel du backbone a légèrement réduit la précision, et le gel de toutes les couches sauf la tête de détection a entraîné la plus forte baisse. En contrepartie, les entraînements avec des couches gelées sont plus rapides et utilisent beaucoup moins de mémoire GPU.
Lorsque tes images partagent des caractéristiques de bas niveau avec les données de préentraînement, que ton jeu de données est petit ou que tu as besoin d’une référence rapide sur du matériel limité. Entraîne toutes les couches lorsque le jeu de données s’agrandit ou si tu veux gagner les derniers points de mAP.
Oui. Lance une nouvelle exécution à partir du
best.ptdu modèle gelé, sans--freeze, pour ajuster finement l’ensemble du réseau, généralement avec un taux d’apprentissage plus faible.