Conseils pour obtenir les meilleurs résultats avec YOLOv5
Ce guide explique comment obtenir le meilleur mAP et les meilleurs résultats d’entraînement avec YOLOv5.
La plupart du temps, tu peux obtenir de bons résultats sans modifier les modèles ni les paramètres d’entraînement, à condition que ton jeu de données soit suffisamment volumineux et correctement étiqueté. Si tu n’obtiens pas de bons résultats dès le début, tu peux prendre certaines mesures pour les améliorer, mais nous recommandons toujours de commencer par entraîner le modèle avec tous les paramètres par défaut avant d’envisager des changements. Cela permet d’établir une référence de performance et de repérer les points à améliorer.
Si tu as des questions sur tes résultats d’entraînement, fournis autant d’informations que possible pour obtenir une réponse utile, notamment les graphiques de résultats (pertes d’entraînement, pertes de validation, P, R, mAP), la courbe PR, la matrice de confusion, les mosaïques d’entraînement, les résultats des tests et les images de statistiques du jeu de données, comme labels.png. Tous ces éléments se trouvent dans ton répertoire project/name, généralement yolov5/runs/train/exp.
Les sections ci-dessous présentent les principaux facteurs qui influent sur les résultats d’entraînement de YOLOv5.
Jeu de données#
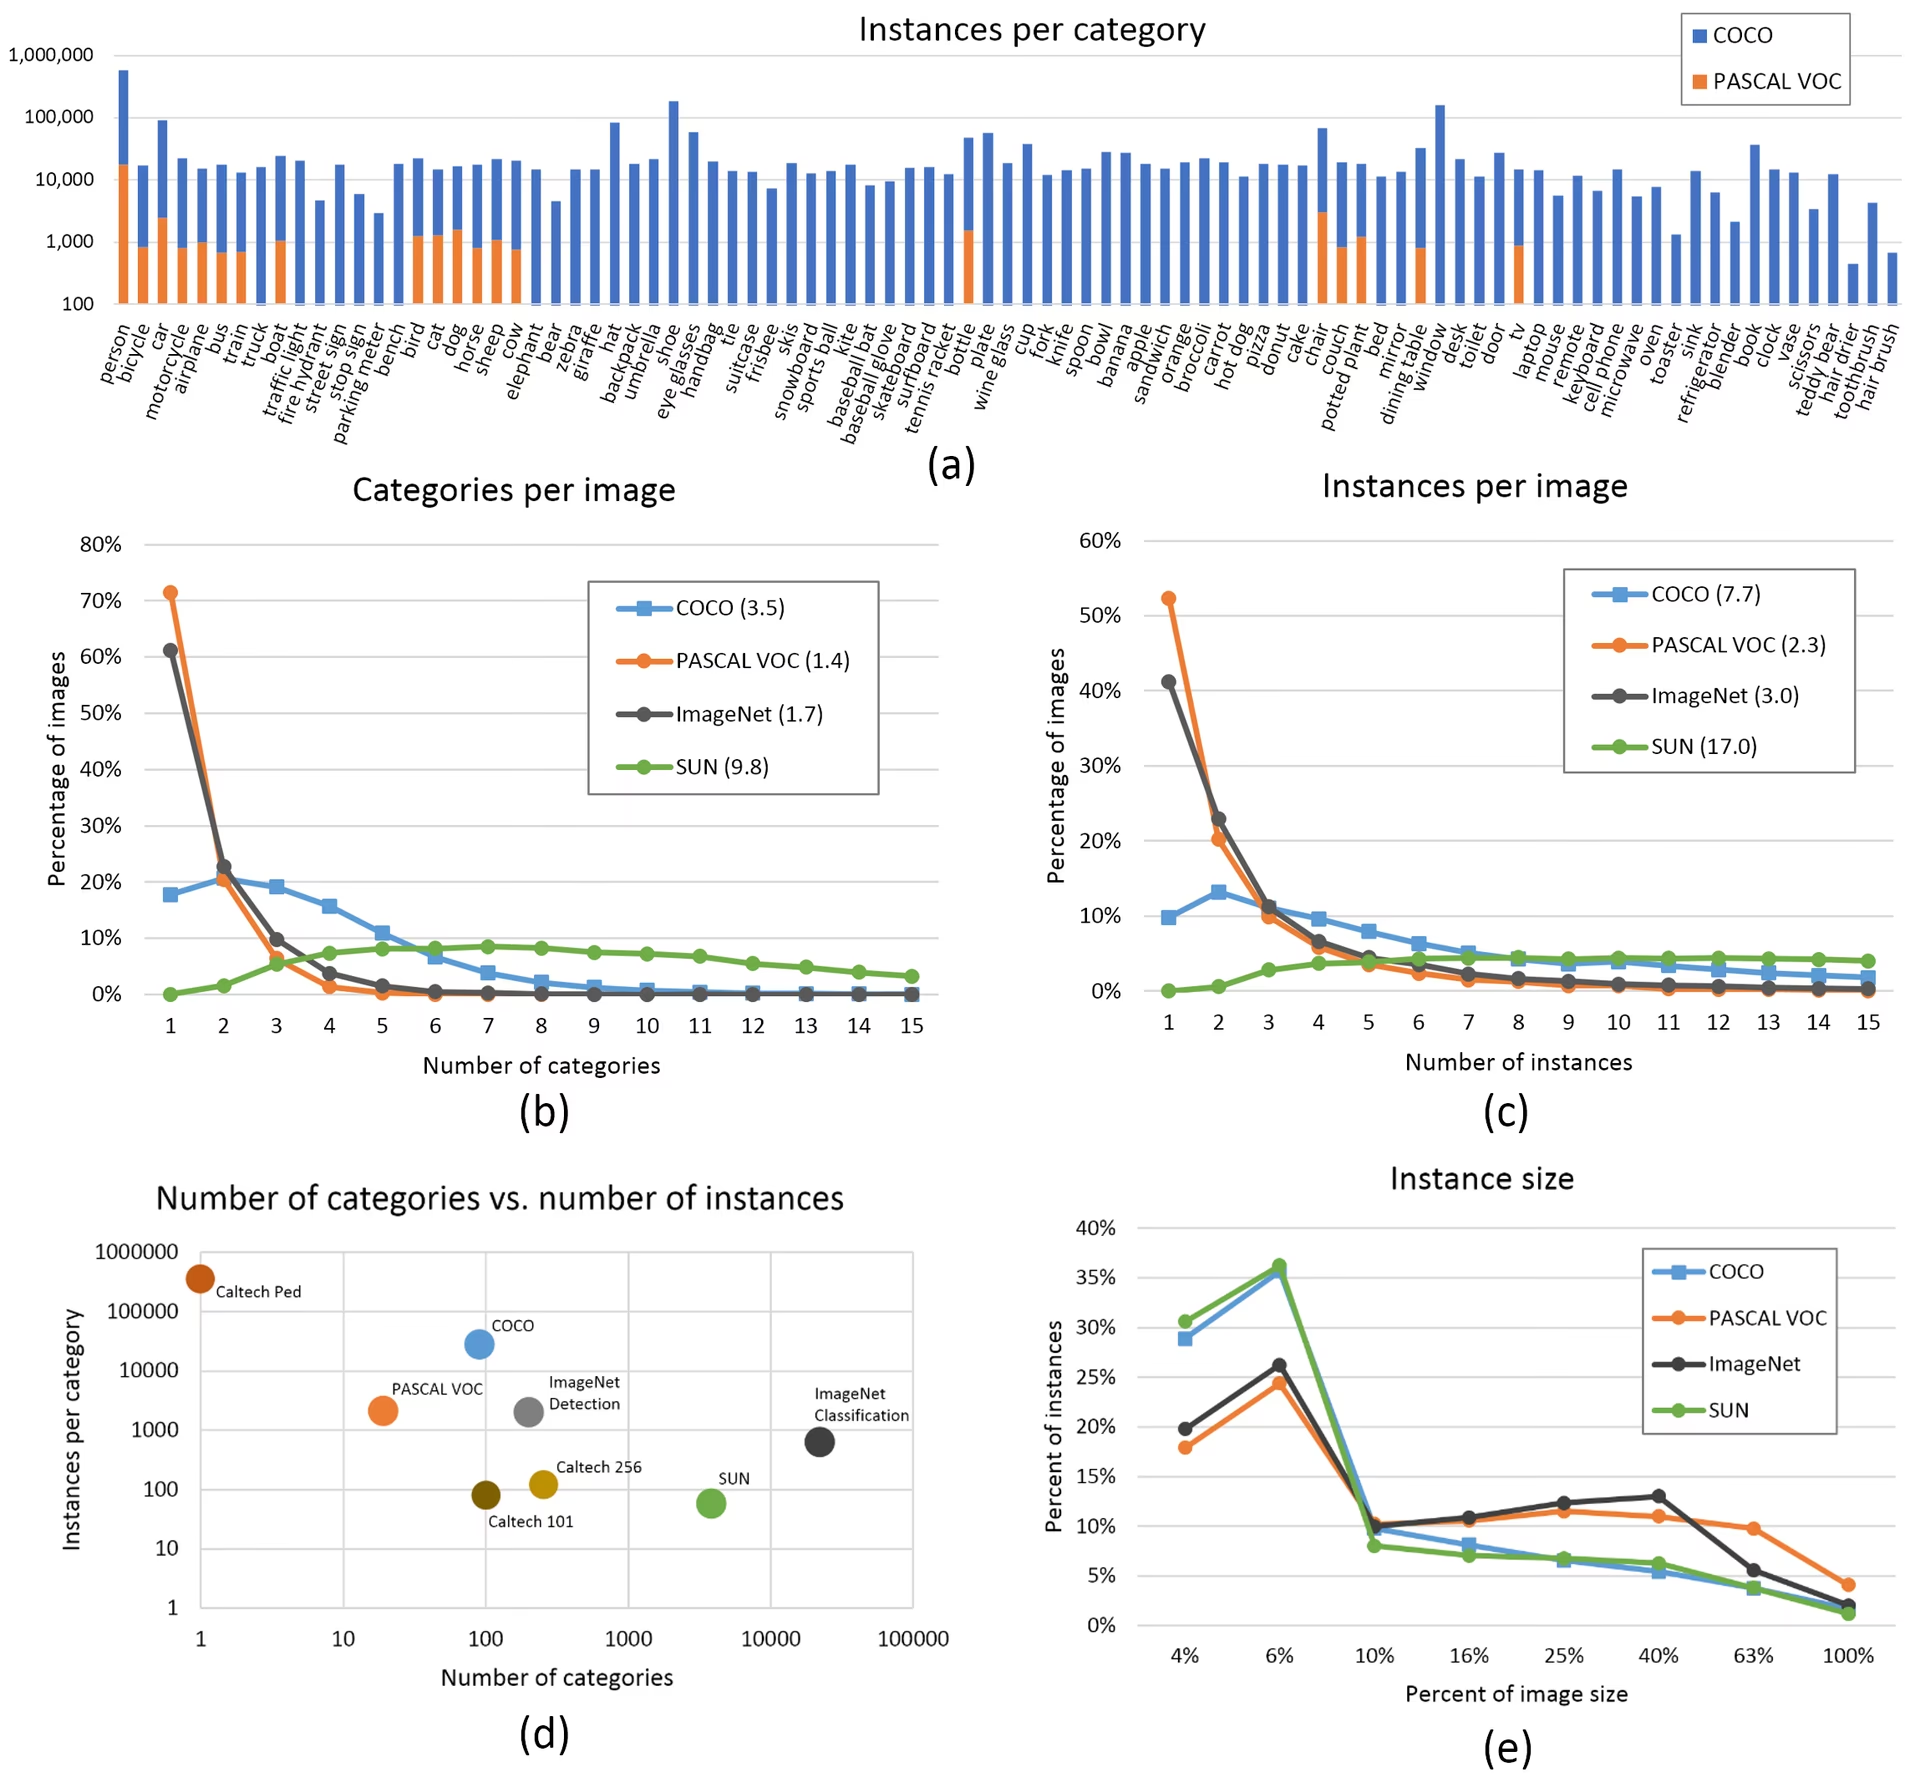
- Images par classe. Nous recommandons au moins 1 500 images par classe.
- Instances par classe. Nous recommandons au moins 10 000 instances (objets annotés) par classe.
- Variété des images. Les images doivent représenter l'environnement de déploiement. Pour les cas d'utilisation réels, nous recommandons des images prises à différents moments de la journée, au fil des saisons, dans différentes conditions météorologiques et lumineuses, sous différents angles et provenant de diverses sources (collectées en ligne, recueillies localement, prises avec différents appareils photo), etc.
- Cohérence des annotations. Toutes les instances de toutes les classes présentes dans toutes les images doivent être annotées. Une annotation partielle ne fonctionnera pas.
- Précision des annotations. Les annotations doivent délimiter précisément chaque objet. Il ne doit pas y avoir d'espace entre un objet et sa boîte englobante. Aucun objet ne doit être dépourvu d'étiquette.
- Respect de la séparation entraînement/validation. Veille à ce que les images de validation et de test ne figurent jamais dans le jeu d'entraînement, afin d'éviter des métriques trop optimistes. Maintiens des répartitions de classes similaires entre les sous-ensembles.
- Vérification des étiquettes. Affiche les
train_batch*.jpgmosaïques au début de l’entraînement pour vérifier que tes étiquettes sont correctes. - Images d'arrière-plan. Les images d'arrière-plan sont des images sans objet ajoutées à un jeu de données pour réduire les faux positifs (FP). Nous recommandons d'inclure environ 0 à 10 % d'images d'arrière-plan pour réduire les FP (COCO en compte 1 000 à titre de référence, soit 1 % du total). Les images d'arrière-plan ne nécessitent aucune annotation.
Choix du modèle#
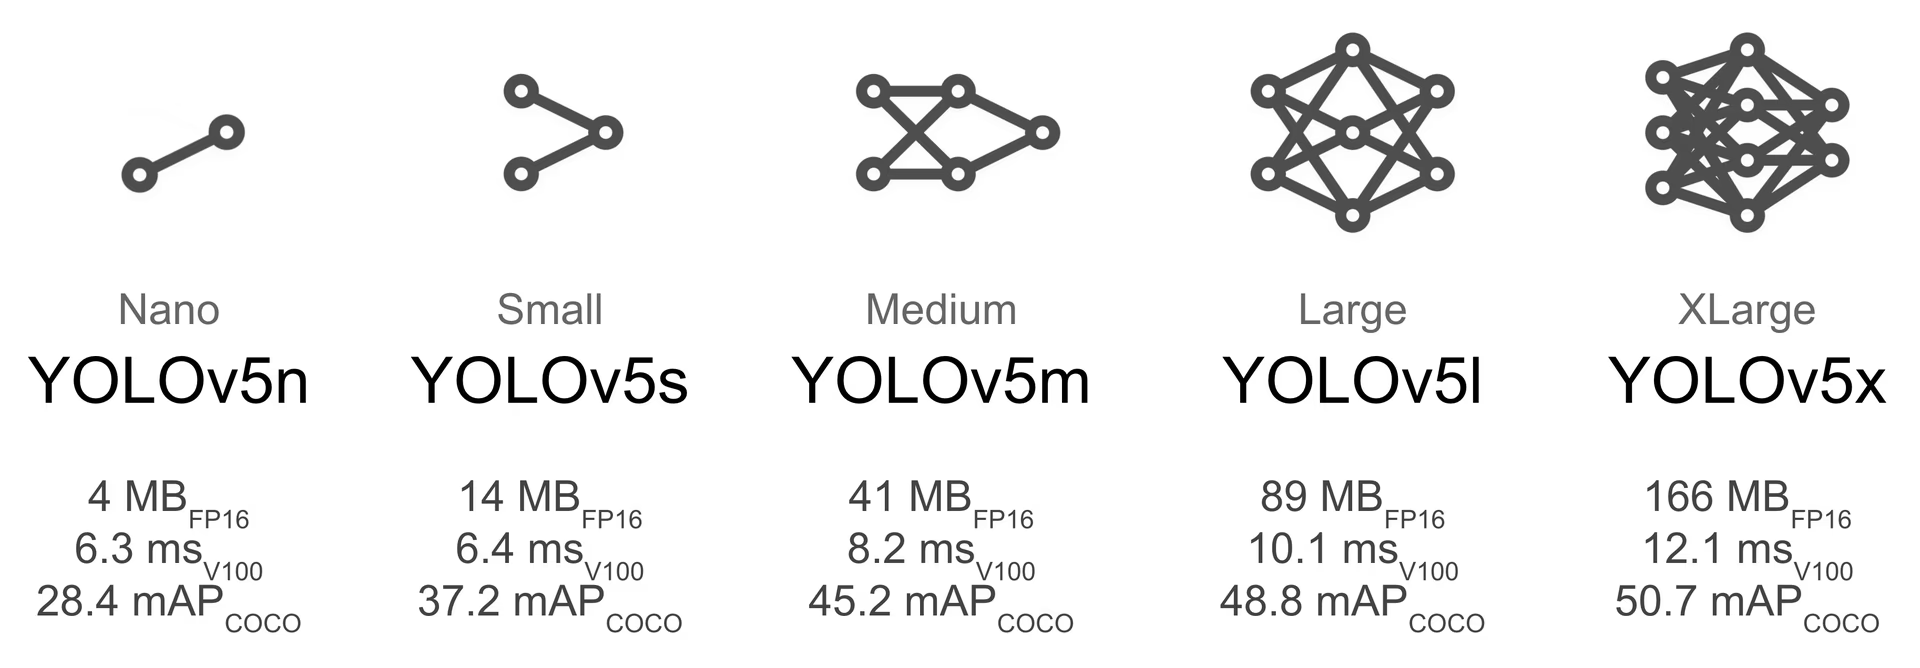
Les modèles plus grands comme YOLOv5x et YOLOv5x6 produisent de meilleurs résultats dans presque tous les cas, mais comportent davantage de paramètres, nécessitent plus de mémoire CUDA pour l’entraînement et s’exécutent plus lentement. Pour les déploiements mobiles, nous recommandons YOLOv5s/m ; pour les déploiements cloud, nous recommandons YOLOv5l/x.
-
Partir de poids préentraînés. Recommandé pour les jeux de données de petite ou moyenne taille (par exemple, VOC, VisDrone, GlobalWheat). Indique le nom du modèle dans l’argument
--weights. Les modèles sont téléchargés automatiquement depuis la dernière version de YOLOv5.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Partir de zéro. Recommandé pour les grands jeux de données (par exemple, COCO, Objects365, OIv6). Indique le YAML de l’architecture du modèle qui t’intéresse, ainsi qu’un argument
--weights ''vide :python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Paramètres d'entraînement#
Avant de modifier quoi que ce soit, commence par entraîner le modèle avec les paramètres par défaut pour établir une référence de performance. Tu trouveras la liste complète des paramètres de train.py dans l'analyseur d'arguments de train.py.
- Époques. Commence par 300 époques. Si le surapprentissage apparaît trop tôt, tu peux réduire le nombre d’époques. Si le surapprentissage ne se produit pas après 300 époques, prolonge l’entraînement, par exemple jusqu’à 600 ou 1 200 époques.
- Taille des images. COCO est entraîné à sa résolution native
--img 640, mais, en raison du grand nombre de petits objets dans le jeu de données, l’entraînement à des résolutions plus élevées comme--img 1280peut améliorer les résultats. Si ton jeu de données personnalisé contient beaucoup de petits objets, l’entraînement à la résolution native ou à une résolution supérieure peut être bénéfique. Les meilleurs résultats d’inférence sont obtenus à la même--imgque celle utilisée pour l’entraînement ; par exemple, si tu entraînes le modèle en--img 1280, tu dois aussi le tester et détecter des objets en--img 1280. - Taille du lot. Utilise la plus grande valeur
--batch-sizeque ton matériel peut prendre en charge. Les petites tailles de lot produisent des statistiques de normalisation par lot médiocres et sont à éviter. Tu peux utiliser--batch-size -1pour sélectionner automatiquement la taille de lot optimale pour ton GPU. - Taux d'apprentissage. Le calendrier de taux d'apprentissage par défaut donne de bons résultats dans la plupart des cas. Pour accélérer la convergence, tu peux essayer l'indicateur
--cos-lrafin d'activer un calendrier de taux d'apprentissage cosinus, qui réduit progressivement le taux d'apprentissage en suivant une courbe cosinus au fil des époques. - Augmentation des données. YOLOv5 inclut différentes techniques d'augmentation, comme la mosaïque, qui combine plusieurs images d'entraînement. Ajuste l'intensité de l'augmentation à l'aide de l'hyperparamètre
mosaicdans ton fichier--hyppour stabiliser l'entraînement. - Hyperparamètres. Les hyperparamètres par défaut se trouvent dans hyp.scratch-low.yaml. Nous te recommandons de commencer par entraîner le modèle avec les hyperparamètres par défaut avant d'envisager de les modifier. En général, augmenter les hyperparamètres d'augmentation réduit et retarde le surapprentissage, ce qui permet de prolonger l'entraînement et d'obtenir un mAP final plus élevé. Réduire les hyperparamètres de pondération des composantes de perte, comme
hyp['obj'], aide à réduire le surapprentissage pour ces composantes spécifiques. Pour optimiser ces hyperparamètres automatiquement, consulte notre tutoriel sur l'évolution des hyperparamètres. - Entraînement en précision mixte. YOLOv5 active automatiquement la précision mixte automatique (AMP) lorsqu'un GPU compatible est détecté, ce qui accélère l'entraînement et réduit l'utilisation de la mémoire sans compromettre la précision du modèle.
- Entraînement multi-GPU. Si tu disposes de plusieurs GPU, lance l’entraînement DistributedDataParallel avec
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3pour réduire considérablement le temps d’entraînement. - Arrêt anticipé. Utilise
--patience 50pour interrompre l'entraînement si les métriques de validation ne s'améliorent pas pendant 50 époques, afin de gagner du temps et d'éviter le surapprentissage.
Techniques d'optimisation avancées#
- Apprentissage par transfert. Pour les jeux de données spécialisés, commence avec des poids préentraînés et, si tu le souhaites, fige des couches à l'aide de
--freezepour adapter le modèle à ta tâche spécifique. - Élagage de modèle. Après l’entraînement, envisage d’élaguer ton modèle pour mettre à zéro les poids redondants avec une faible perte de précision, puis déploie-le avec un moteur d’exécution prenant en charge la parcimonie afin d’accélérer l’inférence.
- Ensemble de modèles. Pour les applications critiques, entraîne plusieurs modèles avec des configurations différentes et combine leurs prédictions pour améliorer la précision.
- Augmentation au moment du test. Active TTA pendant l’inférence avec
--augmentpour améliorer la précision des prédictions en fusionnant celles obtenues à partir de versions retournées et redimensionnées de l’image d’entrée.
Pour aller plus loin#
Pour en savoir plus, tu peux commencer par A Recipe for Training Neural Networks de Karpathy, qui présente des idées d’entraînement applicables à tous les domaines du ML.
Bonne chance, et fais-nous savoir si tu as d’autres questions.
FAQ#
Ton modèle est peut-être en surapprentissage si la perte d’entraînement continue de diminuer tandis que la perte de validation commence à augmenter. Surveille la mAP de validation : si elle plafonne ou diminue alors que la perte d’entraînement continue de s’améliorer, c’est un signe de surapprentissage. Parmi les solutions possibles : ajouter des données d’entraînement, augmenter l’augmentation des données ou appliquer des techniques de régularisation.
La taille de lot optimale dépend de la mémoire de ton GPU. En général, les lots plus grands fournissent de meilleures statistiques de normalisation par lot et une plus grande stabilité d'entraînement. Utilise la plus grande taille de lot que ton matériel peut prendre en charge sans manquer de mémoire. Tu peux utiliser
--batch-size -1pour déterminer automatiquement la taille de lot optimale pour ta configuration.Pour accélérer l’entraînement, essaie d’utiliser plusieurs GPU avec DDP, de mettre en cache ton jeu de données avec
--cacheet d’optimiser la taille de ton lot (la précision mixte est activée automatiquement sur les GPU compatibles). Envisage aussi d’utiliser une variante de modèle plus petite, comme YOLOv5s, si la précision absolue n’est pas essentielle.


Commentaires
Pose une question, partage tes résultats ou aide quelqu’un d’autre.