Élagage et parcimonie des modèles dans YOLOv5#
Ce guide explique comment appliquer l’élagage aux modèles YOLOv5 afin de créer des réseaux plus efficaces tout en préservant leurs performances.
Qu'est-ce que l'élagage de modèles ?#
L’élagage de modèles est une technique permettant de réduire la taille et la complexité des réseaux neuronaux en supprimant les paramètres les moins importants (poids et connexions). Ce processus crée un modèle plus efficace qui présente plusieurs avantages :
- Taille de modèle réduite pour faciliter le déploiement sur des appareils aux ressources limitées
- Inférence plus rapide avec un impact minimal sur la précision
- Utilisation réduite de la mémoire et de l'énergie
- Efficacité globale améliorée pour les applications en temps réel
L’élagage consiste à identifier et à supprimer les paramètres qui contribuent le moins aux performances du modèle, ce qui donne un modèle plus léger d’une précision similaire.
Avant de commencer#
Clone le dépôt et installe requirements.txt dans un environnement Python>=3.8.0, avec notamment PyTorch>=1.8. Les modèles et les jeux de données sont automatiquement téléchargés depuis la dernière version de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Tester les performances de référence#
Avant l’élagage, établis une performance de référence à laquelle te comparer. Cette commande teste YOLOv5x sur COCO val2017 avec des images de 640 pixels. yolov5x.pt est le modèle P5 le plus grand et le plus précis. Les autres options sont les points de contrôle préentraînés plus petits yolov5n.pt, yolov5s.pt, yolov5m.pt et yolov5l.pt, ou ton propre point de contrôle issu de l’entraînement sur un jeu de données personnalisé, par exemple runs/train/exp/weights/best.pt.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSortie :
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
Appliquer l'élagage à YOLOv5x (parcimonie de 30 %)#
Tu peux appliquer l'élagage au modèle à l'aide de la fonction prune() définie dans utils/torch_utils.py. Pour tester un modèle élagué, modifie val.py afin d'élaguer YOLOv5x jusqu'à atteindre une parcimonie de 0.3 (30 % des poids mis à zéro) :
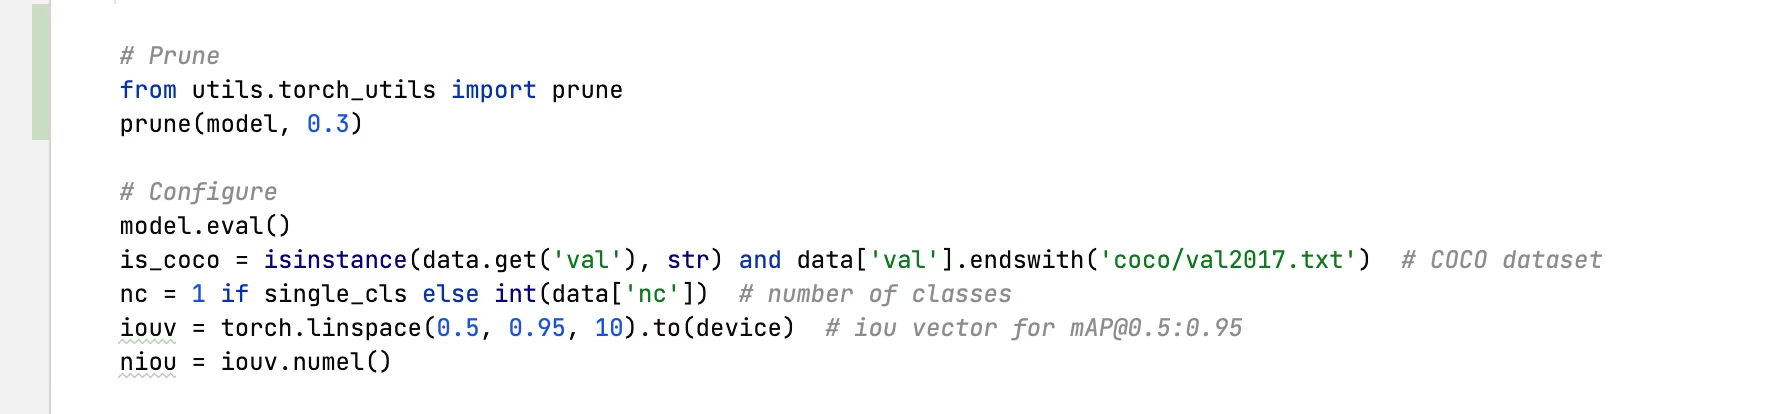
Résultat après un élagage de 30 % :
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
Analyse des résultats#
Les résultats montrent que :
- Parcimonie de 30 % atteinte : 30 % des paramètres de poids du modèle dans les couches
nn.Conv2dsont désormais nuls - Le temps d'inférence reste inchangé : malgré l'élagage, la vitesse de traitement reste pratiquement identique
- Impact minimal sur les performances : le mAP a légèrement baissé, de 0.507 à 0.489 (soit une réduction de seulement 3.6 %)
- Taille du modèle inchangée : les poids mis à zéro sont toujours stockés de manière dense ; la taille du fichier ne diminue donc qu'avec des formats ou une compression prenant en charge les représentations creuses
Cela montre que 30 % des poids de convolution peuvent être supprimés avec un impact minime sur la précision. Pour convertir cette parcimonie en inférence plus rapide ou en fichiers plus petits, il faut un environnement d’exécution sensible à la parcimonie, un élagage structuré ou de la compression.
Ajustement fin des modèles élagués#
Pour obtenir les meilleurs résultats, les modèles élagués doivent faire l'objet d'un ajustement fin après l'élagage afin de retrouver leur précision. Pour cela :
- Applique l'élagage en définissant le niveau de parcimonie souhaité
- Entraîner le modèle élagué pendant quelques époques avec un taux d’apprentissage plus faible
- Évalue le modèle élagué après ajustement fin en le comparant aux performances de référence
Ce processus permet aux paramètres restants de s'adapter pour compenser les connexions supprimées et de retrouver souvent tout ou partie de la précision d'origine.
Environnements pris en charge#
Ultralytics propose différents environnements prêts à l’emploi, chacun préinstallé avec des dépendances essentielles telles que CUDA, cuDNN, Python et PyTorch, pour te permettre de démarrer tes projets.
- Notebooks GPU gratuits :


- Google Cloud : Guide de démarrage rapide GCP
- Amazon : Guide de démarrage rapide AWS
- Azure : Guide de démarrage rapide AzureML
- Docker : Guide de démarrage rapide Docker

État du projet#

Ce badge indique que tous les tests d’intégration continue (CI) de GitHub Actions pour YOLOv5 réussissent. Ces tests CI vérifient rigoureusement le fonctionnement et les performances de YOLOv5 dans plusieurs domaines clés : entraînement, validation, inférence, exportation et tests de performance. Ils garantissent un fonctionnement cohérent et fiable sur macOS, Windows et Ubuntu, grâce à des tests effectués toutes les 24 heures et à chaque nouveau commit.
FAQ#
L'élagage non structuré met les poids à zéro, mais conserve la forme des tenseurs : les noyaux denses de PyTorch effectuent donc la même quantité de calculs. Pour accélérer l'exécution, il faut un environnement d'exécution prenant en charge la parcimonie, comme DeepSparse, ou un élagage structuré qui supprime des canaux entiers.
Appelle la fonction utilitaire de
utils/torch_utils.pyavant la validation ou l'exportation :from utils.torch_utils import prune prune(model, amount=0.3) # Parcimonie globale de 30 % sur les poids nn.Conv2dCommence à 0.3 et mesure le mAP. YOLOv5x a perdu environ 3.6 % de mAP avec une parcimonie de 30 % sans ajustement fin ; les niveaux de parcimonie plus élevés nécessitent généralement quelques époques de réentraînement avec un faible taux d'apprentissage pour retrouver la précision.
Oui. Les poids mis à zéro sont enregistrés comme les autres ;
export.pyfonctionne donc sans modification. La taille du fichier ne diminue que si le format cible ou l'environnement d'exécution compresse les tenseurs creux.
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un d’autre.