Export TFLite, ONNX, CoreML et TensorRT
Ce guide explique comment exporter un modèle YOLOv5 entraîné depuis PyTorch vers divers formats de déploiement, notamment ONNX, TensorRT, CoreML et d’autres.
Avant de commencer#
Clone le dépôt et installe requirements.txt dans un environnement Python>=3.8.0, avec notamment PyTorch>=1.8. Les modèles et les jeux de données sont automatiquement téléchargés depuis la dernière version de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
L’annexe du notebook Colab de YOLOv5 contient un exemple d’exportation vers TensorRT (GPU requis). 
Formats d’exportation pris en charge#
L’inférence YOLOv5 est officiellement prise en charge dans 12 formats :
- Exporte vers ONNX ou OpenVINO pour accélérer le CPU jusqu’à 3 fois. Consulte les benchmarks CPU.
- Exporte vers TensorRT pour accélérer le GPU jusqu’à 5 fois. Consulte les benchmarks GPU.
| Format | export.py --include | Modèle |
|---|---|---|
| PyTorch | - | yolov5s.pt |
| TorchScript | torchscript | yolov5s.torchscript |
| ONNX | onnx | yolov5s.onnx |
| OpenVINO | openvino | yolov5s_openvino_model/ |
| TensorRT | engine | yolov5s.engine |
| CoreML | coreml | yolov5s.mlpackage |
| TensorFlow SavedModel | saved_model | yolov5s_saved_model/ |
| TensorFlow GraphDef | pb | yolov5s.pb |
| TensorFlow Lite | tflite | yolov5s.tflite |
| TensorFlow Edge TPU | edgetpu | yolov5s_edgetpu.tflite |
| TensorFlow.js | tfjs | yolov5s_web_model/ |
| PaddlePaddle | paddle | yolov5s_paddle_model/ |
Benchmarks#
Les benchmarks ci-dessous sont exécutés sur Colab Pro avec le notebook de tutoriel YOLOv5 . Pour les reproduire :
python benchmarks.py --weights yolov5s.pt --imgsz 640 --device 0GPU V100 sur Colab Pro#
benchmarks: weights=/content/yolov5/yolov5s.pt, imgsz=640, batch_size=1, data=/content/yolov5/data/coco128.yaml, device=0, half=False, test=False
Checking setup...
YOLOv5 🚀 v6.1-135-g7926afc torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)
Setup complete ✅ (8 CPUs, 51.0 GB RAM, 46.7/166.8 GB disk)

Benchmarks complete (458.07s)
                   Format      mAP50-95  Inference time (ms)
0                 PyTorch        0.4623                10.19
1             TorchScript        0.4623                 6.85
2                    ONNX        0.4623                14.63
3                OpenVINO           NaN                  NaN
4                TensorRT        0.4617                 1.89
5                  CoreML           NaN                  NaN
6   TensorFlow SavedModel        0.4623                21.28
7     TensorFlow GraphDef        0.4623                21.22
8         TensorFlow Lite           NaN                  NaN
9     TensorFlow Edge TPU           NaN                  NaN
10          TensorFlow.js           NaN                  NaN
CPU sur Colab Pro#
benchmarks: weights=/content/yolov5/yolov5s.pt, imgsz=640, batch_size=1, data=/content/yolov5/data/coco128.yaml, device=cpu, half=False, test=False
Checking setup...
YOLOv5 🚀 v6.1-135-g7926afc torch 1.10.0+cu111 CPU
Setup complete ✅ (8 CPUs, 51.0 GB RAM, 41.5/166.8 GB disk)

Benchmarks complete (241.20s)
                   Format      mAP50-95  Inference time (ms)
0                 PyTorch        0.4623               127.61
1             TorchScript        0.4623               131.23
2                    ONNX        0.4623                69.34
3                OpenVINO        0.4623                66.52
4                TensorRT           NaN                  NaN
5                  CoreML           NaN                  NaN
6   TensorFlow SavedModel        0.4623               123.79
7     TensorFlow GraphDef        0.4623               121.57
8         TensorFlow Lite        0.4623               316.61
9     TensorFlow Edge TPU           NaN                  NaN
10          TensorFlow.js           NaN                  NaN
Exporter un modèle YOLOv5 entraîné#
Cette commande exporte un modèle YOLOv5s préentraîné aux formats TorchScript et ONNX. yolov5s.pt est le modèle « small », le deuxième plus petit modèle disponible. Les autres options sont les points de contrôle préentraînés yolov5n.pt, yolov5m.pt, yolov5l.pt et yolov5x.pt, ainsi que leurs variantes P6, par exemple yolov5s6.pt, ou ton propre point de contrôle d’entraînement personnalisé, par exemple runs/train/exp/weights/best.pt.
python export.py --weights yolov5s.pt --include torchscript onnxAjoute --half pour exporter les modèles en demi-précision FP16 et obtenir des fichiers moins volumineux.
Sortie :
export: data=data/coco128.yaml, weights=['yolov5s.pt'], imgsz=[640, 640], batch_size=1, device=cpu, half=False, inplace=False, train=False, keras=False, optimize=False, int8=False, dynamic=False, simplify=False, opset=12, verbose=False, workspace=4, nms=False, agnostic_nms=False, topk_per_class=100, topk_all=100, iou_thres=0.45, conf_thres=0.25, include=['torchscript', 'onnx']
YOLOv5 🚀 v6.2-104-ge3e5122 Python-3.8.0 torch-1.12.1+cu113 CPU

Downloading https://github.com/ultralytics/yolov5/releases/download/v6.2/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 274MB/s]

Fusing layers...
YOLOv5s summary: 213 layers, 7225885 parameters, 0 gradients

PyTorch: starting from yolov5s.pt with output shape (1, 25200, 85) (14.1 MB)

TorchScript: starting export with torch 1.12.1+cu113...
TorchScript: export success ✅ 1.7s, saved as yolov5s.torchscript (28.1 MB)

ONNX: starting export with onnx 1.12.0...
ONNX: export success ✅ 2.3s, saved as yolov5s.onnx (28.0 MB)

Export complete (5.5s)
Results saved to /content/yolov5
Detect:          python detect.py --weights yolov5s.onnx
Validate:        python val.py --weights yolov5s.onnx
PyTorch Hub:     model = torch.hub.load('ultralytics/yolov5', 'custom', 'yolov5s.onnx')
Visualize:       https://netron.app/
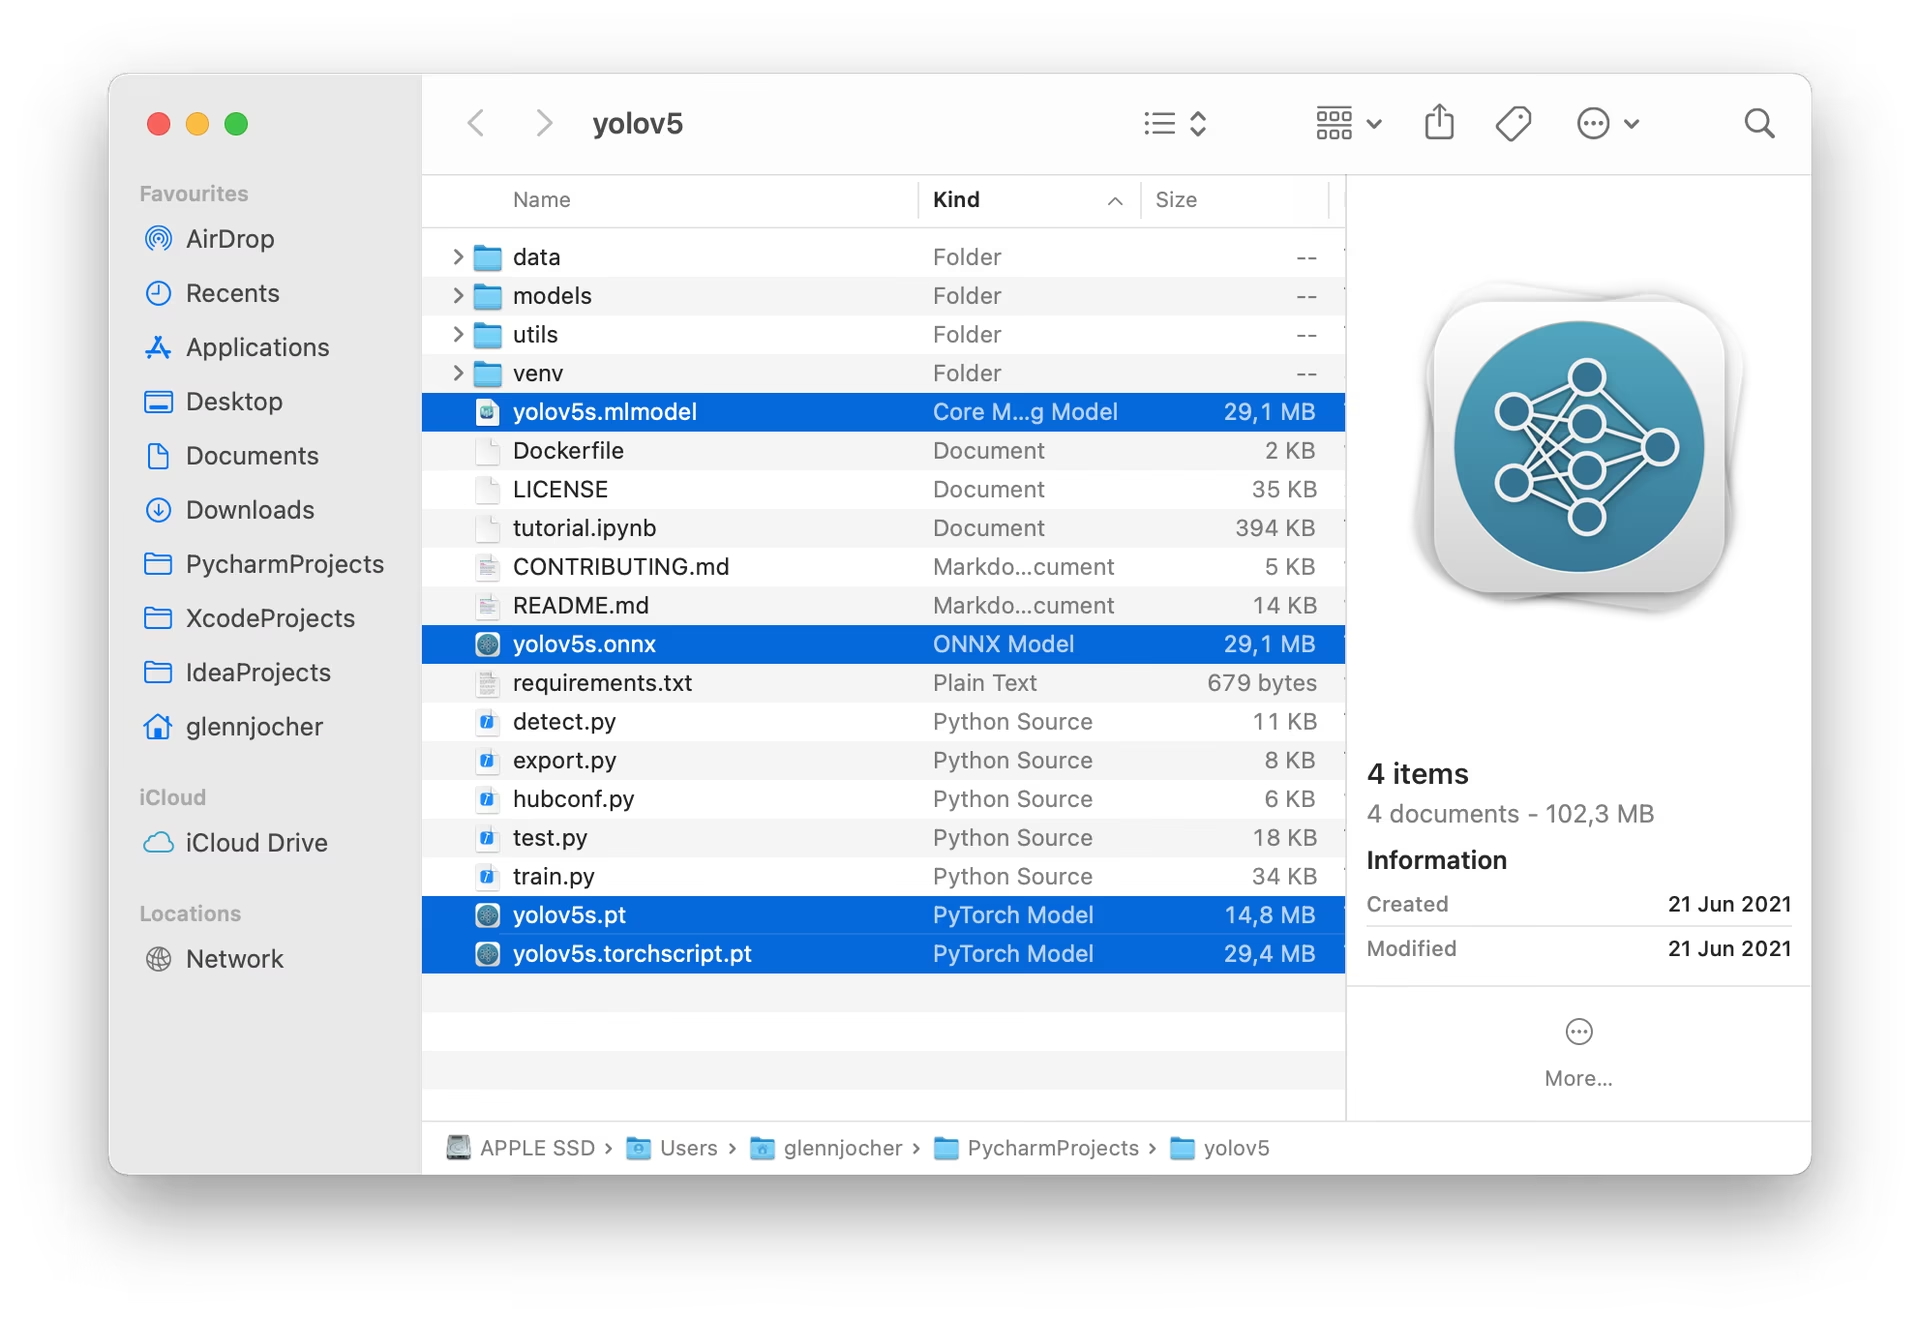
Les modèles exportés sont enregistrés à côté du modèle PyTorch d’origine :
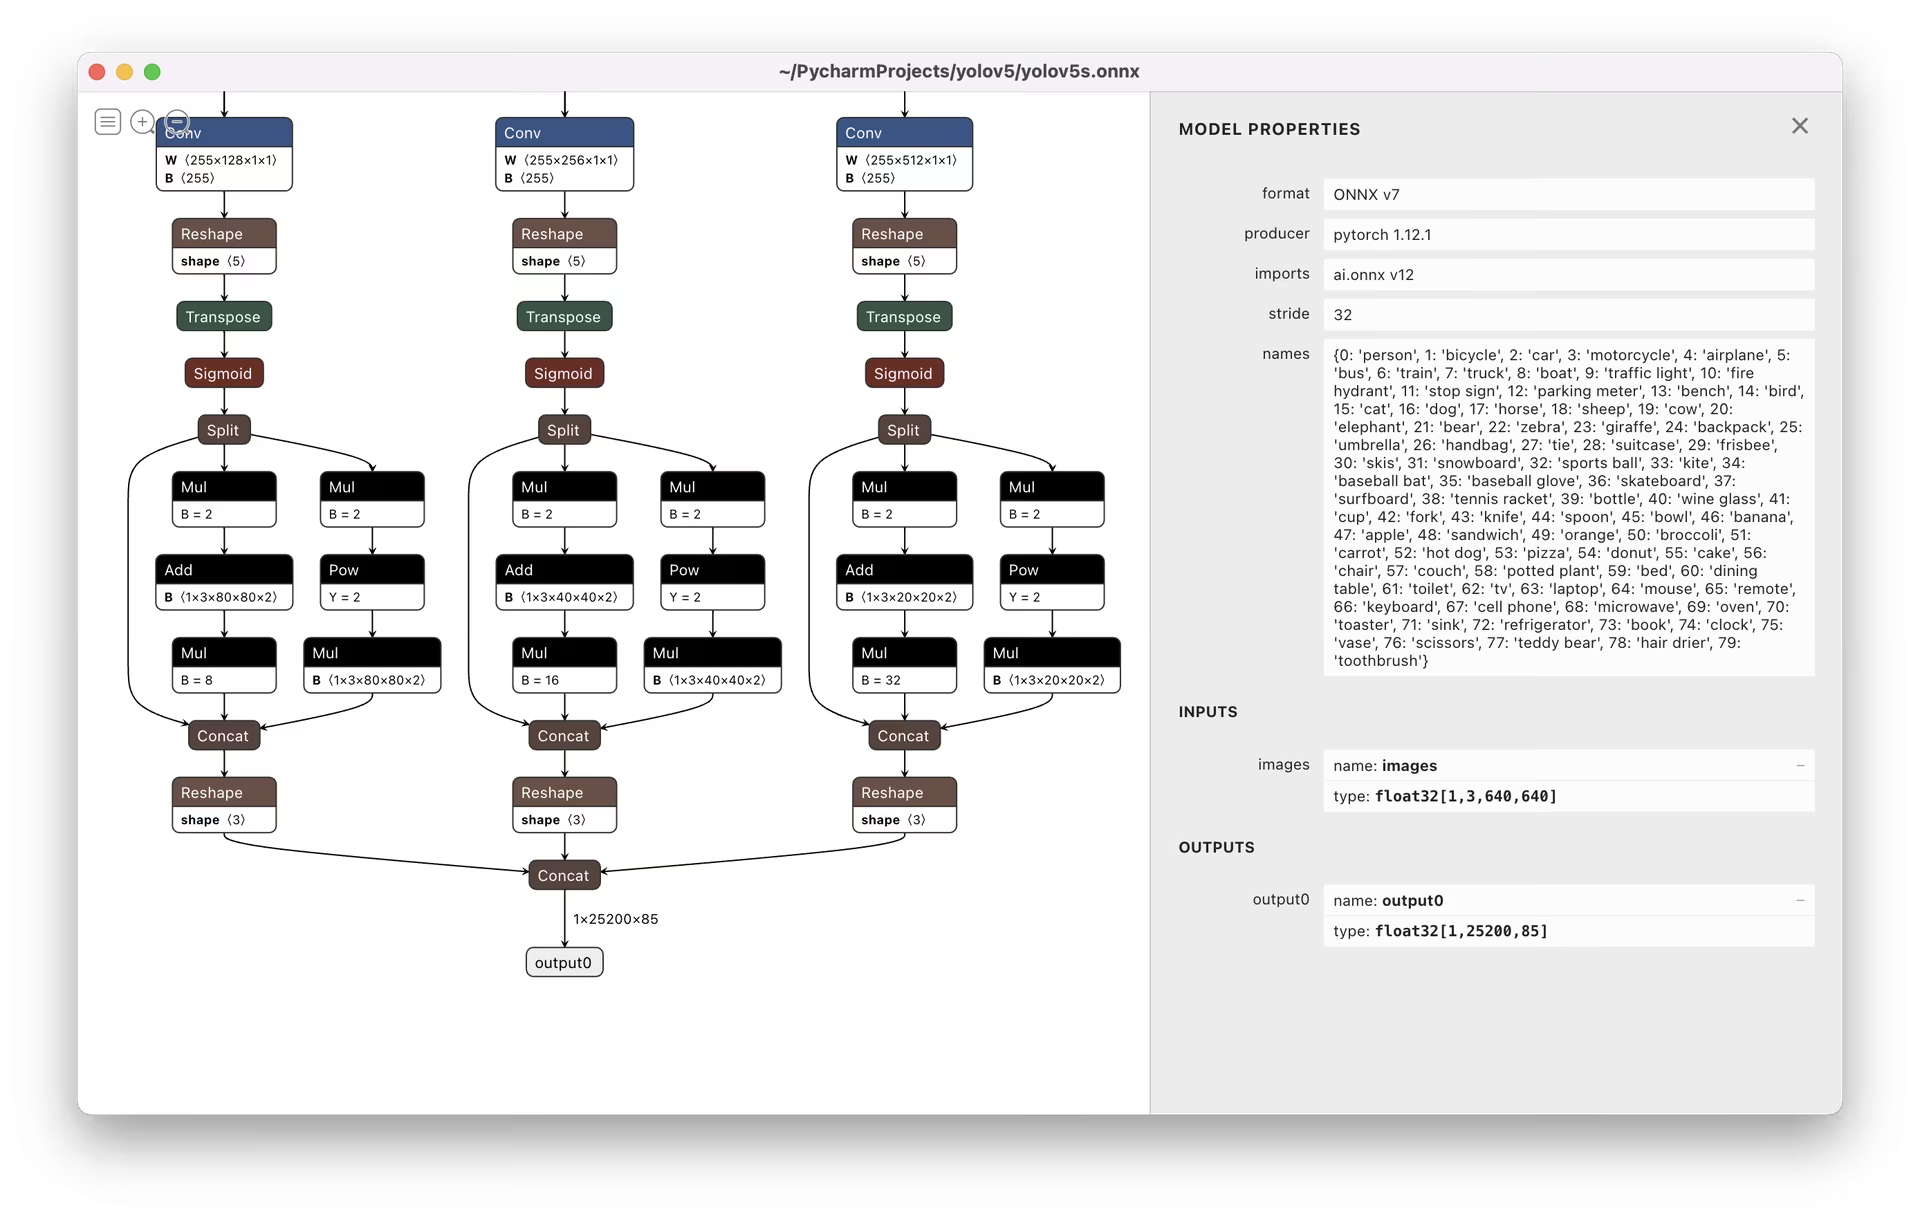
Il est recommandé d’utiliser Netron Viewer pour visualiser les modèles exportés :
Exemples d’utilisation des modèles exportés#
detect.py exécute l’inférence sur les modèles exportés :
python detect.py --weights yolov5s.pt             # PyTorch
python detect.py --weights yolov5s.torchscript    # TorchScript
python detect.py --weights yolov5s.onnx           # ONNX Runtime or OpenCV DNN with --dnn
python detect.py --weights yolov5s_openvino_model # OpenVINO
python detect.py --weights yolov5s.engine         # TensorRT
python detect.py --weights yolov5s.mlpackage      # CoreML (macOS only)
python detect.py --weights yolov5s_saved_model    # TensorFlow SavedModel
python detect.py --weights yolov5s.pb             # TensorFlow GraphDef
python detect.py --weights yolov5s.tflite         # TensorFlow Lite
python detect.py --weights yolov5s_edgetpu.tflite # TensorFlow Edge TPU
python detect.py --weights yolov5s_paddle_model   # PaddlePaddle
val.py exécute la validation sur les modèles exportés :
python val.py --weights yolov5s.pt             # PyTorch
python val.py --weights yolov5s.torchscript    # TorchScript
python val.py --weights yolov5s.onnx           # ONNX Runtime or OpenCV DNN with --dnn
python val.py --weights yolov5s_openvino_model # OpenVINO
python val.py --weights yolov5s.engine         # TensorRT
python val.py --weights yolov5s.mlpackage      # CoreML (macOS only)
python val.py --weights yolov5s_saved_model    # TensorFlow SavedModel
python val.py --weights yolov5s.pb             # TensorFlow GraphDef
python val.py --weights yolov5s.tflite         # TensorFlow Lite
python val.py --weights yolov5s_edgetpu.tflite # TensorFlow Edge TPU
python val.py --weights yolov5s_paddle_model   # PaddlePaddle
Utilise PyTorch Hub avec les modèles YOLOv5 exportés :
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.pt")
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.torchscript")  # TorchScript
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.onnx")  # ONNX Runtime
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_openvino_model")  # OpenVINO
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.engine")  # TensorRT
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.mlpackage")  # CoreML (macOS uniquement)
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_saved_model")  # TensorFlow SavedModel
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.pb")  # TensorFlow GraphDef
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.tflite")  # TensorFlow Lite
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_edgetpu.tflite")  # TensorFlow Edge TPU
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_paddle_model")  # PaddlePaddle

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # or file, Path, PIL, OpenCV, numpy, list

# Inference
results = model(img)

# Results
results.print()  # ou .show(), .save(), .crop(), .pandas(), etc.
Inférence OpenCV DNN#
Inférence OpenCV avec des modèles ONNX :
python export.py --weights yolov5s.pt --include onnx

python detect.py --weights yolov5s.onnx --dnn # detect
python val.py --weights yolov5s.onnx --dnn    # validate
Inférence C++#
Exemples d’inférence YOLOv5 OpenCV DNN en C++ avec un modèle ONNX exporté :
- https://github.com/Hexmagic/ONNX-yolov5/blob/master/src/test.cpp
- https://github.com/doleron/yolov5-opencv-cpp-python
Exemples d’inférence YOLOv5 OpenVINO en C++ :
- https://github.com/dacquaviva/yolov5-openvino-cpp-python
- https://github.com/UNeedCryDear/yolov5-seg-opencv-onnxruntime-cpp
Inférence dans un navigateur Web avec TensorFlow.js#
Environnements pris en charge#
Ultralytics propose différents environnements prêts à l’emploi, chacun préinstallé avec des dépendances essentielles telles que CUDA, cuDNN, Python et PyTorch, pour te permettre de démarrer tes projets.
- Notebooks GPU gratuits :


- Google Cloud : Guide de démarrage rapide GCP
- Amazon : Guide de démarrage rapide AWS
- Azure : Guide de démarrage rapide AzureML
- Docker : Guide de démarrage rapide Docker

État du projet#

Ce badge indique que tous les tests d’intégration continue (CI) de GitHub Actions pour YOLOv5 réussissent. Ces tests CI vérifient rigoureusement le fonctionnement et les performances de YOLOv5 dans plusieurs domaines clés : entraînement, validation, inférence, exportation et tests de performance. Ils garantissent un fonctionnement cohérent et fiable sur macOS, Windows et Ubuntu, grâce à des tests effectués toutes les 24 heures et à chaque nouveau commit.
FAQ#
Utilise ONNX ou OpenVINO pour le déploiement sur CPU, où ils sont jusqu’à 3 fois plus rapides que PyTorch, et TensorRT pour les GPU NVIDIA, où il est jusqu’à 5 fois plus rapide. CoreML cible les appareils Apple, tandis que TensorFlow Lite et Edge TPU ciblent Android et le matériel Coral.
Ajoute
--half. La demi-précision nécessite un GPU pour la plupart des formats ; transmets donc également--device 0. CoreML fait exception et permet d’exporter en FP16 sur CPU.Oui. Ajoute
--dynamic. Les exports ONNX prennent en charge des axes dynamiques pour le lot, la hauteur et la largeur, et sont tracés sur CPU ; omets donc--device 0. Les exports TensorRT conservent une taille d’image fixe et ne font varier que la dimension du lot : ils nécessitent toujours--device 0, et--batch-sizedéfinit la taille de lot maximale acceptée par le moteur.Transmets le fichier exporté à
detect.py --weights,val.py --weightsoutorch.hub.load("ultralytics/yolov5", "custom", "yolov5s.onnx"). YOLOv5 sélectionne le backend approprié à partir du suffixe du fichier.


Commentaires
Pose une question, partage tes résultats ou aide quelqu’un d’autre.