Ensembling de modèles YOLOv5#
📚 Ce guide explique comment utiliser l'ensembling de modèles Ultralytics YOLOv5 🚀 pendant les tests et l'inférence pour améliorer le mAP et le rappel.
D'après l'apprentissage ensembliste :
L'ensembling de modèles consiste à créer plusieurs modèles différents pour prédire un résultat, soit en utilisant de nombreux algorithmes de modélisation distincts, soit en utilisant différents jeux de données d'entraînement. Le modèle d'ensemble agrège ensuite les prédictions de chaque modèle de base pour produire une prédiction finale unique sur les données non vues. L'objectif de l'utilisation de modèles d'ensemble est de réduire l'erreur de généralisation des prédictions. Tant que les modèles de base sont diversifiés et indépendants, l'erreur de prédiction du modèle diminue lorsque l'approche par ensemble est utilisée. Cette approche s'appuie sur la sagesse collective pour établir une prédiction. Même si le modèle d'ensemble comprend plusieurs modèles de base, il se comporte et fonctionne comme un modèle unique.
Avant de commencer#
Clone le dépôt et installe requirements.txt dans un environnement Python>=3.8.0, avec PyTorch>=1.8. Les modèles et les jeux de données sont téléchargés automatiquement depuis la dernière version de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Test normal#
Avant l'ensembling, établis les performances de référence d'un modèle unique. Cette commande teste YOLOv5x sur COCO val2017 avec une taille d'image de 640 pixels. yolov5x.pt est le modèle disponible le plus grand et le plus précis. Les autres options sont yolov5n.pt, yolov5s.pt, yolov5m.pt et yolov5l.pt, ou ton propre checkpoint issu de l'entraînement sur un jeu de données personnalisé, c'est-à-dire runs/train/exp/weights/best.pt. Pour plus de détails sur tous les modèles disponibles, consulte le tableau des checkpoints préentraînés.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSortie :
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Test de l'ensemble#
Tu peux combiner plusieurs modèles préentraînés pour les tests et l'inférence en ajoutant simplement d'autres modèles à l'argument --weights dans toute commande val.py ou detect.py existante. Cet exemple teste un ensemble de 2 modèles :
- YOLOv5x
- YOLOv5l6
python val.py --weights yolov5x.pt yolov5l6.pt --data coco.yaml --img 640 --halfTu peux répertorier autant de checkpoints que tu le souhaites, y compris des poids personnalisés tels que runs/train/exp5/weights/best.pt. YOLOv5 exécutera automatiquement chaque modèle et concaténera leurs prédictions pour chaque image avant d'effectuer la NMS.
Sortie :
val: data=./data/coco.yaml, weights=['yolov5x.pt', 'yolov5l6.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients  # Model 1
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients  # Model 2
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']  # Ensemble notice

val: Scanning '../datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:00<00:00, 49695545.02it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [03:58<00:00,  1.52s/it]
                 all       5000      36335      0.747      0.637      0.692      0.502
Speed: 0.1ms pre-process, 39.5ms inference, 2.0ms NMS per image at shape (32, 3, 640, 640)  # <--- ensemble speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.515  # <--- ensemble mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.699
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.557
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.356
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.563
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.668
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.387
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.638
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.689  # <--- ensemble mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.743
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.844
Inférence par ensemble#
Ajoute d'autres modèles à l'argument --weights pour effectuer une inférence par ensemble :
python detect.py --weights yolov5x.pt yolov5l6.pt --img 640 --source data/imagesSortie :
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']

image 1/2 /content/yolov5/data/images/bus.jpg: 640x512 4 persons, 1 bus, 1 tie, Done. (0.063s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 384x640 3 persons, 2 ties, Done. (0.056s)
Results saved to runs/detect/exp2
Done. (0.223s)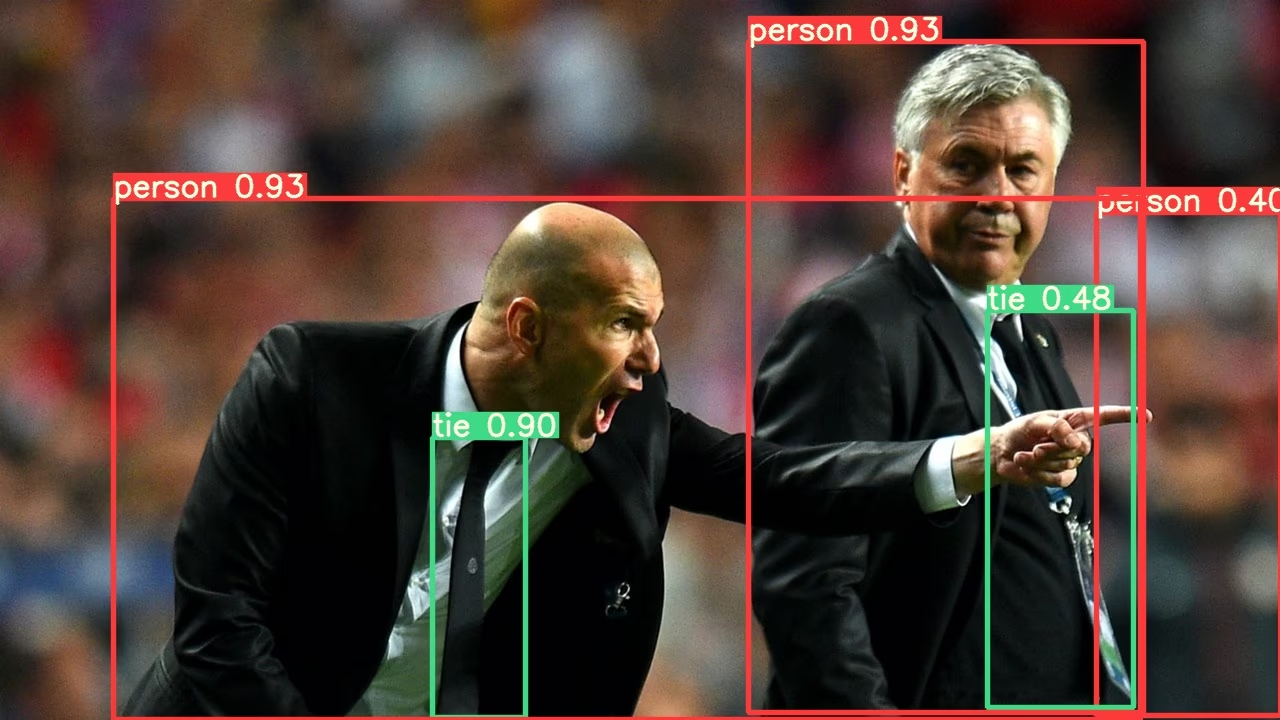
Avantages de l'ensembling de modèles#
L'ensembling de modèles avec YOLOv5 offre plusieurs avantages :
- Précision améliorée : comme le montrent les exemples ci-dessus, l'ensembling de plusieurs modèles augmente le mAP de 0.504 à 0.515 et le mAR de 0.681 à 0.689.
- Meilleure généralisation : la combinaison de modèles diversifiés contribue à réduire le surapprentissage et améliore les performances sur des données variées.
- Robustesse accrue : les ensembles sont généralement plus robustes au bruit et aux valeurs aberrantes dans les données.
- Forces complémentaires : différents modèles peuvent exceller dans la détection de différents types d'objets ou dans des conditions environnementales différentes.
Le principal compromis est l'augmentation du temps d'inférence, comme le montrent les mesures de vitesse (22.4 ms pour un modèle unique contre 39.5 ms pour l'ensemble).
Quand utiliser l'ensembling de modèles#
Envisage l'ensembling de modèles dans les situations suivantes :
- Lorsque la précision compte davantage que la vitesse d'inférence
- Pour les applications critiques où les faux négatifs doivent être réduits au minimum
- Lors du traitement d'images difficiles présentant des variations d'éclairage, des occlusions ou des différences d'échelle
- Lors de compétitions ou d'évaluations comparatives nécessitant des performances maximales
Pour les applications en temps réel soumises à des exigences strictes en matière de latence, l'inférence avec un seul modèle peut être plus appropriée.
Environnements pris en charge#
Ultralytics propose un ensemble d’environnements prêts à l’emploi, chacun préinstallé avec les dépendances essentielles comme CUDA, CUDNN, Python et PyTorch, pour te permettre de démarrer tes projets.
- Notebooks GPU gratuits :


- Google Cloud : Guide de démarrage rapide GCP
- Amazon : Guide de démarrage rapide AWS
- Azure : Guide de démarrage rapide AzureML
- Docker : Guide de démarrage rapide Docker

État du projet#

Ce badge indique que tous les tests d’intégration continue (CI) de GitHub Actions pour YOLOv5 réussissent. Ces tests CI vérifient rigoureusement le fonctionnement et les performances de YOLOv5 dans plusieurs domaines clés : entraînement, validation, inférence, exportation et tests de performance. Ils garantissent un fonctionnement cohérent et fiable sur macOS, Windows et Ubuntu, grâce à des tests effectués toutes les 24 heures et à chaque nouveau commit.
FAQ#
Autant que tu le souhaites. Indique chaque checkpoint après
--weights, par exemple--weights yolov5x.pt yolov5l6.pt runs/train/exp/weights/best.pt. Le temps d'inférence augmente à peu près proportionnellement au nombre de modèles.Oui. Les prédictions sont concaténées avant la NMS : chaque modèle doit donc avoir été entraîné sur la même liste de classes, dans le même ordre. Les tailles d'entrée et les architectures peuvent différer.
Oui. Ajoute
--augmentà la même commandeval.pyoudetect.pypour appliquer la TTA à chaque modèle de l'ensemble.L'ensembling est géré par le module PyTorch
Ensembledansmodels/experimental.py; il ne s'applique donc qu'aux checkpoints.pt. Exporte chaque modèle séparément si tu as besoin de fichiers ONNX ou TensorRT.