Exportation au format Intel OpenVINO#
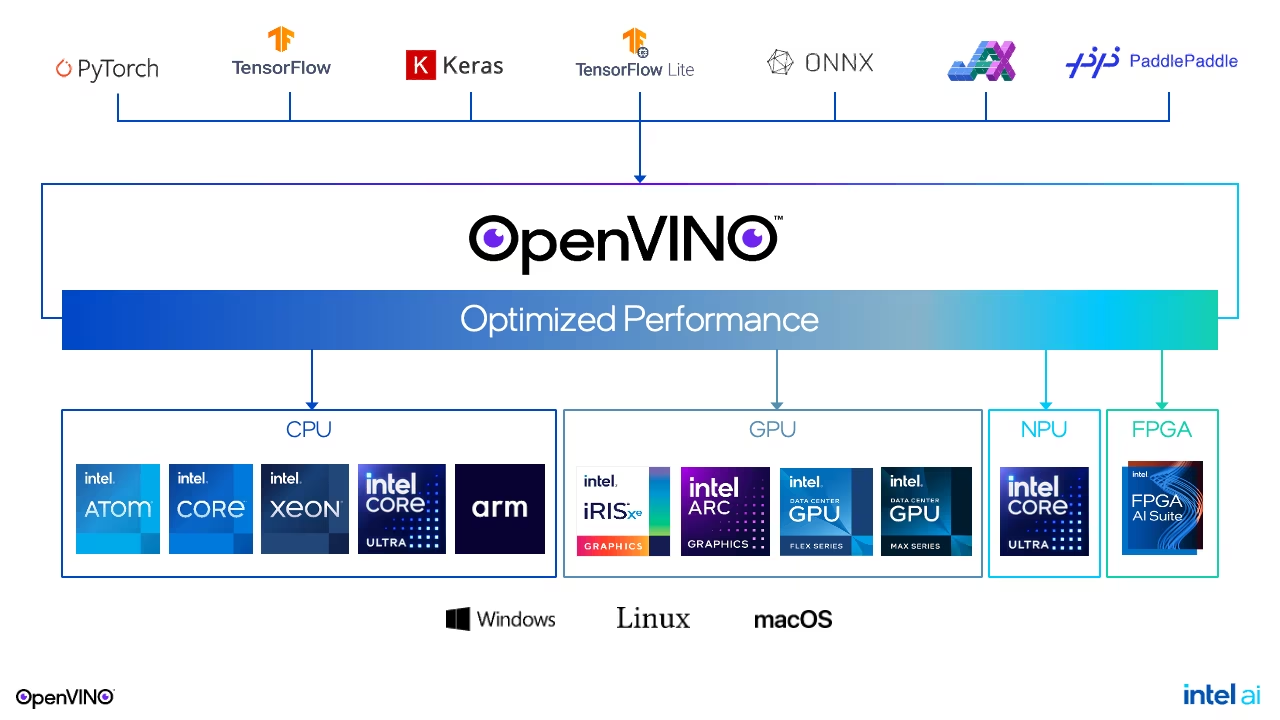
Dans ce guide, nous présentons l’exportation des modèles YOLO26 au format OpenVINO, qui peut accélérer le CPU jusqu’à 3 fois, ainsi qu’accélérer l’inférence YOLO sur le GPU et le NPU Intel.
OpenVINO, abréviation de boîte à outils d’inférence visuelle ouverte et d’optimisation des réseaux neuronaux, est une boîte à outils complète qui permet d’optimiser et de déployer des modèles d’inférence d’IA. Malgré le terme « visuelle » dans son nom, OpenVINO prend également en charge d’autres tâches, notamment le traitement du langage, de l’audio et des séries temporelles.
À regarder : Comment exporter Ultralytics YOLO26 au format Intel OpenVINO pour accélérer l’inférence 🚀
Tâches prises en charge#
L’exportation OpenVINO prend en charge les sept tâches Ultralytics. La segmentation sémantique et l’estimation de profondeur sont disponibles uniquement avec YOLO26, la seule famille qui intègre ces têtes.
| Tâche | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Détecter | ✅ | ✅ | ✅ |
| Segmenter | ✅ | ✅ | ✅ |
| Sémantique | ❌ | ❌ | ✅ |
| Profondeur | ❌ | ❌ | ✅ |
| Classifier | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Installation#
Installe les dépendances d’exportation OpenVINO avec :
pip install "ultralytics[export-openvino]"Ces dépendances sont également incluses dans ultralytics[export] et sont installées automatiquement lorsque l’exportation l’exige.
Exemples d'utilisation#
Le format OpenVINO prend en charge les modes Export, Predict et Validate. Exporte ton modèle, puis charge le modèle exporté pour lancer l’inférence ou valider sa précision sur un CPU Intel, un GPU intégré ou discret, ou un NPU.
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# Exporter le modèle au format OpenVINO
model.export(format="openvino") # creates 'yolo26n_openvino_model/'from ultralytics import YOLO
# Charger le modèle OpenVINO exporté
model = YOLO("yolo26n_openvino_model/")
# Exécuter l’inférence
results = model("https://ultralytics.com/images/bus.jpg")
# Lancer l’inférence sur un appareil spécifique. Appareils disponibles : ["intel:gpu", "intel:npu", "intel:cpu"]
results = model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")from ultralytics import YOLO
# Charger le modèle OpenVINO exporté
model = YOLO("yolo26n_openvino_model/")
# Valider la précision sur le jeu de données COCO8
metrics = model.val(data="coco8.yaml")Arguments d’exportation#
| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
format | str | 'openvino' | Format cible du modèle exporté, qui définit sa compatibilité avec différents environnements de déploiement. |
imgsz | int ou tuple | 640 | Taille d’image souhaitée pour l’entrée du modèle. Peut être un entier pour les images carrées ou un tuple (height, width) pour définir des dimensions spécifiques. |
quantize | int ou str | None | Précision de quantification : 16 (FP16) ou 8 (INT8/PTQ ; nécessite les données de calibration data/fraction) ; 32/non défini correspond à FP32. Remplace les indicateurs obsolètes half/int8. |
dynamic | bool | False | Permet d'utiliser des tailles d'entrée dynamiques, offrant ainsi une plus grande flexibilité pour traiter des images de dimensions variables. |
nms | bool, facultatif | None | Sélectionne la sortie brute (None, par défaut), NMS intégrée (True) ou la tête sans NMS (False). |
batch | int | 1 | Indique la taille de lot pour l’inférence du modèle exporté ou le nombre maximal d’images que le modèle exporté traitera simultanément en mode predict. |
data | str | None | Chemin vers le fichier YAML du jeu de données, indispensable à la quantification ; pour la classification, un répertoire de jeu de données ou le nom d’un jeu de données intégré est requis. Si quantize=8 n’est pas indiqué, Ultralytics sélectionne le jeu de données de calibration par défaut correspondant à la tâche du modèle. |
fraction | float, int ou list | 1.0 | Sous-ensemble de calibration exprimé en ratio, en nombre d’images ou en listes [train, val, test] de ratios/de nombres. Les listes de deux éléments laissent test complet, tandis que 0 l’ignore. |
device | str | None | Indique l’appareil utilisé pour l’exportation : CPU (device=cpu), MPS pour les puces Apple (device=mps). |
Pour en savoir plus sur le processus d’export, consulte la page de la documentation Ultralytics consacrée à l’export.
OpenVINO™ est compatible avec la plupart des processeurs Intel®, mais pour garantir des performances optimales :
-
Vérifie la prise en charge d’OpenVINO™ Vérifie si ta puce Intel® est officiellement prise en charge par OpenVINO™ à l’aide de la liste de compatibilité d’Intel.
-
Identifie ton accélérateur Détermine si ton processeur est équipé d’un NPU (unité de traitement neuronal) ou d’un GPU (GPU intégré) en consultant le guide matériel d’Intel.
-
Installe les derniers pilotes Si ta puce prend en charge un NPU ou un GPU, mais qu’OpenVINO™ ne le détecte pas, tu devras peut-être installer ou mettre à jour les pilotes correspondants. Suis les instructions d’installation des pilotes pour profiter pleinement de l’accélération.
En suivant ces trois étapes, tu peux t’assurer qu’OpenVINO™ fonctionne de manière optimale sur ton matériel Intel®.
Avantages d’OpenVINO#
- Performances : OpenVINO offre une inférence très performante en exploitant la puissance des CPU Intel, des GPU intégrés et discrets, ainsi que des FPGA.
- Prise en charge de l’exécution hétérogène : OpenVINO fournit une API qui permet d’écrire une seule fois et de déployer sur tout matériel Intel pris en charge (CPU, GPU, FPGA, VPU, etc.).
- Optimiseur de modèles : OpenVINO fournit un optimiseur de modèles qui importe, convertit et optimise les modèles issus de frameworks populaires d’apprentissage profond, tels que PyTorch, TensorFlow, TensorFlow Lite, Keras, ONNX, PaddlePaddle et Caffe.
- Facilité d’utilisation : la boîte à outils comprend une grande collection de notebooks de tutoriel (dont un sur l’optimisation de YOLO26) qui présentent différents aspects de la boîte à outils.
Structure de l’exportation OpenVINO#
L’exportation d’un modèle au format OpenVINO génère un répertoire contenant les éléments suivants :
- Fichier XML : décrit la topologie du réseau.
- Fichier BIN : contient les données binaires des poids et des biais.
- Fichier de métadonnées :
metadata.yamlcontient des métadonnées du modèle, comme les noms des classes, la taille de l’image et la tâche. Ultralytics lit ces informations lors du chargement du modèle.
Tu peux utiliser ces fichiers pour lancer l’inférence avec OpenVINO Runtime.
Utilisation de l’exportation OpenVINO pour le déploiement#
Une fois ton modèle exporté au format OpenVINO, tu as deux options principales pour lancer l’inférence :
-
Utilise le paquet
ultralytics, qui fournit une API de haut niveau et encapsule OpenVINO Runtime. -
Utilise le paquet natif
openvinopour mieux contrôler le comportement de l’inférence ou le personnaliser.
Inférence avec Ultralytics#
Le paquet ultralytics te permet de lancer facilement l’inférence à l’aide du modèle OpenVINO exporté, via la méthode predict. Tu peux aussi indiquer l’appareil cible (par exemple, intel:gpu, intel:npu, intel:cpu) à l’aide de l’argument device.
from ultralytics import YOLO

# Charger le modèle OpenVINO exporté
ov_model = YOLO("yolo26n_openvino_model/")  # le chemin vers ton modèle OpenVINO exporté
# Lancer l’inférence avec le modèle exporté
ov_model.predict(device="intel:gpu")  # indiquer l’appareil sur lequel lancer l’inférence
Cette méthode est idéale pour le prototypage rapide ou le déploiement lorsque tu n’as pas besoin de contrôler entièrement le pipeline d’inférence.
Inférence avec OpenVINO Runtime#
OpenVINO Runtime fournit une API unifiée pour l’inférence sur l’ensemble du matériel Intel pris en charge. Il offre également des fonctionnalités avancées, comme l’équilibrage de charge entre les composants matériels Intel et l’exécution asynchrone. Pour en savoir plus sur l’exécution de l’inférence, consulte les notebooks YOLO26.
N’oublie pas que tu auras besoin des fichiers XML et BIN, ainsi que des paramètres propres à l’application, comme la taille d’entrée et le facteur d’échelle de normalisation, pour configurer correctement le modèle et l’utiliser avec Runtime.
Dans ton application de déploiement, tu suivras généralement les étapes suivantes :
- Initialise OpenVINO en créant
core = Core(). - Charge le modèle à l’aide de la méthode
core.read_model(). - Compile le modèle à l’aide de la fonction
core.compile_model(). - Prépare l’entrée (image, texte, audio, etc.).
- Lance l’inférence à l’aide de
compiled_model(input_data).
Pour des étapes plus détaillées et des exemples de code, consulte la documentation OpenVINO ou le tutoriel sur l’API.
Évaluations comparatives de YOLO26 avec OpenVINO#
L’équipe Ultralytics a évalué YOLO26 dans différents formats de modèle et à différentes précisions, en mesurant la vitesse et la précision sur divers appareils Intel compatibles avec OpenVINO.
-
Les résultats d’évaluation comparative ci-dessous sont fournis à titre indicatif. Ils peuvent varier en fonction de la configuration matérielle et logicielle exacte du système, ainsi que de sa charge au moment de l’évaluation.
-
Toutes les évaluations comparatives ont été réalisées avec la version 2026.2.1 du paquet Python
openvino(2026.2.1). -
Les modèles YOLO26 sur NPU sont uniquement pris en charge sur les systèmes Intel® Core™ Ultra™ des séries 2xxV et 3xx, ou ultérieures.
Intel® Core™ Ultra#
La série Intel® Core™ Ultra™ établit une nouvelle référence en matière de calcul haute performance et a été conçue pour répondre aux besoins évolutifs des utilisateurs d’aujourd’hui, des joueurs et créateurs aux professionnels qui exploitent l’IA. Cette gamme de nouvelle génération ne se limite pas à une série de CPU traditionnelle : elle associe de puissants cœurs CPU, des capacités GPU intégrées haute performance et une unité de traitement neuronal (NPU) dédiée au sein d’une seule puce, offrant ainsi une solution unifiée pour diverses charges de calcul exigeantes.
L’architecture Intel® Core Ultra™ repose sur une conception hybride qui assure des performances exceptionnelles pour les tâches de traitement classiques, les charges de travail accélérées par GPU et les opérations basées sur l’IA. L’intégration du NPU améliore l’inférence IA sur l’appareil et accélère l’apprentissage automatique et le traitement des données, tout en réduisant leur consommation de ressources dans un large éventail d’applications.
La famille Core Ultra™ comprend différents modèles adaptés à divers besoins en matière de performances, depuis les conceptions économes en énergie jusqu’aux variantes haute puissance désignées par la lettre « H », idéales pour les ordinateurs portables et les formats compacts qui exigent une forte puissance de calcul. Toute la gamme tire parti de la synergie entre CPU, GPU et NPU intégrés, offrant une efficacité, une réactivité et des capacités multitâches remarquables.
Dans le cadre de l’innovation continue d’Intel, la série Core Ultra™ établit une nouvelle norme pour l’informatique de demain. Avec plusieurs modèles déjà disponibles et d’autres à venir, cette série témoigne de l’engagement d’Intel à proposer des solutions de pointe pour la nouvelle génération d’appareils intelligents dotés de capacités d’IA.
Les évaluations comparatives ci-dessous ont été réalisées sur les processeurs Intel® Core™ Ultra™ X7 358H, Intel® Core™ Ultra™ 7 258V et Intel® Core™ Ultra™ 7 155H, avec les précisions FP32, FP16 et INT8.
Intel® Core™ Ultra™ X7 358H#
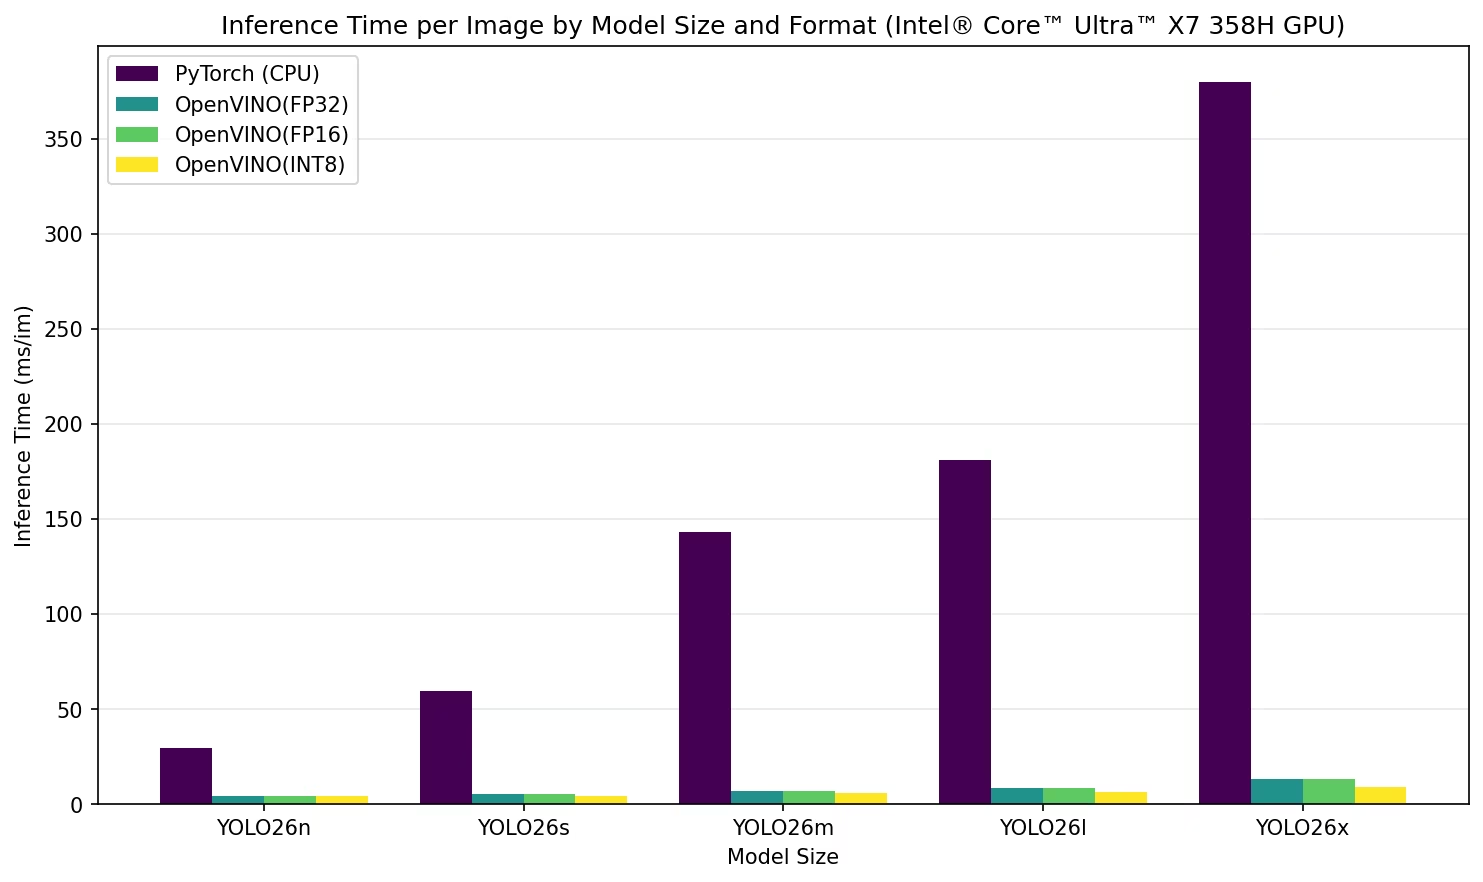
Résultats détaillés des évaluations comparatives
| Modèle | Format | Précision | Statut | Taille (Mo) | metrics/mAP50-95(B) | Temps d’inférence (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 29.28 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.7 | 0.4762 | 4.09 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4762 | 4.03 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 4.24 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 59.32 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 5.08 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.7 | 0.5616 | 5.14 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 4.47 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 143.21 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6166 | 7.1 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6166 | 7.06 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.61 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 181.16 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6205 | 8.45 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6205 | 8.49 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 6.25 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 379.75 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.3 | 0.6568 | 13.03 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 12.98 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 8.74 |
Intel® Core™ Ultra™ 7 258V#
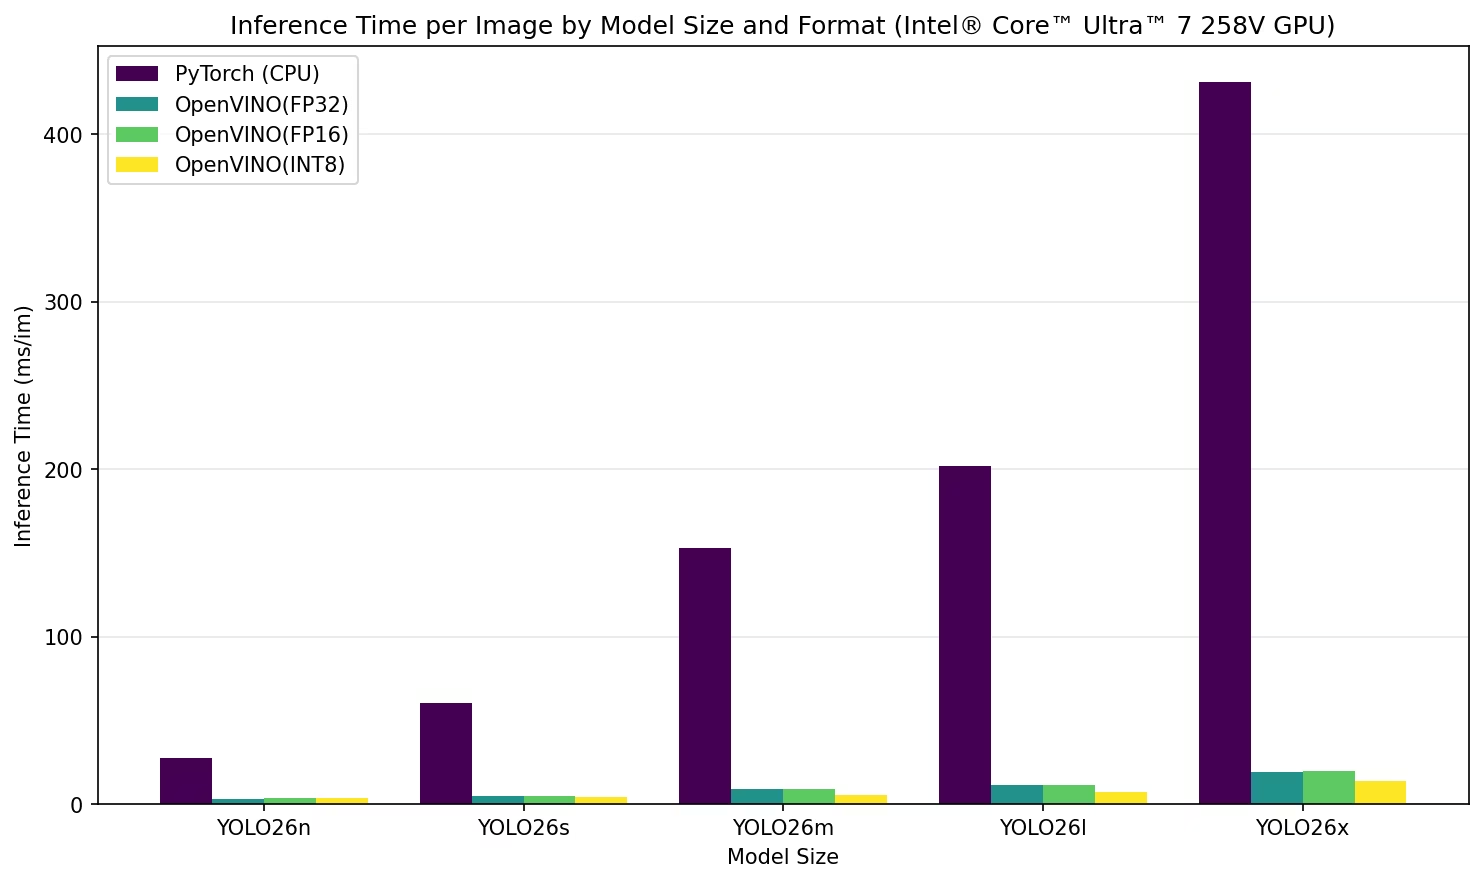
Résultats détaillés des évaluations comparatives
| Modèle | Format | Précision | Statut | Taille (Mo) | metrics/mAP50-95(B) | Temps d’inférence (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 27.33 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4764 | 3.33 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4764 | 3.34 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 3.46 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 60.2 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 4.66 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 4.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 3.99 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 152.87 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6168 | 9.03 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6168 | 8.98 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.7 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 201.57 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6203 | 11.32 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6203 | 11.36 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 7.45 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 431.04 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6568 | 19.08 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 19.63 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 13.69 |
Intel® Core™ Ultra™ 7 155H#
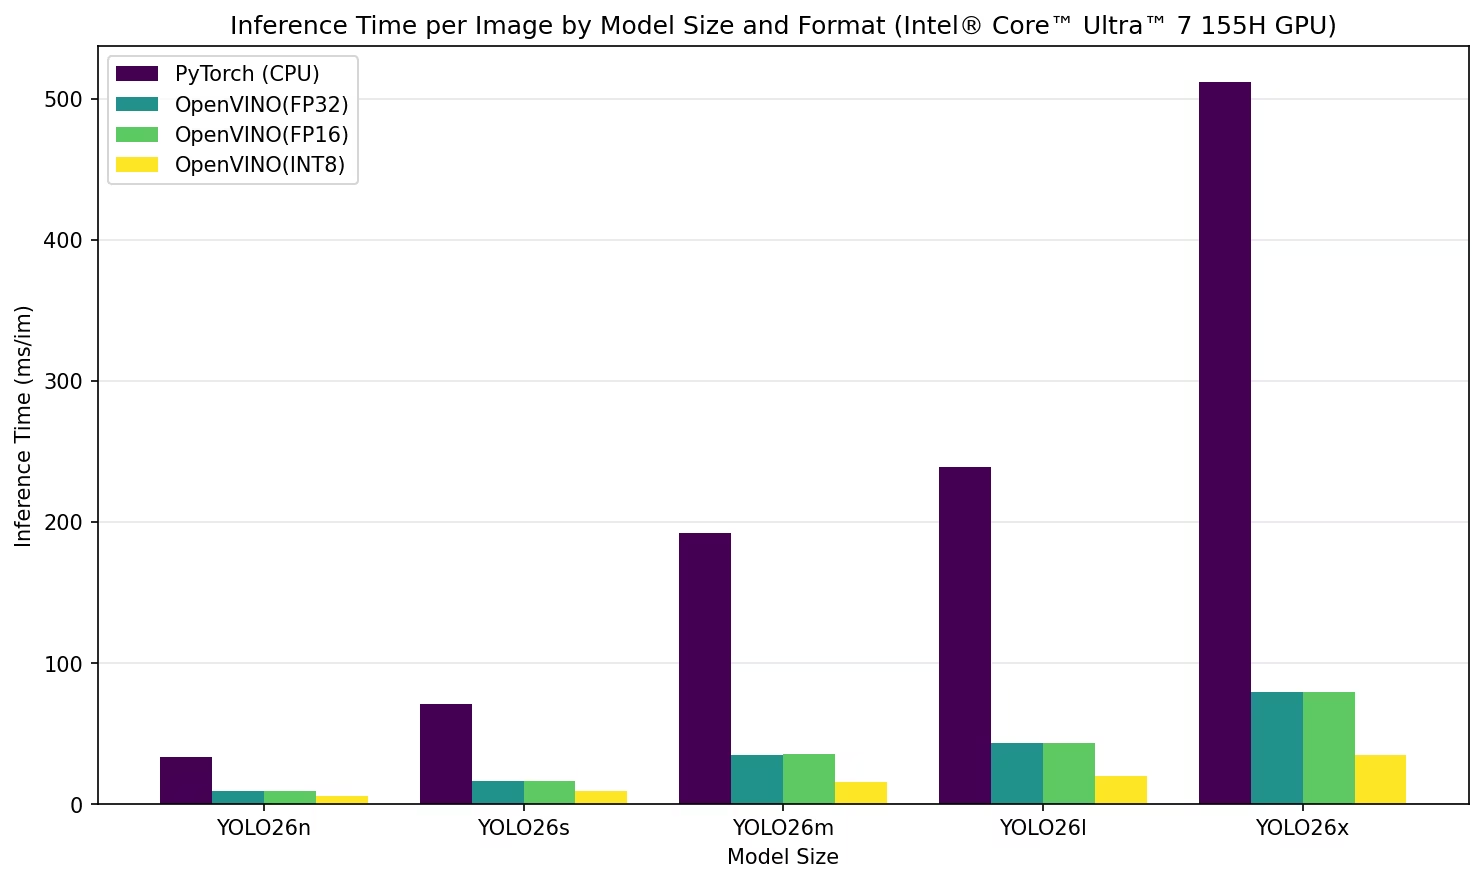
Résultats détaillés des évaluations comparatives
| Modèle | Format | Précision | Statut | Taille (Mo) | metrics/mAP50-95(B) | Temps d’inférence (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 33.19 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4758 | 9.13 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4758 | 9.07 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4573 | 5.79 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 70.92 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 16.37 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 16.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.545 | 9.27 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 192.45 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6167 | 34.47 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6167 | 35.71 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6039 | 15.46 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 239.19 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.621 | 43.24 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.621 | 43.4 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5999 | 19.72 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 511.89 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6552 | 79.49 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6552 | 79.45 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.642 | 34.66 |
Reproduire nos résultats#
Pour reproduire les évaluations comparatives Ultralytics ci-dessus avec tous les formats d’exportation, exécute ce code :
from ultralytics import YOLO

# Charger un modèle YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Évaluer la vitesse et la précision de YOLO26n sur le jeu de données COCO128 dans tous les formats d’exportation
results = model.benchmark(data="coco128.yaml")
Note que les résultats des évaluations comparatives peuvent varier en fonction de la configuration matérielle et logicielle exacte du système, ainsi que de sa charge au moment des tests. Pour obtenir les résultats les plus fiables, utilise un jeu de données contenant un grand nombre d’images, par exemple data='coco.yaml' (5 000 images de validation).
Conclusion#
Les résultats des benchmarks démontrent clairement les avantages de l'exportation du modèle YOLO26 au format OpenVINO. Pour différents modèles et plateformes matérielles, le format OpenVINO offre systématiquement une vitesse d'inférence supérieure à celle des autres formats, tout en maintenant une précision comparable.
Les benchmarks soulignent l'efficacité d'OpenVINO comme outil de déploiement de modèles de deep learning. En convertissant les modèles au format OpenVINO, les développeurs peuvent obtenir des gains de performances importants, ce qui facilite le déploiement de ces modèles dans des applications réelles.
Pour obtenir des informations et des instructions plus détaillées sur l'utilisation d'OpenVINO, consulte la documentation officielle d'OpenVINO.
FAQ#
L'exportation des modèles YOLO26 au format OpenVINO peut considérablement améliorer la vitesse sur CPU et permettre l'accélération sur GPU et NPU sur le matériel Intel. Pour exporter, tu peux utiliser Python ou la CLI, comme indiqué ci-dessous :
Exemplefrom ultralytics import YOLO # Charger un modèle YOLO26n PyTorch model = YOLO("yolo26n.pt") # Exporter le modèle model.export(format="openvino") # creates 'yolo26n_openvino_model/'Pour en savoir plus, consulte la documentation sur les formats d'exportation.
L'utilisation de la boîte à outils OpenVINO d'Intel avec les modèles YOLO26 offre plusieurs avantages :
- Performances : Obtiens une accélération jusqu'à 3x de l'inférence sur CPU et tire parti des GPU et NPU Intel pour accélérer les calculs.
- Optimiseur de modèles : Convertis, optimise et exécute des modèles issus de frameworks populaires comme PyTorch, TensorFlow et ONNX.
- Facilité d'utilisation : Une vaste collection de notebooks de tutoriels est disponible pour aider les utilisateurs à démarrer, notamment des notebooks consacrés à YOLO26.
- Exécution hétérogène : Déploie des modèles sur différents matériels Intel à l'aide d'une API unifiée.
Pour des comparaisons détaillées des performances, consulte notre section des benchmarks.
Après avoir exporté un modèle YOLO26n au format OpenVINO, tu peux exécuter l'inférence avec Python ou la CLI :
Exemplefrom ultralytics import YOLO # Charger le modèle OpenVINO exporté ov_model = YOLO("yolo26n_openvino_model/") # Exécuter l’inférence results = ov_model("https://ultralytics.com/images/bus.jpg")Pour plus de détails, consulte notre documentation sur le mode de prédiction.
Ultralytics YOLO26 est optimisé pour la détection d'objets en temps réel, avec une grande précision et une vitesse élevée. Plus précisément, associé à OpenVINO, YOLO26 offre :
- Une accélération jusqu'à 3x sur les CPU Intel
- Un déploiement fluide sur les GPU et NPU Intel
- Une précision constante et comparable pour divers formats d'exportation
Pour une analyse approfondie des performances, consulte nos benchmarks détaillés de YOLO26 sur différents matériels.
Oui, tu peux comparer les performances des modèles YOLO26 dans différents formats, notamment PyTorch, TorchScript, ONNX et OpenVINO. Utilise l'extrait de code suivant pour lancer les benchmarks sur le jeu de données de ton choix :
Exemplefrom ultralytics import YOLO # Charger un modèle YOLO26n PyTorch model = YOLO("yolo26n.pt") # Comparer la vitesse et la précision de YOLO26n sur le jeu de données COCO8 pour tous les formats d'exportation results = model.benchmark(data="coco8.yaml")Pour consulter les résultats détaillés des benchmarks, reporte-toi à notre section des benchmarks et à notre documentation sur les formats d'exportation.