Évolution des hyperparamètres pour YOLOv5#
📚 Ce guide explique l'évolution des hyperparamètres pour YOLOv5 🚀. L'évolution des hyperparamètres est une méthode d'optimisation des hyperparamètres qui utilise un algorithme génétique (GA) pour l'optimisation.
Les hyperparamètres de l'apprentissage automatique contrôlent différents aspects de l'entraînement, et trouver leurs valeurs optimales peut être difficile. Les méthodes traditionnelles, comme les recherches par grille, peuvent vite devenir inapplicables en raison des facteurs suivants :
- L'espace de recherche de grande dimension
- Les corrélations inconnues entre les dimensions
- Le coût élevé de l'évaluation de la fonction de fitness en chaque point
Les algorithmes génétiques sont donc adaptés à la recherche d'hyperparamètres.
Avant de commencer#
Clone le dépôt et installe requirements.txt dans un environnement Python>=3.8.0, avec PyTorch>=1.8. Les modèles et les jeux de données sont téléchargés automatiquement depuis la dernière version de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Initialiser les hyperparamètres#
YOLOv5 utilise environ 30 hyperparamètres pour différents réglages d'entraînement. Ils sont définis dans les fichiers *.yaml du répertoire /data/hyps. De meilleures valeurs initiales produisent de meilleurs résultats finaux ; il est donc important d'initialiser correctement ces valeurs avant de les faire évoluer. En cas de doute, utilise simplement les valeurs par défaut, qui sont optimisées pour entraîner YOLOv5 sur COCO à partir de zéro.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Définir la fonction de fitness#
La fitness est la valeur que nous cherchons à maximiser. Dans YOLOv5, nous définissons une fonction de fitness par défaut comme une combinaison pondérée de métriques : mAP@0.5 représente 10 % du poids et mAP@0.5:0.95 les 90 % restants, tandis que la précision (P) et le rappel (R) sont exclus. Tu peux les ajuster à ta convenance ou utiliser la définition de fitness par défaut dans utils/metrics.py (recommandé). Cette fitness détermine le résultat enregistré dans hyp_evolve.yaml ; l'algorithme génétique classe les parents et les élites en fonction de mAP@0.5 uniquement, de sorte que la modification de ces poids ne change pas la sélection des parents.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # poids pour [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Faire évoluer#
L’évolution s’effectue à partir d’un scénario de base que nous cherchons à améliorer. Dans cet exemple, le scénario de base consiste à effectuer un ajustement fin de COCO128 pendant 10 époques avec YOLOv5s préentraîné. La commande d’entraînement du scénario de base est la suivante :
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cachePour faire évoluer les hyperparamètres propres à ce scénario, à partir de nos valeurs initiales définies dans la section 1. et en maximisant la fonction de fitness définie dans la section 2., ajoute --evolve :
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
Par défaut, l’évolution s’exécute sur 300 générations, et chaque génération entraîne le scénario de base une fois pour chacun des 50 individus de la population. Tu peux modifier le nombre de générations avec l’argument --evolve, par exemple python train.py --evolve 1000.
Les principaux opérateurs génétiques sont le croisement et la mutation. À chaque génération, chaque individu est entraîné et évalué selon mAP@0.5, les parents sont sélectionnés par tournoi avec les élites les plus performantes ajoutées au groupe de parents, puis la génération suivante est créée par croisement et mutation, avec des taux qui s’adaptent au fil de l’évolution. Les résultats sont consignés dans runs/evolve/exp/evolve.csv, et l’individu issu de la génération ayant la fitness la plus élevée est enregistré à chaque génération sous runs/evolve/exp/hyp_evolve.yaml :
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
Pour obtenir les meilleurs résultats, nous recommandons au moins 300 générations d’évolution. Note que l’évolution est généralement coûteuse et chronophage, car le scénario de base est entraîné des milliers de fois, ce qui peut nécessiter des centaines, voire des milliers d’heures GPU.
Une fois l’évolution terminée, réutilise les paramètres trouvés en lançant l’entraînement avec le fichier enregistré, par exemple python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. Visualiser#
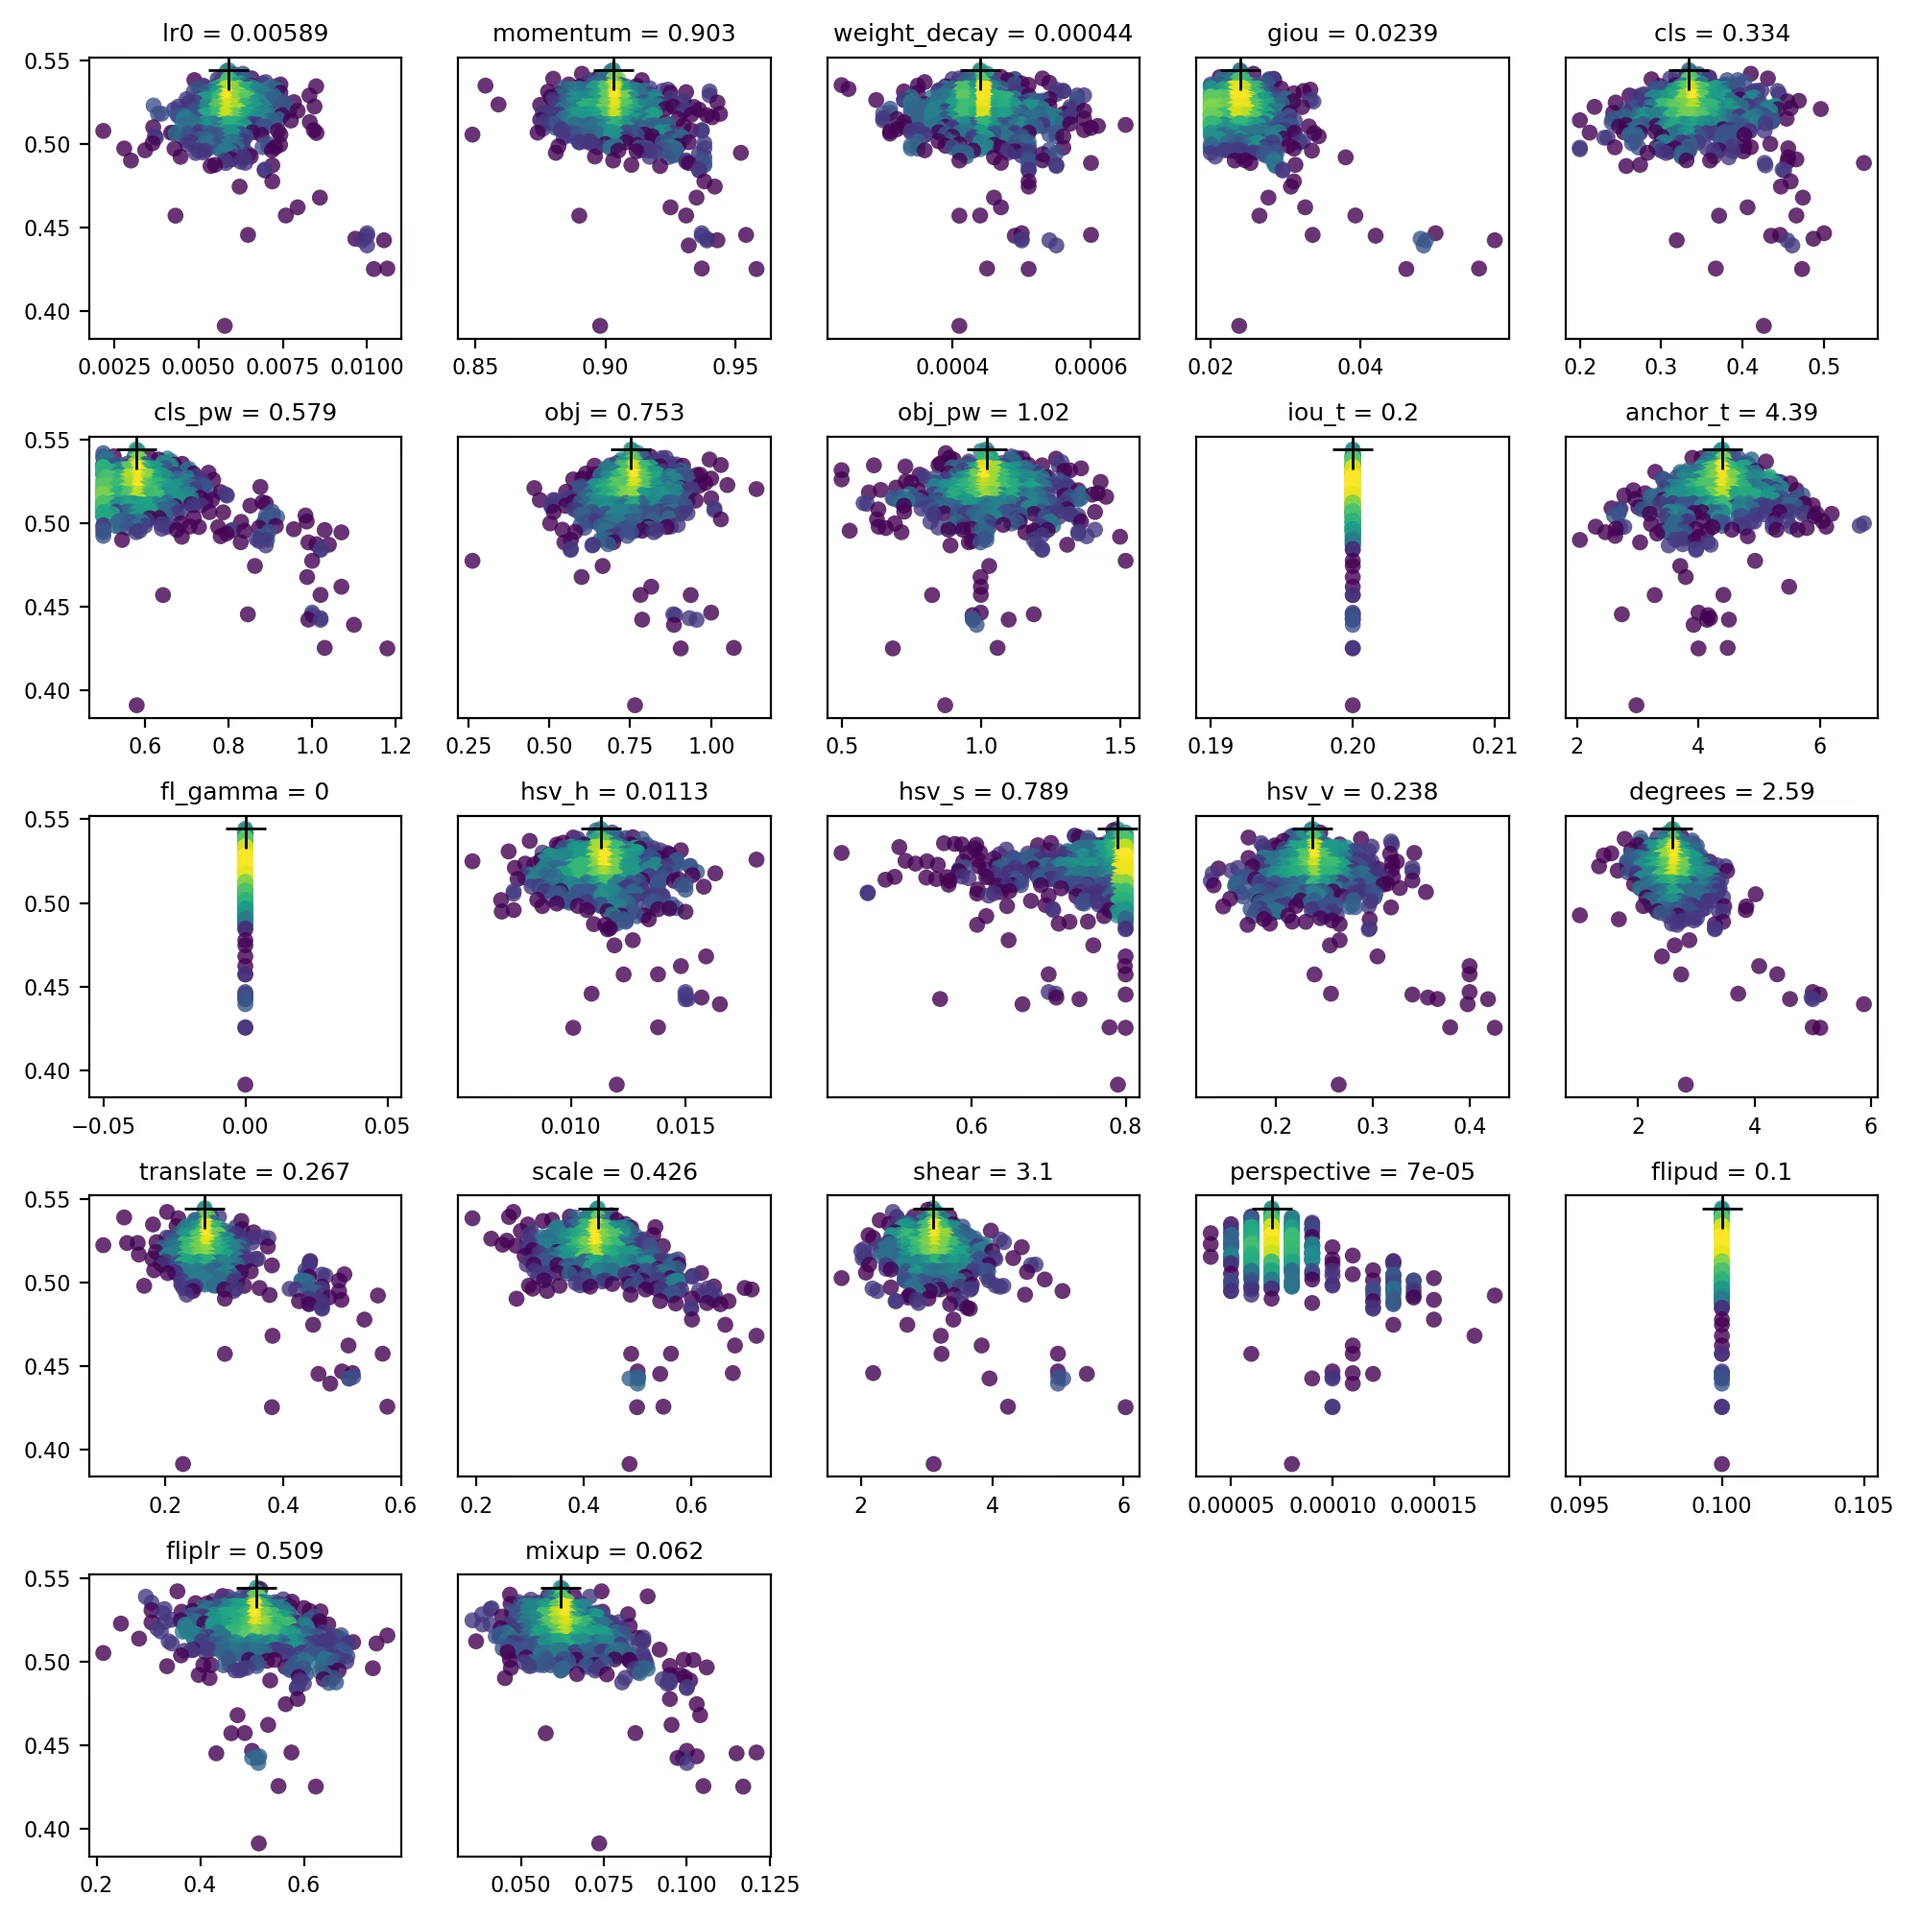
evolve.csv est représenté sous forme de evolve.png par utils.plots.plot_evolve() à la fin de l’évolution. Le graphique comporte un sous-graphique par hyperparamètre et indique la fitness (axe y) en fonction des valeurs de l’hyperparamètre (axe x). Le jaune indique les concentrations les plus élevées. Les distributions verticales indiquent qu’un paramètre a été désactivé et ne subit aucune mutation. Cette option se règle dans le dictionnaire meta de train.py. Elle est utile pour figer des paramètres et empêcher leur évolution.
Environnements pris en charge#
Ultralytics propose un ensemble d’environnements prêts à l’emploi, chacun préinstallé avec les dépendances essentielles comme CUDA, CUDNN, Python et PyTorch, pour te permettre de démarrer tes projets.
- Notebooks GPU gratuits :


- Google Cloud : Guide de démarrage rapide GCP
- Amazon : Guide de démarrage rapide AWS
- Azure : Guide de démarrage rapide AzureML
- Docker : Guide de démarrage rapide Docker

État du projet#

Ce badge indique que tous les tests d’intégration continue (CI) de GitHub Actions pour YOLOv5 réussissent. Ces tests CI vérifient rigoureusement le fonctionnement et les performances de YOLOv5 dans plusieurs domaines clés : entraînement, validation, inférence, exportation et tests de performance. Ils garantissent un fonctionnement cohérent et fiable sur macOS, Windows et Ubuntu, grâce à des tests effectués toutes les 24 heures et à chaque nouveau commit.
FAQ#
Chaque génération entraîne le scénario de base une fois par individu de la population de 50 membres. Ainsi, 300 générations d’une exécution de COCO128 sur 10 époques coûtent environ 15 000 fois plus qu’une seule exécution de ce type. Garde le scénario de base court et représentatif. La boucle multi-GPU ci-dessus lance une recherche indépendante sur chaque GPU au lieu de partager une seule recherche ; réduis donc
--evolvepar processus si tu as un budget fixe.Oui. Par défaut,
--evolvecorrespond à 300 générations ; indique un nombre, par exemple--evolve 1000, pour en exécuter davantage.Définis la première valeur de son entrée dans le dictionnaire
metadetrain.pysurFalse. Les paramètres exclus conservent leur valeur initiale et apparaissent sous forme de lignes verticales dansevolve.png.Transmets le fichier enregistré à une exécution d’entraînement classique :
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.