Entraîner YOLOv5 sur des données personnalisées#
📚 Ce guide explique comment entraîner ton propre jeu de données personnalisé avec le modèle YOLOv5 🚀. L’entraînement de modèles personnalisés est une étape fondamentale pour adapter les solutions de vision par ordinateur à des applications concrètes spécifiques, au-delà de la simple détection d’objets.
Avant de commencer#
Commence par vérifier que ton environnement est correctement configuré. Clone le dépôt YOLOv5 et installe les dépendances requises depuis requirements.txt. Un environnement Python>=3.8.0 avec PyTorch>=1.8 est indispensable. Les modèles et les jeux de données sont automatiquement téléchargés depuis la version la plus récente de YOLOv5 s’ils ne sont pas trouvés localement.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
Entraîner sur des données personnalisées#
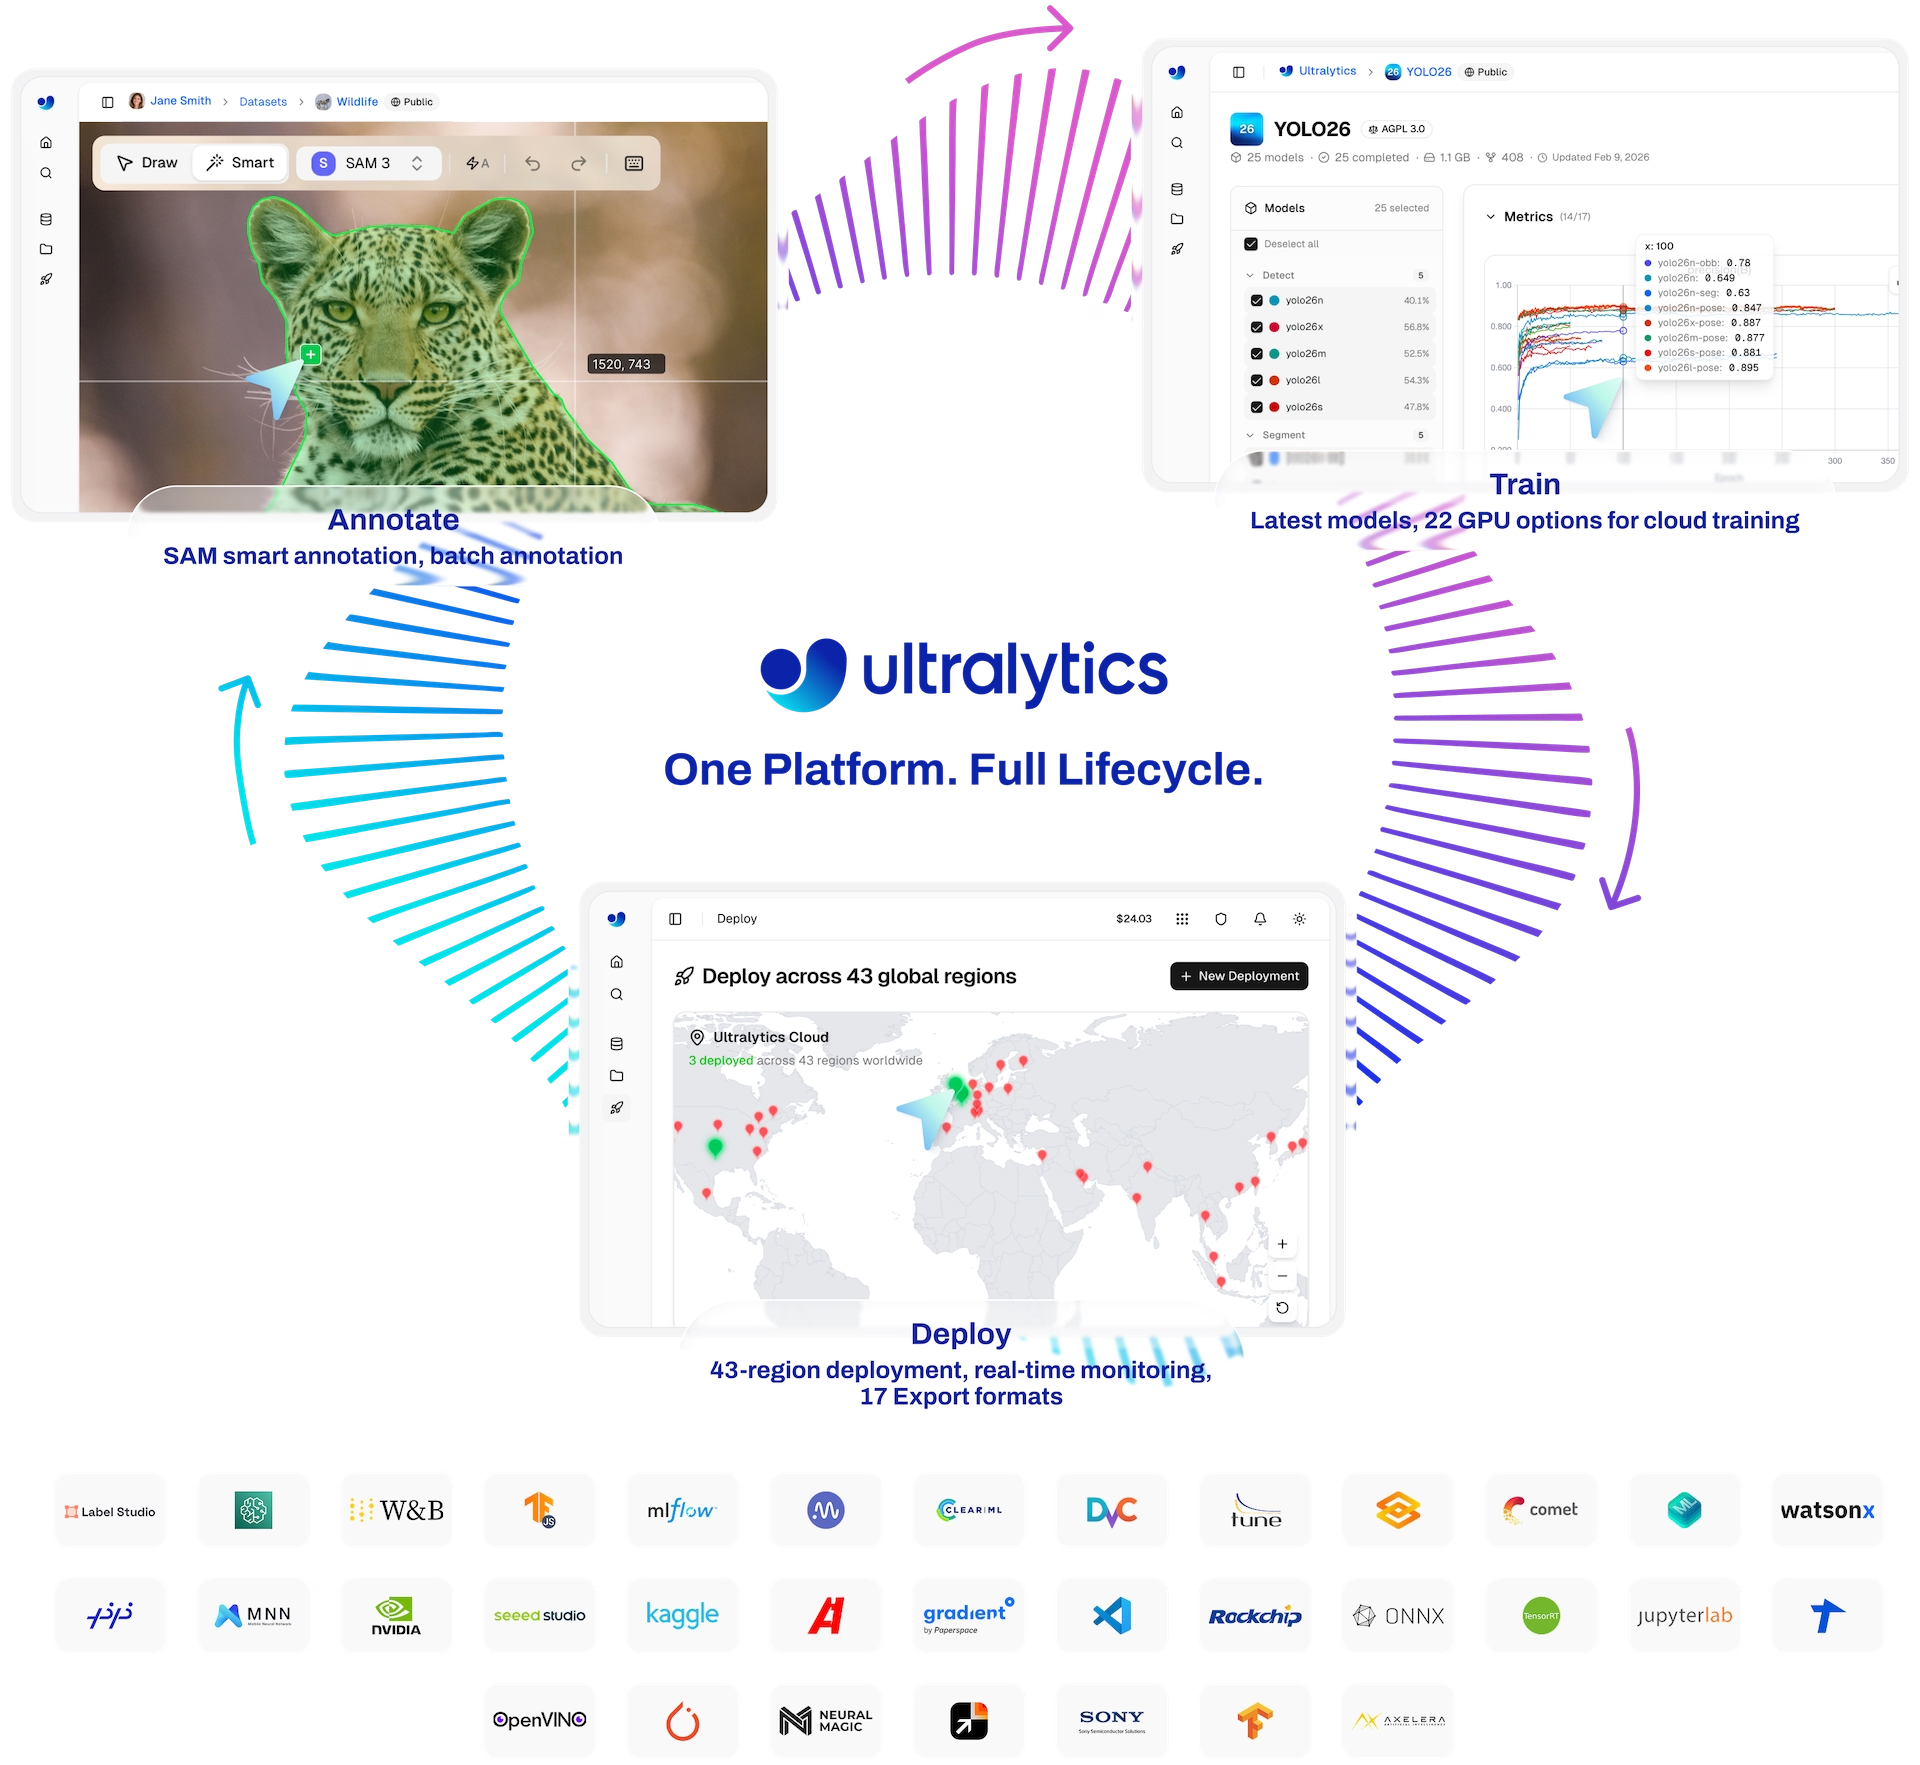
Le développement d’un modèle personnalisé de détection d’objets est un processus itératif :
- Collecter et organiser les images : rassemble des images pertinentes pour ta tâche spécifique. Des données diversifiées et de haute qualité sont essentielles. Consulte notre guide sur la collecte et l’annotation des données.
- Annoter les objets : annote avec précision les objets d’intérêt dans tes images.
- Entraîner un modèle : utilise les données annotées pour entraîner ton modèle YOLOv5. Tire parti de l’apprentissage par transfert en partant de poids préentraînés.
- Déployer et prédire : utilise le modèle entraîné pour effectuer des inférences sur de nouvelles données inédites.
- Collecter les cas limites : repère les situations où le modèle est peu performant (cas limites) et ajoute des données similaires à ton jeu de données pour améliorer sa robustesse. Répète le cycle.
La plateforme Ultralytics propose une solution simplifiée sans code pour l’ensemble de ce cycle d’opérations de machine learning (MLOps), notamment la gestion des jeux de données, l’entraînement des modèles et le déploiement.
Ultralytics propose deux options de licence pour répondre à différents cas d’utilisation :
- Licence AGPL-3.0 : cette licence open source approuvée par l’OSI est idéale pour les étudiants, les chercheurs et les passionnés qui défendent la collaboration ouverte et le partage des connaissances. Elle exige que les œuvres dérivées soient partagées sous la même licence. Consulte le fichier LICENSE pour obtenir tous les détails.
- Licence Enterprise : destinée au développement et à la production, cette licence permet d’intégrer facilement les logiciels et modèles d’IA Ultralytics aux produits et services commerciaux, notamment aux outils internes, aux flux de travail automatisés et aux déploiements en production, sans être soumis aux exigences open source de l’AGPL-3.0. Pour commencer, contacte-nous via Ultralytics Licensing.
Découvre plus en détail nos options de licence sur la page Licences Ultralytics.
Avant de commencer l’entraînement, il est essentiel de préparer le jeu de données.
1. Créer un jeu de données#
Les modèles YOLOv5 ont besoin de données annotées pour apprendre les caractéristiques visuelles des classes d’objets. Il est essentiel de bien organiser ton jeu de données.
1.1 Créer dataset.yaml#
Le fichier de configuration du jeu de données (par exemple, coco128.yaml) décrit la structure du jeu de données, les noms des classes et les chemins d’accès aux répertoires d’images. COCO128 est un petit jeu de données d’exemple composé des 128 premières images du vaste jeu de données COCO. Il est utile pour tester rapidement le pipeline d’entraînement et diagnostiquer d’éventuels problèmes comme le surapprentissage.
La structure du fichier dataset.yaml comprend :
path: le répertoire racine qui contient le jeu de données.train,val,test: chemins relatifs depuispathvers les répertoires contenant les images ou les fichiers texte qui répertorient les chemins des images pour les ensembles d’entraînement, de validation et de test.names: un dictionnaire associant les indices de classe (à partir de 0) à leurs noms de classe correspondants.
Tu peux définir path comme un répertoire absolu (par exemple, /home/user/datasets/coco128) ou comme un chemin relatif tel que ../datasets/coco128 lorsque tu lances l’entraînement depuis la racine du dépôt YOLOv5.
Voici la structure de coco128.yaml (voir sur GitHub :
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 Exploiter les modèles pour l’annotation automatisée#
L’annotation manuelle est courante, mais elle prend du temps. Les modèles de fondation peuvent automatiser ou semi-automatiser l’annotation et accélérer la création des jeux de données. Voici quelques modèles qui peuvent aider à générer des annotations :
- Google Gemini : les grands modèles multimodaux comme Gemini possèdent de puissantes capacités de compréhension des images. On peut leur demander d’identifier et de localiser des objets dans des images, puis de générer des boîtes englobantes ou des descriptions convertibles en annotations au format YOLO. Découvre son potentiel dans le notebook de tutoriel fourni.
- SAM2 (Segment Anything Model 2) : les modèles de fondation dédiés à la segmentation, comme SAM2, peuvent identifier et délimiter les objets avec une grande précision. Bien qu’ils soient principalement conçus pour la segmentation, les masques obtenus peuvent souvent être convertis en annotations de boîtes englobantes adaptées aux tâches de détection d’objets.
- YOLOWorld : ce modèle permet la détection à vocabulaire ouvert. Tu peux fournir des descriptions textuelles des objets qui t’intéressent, et YOLOWorld peut les localiser dans des images sans avoir été préalablement entraîné sur ces classes spécifiques. Tu peux t’en servir comme point de départ pour générer des annotations initiales, que tu pourras ensuite affiner.
L’utilisation de ces modèles peut fournir une étape de « préannotation » et réduire le travail manuel nécessaire. Il est toutefois essentiel de vérifier et d’affiner les annotations générées automatiquement pour garantir leur exactitude et leur cohérence, car leur qualité a une incidence directe sur les performances de ton modèle YOLOv5 entraîné. Après avoir généré tes annotations (et les avoir éventuellement affinées), vérifie qu’elles respectent le format YOLO : un fichier *.txt par image, chaque ligne représentant un objet sous la forme class_index x_center y_center width height (coordonnées normalisées, classe indexée à partir de zéro). Si une image ne contient aucun objet d’intérêt, aucun fichier *.txt correspondant n’est nécessaire.
Les spécifications des fichiers *.txt au format YOLO sont précises :
- Une ligne par boîte englobante.
- Chaque ligne doit contenir :
class_index x_center y_center width height. - Les coordonnées doivent être normalisées sur une plage comprise entre 0 et 1. Pour cela, divise les valeurs en pixels de
x_centeretwidthpar la largeur totale de l’image, et divisey_centeretheightpar sa hauteur totale. - Les indices de classe commencent à zéro (c’est-à-dire que la première classe est représentée par
0, la deuxième par1, et ainsi de suite).
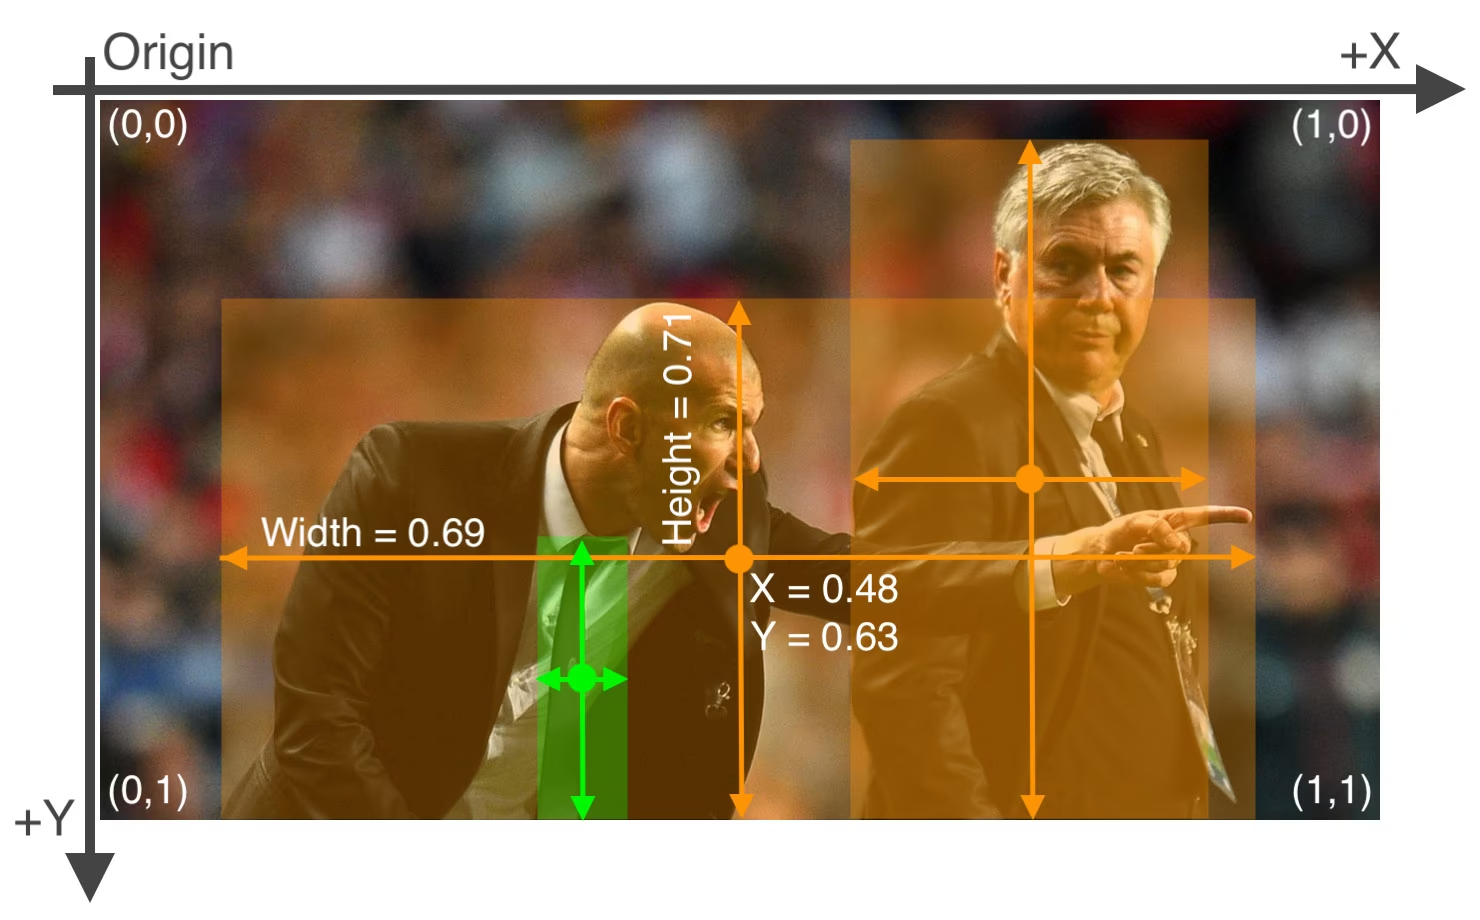
Le fichier d’annotation correspondant à l’image ci-dessus, qui contient deux objets « person » (indice de classe 0) et un objet « tie » (indice de classe 27), se présenterait ainsi :
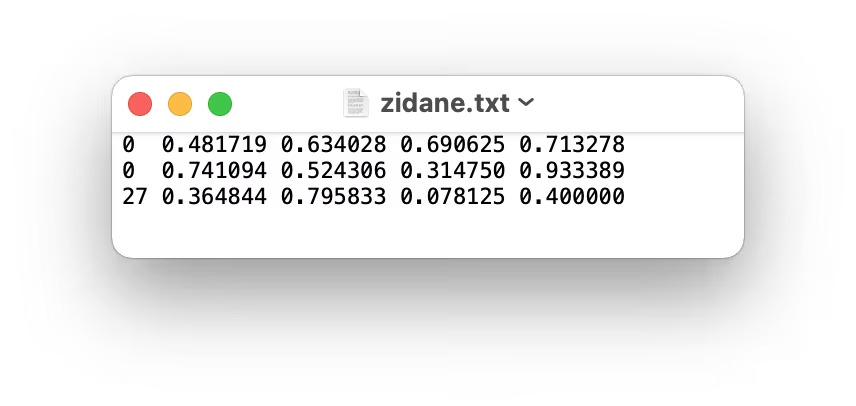
1.3 Organiser les répertoires#
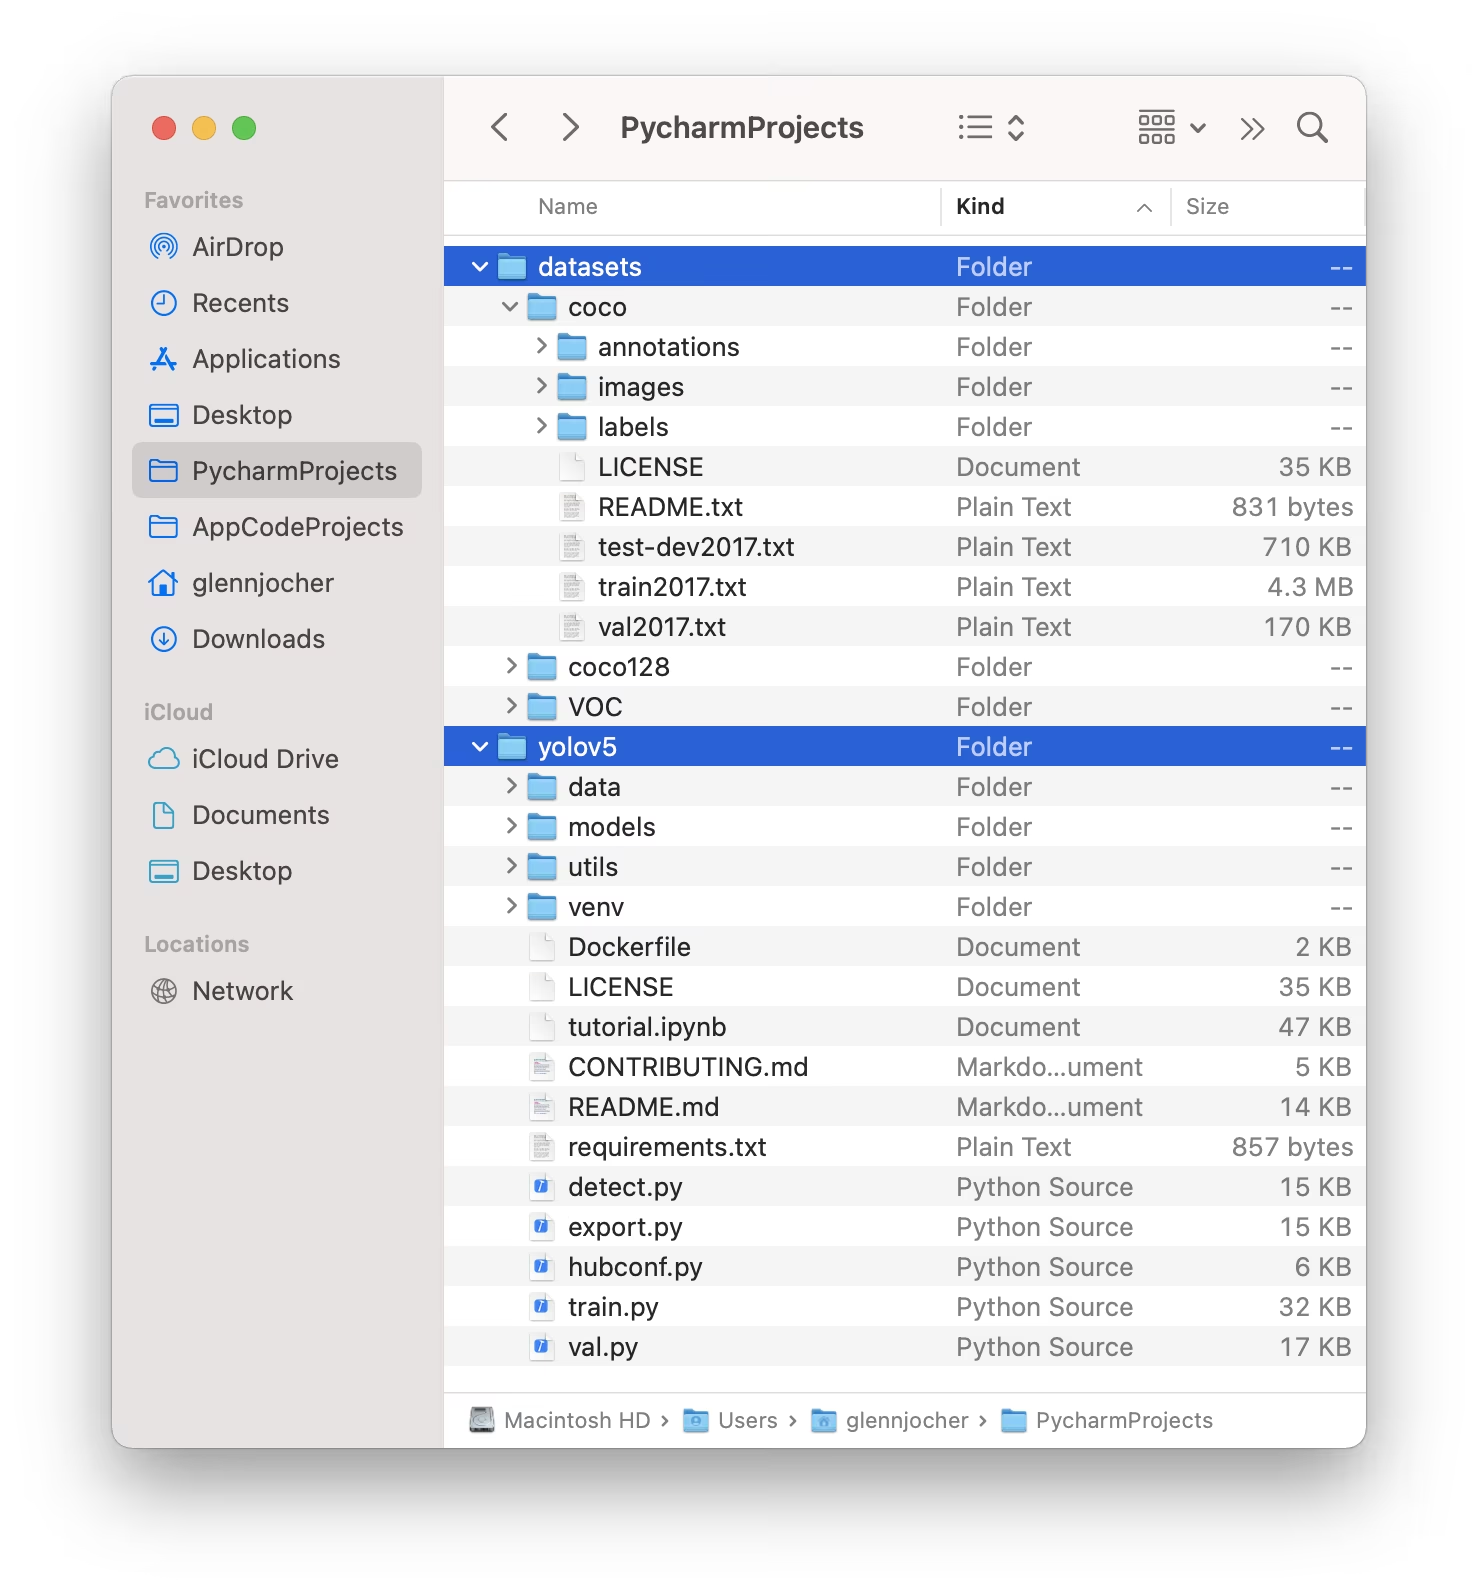
Structure ton répertoire de jeux de données comme illustré ci-dessous. Par défaut, YOLOv5 s’attend à ce que le répertoire du jeu de données (par exemple, /coco128) se trouve dans un dossier /datasets, à côté du répertoire du dépôt /yolov5.
YOLOv5 localise automatiquement les annotations de chaque image en remplaçant la dernière occurrence de /images/ dans le chemin de l’image par /labels/. Par exemple :
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
La structure de répertoires recommandée est la suivante :
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. Choisir un modèle#
Choisis un modèle préentraîné pour lancer le processus d’entraînement. Partir de poids préentraînés accélère considérablement l’apprentissage et améliore les performances par rapport à un entraînement à partir de zéro. YOLOv5 propose différentes tailles de modèles, qui offrent chacune un compromis différent entre vitesse et précision. Par exemple, YOLOv5s est le deuxième plus petit et le deuxième plus rapide des modèles ; il convient aux environnements disposant de ressources limitées. Consulte le tableau du README pour comparer en détail tous les modèles disponibles.

3. Entraîner#
Lance l’entraînement du modèle avec le script train.py. Les arguments essentiels comprennent :
--img: définit la taille des images d’entrée (par exemple,--img 640). Des tailles plus grandes donnent généralement une meilleure précision, mais nécessitent davantage de mémoire GPU.--batch: détermine la taille de lot (par exemple,--batch 16). Choisis la plus grande taille que ton GPU peut gérer.--epochs: définit le nombre total d’époques d’entraînement (par exemple,--epochs 100). Une époque correspond à un passage complet sur l’ensemble du jeu de données d’entraînement.--data: chemin vers ton fichierdataset.yaml(par exemple,--data coco128.yaml).--weights: chemin vers le fichier de poids initiaux. L’utilisation de poids préentraînés (par exemple,--weights yolov5s.pt) est vivement recommandée pour accélérer la convergence et obtenir de meilleurs résultats. Pour entraîner le modèle à partir de zéro (déconseillé, sauf si tu disposes d’un très grand jeu de données et de besoins spécifiques), utilise--weights '' --cfg yolov5s.yaml.
Si les poids préentraînés ne sont pas trouvés localement, ils sont automatiquement téléchargés depuis la dernière version de YOLOv5.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt💡 Utilise --cache ram ou --cache disk pour mettre en cache les images du jeu de données dans la RAM ou sur le disque local, respectivement. Cela accélère considérablement l’entraînement, en particulier lorsque les opérations d’E/S (entrée/sortie) du jeu de données constituent un goulot d’étranglement. Note que cela nécessite beaucoup de RAM ou d’espace disque.
💡 Entraîne toujours tes modèles avec des jeux de données stockés localement. L’accès aux données sur des lecteurs réseau (comme Google Drive) ou sur un stockage distant peut être beaucoup plus lent et nuire aux performances de l’entraînement. Copier ton jeu de données sur un SSD local est souvent la meilleure pratique.
Tous les résultats de l’entraînement, y compris les poids et les journaux, sont enregistrés dans le répertoire runs/train/. Chaque session d’entraînement crée un nouveau sous-répertoire (par exemple, runs/train/exp, runs/train/exp2, etc.). Pour une expérience interactive et pratique, consulte la section sur l’entraînement dans nos notebooks de tutoriels officiels : 

4. Visualiser#
YOLOv5 s’intègre parfaitement à divers outils permettant de visualiser la progression de l’entraînement, d’évaluer les résultats et de suivre les performances en temps réel.
Journalisation et visualisation avec Comet#
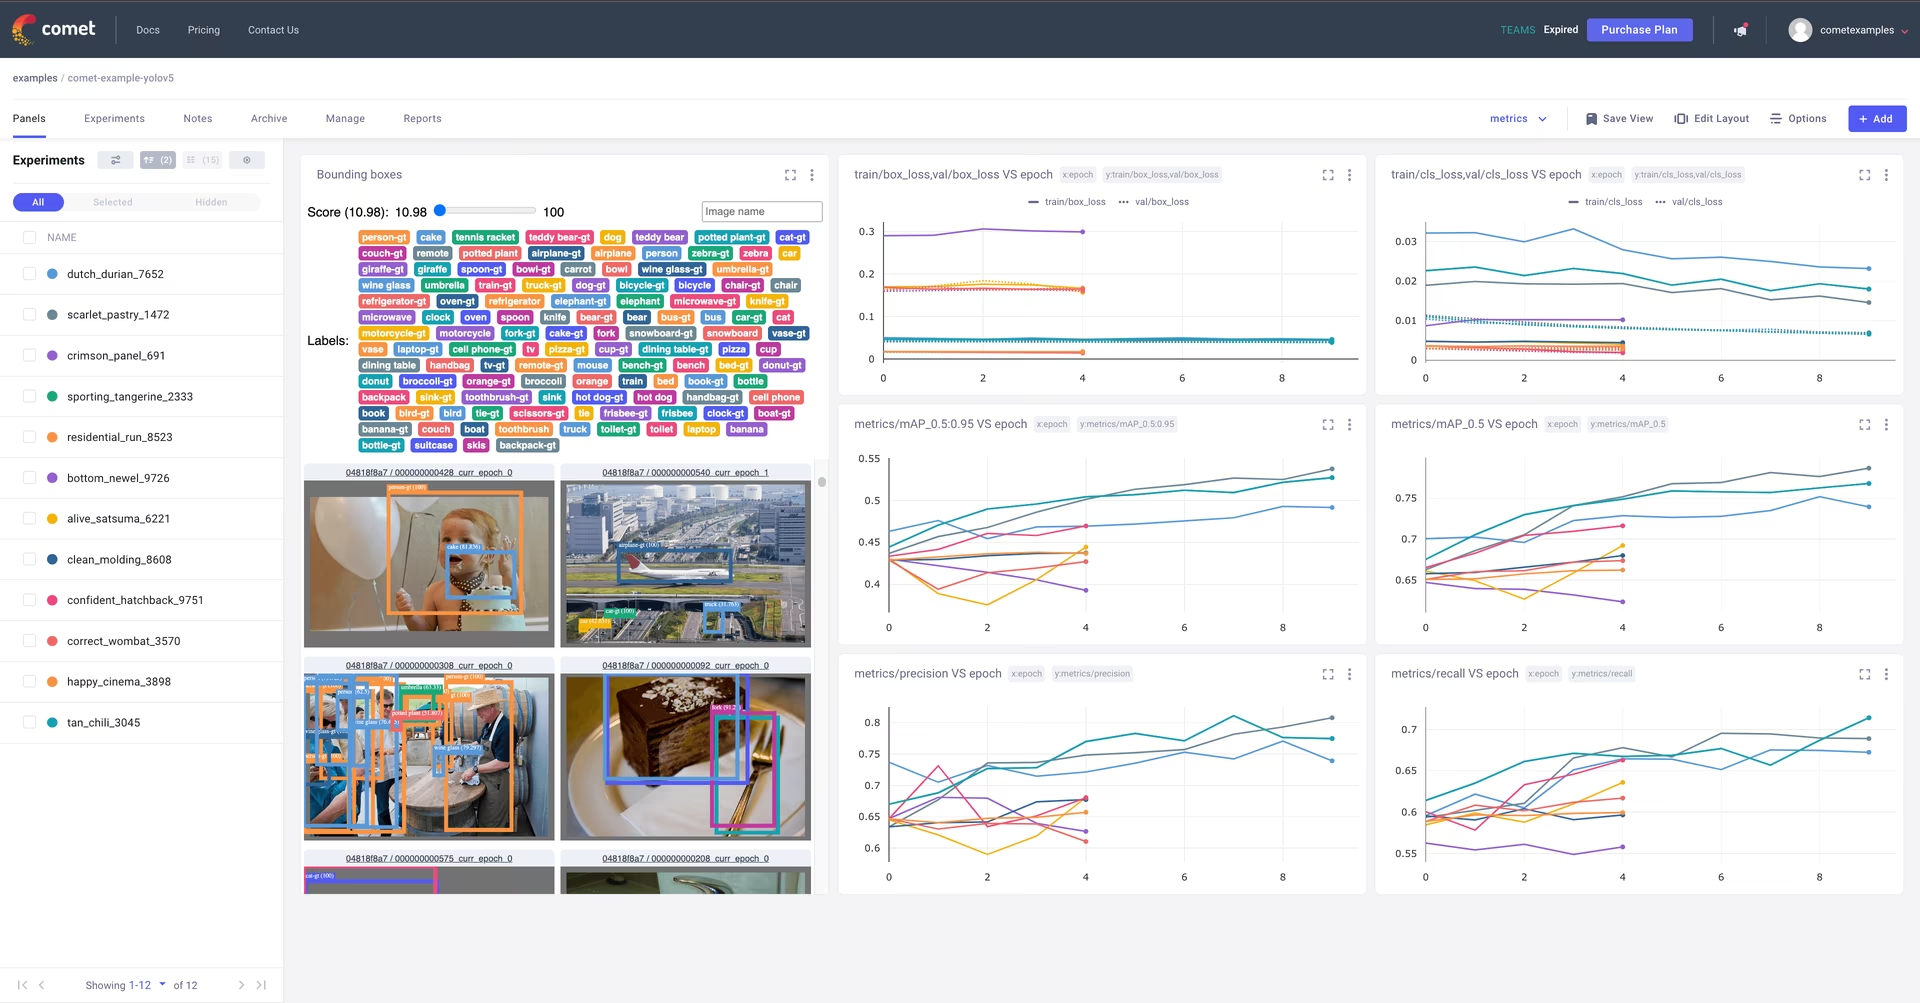
Comet est entièrement intégré pour assurer un suivi complet des expériences. Visualise les métriques en direct, enregistre les hyperparamètres, gère les jeux de données et les points de contrôle des modèles, et analyse les prédictions des modèles à l’aide des panneaux personnalisés Comet interactifs.
La prise en main est simple :
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
Découvre plus en détail les fonctionnalités prises en charge dans notre guide d’intégration de Comet. Pour en savoir plus sur les capacités de Comet, consulte sa documentation officielle. Essaie le notebook Comet Colab pour une démonstration en direct :
Journalisation et automatisation avec ClearML#
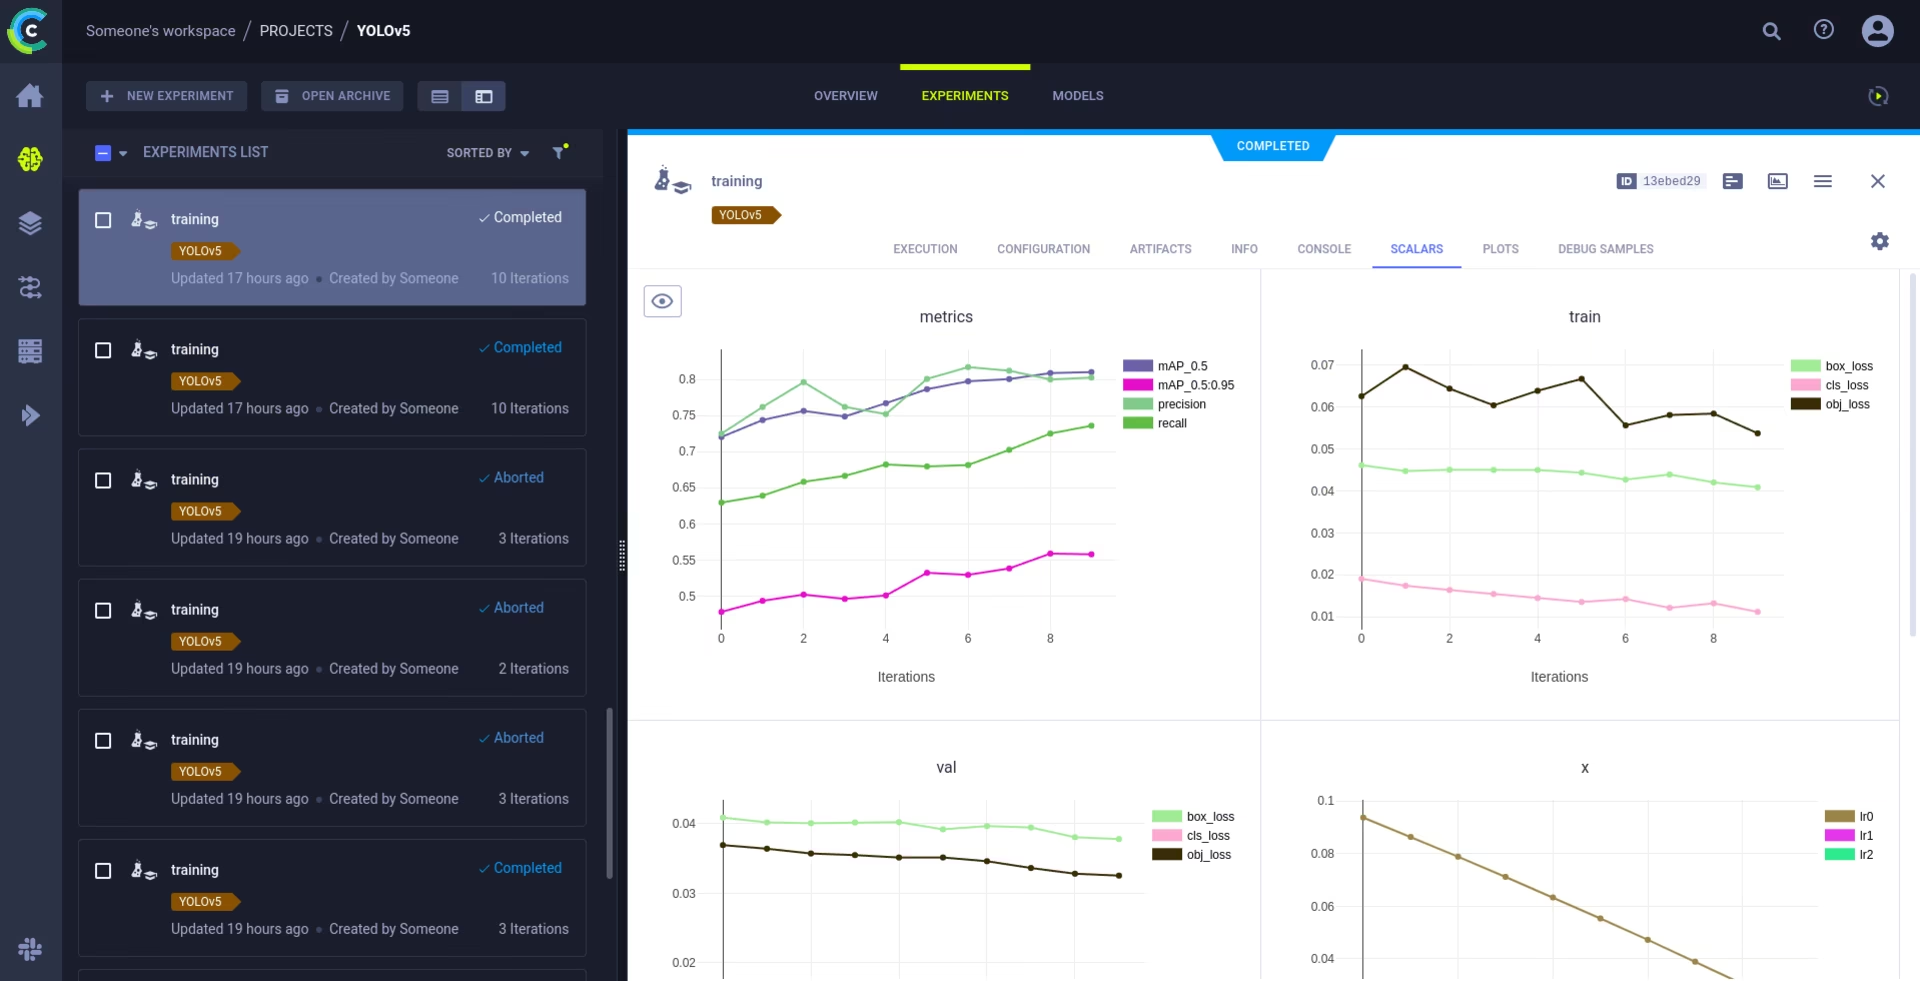
L’intégration de ClearML permet un suivi détaillé des expériences, la gestion des versions des jeux de données et même l’exécution à distance des entraînements. Active ClearML en suivant ces étapes simples :
- Installe le paquet :
pip install clearml - Initialise ClearML : exécute
clearml-initune fois pour te connecter à ton serveur ClearML (auto-hébergé ou sur l’offre gratuite).
ClearML capture automatiquement les détails des expériences, les téléversements de modèles, les comparaisons, les modifications de code non validées et les paquets installés, ce qui garantit une reproductibilité complète. Tu peux facilement planifier des tâches d’entraînement sur des agents distants et gérer les versions des jeux de données avec ClearML Data. Consulte le guide d’intégration de ClearML pour obtenir tous les détails.
Journalisation locale#
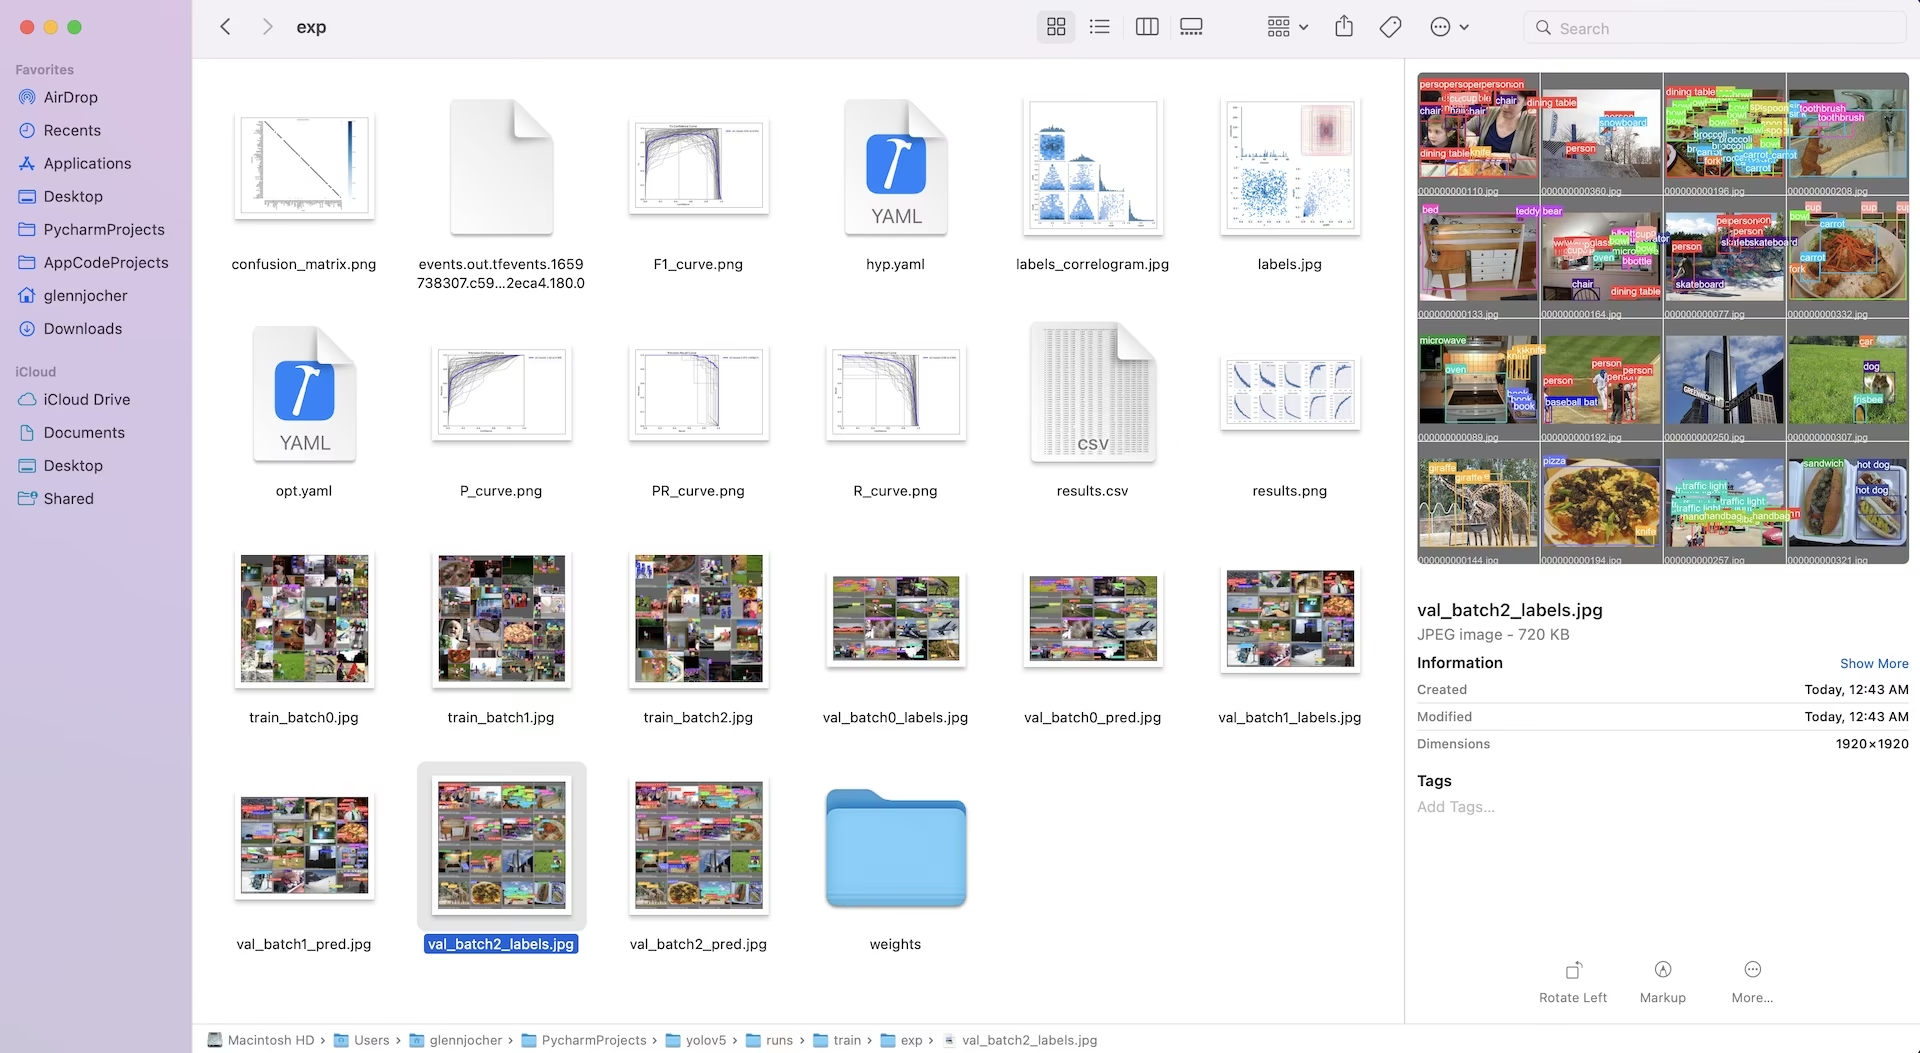
Les résultats de l’entraînement sont automatiquement consignés avec TensorBoard et enregistrés sous forme de fichiers CSV dans le répertoire de l’expérience concernée (par exemple, runs/train/exp). Les données consignées comprennent :
- Les pertes et les métriques de performance de l’entraînement et de la validation.
- Des exemples d’images montrant les augmentations appliquées (comme les mosaïques).
- Les annotations de référence et les prédictions du modèle, côte à côte pour une inspection visuelle.
- Des métriques d’évaluation clés, comme les courbes précision-rappel (PR).
- Des matrices de confusion pour une analyse détaillée des performances par classe.
Le fichier results.csv est mis à jour après chaque époque et représenté sous forme de graphique dans results.png une fois l’entraînement terminé. Tu peux également tracer manuellement n’importe quel fichier results.csv à l’aide de la fonction utilitaire fournie :
from utils.plots import plot_results

# Tracer les résultats d’un répertoire d’exécution d’entraînement spécifique
plot_results("runs/train/exp/results.csv")  # Cela générera 'results.png' dans le même répertoire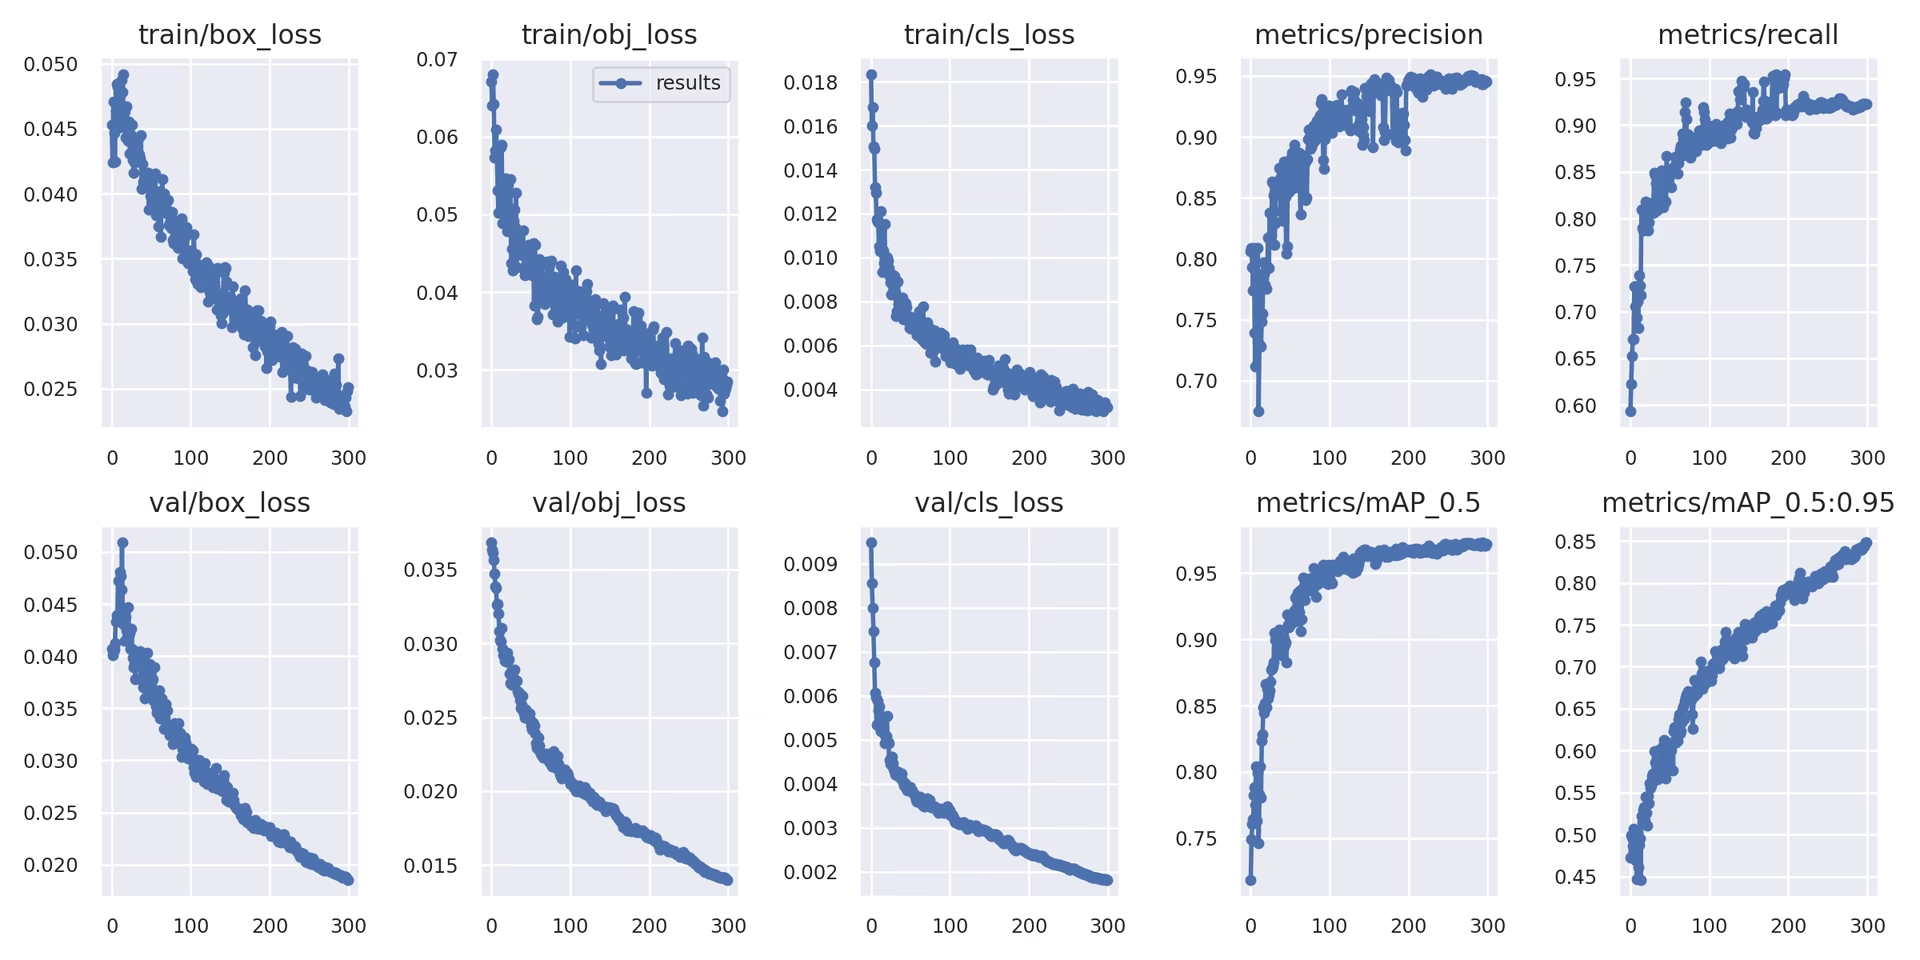
5. Étapes suivantes#
Une fois l’entraînement terminé avec succès, le point de contrôle du modèle le plus performant (best.pt) est enregistré et prêt à être déployé ou peaufiné. Voici quelques étapes possibles :
- Effectue des inférences sur de nouvelles images ou vidéos avec le modèle entraîné, via la CLI ou Python.
- Exécute
val.pypour évaluer la précision et les capacités de généralisation du modèle sur différents sous-ensembles de données (par exemple, un jeu de test mis de côté). - Exporte le modèle vers différents formats de déploiement, comme ONNX, TensorFlow SavedModel ou TensorRT, afin d’optimiser l’inférence sur diverses plateformes.
- Utilise l’évolution des hyperparamètres pour tenter d’obtenir des gains de performance supplémentaires.
- Continue d’améliorer ton modèle en suivant nos conseils pour obtenir les meilleurs résultats d’entraînement et en ajoutant progressivement des données plus diversifiées et plus difficiles, en fonction de l’analyse des performances.
Environnements pris en charge#
Ultralytics fournit des environnements prêts à l’emploi dotés des dépendances essentielles, comme CUDA, cuDNN, Python et PyTorch, pour te permettre de démarrer facilement.
- Notebooks GPU gratuits :
- Plateformes cloud :
- Google Cloud : Guide de démarrage rapide GCP
- Amazon AWS : Guide de démarrage rapide AWS
- Microsoft Azure : Guide de démarrage rapide AzureML
- Configuration locale :
- Docker : Guide de démarrage rapide Docker
- Docker : Guide de démarrage rapide Docker


État du projet#

Ce badge indique que tous les tests GitHub Actions d’intégration continue (CI) de YOLOv5 réussissent. Ces tests CI rigoureux couvrent les fonctionnalités essentielles, notamment l’entraînement, la validation, l’inférence, l’export et les benchmarks, sur les systèmes d’exploitation macOS, Windows et Ubuntu. Les tests s’exécutent automatiquement toutes les 24 heures et à chaque commit de code, garantissant une stabilité constante et des performances optimales.
FAQ#
L'entraînement de YOLOv5 sur un jeu de données personnalisé comporte plusieurs étapes clés :
- Prépare ton jeu de données : collecte des images et annote-les. Vérifie que les annotations respectent le format YOLO requis. Organise les images et les étiquettes dans les répertoires
train/etval/(et, éventuellement,test/). Pense à utiliser des modèles comme Google Gemini, SAM2 ou YOLOWorld pour t'aider à effectuer l'annotation ou l'automatiser (voir la section 1.2). - Configure ton environnement : clone le dépôt YOLOv5 et installe les dépendances à l'aide de
pip install -r requirements.txt.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - Crée la configuration du jeu de données : définis les chemins d'accès au jeu de données, le nombre de classes et leurs noms dans un fichier
dataset.yaml. - Lance l'entraînement : exécute le script
train.pyen indiquant les chemins versdataset.yaml, les poids préentraînés souhaités (par exemple,yolov5s.pt), la taille des images, la taille du lot et le nombre d'époques.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- Prépare ton jeu de données : collecte des images et annote-les. Vérifie que les annotations respectent le format YOLO requis. Organise les images et les étiquettes dans les répertoires
Ultralytics Platform est une plateforme complète conçue pour simplifier l'ensemble du cycle de développement des modèles YOLO, souvent sans avoir à écrire de code. Voici quelques-uns de ses principaux avantages :
- Entraînement simplifié : entraîne facilement tes modèles dans des environnements préconfigurés et grâce à une interface utilisateur intuitive.
- Gestion intégrée des données : importe, versionne et gère efficacement tes jeux de données au sein de la plateforme.
- Suivi en temps réel : suis la progression de l'entraînement et visualise les métriques de performance à mesure qu'elles arrivent.
- Fonctionnalités collaboratives : facilite le travail d'équipe grâce au partage de ressources, aux outils de gestion de projet et au partage simplifié des modèles.
- Déploiement sans code : déploie directement les modèles entraînés sur différentes cibles.
Pour découvrir une mise en pratique, consulte notre article de blog : Comment entraîner tes modèles personnalisés avec Ultralytics Platform.
Que tu effectues l'annotation manuellement ou à l'aide d'outils automatisés (comme ceux mentionnés à la section 1.2), les étiquettes finales doivent respecter le format YOLO spécifique requis par YOLOv5 :
- Crée un fichier
.txtpour chaque image. Le nom du fichier doit correspondre à celui de l'image (par exemple,image1.jpgcorrespond àimage1.txt). Place ces fichiers dans un répertoirelabels/, au même niveau que ton répertoireimages/(par exemple,../datasets/mydataset/labels/train/). - Chaque ligne d'un fichier
.txtreprésente l'annotation d'un objet et respecte le format suivant :class_index center_x center_y width height. - Les coordonnées (
center_x,center_y,width,height) doivent être normalisées (valeurs comprises entre 0.0 et 1.0) par rapport aux dimensions de l'image. - Les indices des classes commencent à zéro (la première classe est
0, la deuxième est1, etc.).
De nombreux outils d'annotation manuelle proposent un export direct au format YOLO. Si tu utilises des modèles automatisés, tu devras convertir leur sortie (par exemple, les coordonnées des boîtes englobantes ou les masques de segmentation) en ce format texte normalisé, au moyen de scripts ou d'autres processus. Vérifie que la structure finale de ton jeu de données respecte l'exemple fourni dans le guide. Pour en savoir plus, consulte notre Guide de collecte et d'annotation des données.
- Crée un fichier
Ultralytics propose des licences flexibles adaptées à différents besoins :
- Licence AGPL-3.0 : cette licence open source convient à la recherche universitaire, aux projets personnels et aux situations où le respect des obligations de l'open source est acceptable. Elle impose également la publication en open source des modifications et des œuvres dérivées sous AGPL-3.0. Consulte les détails de la licence AGPL-3.0.
- Licence Entreprise : une licence commerciale destinée aux entreprises qui intègrent YOLOv5 à des produits ou services propriétaires. Elle supprime les obligations liées à l'open source imposées par AGPL-3.0 et permet la distribution de logiciels à code source fermé. Consulte notre page des licences pour en savoir plus ou demander une licence Entreprise.
Choisis la licence la mieux adaptée aux exigences de ton projet et à son mode de distribution.