Déploie YOLOv5 avec DeepSparse de Neural Magic#
Neural Magic a été racheté par Red Hat en janvier 2025 et a abandonné les versions communautaires de DeepSparse, SparseML, SparseZoo et Sparsify le 2 juin 2025. Les outils fonctionnent toujours, mais ne bénéficient plus de mises à jour ni d’assistance. Pour une accélération CPU maintenue, consulte les intégrations OpenVINO et ONNX.
Bienvenue dans l’IA fournie par logiciel.
Ce guide explique comment déployer YOLOv5 avec DeepSparse de Neural Magic.
DeepSparse est un moteur d’inférence offrant des performances exceptionnelles sur CPU. Par exemple, par rapport à la référence ONNX Runtime, DeepSparse accélère YOLOv5s de 5.8x sur la même machine !
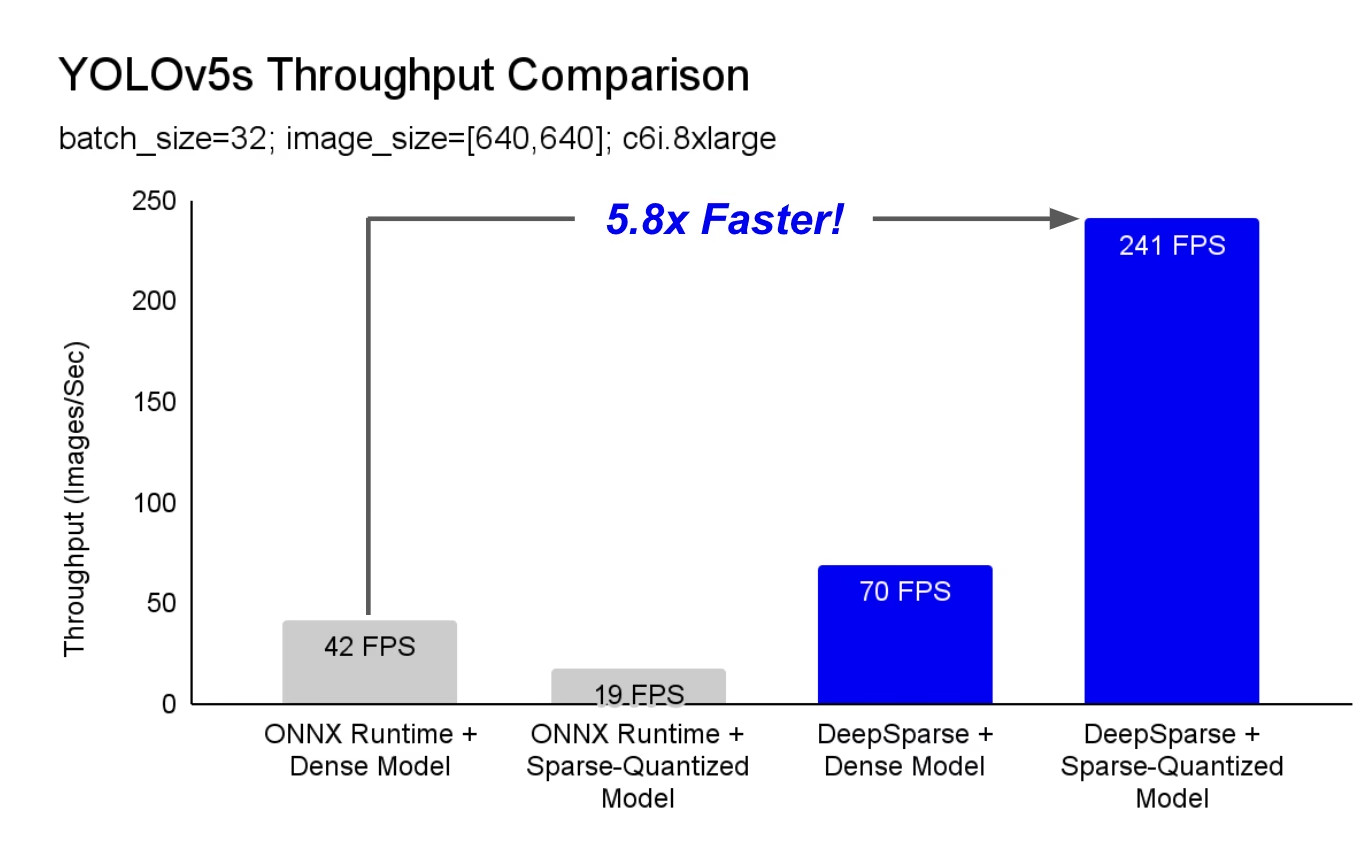
Pour la première fois, tes charges de travail de deep learning peuvent répondre aux exigences de performances de la production sans la complexité ni le coût des accélérateurs matériels. En bref, DeepSparse t’offre les performances des GPU et la simplicité du logiciel :
- Déploiements flexibles : exécute tes applications de façon cohérente dans le cloud, les centres de données et l’edge, avec n’importe quel fournisseur matériel, d’Intel à AMD en passant par ARM
- Évolutivité illimitée : évolue verticalement jusqu’à des centaines de cœurs, horizontalement avec Kubernetes standard, ou avec une abstraction complète grâce au serverless
- Intégration facile : des API claires pour intégrer ton modèle à une application et le surveiller en production
Comment DeepSparse atteint-il des performances de niveau GPU ?#
DeepSparse exploite la parcimonie des modèles pour accélérer leur exécution.
La parcimonisation par élagage et quantification est une technique largement étudiée qui permet de réduire d’un ordre de grandeur la taille et la puissance de calcul nécessaires à l’exécution d’un réseau, tout en maintenant une précision élevée. DeepSparse tient compte de la parcimonie : il ignore les paramètres mis à zéro, ce qui réduit le calcul lors d’une propagation avant. Comme le calcul parcimonieux est désormais limité par la mémoire, DeepSparse exécute le réseau en profondeur en divisant le problème en colonnes de tenseur, des bandes verticales de calcul qui tiennent dans le cache.
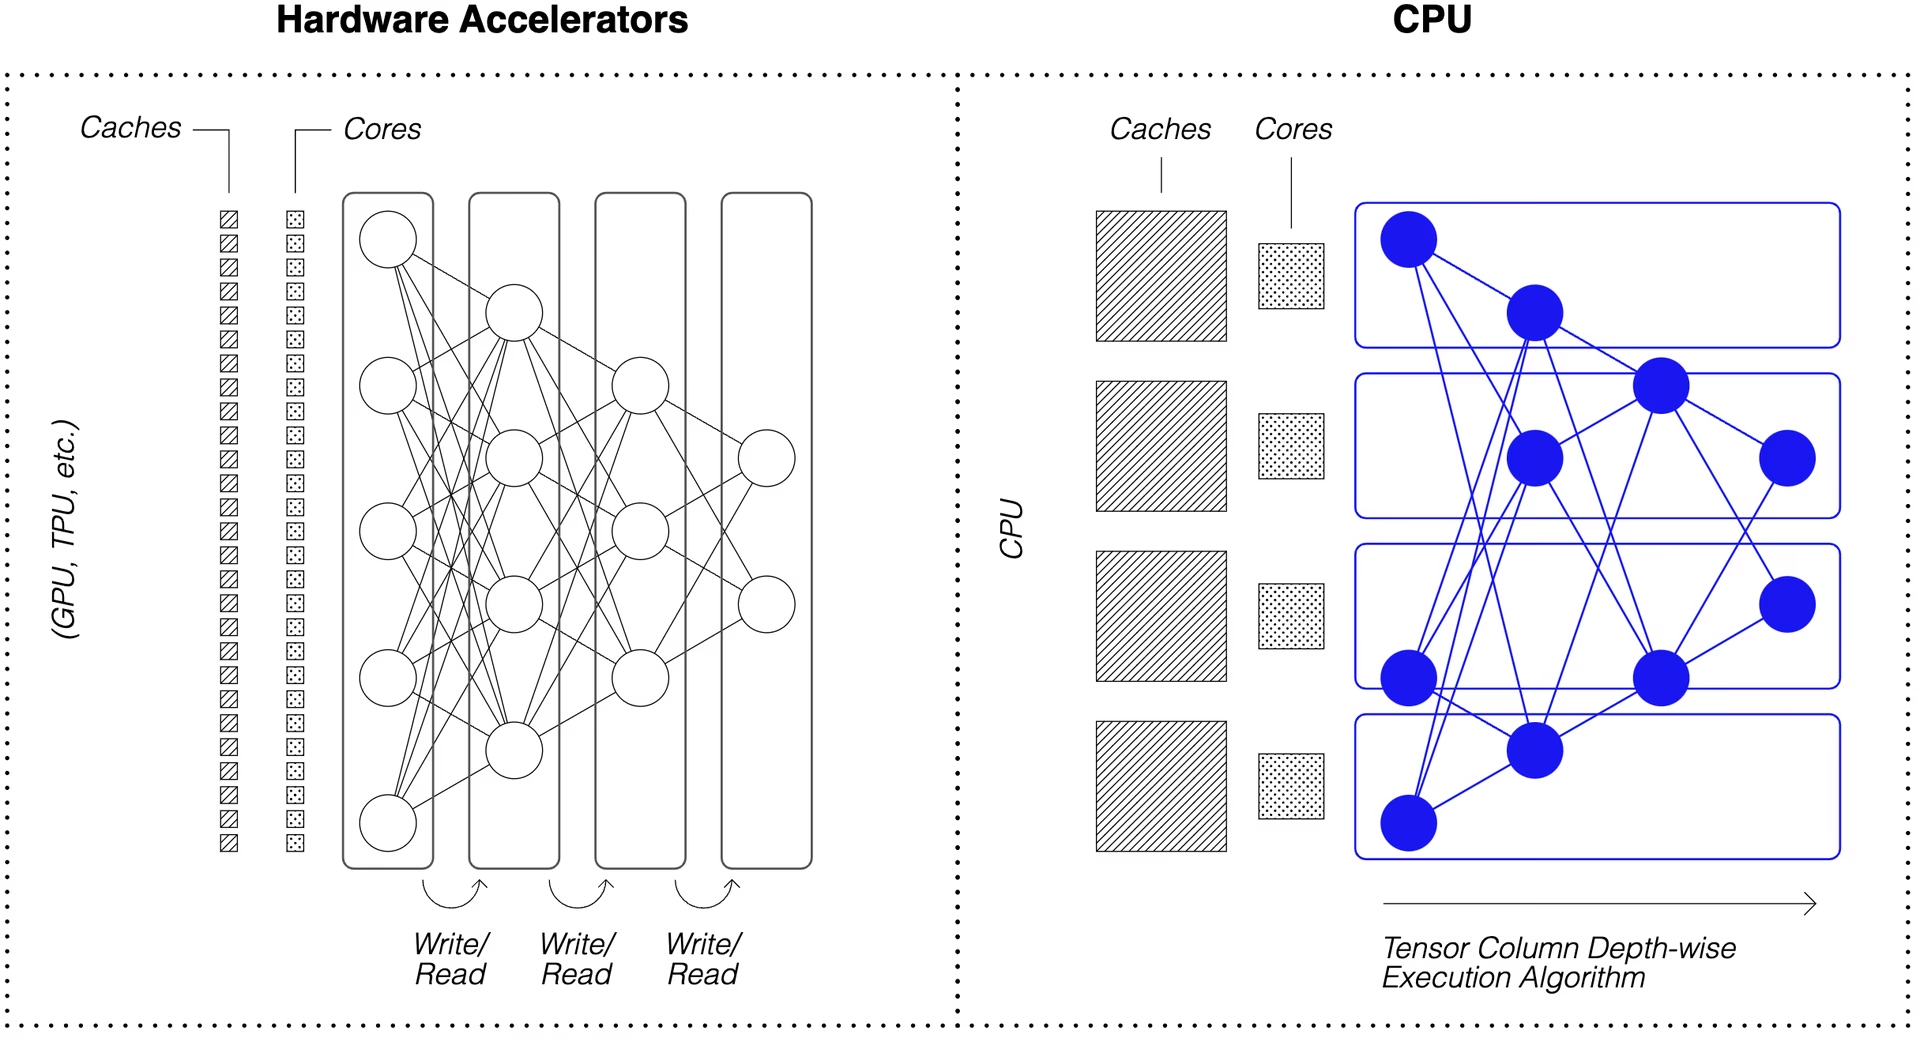
Grâce aux réseaux parcimonieux dont le calcul compressé s’exécute en profondeur dans le cache, DeepSparse offre des performances de niveau GPU sur CPU !
Comment créer une version parcimonieuse de YOLOv5 entraînée sur mes données ?#
Le dépôt de modèles open source de Neural Magic, SparseZoo, contient des points de contrôle préalablement parcimonisés pour chaque modèle YOLOv5. Avec SparseML, intégré à Ultralytics, tu peux affiner un point de contrôle parcimonieux sur tes données à l’aide d’une seule commande CLI.
Consulte l’intégration de SparseML à YOLOv5 pour en savoir plus.
Utilisation de DeepSparse#
Nous allons parcourir un exemple d’évaluation et de déploiement d’une version parcimonieuse de YOLOv5s avec DeepSparse.
Installer DeepSparse#
Exécute la commande suivante pour installer DeepSparse. Nous te recommandons d’utiliser un environnement virtuel avec Python.
pip install "deepsparse[server,yolo,onnxruntime]"Récupérer un fichier ONNX#
DeepSparse accepte un modèle au format ONNX, fourni sous l’une des formes suivantes :
- Un stub SparseZoo qui identifie un fichier ONNX dans SparseZoo
- Un chemin local vers un modèle ONNX dans un système de fichiers
Les exemples ci-dessous utilisent les points de contrôle YOLOv5s denses et élagués-quantifiés standard, identifiés par les stubs SparseZoo suivants :
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Déployer un modèle#
DeepSparse propose des API pratiques pour intégrer ton modèle à une application.
Pour essayer les exemples de déploiement ci-dessous, télécharge une image d’exemple et enregistre-la sous le nom basilica.jpg avec la commande suivante :
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgAPI Python#
Pipelines encapsule le prétraitement et le post-traitement des sorties autour du moteur d’exécution, fournissant une interface claire pour intégrer DeepSparse à une application. L’intégration DeepSparse-Ultralytics comprend un Pipeline prêt à l’emploi qui accepte des images brutes et renvoie les boîtes englobantes.
Crée un Pipeline et lance l’inférence :
from deepsparse import Pipeline

# liste d’images dans le système de fichiers local
images = ["basilica.jpg"]

# créer Pipeline
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# lancer l’inférence sur les images, recevoir les boîtes englobantes et les classes
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
Si tu exécutes le programme dans le cloud, tu peux obtenir une erreur indiquant qu’OpenCV ne trouve pas libGL.so.1. Tu peux soit installer la bibliothèque manquante :
apt-get install libgl1Soit utiliser la version headless d’OpenCV, qui évite entièrement les dépendances à l’interface graphique :
pip install opencv-python-headlessServeur HTTP#
DeepSparse Server s’appuie sur le framework web populaire FastAPI et le serveur web Uvicorn. Avec une seule commande CLI, tu peux facilement configurer un point de terminaison de service de modèle avec DeepSparse. Le serveur prend en charge tous les pipelines de DeepSparse, y compris la détection d’objets avec YOLOv5, ce qui te permet d’envoyer des images brutes au point de terminaison et de recevoir les boîtes englobantes.
Lance le serveur avec YOLOv5s élagué-quantifié :
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Voici un exemple de requête utilisant le package Python requests :
import json
from contextlib import ExitStack

import requests

# liste d’images pour l’inférence (fichiers locaux côté client)
path = ["basilica.jpg"]

# envoyer une requête HTTP au point de terminaison /predict/from_files
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# la réponse est renvoyée au format JSON
annotations = json.loads(resp.text)  # dictionnaire des résultats d’annotation
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]
CLI d’annotation#
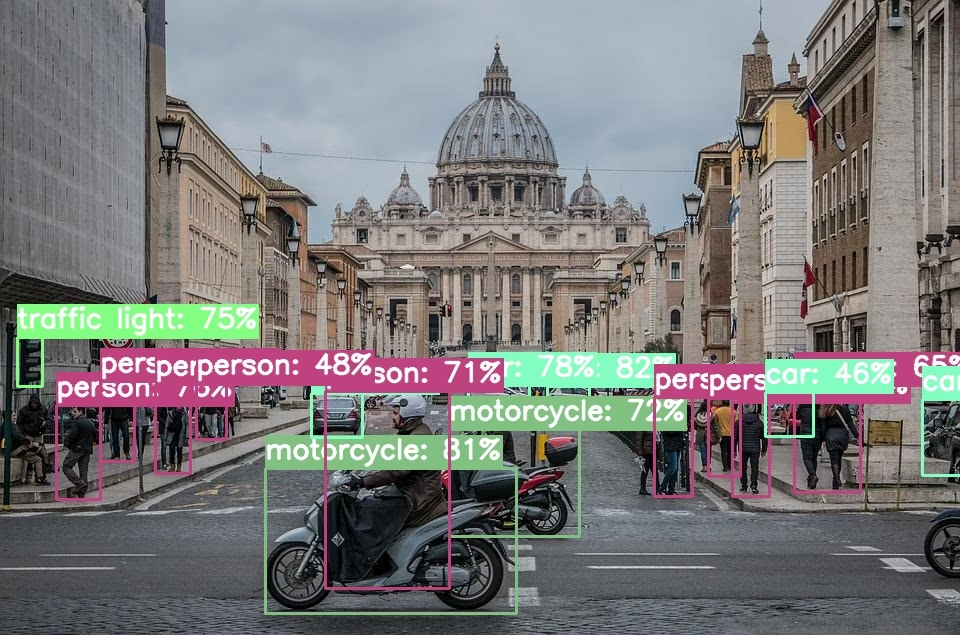
Tu peux aussi utiliser la commande annotate pour que le moteur enregistre une photo annotée sur le disque. Essaie --source 0 pour annoter le flux de ta webcam en direct !
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpgL’exécution de la commande ci-dessus créera un dossier annotation-results et enregistrera l’image annotée à l’intérieur.
Évaluation des performances#
Nous allons comparer le débit de DeepSparse à celui d’ONNX Runtime sur YOLOv5s, à l’aide du script d’évaluation de DeepSparse.
Les évaluations ont été exécutées sur une instance AWS c6i.8xlarge (16 cœurs).
Comparaison des performances avec une taille de lot de 32#
Référence ONNX Runtime#
Avec une taille de lot de 32, ONNX Runtime atteint 42 images/s avec le modèle YOLOv5s dense standard :
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
Performances de DeepSparse avec un modèle dense#
DeepSparse offre ses meilleures performances avec des modèles creux optimisés, mais fonctionne aussi bien avec le modèle YOLOv5s dense standard.
Avec une taille de lot de 32, DeepSparse atteint 70 images/s avec le modèle YOLOv5s dense standard, soit une amélioration des performances de 1,7x par rapport à ORT !
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
Performances de DeepSparse avec un modèle creux#
Lorsque le modèle est rendu creux, les gains de performances de DeepSparse par rapport à ONNX Runtime sont encore plus importants.
Avec une taille de lot de 32, DeepSparse atteint 241 images/s avec le modèle YOLOv5s élagué et quantifié, soit une amélioration des performances de 5,8x par rapport à ORT !
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
Comparaison des performances avec une taille de lot de 1#
DeepSparse peut également surpasser ONNX Runtime dans le scénario sensible à la latence avec une taille de lot de 1.
Référence ONNX Runtime#
Avec une taille de lot de 1, ONNX Runtime atteint 48 images/s avec le modèle YOLOv5s dense standard.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
Performances de DeepSparse avec un modèle creux#
Avec une taille de lot de 1, DeepSparse atteint 135 éléments/s avec un modèle YOLOv5s élagué et quantifié, soit un gain de performances de 2,8x par rapport à ONNX Runtime !
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
Comme les instances c6i.8xlarge disposent d’instructions VNNI, le débit de DeepSparse peut encore augmenter si les poids sont élagués par blocs de 4.
Avec une taille de lot de 1, DeepSparse atteint 180 éléments/s avec un modèle YOLOv5s élagué par blocs de 4 et quantifié, soit un gain de performances de 3,7x par rapport à ONNX Runtime !
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
Bien démarrer avec DeepSparse#
Recherche ou tests ? DeepSparse Community est gratuit pour la recherche et les tests. Pour commencer, consulte le README de DeepSparse.
Pour en savoir plus sur le déploiement de YOLOv5 avec DeepSparse, consulte les exemples DeepSparse pour YOLOv5 et l’article de blog d’Ultralytics sur l’intégration de DeepSparse.
FAQ#
Non. DeepSparse est un environnement d’exécution sur CPU, et les évaluations ci-dessus ont été réalisées sur une instance AWS
c6i.8xlargeà 16 cœurs, sans aucun accélérateur.Exporte-le au format ONNX avec
python export.py --weights best.pt --include onnx, puis indique le chemin du fichier à la place d’un stub SparseZoo avecmodel_path. Les modèles denses tirent tout de même parti de l’environnement d’exécution, et les modèles élagués et quantifiés en tirent le plus grand bénéfice.Effectue un ajustement fin sur tes données à partir de l’un des points de contrôle SparseZoo préalablement rendus creux, avec SparseML, qui préserve la structure de parcimonie pendant l’entraînement, puis exporte le modèle au format ONNX.
Non. Les versions communautaires ont été abandonnées le 2 juin 2025, et les paquets sur PyPI sont figés. Les pipelines existants continuent de fonctionner, mais pour les nouveaux déploiements, privilégie les solutions OpenVINO ou ONNX Runtime, qui sont activement maintenues.