Intégration de ClearML#

À propos de ClearML#
ClearML est une plateforme MLOps open source conçue pour simplifier les workflows de machine learning et faire gagner du temps aux équipes d'ingénierie.
- 🔨 Suis chaque exécution d'entraînement YOLOv5 dans le gestionnaire d'expériences.
- 🔧 Versionne et accède à tes données d'entraînement personnalisées grâce à l'outil de gestion des versions des données intégré de ClearML.
- 🔦 Entraîne et surveille à distance les exécutions YOLOv5 avec l'agent ClearML.
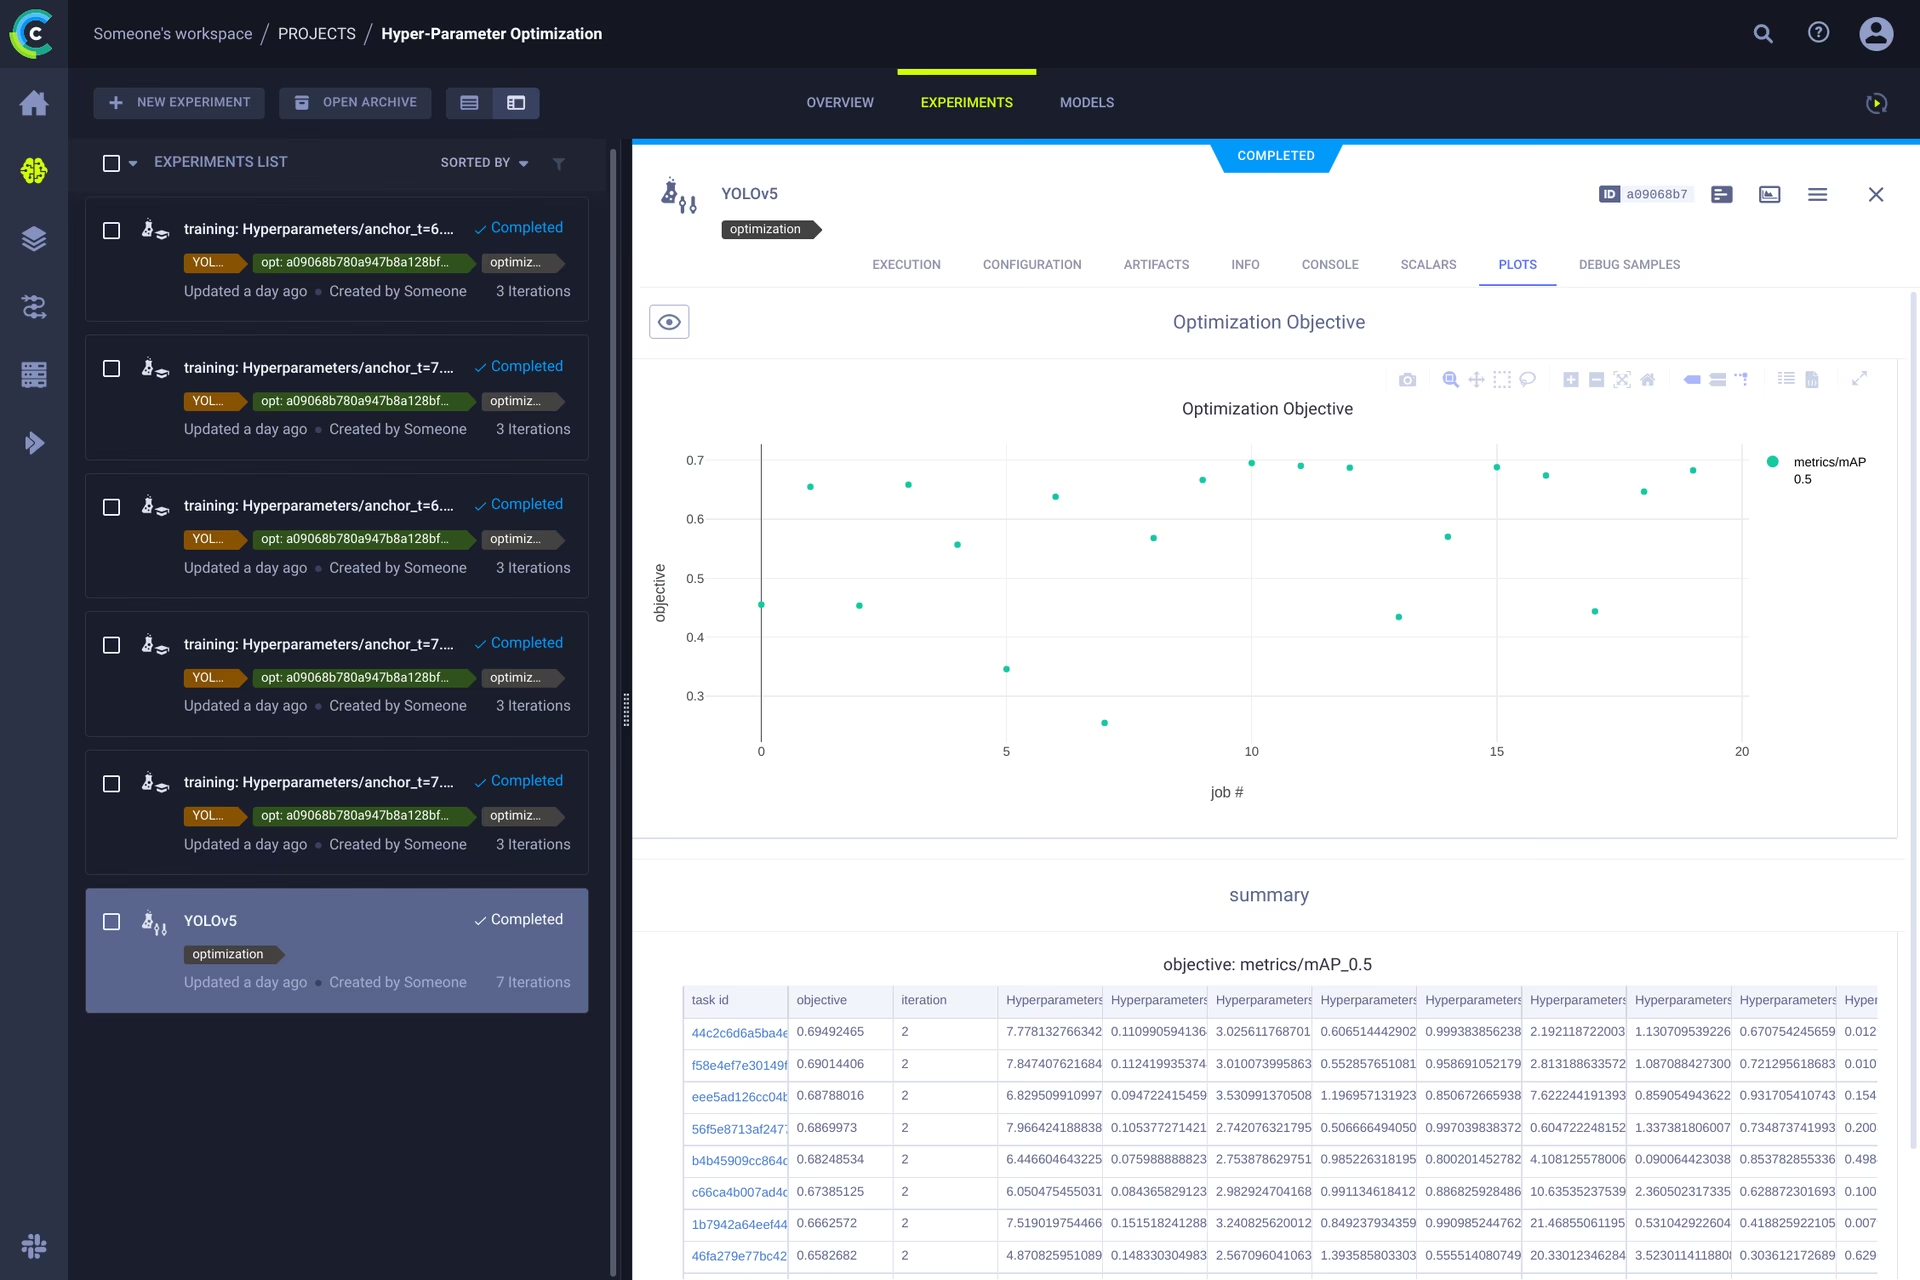
- 🔬 Trouve le meilleur mAP grâce à l'optimisation des hyperparamètres de ClearML.
- 🔭 Transforme ton modèle YOLOv5 en API en quelques commandes avec ClearML Serving.
Utilise autant ou aussi peu de ces outils que nécessaire : commence uniquement par le gestionnaire d'expériences ou combine-les tous pour créer un pipeline complet.
🦾 Mise en place#
ClearML doit communiquer avec un serveur pour suivre tes expériences et tes données. Tu as deux options :
- Inscris-toi au service hébergé gratuit de ClearML, ou
- Déploie ton propre serveur ClearML : il est open source et reste donc une option viable, même pour les données sensibles.
Installe ensuite le package Python clearml et connecte le SDK à ton serveur :
pip install clearmlGénère tes identifiants dans Paramètres → Espace de travail → Créer de nouveaux identifiants (en haut à droite de l'interface ClearML), puis exécute :
clearml-initSuis les instructions. Voilà, la configuration est terminée.
🚀 Entraîner YOLOv5 avec ClearML#
Pour activer le suivi des expériences, installe le package pip ClearML si ce n'est pas déjà fait :
pip install clearmlCette opération active l'intégration au script d'entraînement YOLOv5. À partir de maintenant, chaque exécution d'entraînement sera capturée et stockée par le gestionnaire d'expériences ClearML.
Pour personnaliser les noms du projet et de la tâche, transmets --project et --name à train.py. Les valeurs par défaut sont YOLOv5 et Training. ClearML utilise / comme séparateur de sous-projet ; évite donc / dans les noms de projet personnalisés.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheOu avec des noms personnalisés :
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheChaque exécution capture les éléments suivants :
- Le code source et les modifications non validées
- Les packages installés
- Les hyperparamètres
- Les points de contrôle du modèle (utilise
--save-period npour enregistrer un point de contrôle toutes lesnépoques) - La sortie de la console
- Les valeurs scalaires (mAP_0.5, mAP_0.5:0.95, précision, rappel, pertes, taux d'apprentissage)
- Les détails de la machine, la durée d'exécution et la date de création
- Les graphiques générés, comme le corrélogramme des étiquettes et la matrice de confusion
- Les images avec des boîtes englobantes pour chaque époque
- Les visualisations des mosaïques pour chaque époque
- Les images de validation pour chaque époque
Tout apparaît dans l'interface ClearML, ce qui te permet de surveiller l'entraînement depuis un seul endroit. Ajoute des colonnes personnalisées (par exemple, mAP_0.5) pour trier les modèles selon leurs performances, ou sélectionne plusieurs expériences pour les comparer côte à côte.
Poursuis ta lecture sur l'optimisation des hyperparamètres et l'exécution à distance.
🔗 Gestion des versions des jeux de données#
Le versionnage des données indépendamment du code facilite l'accès à la dernière version et garantit une reproductibilité complète. Ce dépôt accepte un ID de version du jeu de données, récupère automatiquement les données si elles sont manquantes et enregistre l'ID comme paramètre de tâche, afin que tu saches toujours quelles données ont été utilisées pour chaque expérience.
Préparer ton jeu de données#
Le dépôt YOLOv5 prend en charge de nombreux jeux de données via des fichiers de configuration YAML. Par défaut, les jeux de données sont téléchargés dans le dossier ../datasets, relatif à la racine du dépôt. Après le téléchargement de coco128, la structure des dossiers est la suivante :
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
Tous les jeux de données conviennent, à condition de conserver cette structure.
Ensuite, copie le fichier YAML du jeu de données dans le dossier racine du jeu de données : ClearML lit ce fichier pour utiliser correctement le jeu de données. Tu peux rédiger ton propre YAML en suivant la structure de l'exemple et en veillant à définir path, train, test, val, nc et names.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
Importer ton jeu de données#
Pour enregistrer le jeu de données en tant que jeu de données ClearML versionné, place-toi dans son dossier racine et exécute :
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync est l'abréviation de la séquence suivante, que tu peux également exécuter explicitement :
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
Entraîner un modèle avec un jeu de données ClearML#
Une fois le jeu de données enregistré, indique son ID pour lancer l'entraînement :
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 Optimisation des hyperparamètres#
Une fois les expériences et les données versionnées, tu peux t'appuyer dessus. Comme chaque expérience suivie capture l'environnement complet — code, packages installés et configuration —, les exécutions sont entièrement reproductibles. ClearML te permet de cloner une expérience, de modifier ses paramètres et de la relancer automatiquement, ce qui constitue la base de l'optimisation des hyperparamètres (HPO).
Pour exécuter HPO en local, utilise le script fourni. Vérifie d'abord qu'une tâche d'entraînement existe dans le gestionnaire d'expériences : le script la clone et fait varier ses hyperparamètres.
Renseigne l'ID de la tâche modèle dans utils/loggers/clearml/hpo.py, puis exécute :
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
Pour exécuter les essais sur des agents distants, remplace optimizer.start_locally() par optimizer.start() et définis execution_queue dans l'appel HyperParameterOptimizer avec la file d'attente à laquelle tes agents sont connectés.
🤯 Exécution à distance (avancé)#
L'exécution locale de HPO est pratique, mais tu voudras souvent lancer des expériences sur du matériel plus puissant — une machine GPU sur site ou une instance cloud. C'est le rôle de l'agent ClearML :
Chaque expérience suivie contient tout ce qui est nécessaire pour la reproduire sur une autre machine (packages installés, modifications non validées et configuration). Un agent ClearML surveille une file d'attente, récupère les tâches entrantes, recrée l'environnement, exécute le travail et renvoie les valeurs scalaires et les graphiques au gestionnaire d'expériences.
Transforme n'importe quelle machine — une VM cloud, un ordinateur local équipé d'un GPU ou un ordinateur portable — en agent ClearML avec :
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]Clonage, modification et mise en file d'attente#
Lorsqu'un agent est en cours d'exécution, tu peux lui attribuer directement du travail depuis l'interface :
- 🪄 Fais un clic droit sur une expérience et clone-la.
- 🎯 Modifie ses hyperparamètres.
- ⏳ Fais un clic droit sur la tâche clonée et ajoute-la à une file d'attente cible.
Exécuter une tâche à distance#
Tu peux aussi programmer l'exécution à distance d'un script en cours en ajoutant task.execute_remotely() après l'initialisation du logger ClearML. Ajoute la ligne mise en évidence à train.py :
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ AJOUTE CETTE LIGNE
    # ...
    # Traiter le lien d'artefact du jeu de données personnalisé
    data_dict = loggers.remote_dataset
# ...
Après cette modification, le script d'entraînement s'exécute jusqu'à cette ligne, regroupe le code et l'envoie à la file d'attente.
Mise à l'échelle automatique des workers#
ClearML fournit des outils de mise à l'échelle automatique qui lancent des machines distantes sur AWS, GCP ou Azure lorsqu'une file d'attente contient des expériences en attente, les convertissent en agents ClearML et les arrêtent lorsque le travail est terminé. Tu ne paies ainsi que pour les ressources de calcul réellement utilisées.
Regarde la vidéo de prise en main ci-dessous :
En savoir plus#
Pour en savoir plus sur l'intégration de ClearML aux modèles Ultralytics, consulte notre guide d'intégration ClearML et découvre comment améliorer ton workflow MLOps avec d'autres outils de suivi des expériences.
FAQ#
Non. Le service hébergé gratuit sur app.clear.ml fonctionne dès l’installation après
clearml-init. L’auto-hébergement est facultatif et constitue le choix habituel lorsque les données ne peuvent pas quitter ton réseau.YOLOv5 active l’intégration dès que le package
clearmlpeut être importé. Désinstalle-le avecpip uninstall clearmlpour désactiver le suivi lors d’une exécution.Enregistre le jeu de données avec
clearml-data sync, puis transmets son ID comme argument de données :python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. L’ID est consigné dans la tâche afin que chaque expérience sache exactement quelles données elle a utilisées.Oui. Démarre un
clearml-agent daemonsur chaque machine, puis ajoute des expériences clonées à la file d’attente depuis l’interface, ou modifieutils/loggers/clearml/hpo.pypour appeleroptimizer.start()en définissantexecution_queueafin que l’optimiseur envoie les essais dans la file d’attente.