Stratégies de collecte et d’annotation des données en vision par ordinateur
La collecte des données et l’annotation sont les deux étapes fondamentales de tout projet de vision par ordinateur : tu rassembles des images ou des vidéos représentatives, puis tu les étiquettes pour que le modèle puisse apprendre à partir de celles-ci. La qualité de ces données détermine directement les performances du modèle ; il est donc essentiel de définir les classes, de choisir des sources non biaisées et d’assurer une annotation cohérente avant de commencer l’entraînement.
Regarder : Comment élaborer des stratégies efficaces de collecte et d’annotation des données pour la vision par ordinateur 🚀
Ce guide aborde la définition des classes et la collecte des données, l’annotation des données, ainsi que les types et formats d’annotation disponibles, et les stratégies d’étiquetage efficaces — chaque décision étant alignée sur les objectifs de ton projet.
Définir les classes et collecter les données#
La collecte d’images et de vidéos pour un projet de vision par ordinateur repose sur trois décisions : le nombre de classes à définir, les sources de données à choisir et les moyens de préserver l’impartialité du jeu de données.
Choisir les classes adaptées à ton projet#
L’une des premières questions à se poser au lancement d’un projet de vision par ordinateur est le nombre de classes à inclure. Tu dois déterminer les catégories ou les étiquettes que ton modèle devra reconnaître et différencier. Le nombre de classes doit être défini en fonction des objectifs spécifiques de ton projet.
Par exemple, si tu veux surveiller la circulation, tes classes peuvent inclure « voiture », « camion », « bus », « moto » et « vélo ». En revanche, pour suivre les articles dans un magasin, tes classes peuvent être « fruits », « légumes », « boissons » et « collations ». Définir les classes en fonction des objectifs de ton projet permet de garder un jeu de données pertinent et ciblé.
Lorsque tu définis tes classes, il est également important de choisir entre un nombre restreint de classes générales et un nombre plus élevé de classes détaillées. Le « nombre de classes » désigne le nombre de classes distinctes qui t’intéressent. Ce choix influe sur le niveau de détail de tes données et sur la complexité de ton modèle. Voici les éléments à prendre en compte pour chaque approche :
- Nombre restreint de classes : il s’agit de catégories plus larges et inclusives, comme « véhicule » et « non-véhicule ». Elles simplifient l’annotation et nécessitent moins de ressources de calcul, mais fournissent des informations moins détaillées, ce qui peut limiter l’efficacité du modèle dans des scénarios complexes.
- Nombre élevé de classes : il s’agit de catégories plus nombreuses et plus précises, comme « berline », « SUV », « camionnette » et « moto ». Elles fournissent des informations plus détaillées, ce qui améliore la précision et les performances du modèle. Leur annotation prend toutefois plus de temps et d’efforts, et elles nécessitent davantage de ressources de calcul.
Commencer avec des classes plus précises peut être très utile, en particulier dans les projets complexes où les détails comptent. Des classes plus précises te permettent de recueillir des données plus détaillées, d’obtenir des informations plus approfondies et de mieux distinguer les catégories. Cela améliore la précision du modèle et facilite aussi son ajustement ultérieur, si nécessaire, ce qui permet d’économiser du temps et des ressources.
Sources de données#
Tu peux utiliser des jeux de données publics ou recueillir tes propres données. Les jeux de données publics, comme ceux disponibles sur Kaggle et Google Dataset Search Engine, proposent des données normalisées et bien annotées, ce qui en fait d’excellents points de départ pour entraîner et valider des modèles.
En revanche, la collecte de données personnalisées te permet d’adapter ton jeu de données à tes besoins spécifiques. Tu peux capturer des images et des vidéos avec des caméras ou des drones, récupérer des images sur le Web ou utiliser les données internes déjà disponibles dans ton organisation. Les données personnalisées te donnent davantage de contrôle sur leur qualité et leur pertinence. En combinant des sources publiques et personnalisées, tu peux créer un jeu de données varié et complet.
Éviter les biais dans la collecte des données#
Un biais apparaît lorsque certains groupes ou scénarios sont sous-représentés ou surreprésentés dans ton jeu de données. Le modèle obtenu peut alors bien fonctionner sur certaines données, mais mal sur d’autres. Il est essentiel d’éviter les biais en IA pour que ton modèle de vision par ordinateur fonctionne correctement dans des scénarios variés.
Voici comment éviter les biais lors de la collecte des données :
- Diversité des sources : collecte des données provenant de nombreuses sources afin de couvrir différents points de vue et scénarios.
- Représentation équilibrée : veille à représenter équitablement tous les groupes concernés. Pense, par exemple, à varier les âges, les genres et les origines ethniques.
- Suivi continu : examine et actualise régulièrement ton jeu de données pour repérer et corriger les biais émergents.
- Techniques d’atténuation des biais : utilise des méthodes telles que le suréchantillonnage des classes sous-représentées, l’augmentation des données et les algorithmes conçus pour favoriser l’équité.
En suivant ces pratiques, tu peux créer un modèle plus robuste et plus équitable, capable de bien généraliser dans des applications réelles.
Qu’est-ce que l’annotation des données ?#
L’annotation des données consiste à étiqueter les données pour les rendre exploitables lors de l’entraînement de modèles d’apprentissage automatique. En vision par ordinateur, cela signifie étiqueter les images ou les vidéos avec les informations dont un modèle a besoin pour apprendre. Sans données correctement annotées, les modèles ne peuvent pas apprendre avec précision les relations entre les entrées et les sorties.
Types d’annotation des données#
Selon les exigences spécifiques d’une tâche de vision par ordinateur, différents types d’annotation des données sont possibles. En voici quelques exemples :
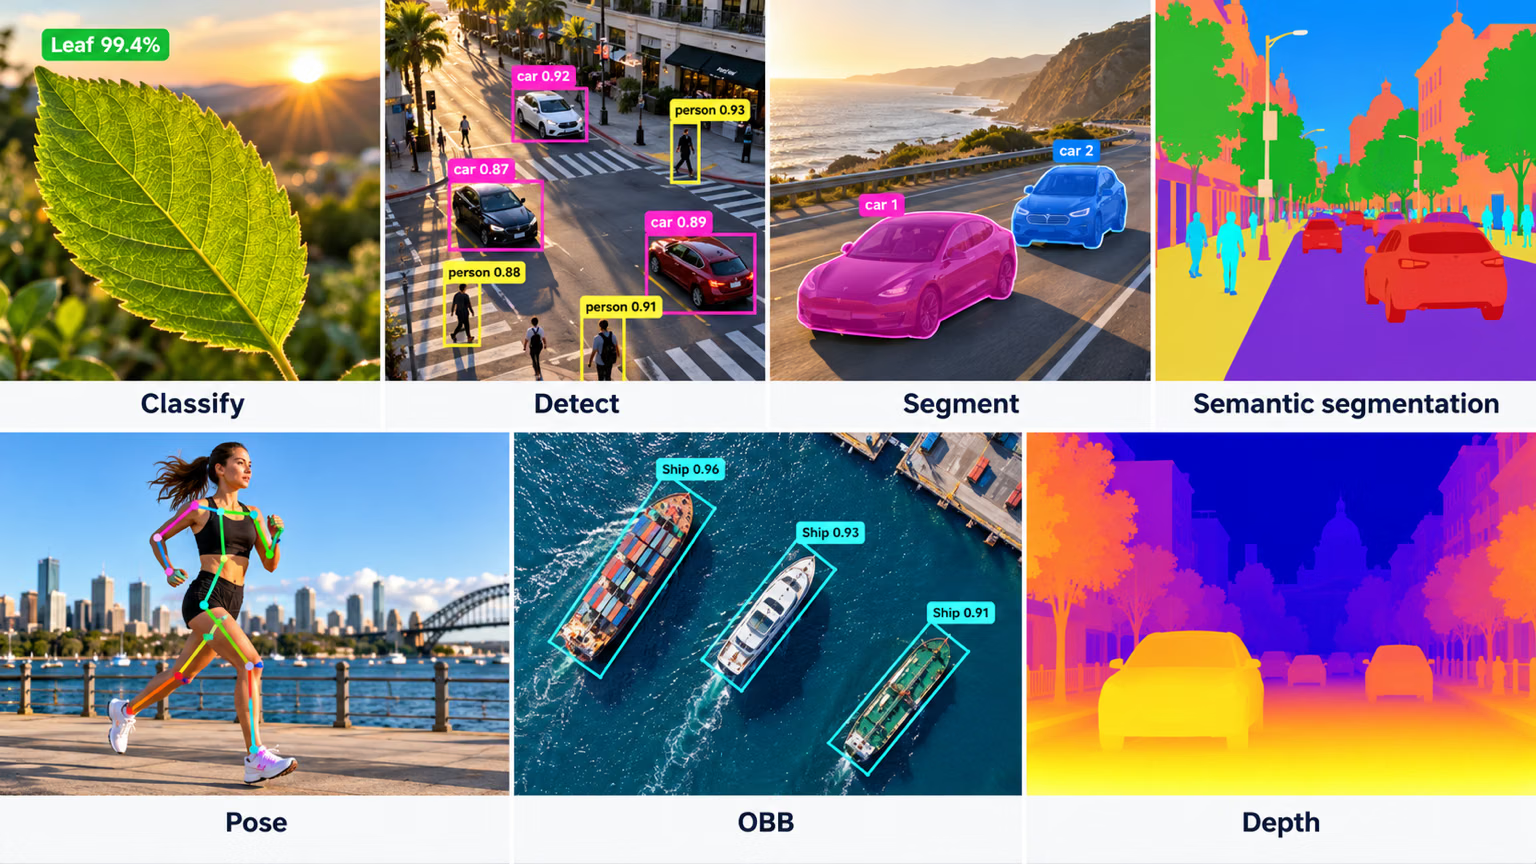
- Boîtes englobantes : rectangles dessinés autour des objets dans une image et principalement utilisés pour la détection d’objets. Ces boîtes sont définies par les coordonnées de leurs coins supérieur gauche et inférieur droit.
- Polygones : contours détaillés des objets, qui permettent une annotation plus précise qu’avec des boîtes englobantes. Les polygones sont utilisés dans des tâches comme la segmentation d’instances, où la forme de l’objet est importante.
- Masques : masques binaires où chaque pixel appartient soit à un objet, soit à l’arrière-plan. Les masques sont utilisés pour la segmentation sémantique, afin d’obtenir des détails au niveau du pixel.
- Points clés : points spécifiques marqués dans une image pour repérer des emplacements d’intérêt. Les points clés sont utilisés dans des tâches comme l’estimation de pose et la détection des repères faciaux.
- Boîtes englobantes orientées : rectangles associés à un angle de rotation, utilisés dans les tâches d’OBB où les objets peuvent apparaître dans n’importe quelle orientation, par exemple dans les images aériennes.
Formats d’annotation courants#
Après avoir choisi un type d’annotation, il est important de sélectionner le format approprié pour stocker et partager les annotations. Les formats les plus courants sont les suivants :
| Format | Structure des fichiers | Utilisations courantes |
|---|---|---|
| COCO | Un seul fichier JSON | Détection d’objets, segmentation d’instances, détection de points clés, segmentation de régions non constituées d’objets et segmentation panoptique, légendage d’images |
| Pascal VOC | Un fichier XML par image | Détection d’objets |
| YOLO | Un fichier .txt par image | Détection d’objets, segmentation, pose et boîtes orientées |
Le format YOLO stocke une ligne par objet, avec des indices de classe commençant à 0. Pour la détection d’objets, la ligne est class x_center y_center width height avec des coordonnées normalisées entre 0 et 1. Une ligne de segmentation remplace la boîte par les points du polygone normalisés de l’objet, tandis qu’une ligne de pose conserve la boîte et ajoute les coordonnées des points clés à la suite, avec un indicateur de visibilité pour chaque point clé lorsque le jeu de données déclare kpt_shape: [n, 3]. Une ligne OBB stocke class x1 y1 x2 y2 x3 y3 x4 y4 à l’aide de coordonnées de sommets normalisées.
Si ton outil d’annotation exporte du JSON COCO, tu peux soit le convertir en étiquettes YOLO .txt, soit entraîner directement le modèle à partir du JSON avec une classe de jeu de données personnalisée.
Définir des consignes d’annotation#
Après avoir choisi le type et le format d’annotation, l’étape suivante consiste à établir des règles d’étiquetage claires et objectives. Ces règles servent de guide pour assurer la cohérence et l’exactitude tout au long du processus d’annotation. Elles doivent notamment porter sur les points suivants :
- Clarté et précision : veille à ce que tes consignes soient claires. Utilise des exemples et des illustrations pour montrer ce qui est attendu.
- Cohérence : veille à uniformiser tes annotations. Définis des critères standard pour annoter les différents types de données afin que toutes les annotations suivent les mêmes règles.
- Réduction des biais : reste neutre. Apprends à rester objectif et à réduire tes biais personnels pour garantir des annotations équitables.
- Efficacité : Utilise des outils et des workflows qui automatisent les tâches répétitives afin d’accélérer et d’optimiser le processus d’annotation.
En examinant et en actualisant régulièrement tes règles d’étiquetage, tu maintiendras des annotations exactes et cohérentes, alignées sur les objectifs de ton projet.
Outils d’annotation#
Un bon outil d’annotation te permet d’étiqueter chaque type requis par ta tâche, garantit le respect de consignes cohérentes et exporte les étiquettes dans un format prêt pour l’entraînement. La plateforme Ultralytics propose un éditeur d’annotations intégré qui prend en charge la détection, la segmentation d’instances, la segmentation sémantique, la classification, l’estimation de pose et l’OBB, avec une annotation intelligente assistée par SAM qui génère un masque à partir d’un simple clic pour les tâches de détection, de segmentation d’instances, de segmentation sémantique et d’OBB. Comme les annotations sont enregistrées dans la structure attendue pour chaque tâche — des lignes YOLO .txt pour les tâches spatiales et des dossiers de classes pour la classification —, ton jeu de données étiqueté peut passer directement à l’entraînement, sans étape de conversion.
Qualité des annotations : exactitude, précision et valeurs aberrantes#
Avant d’annoter à grande échelle, il est utile de comprendre l’exactitude, la précision, les valeurs aberrantes et le contrôle qualité, afin d’éviter d’étiqueter tes données de manière contre-productive.
Comprendre l’exactitude et la précision#
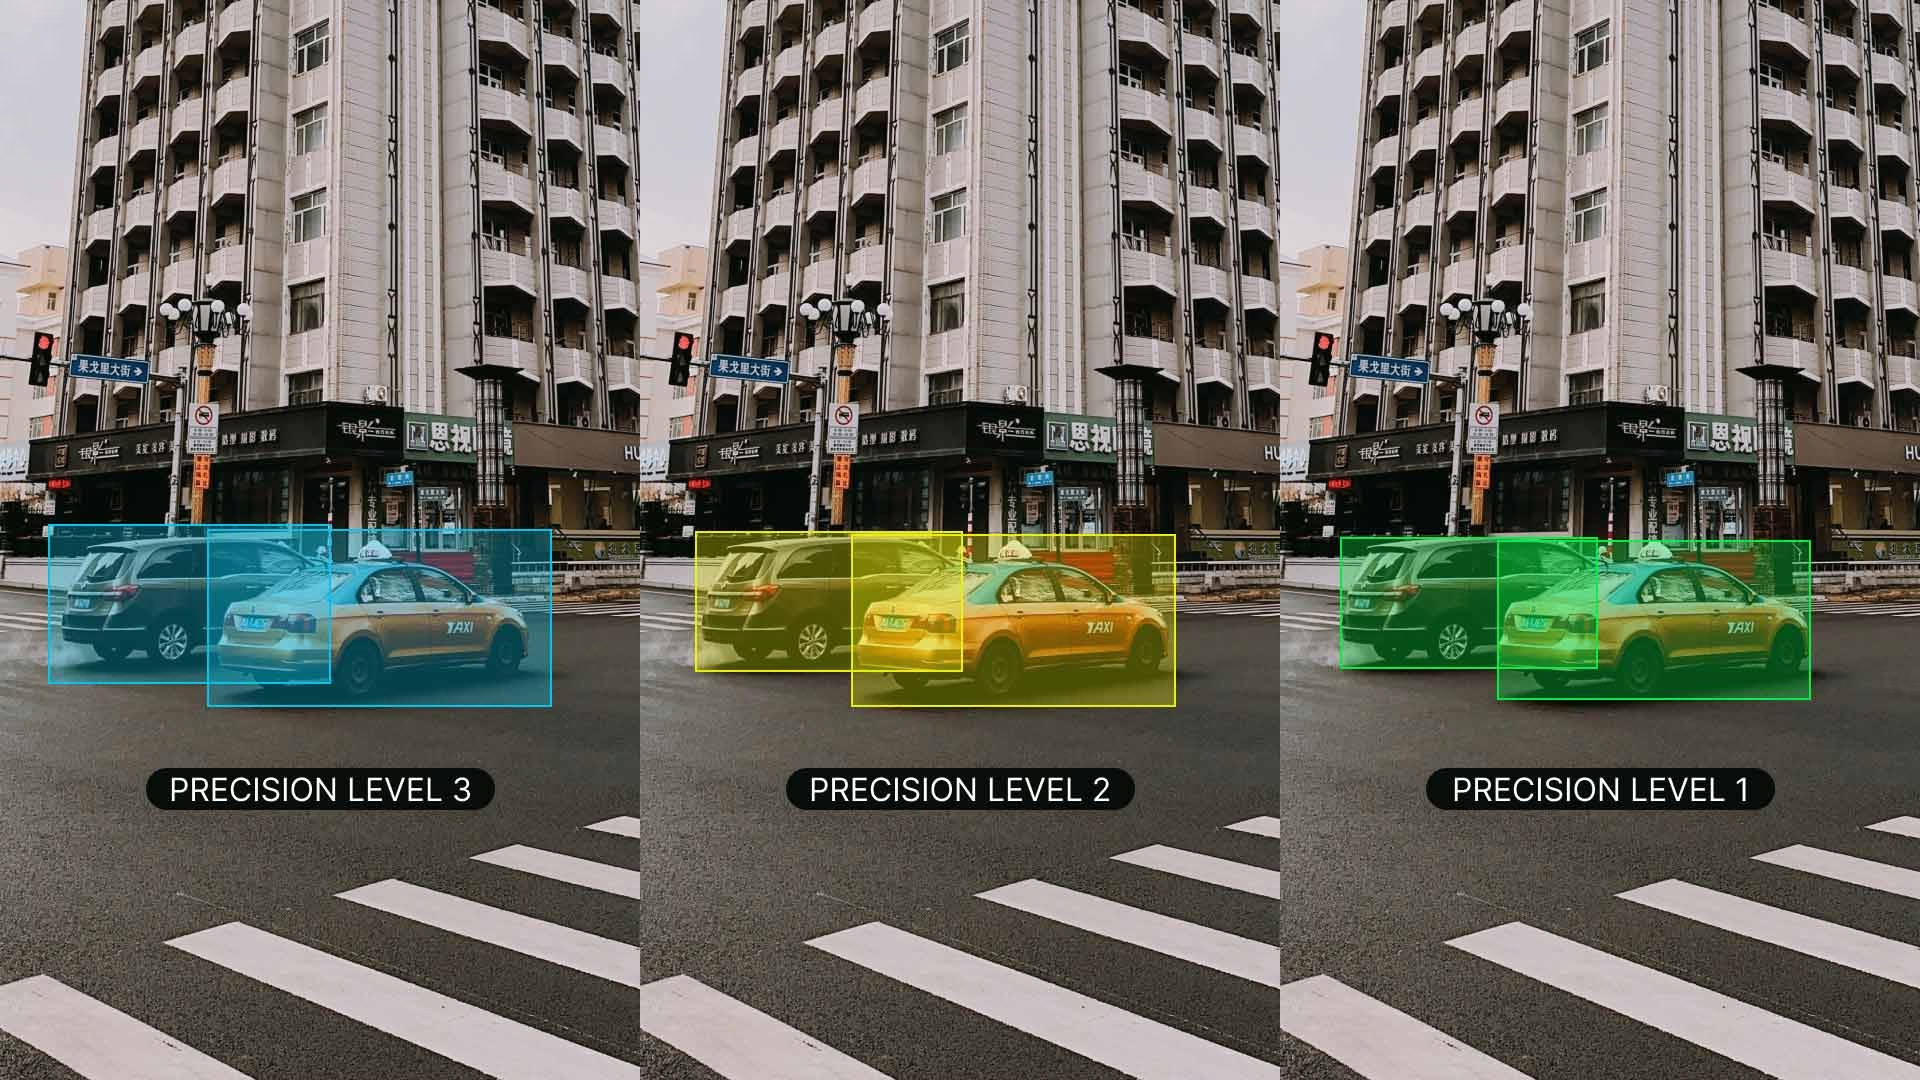
Il est important de comprendre la différence entre l’exactitude et la précision, ainsi que leur lien avec l’annotation. L’exactitude indique dans quelle mesure les données annotées sont proches des valeurs réelles. Elle permet de mesurer la fidélité des étiquettes aux situations du monde réel. La précision indique la cohérence des annotations. Elle permet de vérifier si tu attribues la même étiquette au même objet ou à la même caractéristique dans l’ensemble du jeu de données. Une exactitude et une précision élevées permettent de mieux entraîner les modèles en réduisant le bruit et en améliorant leur capacité à généraliser à partir des données d’entraînement.
Repérer les valeurs aberrantes#
Les valeurs aberrantes sont des points de données qui s’écartent considérablement des autres observations du jeu de données. Dans le cas des annotations, il peut s’agir d’une image étiquetée incorrectement ou d’une annotation qui ne correspond pas au reste du jeu de données. Ces valeurs sont problématiques, car elles peuvent fausser l’apprentissage du modèle et entraîner des prédictions inexactes ainsi qu’une mauvaise généralisation.
Tu peux utiliser différentes méthodes pour détecter et corriger les valeurs aberrantes :
- Techniques statistiques : pour détecter les valeurs aberrantes dans les caractéristiques numériques comme les valeurs des pixels, les coordonnées des boîtes englobantes ou la taille des objets, tu peux utiliser des méthodes telles que les diagrammes en boîte, les histogrammes ou les scores z.
- Techniques visuelles : pour repérer les anomalies dans les caractéristiques catégorielles comme les classes d’objets, les couleurs ou les formes, utilise des méthodes visuelles telles que l’affichage d’images, d’étiquettes ou de cartes thermiques.
- Méthodes algorithmiques : Utilise des outils comme le clustering (par ex. le clustering K-means, DBSCAN) et les algorithmes de détection d’anomalies pour repérer les valeurs aberrantes en fonction des tendances de distribution des données.
Contrôle qualité des données annotées#
Comme pour tout projet technique, le contrôle qualité est indispensable pour les données annotées. Il est recommandé de vérifier régulièrement les annotations afin de s’assurer qu’elles sont exactes et cohérentes. Voici quelques méthodes pour y parvenir :
- Examiner des échantillons de données annotées
- Utiliser des outils automatisés pour repérer les erreurs courantes
- Demander à une autre personne de vérifier les annotations
Si tu travailles avec plusieurs personnes, la cohérence entre les différents annotateurs est importante. Un bon accord inter-annotateurs signifie que les consignes sont claires et que tout le monde les suit de la même manière. Cela permet à toute l’équipe d’être sur la même longueur d’onde et garantit la cohérence des annotations.
Si tu repères des erreurs lors de la vérification, corrige-les et mets à jour les consignes pour éviter qu’elles ne se reproduisent. Donne des retours aux annotateurs et propose des formations régulières pour les aider à réduire les erreurs. Un processus rigoureux de traitement des erreurs permet de préserver l’exactitude et la fiabilité de ton jeu de données.
Stratégies efficaces d’annotation des données#
Pour rendre le processus d’annotation des données plus fluide et efficace, envisage de mettre en œuvre les stratégies suivantes :
- Consignes d’annotation claires : Fournis des instructions détaillées accompagnées d’exemples afin que tous les annotateurs interprètent les tâches de façon cohérente. Par exemple, pour annoter des oiseaux, précise s’il faut inclure l’oiseau entier ou seulement certaines parties.
- Contrôles qualité réguliers : Définis des critères de référence et utilise des indicateurs spécifiques pour examiner le travail, en maintenant des exigences élevées grâce à des retours continus.
- Utilise des outils de préannotation : De nombreuses plateformes d’annotation modernes proposent des fonctionnalités de préannotation assistée par l’IA qui peuvent accélérer considérablement le processus en générant automatiquement des annotations initiales que les humains peuvent ensuite affiner.
- Mets en œuvre l’apprentissage actif : cette approche donne la priorité à l’étiquetage des échantillons les plus informatifs, ce qui peut réduire le nombre total d’annotations nécessaires tout en maintenant les performances du modèle.
- Traitement par lots : Regroupe les images similaires pour l’annotation afin de maintenir la cohérence et d’améliorer l’efficacité.
Ces stratégies peuvent contribuer à maintenir des annotations de grande qualité tout en réduisant le temps et les ressources nécessaires au processus d’annotation.
Conclusion#
La collecte de données diversifiées et non biaisées, puis leur annotation cohérente à l’aide des bons outils, constitue la base d’un modèle de vision par ordinateur fiable. Une fois ton jeu de données collecté et annoté, consulte le guide des étapes d’un projet de vision par ordinateur pour passer à l’entraînement et à l’évaluation. Si tu as des questions en cours de route, adresse-toi à la communauté sur le dépôt GitHub d’Ultralytics ou le serveur Discord d’Ultralytics.
FAQ#
Pour minimiser les biais, collecte des données provenant de sources variées, veille à ce que tous les groupes concernés (par exemple, différents âges, genres et groupes ethniques) soient représentés de façon équilibrée, examine et actualise régulièrement ton jeu de données pour détecter les biais émergents, et applique des techniques d’atténuation comme le suréchantillonnage des classes sous-représentées, l’augmentation des données et les algorithmes tenant compte de l’équité. Cette méthode permet à ton modèle de vision par ordinateur de rester performant dans des scénarios réels variés et améliore sa capacité de généralisation.
Établis des consignes d’annotation claires et objectives, accompagnées d’instructions détaillées, d’exemples et d’illustrations, puis applique-les uniformément à tous les types de données afin que chaque annotation suive les mêmes règles. Forme les annotateurs à rester neutres pour réduire les biais personnels, révise et actualise régulièrement les consignes, et utilise des contrôles de cohérence automatisés ainsi que les retours entre annotateurs pour maintenir une grande précision conforme aux objectifs de ton projet.
Quelques centaines d’objets annotés par classe suffisent pour commencer à expérimenter l’apprentissage par transfert, mais pour obtenir des performances fiables dans des conditions réelles, Ultralytics recommande au moins 1 500 images et 10 000 instances annotées par classe. Associe un jeu de données suffisamment volumineux à un calendrier d’entraînement raisonnable — environ 300 époques est un point de départ courant, à réduire si le modèle surapprend rapidement — et veille à ce que tes annotations soient rigoureuses et conformes aux objectifs spécifiques de ton projet. Découvre des stratégies d’entraînement détaillées dans le guide d’entraînement de YOLO26.
Oui. Ultralytics Platform intègre un éditeur d’annotations qui prend en charge les boîtes englobantes, les polygones, les points clés, les boîtes orientées et les étiquettes de classification dans un même espace de travail. L’annotation intelligente basée sur SAM accélère l’étiquetage des tâches de détection, de segmentation d’instances, de segmentation sémantique et d’OBB en générant des masques d’un seul clic ; les jeux de données de pose peuvent utiliser les modèles de pose YOLO pour l’annotation intelligente, tandis que la classification est annotée manuellement. Les annotations sont stockées dans le format attendu par chaque tâche — des lignes YOLO
.txtpour les tâches spatiales et des dossiers de classes pour la classification —, prêtes pour l’entraînement.Choisis le type d’annotation en fonction de la tâche que tu veux entraîner. Les boîtes englobantes sont les plus rapides à tracer et suffisent à la détection d’objets. Les polygones et les masques demandent nettement plus de temps par objet, mais sont nécessaires pour la segmentation d’instances lorsque la forme exacte d’un objet importe. Les points clés conviennent à l’estimation de pose et à la détection de repères, tandis que les boîtes orientées conviennent aux tâches OBB, comme l’imagerie aérienne, où un rectangle aligné sur les axes engloberait trop d’arrière-plan. En annotant pour la tâche la plus précise dont tu as réellement besoin, tu maintiens l’effort d’annotation proportionnel au résultat attendu.


Commentaires16
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
 Letícia Rama
Hello,
Has anyone worked with oriented object detection using a multisource dataset that combines satellite and UAV imagery?
I am currently developing a scientific project focused on oriented detection of fishing vessels. As part of this work, I conducted two systematic reviews: one covering existing oriented detection models and another covering publicly available datasets. So far, I have identified multisource datasets that combine imagery from multiple satellite platforms; however, I have not found datasets that explicitly integrate both satellite and UAV images.
I understand the importance of source diversity to mitigate dataset bias and improve model generalization. That said, I would appreciate insights from the community on whether combining UAV and satellite imagery might introduce excessive domain variability (e.g., differences in spatial resolution, viewing angles, and sensor characteristics), potentially hindering model training and convergence.
Any experiences, references, or best practices related to this type of multisource setup would be highly appreciated.
 Glenn JocherUltralytics
Great question—mixing UAV + satellite can increase domain shift (GSD/resolution, look-angle, sensor PSF), but it’s usually manageable if you control the dataset and evaluation: keep one unified, very explicit labeling policy (same object extent/rotation rules) and balanced sampling as described in our Data Collection and Annotation guide, then train with per-source “slice” validation (sat-only/UAV-only) and consider staged training (pretrain on the larger domain, then fine-tune on the smaller) rather than a single fully-mixed run; if you’re using Ultralytics YOLO for oriented detection, the OBB task docs cover the expected label format and training flow—feel free to share your planned split strategy and a couple example tiles (UAV + satellite) here and the team/community can sanity-check the setup.
1- Letícia Rama
Hi Glenn,
To be more specific,
I am using a pretrained yolo26 m obb to perform detection of a single class: ships of a particular type (fishing boats).
I have a dataset with satellite optical images collected from google earth pro counting 331 pairs of images/labels. The total number of instances is 5974. Images size are fixed at 4823 height x 8192 width. The bounding boxes have 0.075 height x 0.04 width (according to yolo train results). Resolution varies from very-low to very-high. The images were captured with an altitude between 200-400 meters.
I also have 21 very-high resolution images collected from UAV. Images size are fixed at 3072 height x 4096 width. The images were captured with an altitude of 120 meters.
I would like to test if incorporating UAV images in training data would improved the models hability to detect the objects.
From what you proposed, please confirm if I understood correctly:
- Should the train set be mixed (sat+UAV) and the validation set be separate (sat-only/UAV-only)?
- If so, is this separation configured the staged training you are refering? That is, pretrain with sat+UAV as the train set and sat-only as validation subset, and further fine-tune with the same train subset (sat+UAV) but now using the uav-only as the validation set?
Thanks
- Letícia Rama
OBS.: sorry, sometimes I wrote 'train subset', and 'validation subset' but all of them was supposed to be written as 'train set', and 'validation set'.
- Glenn JocherUltralytics
Your first interpretation is correct: compare a satellite-only baseline against mixed satellite+UAV training while keeping fixed, disjoint satellite-only and UAV-only evaluation sets. This is not staged training—changing only the validation set does not fine-tune the model. Staged training would first train on satellite data, then continue from that checkpoint using only the UAV training split with a lower learning rate, evaluating both domains afterward. With only 21 UAV images, split by original scene before tiling to prevent leakage, and consider grouped k-fold validation because a single UAV split will be unstable.
1 - Letícia Rama
Understood, thanks.
Sudharsanam-1
hello ! For detecting 31 Chinese symbols (16 true and 15 fake), how many classes should be used in the model? Is it more efficient to detect the true symbols using only true class , or should we also include the fake symbols as separate classes?
Team-Q-Botix
I’m working on Robocon 2026 (Kung Fu Quest) and using YOLO-seg for detecting KFS symbols — ancient Chinese oracle bone characters. There are 15 true symbols, 15 fake ones (random patterns mimicking the real ones), plus 1 “other” class → total 31 classes.
Do you think instance segmentation (YOLOv8-seg / YOLOv11-seg) is the right approach for these detailed 2D symbols, or would box detection + contour refinement be better? Also, any advice on which model to start with and how large a dataset (per class) you’d recommend for good mask performance on Jetson Orin?
robert-hardman
Hello In object recognition with YOLO11 If we label images by drawing polygons: When training, does YOLO11 convert polygon coordinates to boxes? How does Inference handle polygon coordinates?
- Glenn JocherUltralytics
@robert-hardman yOLO11 does not inherently convert polygon annotations to bounding boxes during training. Polygons are used directly for tasks like instance segmentation, while bounding boxes are utilized for object detection. During inference, polygon annotations are retained for segmentation tasks, ensuring accurate object shape representation. For more on annotation types, refer to Data Annotation Guide.
1
ghost
Hello, thanks for the info ! I would like to know how to perform active learning, specifically what are the metrics to choose the most informative images when the task is multi-instance multi-class object detection ?
 Paula DerrengerUltralytics(modifié)
@cawilchesp hello! Great question on active learning for multi-instance multi-class object detection. Active learning can significantly enhance your model by iteratively selecting the most informative samples for annotation. Here are some key metrics and strategies to consider:
Metrics for Selecting Informative Images:
-
Uncertainty Sampling: Choose images where the model is least confident. This can be measured using:
- Entropy: High entropy indicates uncertainty in predictions.
- Margin Sampling: Select samples where the difference between the top two class probabilities is smallest.
- Least Confidence: Select samples with the lowest maximum class probability.
-
Diversity Sampling: Ensure a diverse set of samples to avoid redundancy.
- Core-Set Selection: Use clustering techniques to select a diverse subset of data points.
- Representative Sampling: Choose samples that represent the overall data distribution.
-
Error-Based Sampling: Focus on samples where the model previously made errors.
- Misclassified Samples: Select images where the model's predictions were incorrect.
- High Loss Samples: Choose samples with high loss values during training.
Implementing Active Learning:
Here's a basic example using least-confidence uncertainty sampling for detection, based on each image's mean box confidence (
result.probsis only available for classification models):import numpy as np from ultralytics import YOLO # Load your model model = YOLO('yolo26n.pt') # Predict on a batch of images results = model(['image1.jpg', 'image2.jpg', 'image3.jpg']) # Mean box confidence per image (0 if nothing was detected) scores = [r.boxes.conf.mean().item() if len(r.boxes) else 0.0 for r in results] # Select the image with the lowest confidence most_informative_image = results[int(np.argmin(scores))]Additional Resources:
For more detailed strategies and examples, you can refer to our Data Collection and Annotation Strategies.
Feel free to experiment with these methods and see which works best for your specific use case. If you have any further questions or need more examples, don't hesitate to ask! 😊
-
MoAbbasid
Hello, Im looking for an open source annotation tool similar to labelme that exports directly to YOLOv8 format, something other than labelme?
- Glenn JocherUltralytics
@MoAbbasid hello! For an open-source annotation tool that exports directly to YOLOv8 format, you might want to try CVAT. It's quite versatile and supports exporting annotations directly into YOLO format among others. Another good option could be Label Studio, which offers flexibility in configuring export formats, including YOLO. Both tools provide robust features for efficient data labeling and are well-suited for various annotation tasks. Happy annotating! 😊
1 @glenn-jocher do they offer polygon annotations for instance segmentation?
- Glenn JocherUltralytics(modifié)
Hello @MoAbbasid,
Yes, Ultralytics YOLO does support polygon annotations for instance segmentation. This allows for more precise labeling of objects compared to traditional bounding boxes, which can be particularly useful for complex shapes and detailed segmentation tasks.
To create polygon annotations, you can use tools like Roboflow Annotate or CVAT. Both of these tools support polygon annotations and can export the data in a format compatible with Ultralytics YOLO.
Here's a brief overview of how you can use Roboflow for this purpose:
- Create a Project: Start by creating a new project in Roboflow.
- Upload Images: Upload your images to the project.
- Annotate Images: Use the polygon tool to draw detailed outlines around objects. Roboflow also offers a SAM-based label assistant to speed up the annotation process.
- Export Annotations: Once your annotations are complete, you can export the dataset in YOLO format.
For more detailed steps on using Roboflow for data annotation and management, you can refer to the Roboflow documentation.
Here's a quick example of how to load and use a dataset with polygon annotations:
from ultralytics import YOLO

# Load a YOLO26 segmentation model
model = YOLO('yolo26n-seg.pt')

# Train the model on your custom dataset
model.train(data='path/to/your/dataset.yaml', epochs=100, imgsz=640)

# Validate the model
metrics = model.val()

# Make predictions
results = model.predict(source='path/to/your/images')

# Visualize results
results[0].show()
Feel free to reach out if you have any more questions or need further assistance. Happy annotating! 😊
1