Présentation des jeux de données de détection d'objets
L'entraînement d'un modèle robuste et précis de détection d'objets nécessite un jeu de données complet. Ce guide présente différents formats de jeux de données compatibles avec le modèle Ultralytics YOLO et explique leur structure, leur utilisation et la conversion d'un format à un autre.
Formats de jeux de données pris en charge#
Format Ultralytics YOLO#
Le format Ultralytics YOLO est un format de configuration de jeu de données qui te permet de définir le répertoire racine du jeu de données, les chemins relatifs vers les répertoires d'images d'entraînement, de validation et de test ou vers des fichiers *.txt contenant des chemins d'images, ainsi qu'un dictionnaire de noms de classes. Voici un exemple :
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8 dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco8
# Example usage: yolo train data=coco8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8.ziptrain, val et test acceptent chacun un répertoire, un fichier image, une liste de répertoires ou de fichiers image, ou un fichier UTF-8 *.txt répertoriant un chemin d’image par ligne (les chemins commençant par ./ sont résolus par rapport au fichier *.txt). Un fichier *.txt est utile pour entraîner un modèle sur un sous-ensemble d’un répertoire, ignorer les images non annotées ou combiner des images provenant de plusieurs sources dans une même partition.
path: datasets/coco8 # dataset root
train: train.txt # a directory, an image, a list e.g. [images/a, images/b], or a *.txt file
val: val.txt
names:
  0: person
(Facultatif) colors attribue à chaque classe une couleur d’affichage sous forme de chaîne "#rrggbb" entre guillemets, indexée par identifiant de classe, par exemple colors: ["#042aff", "#ff0000"]. Les modèles entraînés et exportés conservent ces couleurs pour leurs prédictions ; les classes qui n’en ont pas utilisent la palette par défaut. Un enregistrement de jeu de données NDJSON peut contenir le même champ colors.
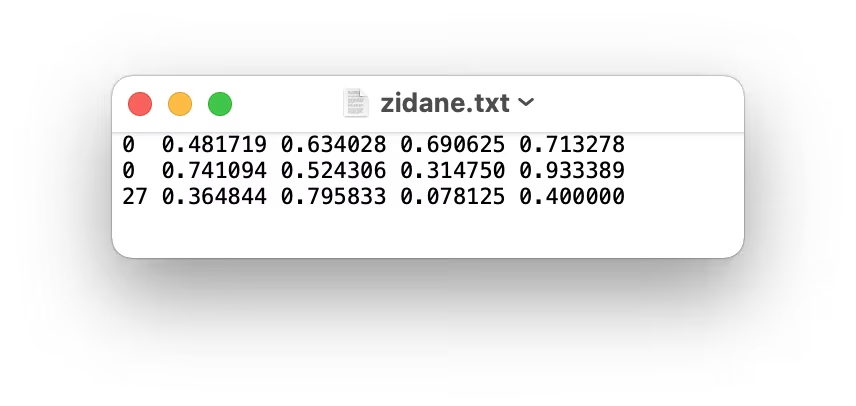
Les annotations de ce format doivent être exportées au format YOLO, avec un fichier *.txt par image. Si une image ne contient aucun objet, aucun fichier *.txt n’est nécessaire. Le fichier *.txt doit comporter une ligne par objet, au format class x_center y_center width height. Les coordonnées de la boîte englobante doivent être au format xywh normalisé (de 0 à 1). Si tes boîtes sont exprimées en pixels, tu dois diviser x_center et width par la largeur de l’image, et y_center et height par sa hauteur. Les coordonnées se rapportent à l’image telle qu’elle s’affiche dans les visionneuses, après application de son orientation EXIF, comme le fait Ultralytics pour chaque image. Les numéros de classe doivent commencer à 0.
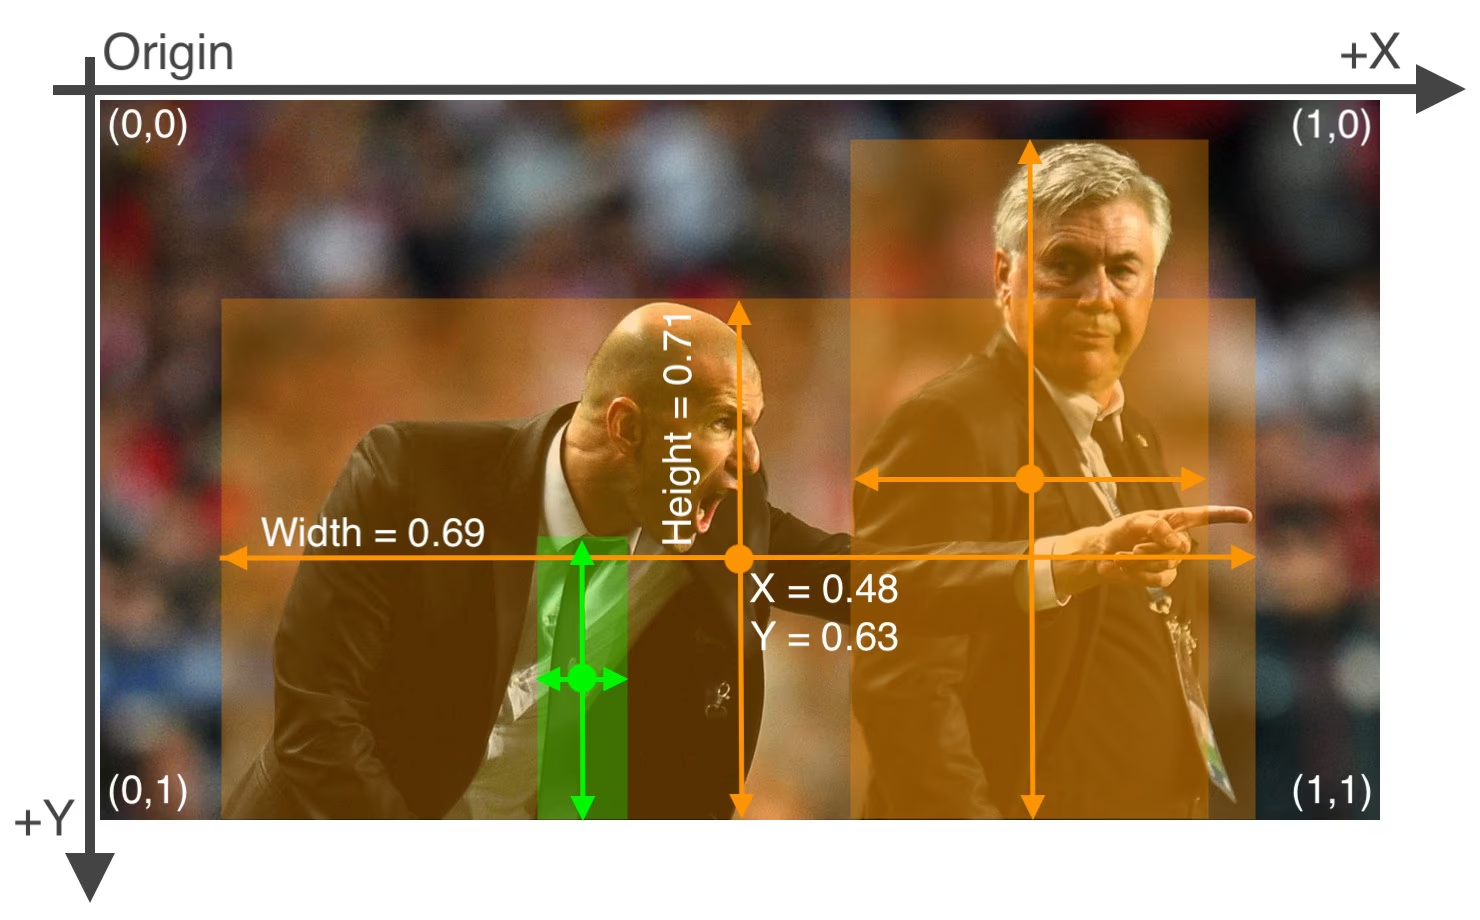
Le fichier d'étiquettes correspondant à l'image ci-dessus contient 2 personnes (classe 0) et une cravate (classe 27) :
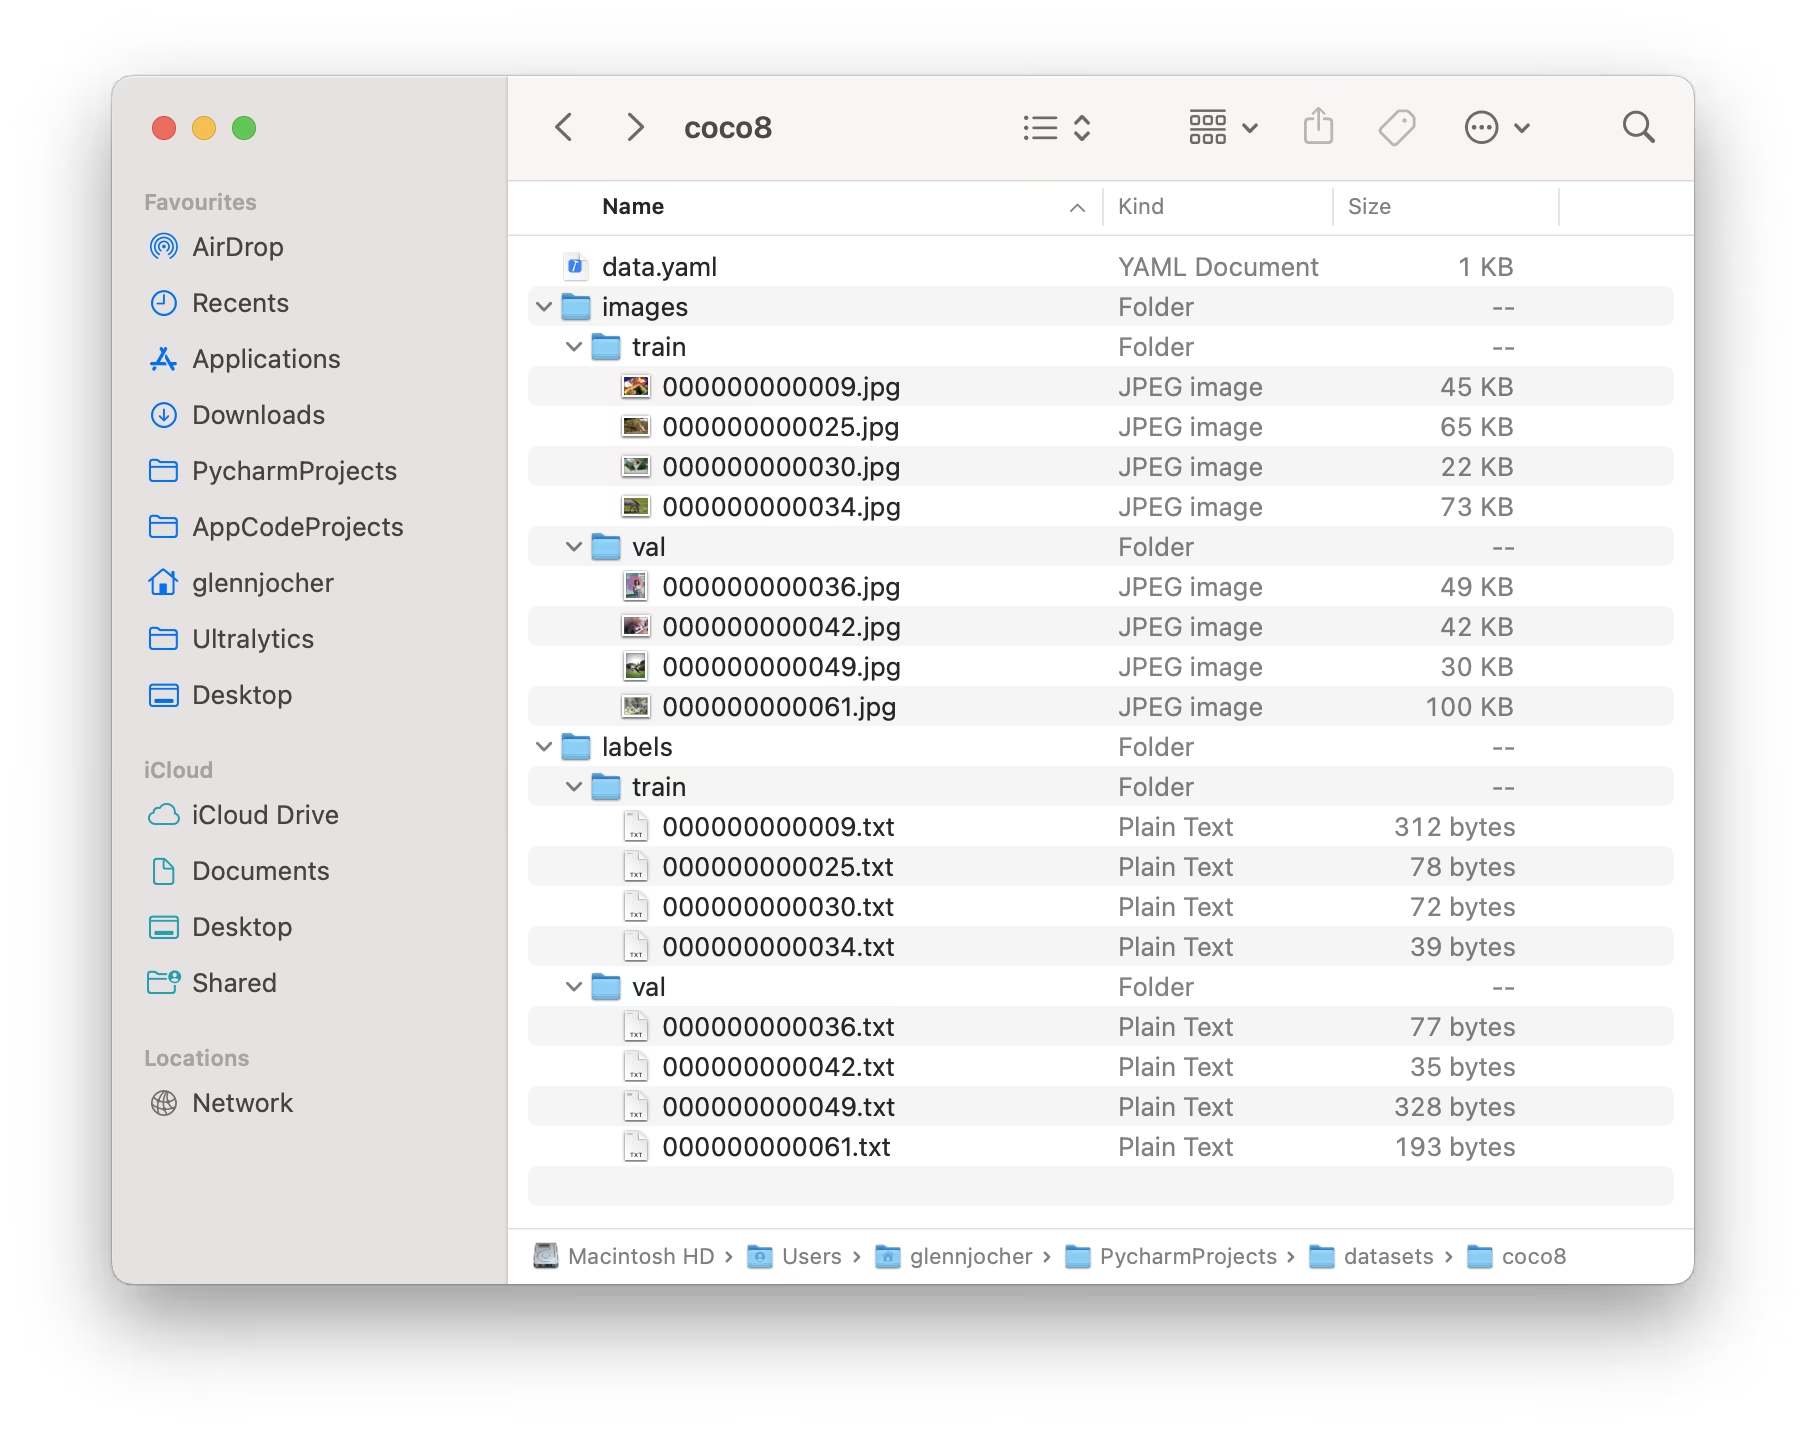
Lorsque tu utilises le format Ultralytics YOLO, organise tes images et étiquettes d'entraînement et de validation comme dans l'exemple du jeu de données COCO8 ci-dessous.
Exemple d’utilisation#
Voici comment utiliser des jeux de données au format YOLO pour entraîner ton modèle :
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)

# Entraîner le modèle
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
Format Ultralytics NDJSON#
Le format NDJSON (JSON délimité par des retours à la ligne) offre une autre façon de définir des jeux de données pour les modèles Ultralytics YOLO. Ce format stocke les métadonnées du jeu de données et les annotations dans un seul fichier, chaque ligne contenant un objet JSON distinct.
Un fichier de jeu de données NDJSON contient :
- Enregistrement du jeu de données (première ligne) : contient les métadonnées du jeu de données, notamment le type de tâche, les noms de classes et des informations générales.
- Enregistrements d'images (lignes suivantes) : contiennent les données de chaque image, notamment ses dimensions, ses annotations et ses chemins de fichiers.
{
    "type": "dataset",
    "task": "detect",
    "name": "Example",
    "description": "COCO NDJSON example dataset",
    "url": "https://platform.ultralytics.com/user/datasets/example",
    "class_names": { "0": "person", "1": "bicycle", "2": "car" },
    "bytes": 426342,
    "version": 0,
    "created_at": "2024-01-01T00:00:00Z",
    "updated_at": "2025-01-01T00:00:00Z"
}
Métadonnées personnalisées des images#
Chaque enregistrement d'image peut inclure un objet JSON metadata contenant des informations contextuelles propres à l'application, telles que les conditions de capture, les identifiants du matériel ou le statut de révision. Les valeurs imbriquées sont prises en charge. Lorsqu'elles sont importées dans Ultralytics Platform, les métadonnées sont associées à l'image et peuvent être consultées ou modifiées depuis son panneau d'informations en plein écran.
{
    "type": "image",
    "file": "airbus-wing.jpg",
    "url": "https://example.com/airbus-wing.jpg",
    "split": "train",
    "metadata": {
        "aircraft": { "family": "A350", "section": "wing" },
        "inspectionStatus": "reviewed"
    }
}
Platform limite les clés de métadonnées de premier niveau à 128 caractères, l'objet de métadonnées sérialisé de chaque image à 500 000 caractères et l'ensemble des métadonnées effectives d'une importation NDJSON à 500 000 caractères.
Exemple d’utilisation#
Pour utiliser un jeu de données NDJSON avec YOLO26, il suffit d'indiquer le chemin du fichier .ndjson :
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n.pt")

# Entraîner avec un jeu de données NDJSON
results = model.train(data="path/to/dataset.ndjson", epochs=100, imgsz=640)
Avantages du format NDJSON#
- Fichier unique : toutes les informations du jeu de données sont regroupées dans un seul fichier.
- Traitement en flux : permet de traiter de grands jeux de données ligne par ligne sans tout charger en mémoire.
- Intégration au cloud : prend en charge les URL d'images distantes pour l'entraînement dans le cloud.
- Extensible : permet d'ajouter facilement des champs de métadonnées personnalisés.
- Gestion des versions : le format à fichier unique fonctionne bien avec git et les systèmes de gestion de versions.
Jeux de données pris en charge#
Voici la liste des jeux de données pris en charge, accompagnés d'une brève description. La plupart sont également hébergés sur Ultralytics Platform, où tu peux parcourir les images et les annotations, consulter les statistiques des jeux de données et les cloner pour l'entraînement dans le cloud.
- African-wildlife : jeu de données contenant des images de la faune africaine, notamment des buffles, des éléphants, des rhinocéros et des zèbres.
- Argoverse : le jeu de données Argoverse-HD pour la détection 2D, composé de 54 446 images urbaines de conduite autonome couvrant 8 classes d'objets routiers.
- Tumeur cérébrale : un jeu de données pour détecter les tumeurs cérébrales dans des images d’IRM cérébrale, annotées avec des boîtes englobantes autour des tumeurs dans une seule classe.
- COCO : Common Objects in Context (COCO) est un vaste jeu de données pour la détection et la segmentation d’objets ainsi que le sous-titrage d’images, avec 80 catégories d’objets.
- COCO8 : un petit sous-ensemble des 8 premières images de COCO train2017, avec 4 images pour l’entraînement et 4 pour la validation, adapté aux tests rapides.
- COCO8-Grayscale : une version en niveaux de gris de COCO8, obtenue en convertissant les images RVB en niveaux de gris, utile pour évaluer des modèles à canal unique.
- COCO8-Multispectral : une version multispectrale de COCO8 à 10 canaux, créée par interpolation des longueurs d’onde RVB, utile pour évaluer des modèles sensibles aux spectres.
- COCO12-Formats : un jeu de données de test contenant 12 images couvrant 12 formats d'image pris en charge (AVIF, BMP, DNG, HEIC, JP2, JPEG, JPG, MPO, PNG, TIF, TIFF, WebP), destiné à valider les pipelines de chargement d'images.
- COCO16 : un sous-ensemble des 16 premières images de COCO train2017 (8 pour l'entraînement et 8 pour la validation), adapté aux tests rapides.
- COCO32 : un sous-ensemble des 32 premières images de COCO train2017 (16 pour l'entraînement et 16 pour la validation), adapté aux tests rapides.
- COCO64 : un sous-ensemble des 64 premières images de COCO train2017 (32 pour l'entraînement et 32 pour la validation), adapté aux tests rapides.
- COCO128 : un petit sous-ensemble des 128 premières images de COCO train2017, adapté aux tests.
- Construction-PPE : un jeu de données présentant des ouvriers sur des chantiers, avec des équipements de sécurité annotés tels que des casques, des gilets, des gants, des bottes et des lunettes de protection, ainsi que des annotations signalant l'équipement manquant, comme no_helmet et no_goggle, pour le suivi de la conformité en conditions réelles.
- Global Wheat 2020 : un jeu de données contenant des images d’épis de blé pour le Global Wheat Challenge 2020.
- HomeObjects-3K : un jeu de données d'objets domestiques d'intérieur comprenant des lits, des chaises, des téléviseurs et bien plus encore, idéal pour la domotique, la robotique, la réalité augmentée et l'analyse de l'agencement des pièces.
- KITTI : un jeu de données présentant des scènes de conduite réelles avec des données stéréo, LiDAR et GPS/IMU, utilisé ici pour des tâches de détection d'objets 2D, comme l'identification de voitures, de piétons et de cyclistes en milieu urbain, rural et autoroutier.
- LVIS : un vaste jeu de données pour la détection d’objets et la segmentation d’instances, comprenant 1 203 catégories d’objets.
- Medical-pills : jeu de données contenant des images de comprimés, annotées pour des applications telles que l'assurance qualité pharmaceutique, le tri des comprimés et la conformité réglementaire.
- Objects365 : un jeu de données de haute qualité et à grande échelle pour la détection d'objets, comprenant 365 catégories d'objets et plus de 1,7 M d'images d'entraînement.
- OpenImagesV7 : un jeu de données exhaustif de Google comprenant 1,7 million d’images d’entraînement et 42 000 images de validation.
- Roboflow 100 : un benchmark diversifié de détection d’objets comprenant 100 jeux de données couvrant sept domaines d’imagerie, pour une évaluation complète des modèles.
- Signature : un jeu de données composé d’images de divers documents avec des signatures annotées, destiné à la recherche sur la vérification de documents et la détection de fraudes.
- SKU-110K : un jeu de données consacré à la détection dense d’objets dans des environnements de vente au détail, avec plus de 11 000 images et 1,7 million de boîtes englobantes.
- TT100K : jeu de données de panneaux de signalisation Tsinghua-Tencent 100K (TT100K), comprenant 16 817 images de rues réparties en 221 catégories de panneaux pour la détection et la classification.
- Ultralytics Benchmark : une suite de benchmark maison composée de 37 jeux de données de détection sélectionnés dans les domaines médical, aérien, industriel, commercial et autres, avec un protocole fixe pour mesurer la généralisation des modèles dans le monde réel.
- VisDrone : un jeu de données contenant des données de détection d’objets et de suivi multi-objets issues d’images capturées par drone, avec plus de 10 000 images et séquences vidéo.
- VOC : le jeu de données Pascal de classes d’objets visuels (VOC) pour la détection et la segmentation d’objets, avec 20 classes d’objets et plus de 11K images.
- xView : un jeu de données pour la détection d’objets dans des images aériennes, avec 60 catégories d’objets et plus d’un million d’objets annotés.
Ajouter ton propre jeu de données#
Si tu as ton propre jeu de données et que tu souhaites l’utiliser pour entraîner des modèles de détection au format Ultralytics YOLO, vérifie qu’il respecte le format décrit plus haut dans « Format Ultralytics YOLO ». Convertis tes annotations au format requis et indique les chemins, le nombre de classes et les noms des classes dans le fichier de configuration YAML.
Porter ou convertir des formats d’étiquettes#
Convertir le format du jeu de données COCO au format YOLO#
Tu peux convertir les étiquettes du format populaire du jeu de données COCO au format YOLO à l'aide de l'extrait de code suivant :
from ultralytics.data.converter import convert_coco

convert_coco(labels_dir="path/to/coco/annotations/")
Cet outil de conversion permet de convertir le jeu de données COCO ou tout autre jeu de données au format COCO au format Ultralytics YOLO. Le processus transforme les annotations COCO au format JSON en annotations YOLO plus simples, au format texte, compatibles avec les modèles Ultralytics YOLO. Pour connaître l’ensemble du processus — y compris la correspondance des ID de classe, la structure des répertoires et les annotations de segmentation ou de pose — consulte Convertir des annotations COCO au format YOLO.
Pense à vérifier soigneusement que le jeu de données que tu veux utiliser est compatible avec ton modèle et respecte les conventions de format nécessaires. Des jeux de données correctement formatés sont essentiels pour entraîner des modèles de détection d’objets performants.
Et ensuite ?#
Une fois ton jeu de données formaté, commence à entraîner ton modèle. Tu ne sais pas quel modèle préentraîné choisir pour commencer ? Compare les options de la famille de modèles YOLO26.
FAQ#
Le format Ultralytics YOLO est une configuration structurée qui permet de définir les jeux de données de tes projets d’entraînement. Il consiste à définir les chemins d’accès aux images et aux étiquettes correspondantes pour l’entraînement, la validation et le test. Par exemple :
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8 dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco8
# Example usage: yolo train data=coco8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8.zip
Les étiquettes sont enregistrées dans des fichiers
*.txt, à raison d’un fichier par image, au formatclass x_center y_center width heightavec des coordonnées normalisées. Pour un guide détaillé, consulte l’exemple du jeu de données COCO8.Tu peux convertir un jeu de données COCO au format YOLO à l’aide des outils de conversion Ultralytics. Voici une méthode rapide :
from ultralytics.data.converter import convert_coco

convert_coco(labels_dir="path/to/coco/annotations/")
Ce code convertit tes annotations COCO au format YOLO pour que tu puisses entraîner des modèles Ultralytics YOLO à partir de celles-ci.
Ultralytics YOLO prend en charge de nombreux jeux de données, notamment :
Chaque page de jeu de données fournit des informations détaillées sur sa structure et son utilisation, adaptées à un entraînement efficace de YOLO26. Consulte la liste complète dans la section Jeux de données pris en charge.
Pour commencer à entraîner un modèle YOLO26, vérifie que ton jeu de données est correctement formaté et que les chemins sont définis dans un fichier YAML. Utilise le script suivant pour commencer l’entraînement :
Exemplefrom ultralytics import YOLO model = YOLO("yolo26n.pt") # Charger un modèle préentraîné results = model.train(data="path/to/your_dataset.yaml", epochs=100, imgsz=640)Ultralytics propose de nombreux exemples et guides pratiques pour utiliser YOLO dans diverses applications. Consulte le blog Ultralytics pour découvrir des études de cas, des tutoriels détaillés et des témoignages de la communauté sur la détection d'objets, la segmentation et bien plus encore. Pour des exemples précis, consulte la page du mode Predict dans la documentation.


Commentaires54
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
zcoolster11
Python Head Bop
 Paula DerrengerUltralytics
@zcoolster11, could you clarify what you mean by “Python Head Bop” and what you’d like to do with Ultralytics YOLO? Feel free to drop your dataset or Python questions here in the discussion so the Ultralytics team can help.
 Murat Raimbekov
hey @orz-serein, short answer: no, you don't need empty label files for background images - just leave the
.txtout.i verified this empirically on the current main branch. setup: 5 images, 2 with real labels, 1 with an empty
.txtfile, 2 without any.txtfile at all. building aYOLODatasetover them gives:Scanning /tmp/bgtest_full/labels... 3 images, 3 backgrounds, 0 corrupt: 100% 5/5all 5 images are kept. the 3 without labels (the empty-
.txtone and the two with no.txtat all) all end up with the same(0, 5)labels array - they are treated identically as background images.so both options work:
- no
.txtfile: counted as "missing" (nm=1), no labels -> background - empty
.txtfile: counted as "empty" (ne=1), no labels -> background
both end up in the same
backgrounds = nm + nebucket inultralytics/data/dataset.py.this is also stated in the detection dataset docs:
If there are no objects in an image, no
*.txtfile is required.how many background images: the yolov5 training tips recommend 0-10% of the dataset as background images to reduce false positives (coco has about 1% background).
hope this helps!
- no
 serein
Hello, I would like to ask a question. During the stage of preparing the training dataset, if some images do not have the target to be detected, do I need to add corresponding empty label files in the label folder?
Fatima-khanjar
Hello, I hope this message finds you well.
I have a question regarding fine-tuning a pre-trained YOLO model (e.g., trained on the COCO dataset) on my custom dataset. My dataset includes both new classes (not present in COCO) and the same existing classes (e.g., toothbrush, car), but with different layouts. Specifically, I would like to add my new classes starting from index 80, while still leveraging the pre-trained weights for the common classes, which are the same but with different layouts.
Is it possible to use the pre-trained weights for the common classes and only train the model on the new classes, while ensuring that the pre-trained knowledge for the common classes is preserved? If so, could you please guide me on how to proceed?
Thank you for your time and assistance. best regards,
bimal-gajera
Hello, I'm working on multiple dataset formats for object detection. For the YOLO dataset format, is there any way I can rename the labels directory and put it in yaml file? Something like this:
path: path_to_root_directory
train: train\images
val: val\images
test: test\images

labels_dir: yolo

nc: 1
names: ['object']
yolo directory has yolo annotations (*.txt files), and it's inside respective train, val and test directory.
 Glenn JocherUltralytics(modifié)
@bimal-gajera currently, the
labels_dirkey is not supported in the YAML file. Ultralytics finds label files by replacing the last/images/directory in each image path with/labels/, so each split needs siblingimages/andlabels/directories (for exampletrain/imagesandtrain/labels). For more details, refer to the Object Detection Datasets Overview.1
nitya-pandey-astro
Hello Team, I am using YOLO for detecting trails of slow-moving astronomical objects in my images. While the model detects the trails, the bounding boxes predicted around the objects are not tight enough. The boxes tend to be too loose or not well-shaped to fit the elongated, irregular trails, resulting in inaccurate object localization. I suspect, YOLO's standard rectangular bounding box not being well-suited for the elongated, curving shapes of the trails. Could you provide guidance on how to improve bounding box accuracy for this specific use case?
- Glenn JocherUltralytics(modifié)
@astronitya thank you for your question! For detecting elongated or irregular trails, consider using Oriented Bounding Boxes (OBB), which may better fit your objects' shapes compared to standard rectangular boxes. You can format your dataset in the YOLO OBB format and train a YOLO26 OBB model. Please refer to the Oriented Bounding Box (OBB) Datasets Overview for details on dataset formatting and training. Let me know if you need further clarification!
@glenn-jocher Thankyou very much for the prompt response. I am going to work on your suggestions.
Yuxuan1998
Hi team, I am a little bit confused with the dataset folder structure. For most dataset I used, it strunctured in the way that each of
train/andval/folders containsimages/andlabels/folders. However, the COCO8 dataset example shows the opposite way, each ofimages/andlabels/folder containstest/andval/folders. Does the folder structure matter here? Thanks in advance- Glenn JocherUltralytics(modifié)
@Yuxuan1998 both layouts work, as long as each image has a sibling
labelsdirectory: Ultralytics finds the label for an image by replacing the last/images/in its path with/labels/(sotrain/images/img.jpgusestrain/labels/img.txt, andimages/train/img.jpguseslabels/train/img.txt). Set the paths in your dataset's YAML file to the image directories. For details, refer to the Object Detection Datasets Overview. Let us know if you need further clarification!1
milanaveed
Hello, can you please fix the broken images on this page? Can't see the label file example.
wgdcxy
Hello, my label and image files are stored according to the requirements, but they are still not recognized, and the following is an error message Thank you in advance
WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1138.41it/s] train: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. train: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1617.94it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train3\labels.jpg...
- Glenn JocherUltralytics
It seems like your dataset labels are not being recognized. Please ensure your label files are in the correct YOLO format and that the directory is writable. For detailed guidance, visit the dataset formatting section at https://docs.ultralytics.com/datasets/detect/.
Hi, but my file path is very accurate, and I checked it N times, so is there any otherreason? Thank you
- Glenn JocherUltralytics
@wgdcxy please ensure your label files are in the correct YOLO format, with one
.txtfile per image containing normalized coordinates. Also, verify that the directory permissions allow writing. For more details, refer to the dataset formatting guide linked earlier. Hello, I'm a student whose English is not particularly good, so some places may not be clear, and secondly, this is not an error but a warning.I don't know why it's the background that reads, not the images. The warnings are as follows: val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%| 30/30 [00:00<00:00, 495.76it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train4\labels.jpg...
Then this warning tells me that the cache file is missing, and I don't know why I can't generate a cache file for the file I created, so I'm here to ask you guys. Below is my own yaml file: # Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..] path: ../cs # dataset root dir train: images/ttb # train images (relative to 'path') 128 images val: images/ttj # val images (relative to 'path') 128 images test: # test images (optional) # Classes names : 0 : wf
Below is my label file: 0 0.6799428104575164 0.5005859375 0.6844771241830065 0.500537109375 0.6845996732026144 0.497265625 0.6802696078431373 0.497119140625 0 0.6803104575163399 0.4935546875 0.6848039215686275 0.493505859375 0.6847630718954248 0.497119140625 0.6802696078431373 0.49697265625 0 0.6802696078431373 0.49013671875 0.6849673202614379 0.490185546875 0.6849264705882353 0.49345703125 0.6803513071895425 0.493359375 0 0.6805555555555556 0.48662109375 0.6850898692810458 0.486767578125 0.6850490196078431 0.490234375 0.6803513071895425 0.490234375 0 0.6808415032679739 0.483447265625 0.6852941176470588 0.48349609375 0.6852124183006536 0.486767578125 0.6806781045751634 0.486669921875 0 0.6806372549019607 0.47998046875 0.6854166666666666 0.47998046875 0.6853349673202613 0.48349609375 0.6808415032679738 0.48359375
Finally, this yolo can be run, but I don't know why the result is 0. Here's how it works: Transferred 381/417 items from pretrained weights 195/200 8.73G 0 0 nan 0 0 2464: 100%|██████████| 8/8 [01:37<00:00, 12.13s/it] Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95): 100%|[00:31<00:00, 7.91s/it] all 30 0 0 0 0 0 0 0 0 0 Finally, thank you for explaining it to me
By the way, the size of my picture is 2448x2048, so the imgsz entered is 2448, and your code changed the size of my picture to 2464, is it related to this. imgsz=[2448] must be multiple of max stride 32, updating to [2464]
I apologize, I found a small mistake of mine. I wrote the file name as "labels" instead of "lables" which I intended to write.Please forgive my carelessness.After all, who doesn't make mistakes. I'll come back to you next time I have a problem. Thank you for your help.
Transferred 417/417 items from pretrained weights Freezing layer 'model.22.dfl.conv.weight' AMP: running Automatic Mixed Precision (AMP) checks with YOLOv8n... AMP: checks passed ✅ WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache... 30 images, 0 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<?, ?it/s] Hello, here I am again, with a new problem, how to solve this problem about image size?Ask for answers, thank you
- Glenn JocherUltralytics
@wgdcxy to address the image size issue, ensure your
imgszis a multiple of 32, as required by the model's architecture. This adjustment helps maintain compatibility with the model's stride. If you have further questions, feel free to ask! WARNING ⚠️ NMS time limit 0.900s exceeded. Hello, my teacher who has never met, what should I do with this warning?
- Glenn JocherUltralytics(modifié)
@wgdcxy the "NMS time limit exceeded" warning is not controlled by an
nmsargument. It appears when too many candidate boxes need to be processed within the time limit, which is common early in training when validation uses a low confidence threshold. It usually stops as the model trains, and you can reduce it by raisingconfor loweringmax_detduring validation. If you have further questions, feel free to ask! Hello, I'm here again. The issue this time is still the same warning. I adjusted the max_time_img to 0.1 in ops. py, but I don't feel it's right. So I came to ask for your help because it still shows this warning. I hope you can tell me where to make the adjustment. Thank you again. WARNING ⚠️ NMS time limit 0.900s exceeded
How can these values be improved? We can only continue training or increase the training dataset. Epoch GPU_mem box_loss seg_loss cls_loss dfl_loss Instances Size 11/500 11G nan 6.21 nan nan 132 2464: 100%|██████████| 8/8 [01:56<00:00, 14.59s/it] Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95): 100%|██████████| 4/4 [00:54<00:00, 13.56s/it] all 30 664 0 0 0 0 0 0 0 0
- Glenn JocherUltralytics
To improve your model's performance, consider increasing the dataset size, enhancing data quality, or adjusting hyperparameters. If issues persist, reviewing the dataset for label accuracy and distribution might help.
WARNING ⚠️ imgsz=[2448] must be multiple of max stride 32, updating to [2464] train: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttb... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1138.41it/s] train: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. train: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttb.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: Scanning D:\Textile_testing\ultralytics-seg\cs\labels\ttj... 0 images, 30 backgrounds, 0 corrupt: 100%|██████████| 30/30 [00:00<00:00, 1617.94it/s] val: WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. val: WARNING ⚠️ Cache directory D:\Textile_testing\ultralytics-seg\cs\labels is not writeable, cache not saved. WARNING ⚠️ No labels found in D:\Textile_testing\ultralytics-seg\cs\labels\ttj.cache, training may not work correctly. See https://docs.ultralytics.com/datasets/detect for dataset formatting guidance. Plotting labels to runs\segment\train3\labels.jpg...
这个问题该如何解决?
- Glenn JocherUltralytics
It looks like your dataset labels are missing or not formatted correctly. Please ensure your labels are in the YOLO format and check the directory permissions. For detailed guidance, visit the dataset formatting section at https://docs.ultralytics.com/datasets/detect/.