Dataset di tumori cerebrali
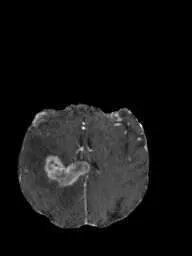
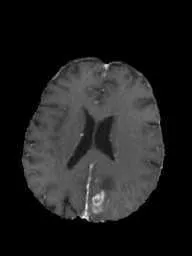
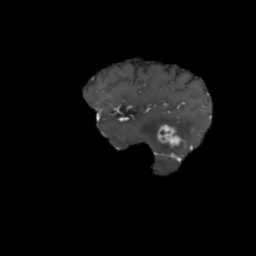

Il dataset Ultralytics Brain Tumor è un dataset di rilevamento di oggetti composto da 1.115 immagini di risonanza magnetica cerebrale (994 per l'addestramento e 121 per la convalida), con 1.180 riquadri delimitatori in un'unica classe, tumor. Ogni immagine contiene da 1 a 3 riquadri che indicano i tumori. La suddivisione di convalida contiene le immagini di 25 pazienti identificati e nessun paziente identificato compare in entrambe le suddivisioni. Con i suoi 4,06 MB, è un dataset compatto per apprendere e prototipare modelli di visione artificiale per applicazioni sanitarie, ma non è una risorsa diagnostica convalidata clinicamente.
Guarda: Rilevamento di tumori cerebrali con la piattaforma Ultralytics e Ultralytics YOLO26 | Rilevamento di oggetti 🚀
Struttura del dataset#
Il dataset Ultralytics Brain Tumor contiene 1.115 immagini di risonanza magnetica cerebrale e 1.180 riquadri delimitatori, suddivisi in due parti secondo la configurazione brain-tumor.yaml:
| Subset | Immagini | Riquadri delimitatori | Pazienti |
|---|---|---|---|
| Addestra | 994 | 1,057 | 95 con un ID, più 541 immagini senza ID paziente |
| Validazione | 121 | 123 | 25 |
| Totale | 1,115 | 1,180 |
Ogni immagine contiene da 1 a 3 riquadri delimitatori dell'unica classe tumor e le dimensioni delle immagini variano da 192x256 a 512x512 pixel. La configurazione non definisce una suddivisione separata per il test.
La suddivisione di convalida è stata creata in base ai pazienti. Alcuni nomi di file iniziano con un ID paziente di cinque cifre: per esempio, 00097_77.jpg appartiene al paziente 00097. Le immagini associate agli ID di 25 di questi pazienti costituiscono la suddivisione di convalida, mentre le immagini degli altri 95 pazienti identificati sono nella suddivisione di addestramento; nessun paziente identificato compare quindi in entrambe le suddivisioni. Le restanti 541 immagini non hanno un ID paziente nel nome del file e sono tutte nella suddivisione di addestramento.
Il dataset viene scaricato automaticamente (4,06 MB) dagli asset di Ultralytics su GitHub al primo addestramento, quindi non è necessario scaricarlo o prepararlo manualmente.
A novembre 2026, il dataset è passato a un'unica classe tumor. Se la cartella locale brain-tumor/images/train contiene 893 immagini invece di 994, elimina la cartella brain-tumor nella directory dei dataset (vedi datasets_dir in yolo settings) e aggiorna il pacchetto con pip install -U ultralytics. La versione corrente verrà scaricata al successivo avvio dell'addestramento.
Esplora Brain Tumor su Ultralytics Platform per sfogliare le immagini con le relative sovrapposizioni delle annotazioni, visualizzare la distribuzione delle classi e le mappe di calore dei riquadri di delimitazione nella scheda Grafici e clonarlo per addestrare il tuo modello nel cloud.
Applicazioni#
I modelli di rilevamento dei tumori cerebrali individuano i tumori nelle immagini di risonanza magnetica cerebrale. Con 1.115 immagini e un download di 4,06 MB, il dataset Ultralytics Brain Tumor è adatto a:
- Apprendere il flusso di lavoro: eseguire l'intero ciclo di addestramento, convalida e previsione su immagini mediche usando un dataset di piccole dimensioni.
- Prototipazione: creare e testare una pipeline di localizzazione dei tumori prima di passare a un dataset clinico più ampio.
- Valutazione su pazienti identificati: misurare il rilevamento sui 25 pazienti di convalida. Poiché 541 immagini di addestramento non riportano l'ID del paziente, non è possibile escludere che si sovrappongano a questi pazienti.
- Ricerca e formazione: confrontare modelli di rilevamento e studiare l'analisi delle immagini mediche e l'IA in radiologia.
I modelli addestrati su questo dataset sono destinati alla ricerca e alla formazione e non sono convalidati per la diagnosi clinica.
YAML del dataset#
La configurazione brain-tumor.yaml definisce il percorso del dataset, le cartelle delle immagini di addestramento e di convalida, l'unica classe tumor e l'URL di download. Le etichette usano il formato Ultralytics YOLO.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Brain-tumor dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor
# Example usage: yolo train data=brain-tumor.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── brain-tumor ← downloads here (4.06 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: brain-tumor # dataset root dir
train: images/train # train images (relative to 'path') 994 images
val: images/val # val images (relative to 'path') 121 images

# Classes
names:
  0: tumor

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipUtilizzo#
Per addestrare un modello YOLO26n sul dataset dei tumori cerebrali per 100 epoche con una dimensione delle immagini di 640, usa gli snippet di codice seguenti.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Carica un modello
model = YOLO("path/to/best.pt") # carica un modello ottimizzato sul dataset brain-tumor
# Inferenza con il modello
results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Immagini di esempio e annotazioni#
Di seguito sono riportate alcune immagini di esempio del dataset Ultralytics Brain Tumor con le relative annotazioni:
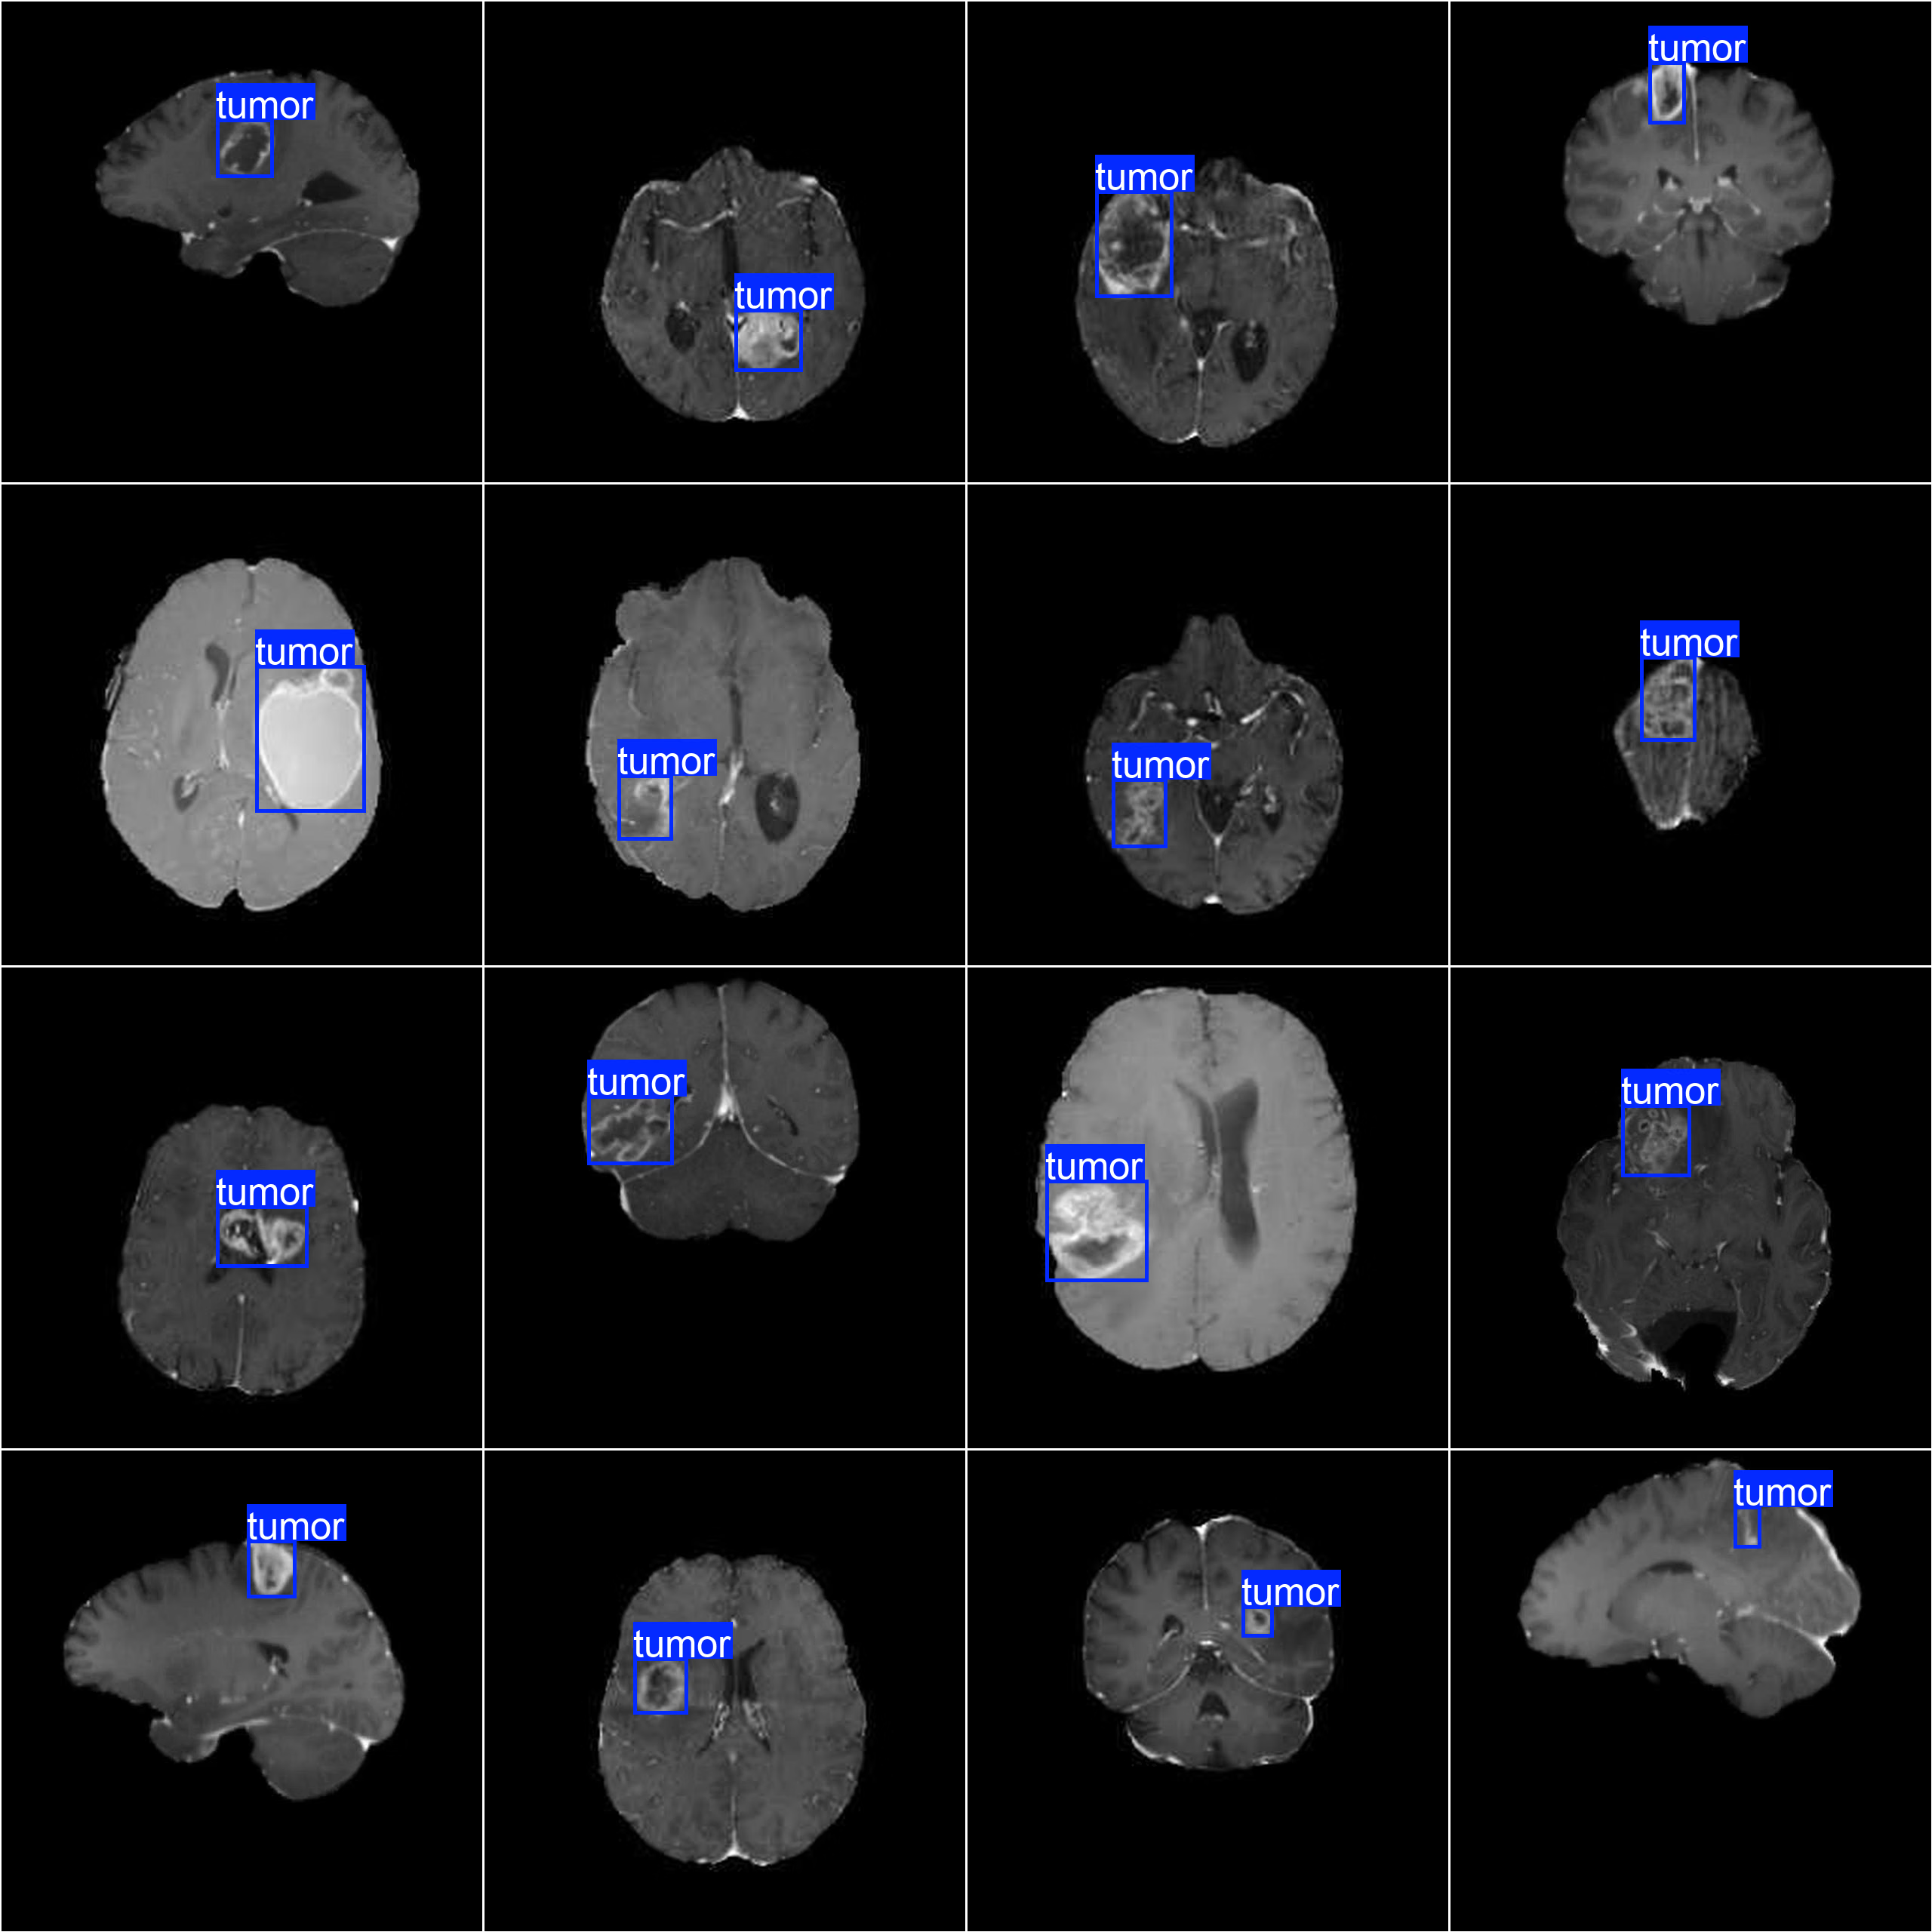
- Immagini annotate: la griglia mostra 16 immagini di addestramento, ciascuna con un riquadro delimitatore
tumorintorno alla lesione. Le dimensioni, le forme e le posizioni dei tumori variano nel dataset, aiutando un modello di rilevamento a generalizzare.
Citazioni e ringraziamenti#
Il dataset è disponibile con la licenza AGPL-3.0.
Se usi il dataset dei tumori cerebrali nel tuo lavoro di ricerca o sviluppo, citane la fonte:
@dataset{Ultralytics_Brain_Tumor_Dataset_2023,
    author = {Ultralytics},
    title = {Brain Tumor Detection Dataset},
    year = {2023},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/brain-tumor}
}
Domande frequenti#
Il dataset Ultralytics Brain Tumor contiene 1.115 immagini di risonanza magnetica cerebrale e 1 classe,
tumor: 994 immagini di addestramento con 1.057 riquadri delimitatori e 121 immagini di convalida con 123 riquadri delimitatori. Ogni immagine contiene da 1 a 3 riquadri e non è prevista una suddivisione separata per il test. Consulta Struttura del dataset per i dettagli sulle suddivisioni.Il dataset Ultralytics Brain Tumor contiene immagini di risonanza magnetica cerebrale e nessuna TAC. Le dimensioni delle immagini variano da 192x256 a 512x512 pixel e ogni immagine è etichettata con da 1 a 3 riquadri delimitatori
tumornel formato Ultralytics YOLO.No, il dataset Ultralytics Brain Tumor non contiene immagini senza tumori né una classe negativa. Tutte le 1.115 immagini presentano da 1 a 3 riquadri delimitatori
tumor, quindi un modello addestrato su questo dataset impara dove si trova un tumore, non se una scansione è sana. I modelli addestrati su questo dataset sono destinati alla ricerca e alla formazione, non alla diagnosi clinica.Il dataset Ultralytics Brain Tumor è suddiviso in base ai pazienti: le 121 immagini di convalida riportano gli ID di 25 pazienti e nessun paziente identificato compare in entrambe le suddivisioni. I pazienti sono identificati dal prefisso di cinque cifre del nome del file, come
00097_77.jpg. L'insieme di addestramento contiene gli altri 95 pazienti identificati, oltre a 541 immagini i cui nomi di file non riportano alcun ID paziente.Il dataset Ultralytics Brain Tumor (4,06 MB) viene scaricato automaticamente dagli asset di Ultralytics su GitHub al primo addestramento con
data="brain-tumor.yaml", quindi non è necessario scaricarlo manualmente. Se sul disco è già presente una copia precedente con 893 immagini di addestramento, elimina la cartellabrain-tumore aggiorna prima il pacchettoultralytics, così verrà scaricata la versione corrente con un'unica classe. Per un altro piccolo dataset di diagnostica per immagini, consulta il dataset di rilevamento Medical Pills.Per addestrare YOLO26 sul dataset Ultralytics Brain Tumor, passa
data="brain-tumor.yaml"al comando di addestramento; il dataset verrà scaricato automaticamente. Gli esempi seguenti addestrano YOLO26n per 100 epoche con una dimensione delle immagini di 640:Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)Per un elenco dettagliato degli argomenti disponibili, consulta la pagina Addestramento.
Per eseguire inferenze con un modello YOLO26 ottimizzato sul dataset Ultralytics Brain Tumor, carica i pesi
best.pte chiama predict su un'immagine di risonanza magnetica cerebrale. Ogni risultato contiene i riquadri delimitatoritumorcon i punteggi di confidenza:Esempio di inferenzafrom ultralytics import YOLO # Carica un modello model = YOLO("path/to/best.pt") # carica un modello ottimizzato sul dataset brain-tumor # Inferenza con il modello results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Il dataset Ultralytics Brain Tumor è stato creato da Ultralytics ed è distribuito con la licenza AGPL-3.0.


Commenti11
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
ZoltinZyc
how can i download this datasett??
1 Paula DerrengerUltralytics(modificato)
Hey there! 😊 The easiest way is to train with
data=brain-tumor.yaml, which downloads the dataset automatically the first time. To download it manually, use:wget https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zip unzip brain-tumor.zip -d path/to/destinationReplace
path/to/destinationwith the directory where you'd like the dataset stored. Once you have the dataset, you're all set to start training or inferencing with YOLO models on brain tumor images!Should you need further guidance, feel free to ask. Happy coding! 🚀
G-qingqian
Thank you for your reply. I noticed that in the original dataset, the images in the train folder do have ID prefixes, but the images in the val folder are all prefixed with val1_, making it impossible to distinguish which patient the data belongs to. Therefore, I cannot redivide the dataset. Could you please provide data with complete identifiers? ---- Replied Message ---- FromGlenn @.>Date1/18/2026 @.>@.>, @.>SubjectRe: [ultralytics/ultralytics] zh/datasets/detect/brain-tumor/ (Discussion #9988) The packaged brain-tumor dataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to *.txt image lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.
my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
— Reply to this email directly, view it on GitHub, or unsubscribe. You are receiving this because you commented.Message ID: @.***>
 Glenn JocherUltralytics
The packaged
brain-tumorzip only includes image-level labels with anonymized filenames (no patient IDs/metadata), so we can’t provide “complete identifiers” or guarantee a patient-disjoint re-split; for patient-wise splitting you’ll need to rebuild from a source that includes patient IDs (e.g., your DICOM/NIfTI originals) and then generatetrain.txt/val.txt, and if you just need stronger evaluation without IDs you can use our K-Fold Cross Validation guide—please keep follow-ups here in the GitHub discussion (we can’t provide support over email/DM).
Can your dataset ensure that the data are independently and identically distributed by patient? That is, there will be no data from the same patient in both the training set and the validation set.
- Glenn JocherUltralytics
The packaged
brain-tumordataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to*.txtimage lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.# my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
pizzas17
How could I download this dataset on COCO format or how could I convert it? (Since I wish to have an EDA on it
xySun17
How can i train the yoloV8 using this dataset without loading the pre-trained weights?
- Paula DerrengerUltralytics(modificato)
@xySun17 hello!
To train YOLO26 without loading the pre-trained weights, you can initialize the model from scratch by specifying the model architecture file (e.g.,
yolo26n.yaml) instead of the pre-trained weights file. Here’s how you can do it:Python
from ultralytics import YOLO

# Load a model architecture without pre-trained weights
model = YOLO("yolo26n.yaml")  # build a new model from YAML

# Train the model
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)
CLI
# Train from scratch using the model architecture file
yolo detect train data=brain-tumor.yaml model=yolo26n.yaml epochs=100 imgsz=640
This approach ensures that the model starts training with random weights rather than pre-trained ones. If you encounter any issues, please ensure you are using the latest version of the Ultralytics package and provide a minimum reproducible example if the problem persists. You can find more details on creating a reproducible example here.
Feel free to reach out if you have any further questions. Happy training! 🚀
1 Thank you!! However, there is another problem, that is, why it says the path of dataset is not found? I already downloaded the dataset files and changed the path in "brain-tumor.yaml" file.
The threw error was follows: "Dataset 'brain-tumor.yaml' images not found ⚠️, missing path '/valid/images' Note dataset download directory is '/home/ros/datasets'. You can update this in '/home/ros/.config/Ultralytics/settings.yaml'"
- Paula DerrengerUltralytics(modificato)
Hello @xySun17,
Thank you for reaching out! It looks like the issue might be related to the dataset path configuration in your
brain-tumor.yamlfile. Here are a few steps to troubleshoot and resolve this:-
Verify Dataset Path: Ensure that the paths specified in your
brain-tumor.yamlfile correctly point to the locations of your dataset images. For example:path: /home/ros/datasets/brain-tumor train: images/train val: images/val -
Check Directory Structure: Confirm that the directory structure matches what is specified in the YAML file. The
images/trainandimages/valdirectories should exist within/home/ros/datasets/brain-tumor. -
Update Configuration: If the dataset is located in a different directory, update the
pathin the YAML file accordingly. For instance, if your dataset is in/home/ros/my-datasets/brain-tumor, update thepathto:path: /home/ros/my-datasets/brain-tumor -
Reproducible Example: If the issue persists, providing a minimum reproducible example can greatly help in diagnosing the problem. You can find guidance on creating a reproducible example here.
-
Latest Version: Ensure you are using the latest version of the Ultralytics package. You can update it using:
pip install --upgrade ultralytics
Here’s an example of how your
brain-tumor.yamlshould look:# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license # Brain-tumor dataset by Ultralytics # Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor/ # Example usage: yolo train data=brain-tumor.yaml path: /home/ros/datasets/brain-tumor # dataset root dir train: images/train # train images (relative to 'path') val: images/val # val images (relative to 'path') # Classes names: 0: negative 1: positive # Download script/URL (optional) download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipIf you follow these steps and still encounter issues, please share more details or any error messages you receive. This will help us assist you better.
Best regards and happy coding! 🚀
-