Dataset COCO8-Seg#
Introduzione#
COCO8-Seg di Ultralytics è un dataset di segmentazione delle istanze piccolo ma versatile, composto dalle prime 8 immagini del set COCO train 2017: 4 per l'addestramento e 4 per la validazione. Questo dataset è ideale per testare e correggere i modelli di segmentazione o per sperimentare nuovi approcci alla segmentazione. Con 8 immagini è abbastanza piccolo da poter essere gestito facilmente, ma abbastanza vario da consentire di verificare la presenza di errori nelle pipeline di addestramento e fungere da controllo preliminare prima di addestrare dataset più grandi.
Struttura del dataset#
- Immagini: 8 in totale (4 train / 4 val).
- Classi: 80 categorie COCO.
- Etichette: poligoni in formato YOLO salvati in
labels/{train,val}, abbinati a ogni file immagine. - Dimensione del download: ~1 MB.
Esplora COCO8-Seg su Ultralytics Platform per sfogliare tutte le immagini con le relative maschere poligonali, visualizzare la distribuzione delle classi e le mappe di calore delle annotazioni nella scheda Grafici e clonare il dataset per addestrare il tuo modello nel cloud.
YAML del dataset#
Un file YAML viene usato per definire la configurazione del dataset. Contiene informazioni sui percorsi, sulle classi e su altri aspetti rilevanti del dataset. Per il dataset COCO8-Seg, il file coco8-seg.yaml è gestito in https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco8-seg.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8-seg dataset (first 8 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/coco8-seg
# Example usage: yolo train data=coco8-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8-seg ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8-seg # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8-seg.zipUtilizzo#
Per addestrare un modello YOLO26n-seg sul dataset COCO8-Seg per 100 epoche con una dimensione delle immagini di 640, puoi usare i seguenti frammenti di codice. Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-seg.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="coco8-seg.yaml", epochs=100, imgsz=640)
Immagini di esempio e annotazioni#
Ecco alcuni esempi di immagini del dataset COCO8-Seg e delle relative annotazioni:
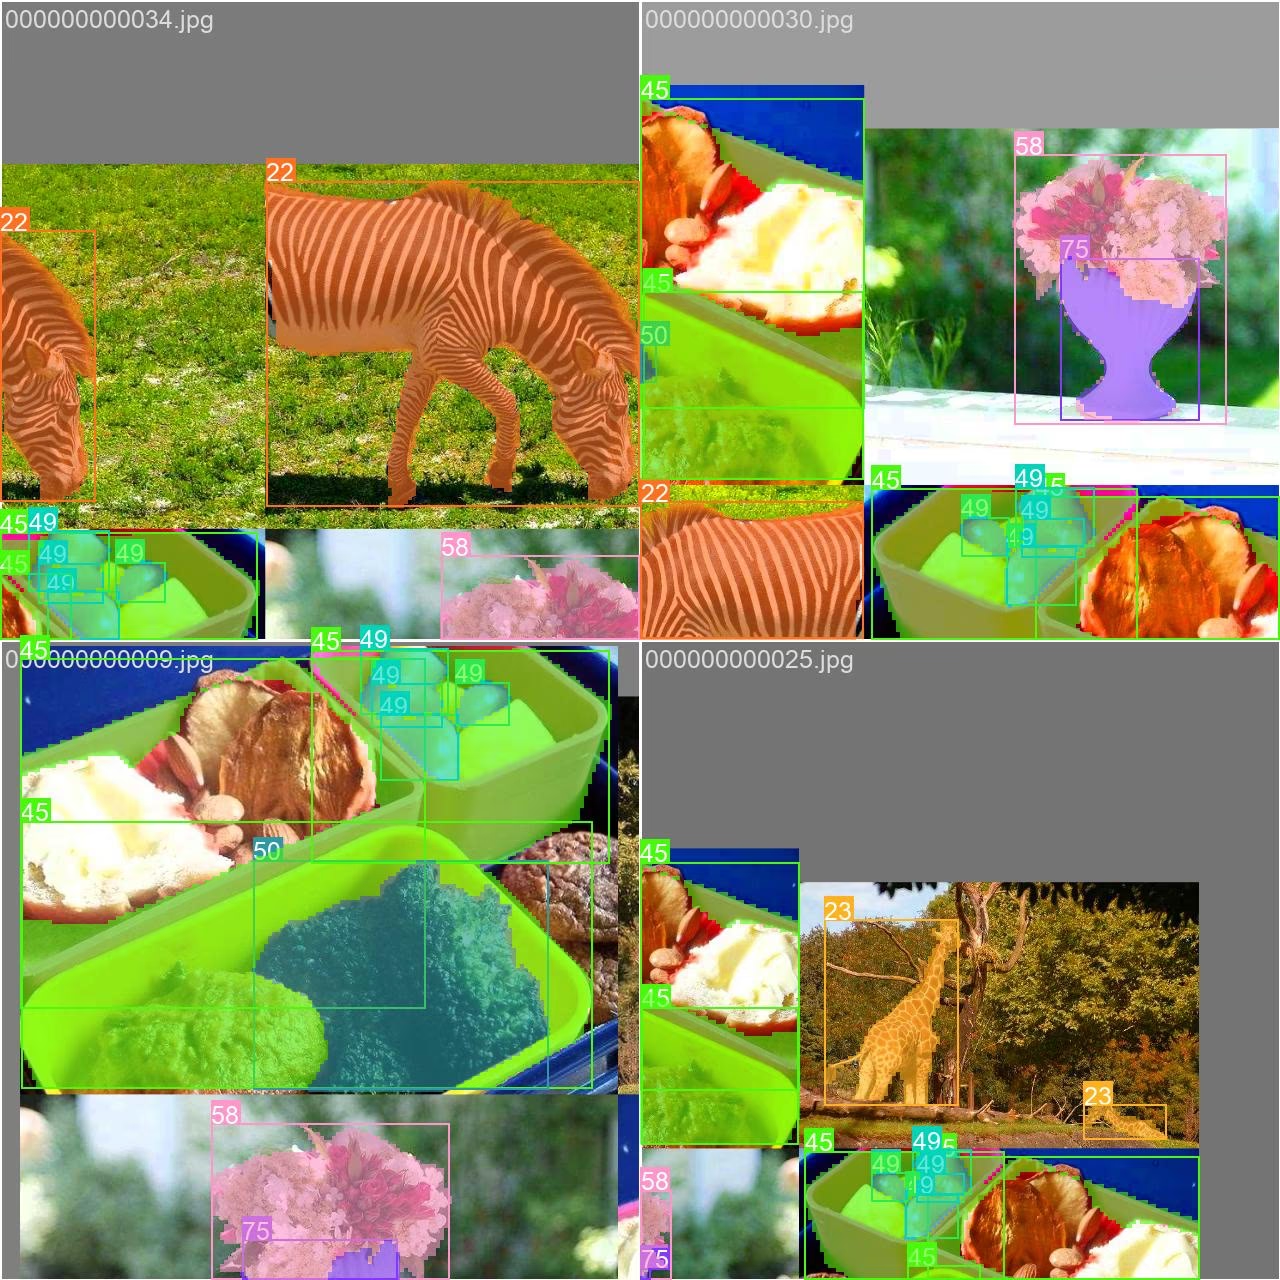
- Immagine a mosaico: questa immagine mostra un batch di addestramento composto da immagini del dataset unite in un mosaico. La creazione di mosaici è una tecnica utilizzata durante l'addestramento che combina più immagini in una sola per aumentare la varietà di oggetti e scene in ogni batch di addestramento. Questo aiuta a migliorare la capacità del modello di generalizzare a oggetti di dimensioni e proporzioni diverse e a contesti differenti.
Citazioni e ringraziamenti#
Se utilizzi il dataset COCO nelle tue attività di ricerca o sviluppo, cita il seguente articolo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Desideriamo ringraziare il Consorzio COCO per aver creato e mantenuto questa preziosa risorsa per la comunità della visione artificiale. Per maggiori informazioni sul dataset COCO e sui suoi creatori, visita il sito web del dataset COCO.
Domande frequenti#
Il dataset COCO8-Seg è un dataset compatto di segmentazione delle istanze di Ultralytics, composto dalle prime 8 immagini del set COCO train 2017 (4 per l'addestramento e 4 per la validazione). È pensato per testare e correggere i modelli di segmentazione o sperimentare nuovi metodi di segmentazione. È particolarmente utile con YOLO26 di Ultralytics per iterare rapidamente e verificare la presenza di errori nella pipeline prima di passare a dataset più grandi. Per informazioni dettagliate sull'uso, consulta la pagina Addestramento del modello.
Per addestrare un modello YOLO26n-seg sul dataset COCO8-Seg per 100 epoche con una dimensione delle immagini di 640, puoi usare comandi Python o CLI. Ecco un breve esempio:
Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n-seg.pt") # Carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="coco8-seg.yaml", epochs=100, imgsz=640)Per una spiegazione approfondita degli argomenti e delle opzioni di configurazione disponibili, consulta la documentazione Addestramento.
Poiché il download e il ciclo di addestramento/validazione sono molto più ridotti rispetto a COCO completo, COCO8-Seg ti consente di eseguire un ciclo di addestramento e validazione per individuare errori nella pipeline — un caricatore di dati non funzionante, una funzione di perdita configurata male o un'augmentazione inadeguata — prima di passare a un dataset più grande. Scopri di più sui formati dei dataset supportati nella guida Ultralytics ai dataset di segmentazione.
Il file di configurazione YAML per il dataset COCO8-Seg è disponibile nel repository Ultralytics. Puoi accedere direttamente al file in https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco8-seg.yaml. Il file YAML include informazioni essenziali sui percorsi del dataset, sulle classi e sulle impostazioni di configurazione necessarie per addestrare e validare il modello.
Per dimensioni, COCO8-Seg (8 immagini) è più piccolo di COCO128-Seg (128 immagini) e del dataset COCO-Seg completo (118.287 immagini di addestramento):
- COCO8-Seg: 8 immagini (4 train, 4 val) — il controllo preliminare più rapido, ideale per CI e debug veloce.
- COCO128-Seg: 128 immagini — un equilibrio tra dimensioni e varietà, con train e val che condividono la stessa directory.
- COCO-Seg completo: 118.287 immagini di addestramento — completo ma dispendioso in termini di risorse, richiede ~20 GB al primo download.
Usa COCO8-Seg per verificare la pipeline nel minor tempo possibile, poi passa a COCO128-Seg o al dataset COCO-Seg completo man mano che aumenta la tua fiducia.