Manutenzione dei modelli di visione artificiale dopo la distribuzione
Monitorare e mantenere un modello di visione artificiale significa tracciare costantemente le sue previsioni per individuare la deriva dei dati e i cali di accuratezza, riaddestrarlo con dati aggiornati quando le prestazioni peggiorano e documentare ogni modifica affinché il lavoro resti riproducibile. Questa è la fase finale di un progetto di visione artificiale, dopo aver raccolto i requisiti, annotato i dati, addestrato il modello e distribuito il modello: è ciò che consente al modello di continuare a soddisfare gli obiettivi del progetto una volta in produzione.
Guarda: Come mantenere i modelli di visione artificiale dopo la distribuzione | Rilevamento del data drift
In questa guida vedremo più da vicino come mantenere i modelli di visione artificiale dopo la distribuzione. Esamineremo come il monitoraggio dei modelli può aiutarti a individuare tempestivamente i problemi, come mantenerli accurati e aggiornati e perché la documentazione è importante per la risoluzione dei problemi.
Monitoraggio dei modelli#
È fondamentale monitorare attentamente i modelli di visione artificiale distribuiti. Senza un monitoraggio adeguato, i modelli possono perdere accuratezza. Un problema comune è lo spostamento della distribuzione dei dati, o deriva dei dati, per cui i dati incontrati dal modello sono diversi da quelli usati per addestrarlo. Quando il modello deve fare previsioni su dati che non riconosce, può interpretarli in modo errato e offrire prestazioni scadenti. Anche i valori anomali, ovvero punti dati insoliti, possono compromettere l'accuratezza del modello.
Il monitoraggio regolare del modello aiuta gli sviluppatori a tenere traccia delle prestazioni del modello, individuare anomalie e affrontare rapidamente problemi come il data drift. Aiuta anche a gestire le risorse, indicando quando sono necessari aggiornamenti, evitando revisioni costose e mantenendo il modello attuale.
Best practice per il monitoraggio dei modelli#
Ecco alcune best practice da tenere presenti quando monitori il tuo modello di visione artificiale in produzione:
- Monitora regolarmente le prestazioni: controlla costantemente le prestazioni del modello per rilevare i cambiamenti nel tempo.
- Verifica la qualità dei dati: controlla che nei dati non ci siano valori mancanti o anomalie.
- Usa fonti di dati diverse: monitora dati provenienti da varie fonti per ottenere una visione completa delle prestazioni del modello.
- Combina diverse tecniche di monitoraggio: usa una combinazione di algoritmi di rilevamento del drift e approcci basati su regole per identificare un'ampia gamma di problemi.
- Monitora input e output: tieni sotto controllo sia i dati elaborati dal modello sia i risultati che produce, per assicurarti che tutto funzioni correttamente.
- Configura avvisi: imposta avvisi per comportamenti insoliti, come cali delle prestazioni, così da poter intervenire rapidamente.
Monitoraggio con Ultralytics Platform#
La Ultralytics Platform offre funzionalità integrate di monitoraggio dei modelli per gli endpoint YOLO distribuiti, così puoi controllare il tuo modello in produzione senza creare uno stack di monitoraggio separato. La dashboard Deploy monitora in tempo reale i principali indicatori:
- Metriche delle richieste: volume totale delle richieste, tasso di errore e latenza P95 per ciascun endpoint, con grafici sparkline delle tendenze nelle ultime 24 ore nella dashboard e intervalli da 1 ora a 30 giorni tramite l'API delle metriche.
- Controlli di integrità: controlli dello stato degli endpoint che segnalano le distribuzioni non funzionanti e riportano la latenza delle risposte.
- Log: log delle richieste filtrabili per gravità (da DEBUG a CRITICAL) per diagnosticare le richieste non riuscite e i picchi di latenza.
- Vista globale: una mappa interattiva del mondo e schede di riepilogo che mostrano tutte le distribuzioni nelle varie aree geografiche in un'unica vista.
Poiché il monitoraggio è accessibile tramite URL standard degli endpoint e un controllo /health, puoi integrare questi segnali anche nella configurazione di osservabilità esistente quando ti serve un'analisi più approfondita. Per i dettagli di configurazione, consulta la guida al monitoraggio delle distribuzioni.
Rilevamento delle anomalie e sistemi di avviso#
Un'anomalia è qualsiasi punto dati o schema che si discosta notevolmente da quanto previsto. Nei modelli di visione artificiale, le anomalie possono essere immagini molto diverse da quelle usate per addestrare il modello. Queste immagini inattese possono segnalare problemi come cambiamenti nella distribuzione dei dati, valori anomali o comportamenti che potrebbero ridurre le prestazioni del modello. Configurare sistemi di avviso per rilevare queste anomalie è una parte importante del monitoraggio dei modelli.
Definendo livelli e limiti standard per le metriche principali, puoi individuare i problemi tempestivamente. Quando le prestazioni superano questi limiti, vengono attivati degli avvisi che consentono di intervenire rapidamente. Aggiornare e riaddestrare regolarmente i modelli con nuovi dati permette di mantenerli pertinenti e accurati al variare dei dati.
Configurazione di soglie e avvisi#
Quando configuri i sistemi di avviso, tieni presenti queste best practice:
- Avvisi standardizzati: usa strumenti e formati coerenti per tutti gli avvisi, come le email o le app di messaggistica come Slack. La standardizzazione ti permette di comprendere e gestire rapidamente gli avvisi.
- Includi il comportamento previsto: i messaggi di avviso devono indicare chiaramente che cosa è andato storto, che cosa ci si aspettava e l'intervallo di tempo valutato. In questo modo puoi valutare l'urgenza e il contesto dell'avviso.
- Avvisi configurabili: rendi gli avvisi facilmente configurabili per adattarli alle condizioni in evoluzione. Permettiti di modificare le soglie, posticipare, disabilitare o confermare gli avvisi.
Rilevamento del data drift#
Il rilevamento della deriva dei dati individua i cambiamenti nel tempo delle proprietà statistiche dei dati di input, che possono peggiorare le prestazioni del modello. Questa tecnica aiuta a individuare un problema prima di decidere se riaddestrare o modificare i modelli. La deriva dei dati riguarda i cambiamenti nel panorama generale dei dati nel tempo, mentre il rilevamento delle anomalie si concentra sull'identificazione di punti dati rari o inattesi che potrebbero richiedere un intervento immediato.
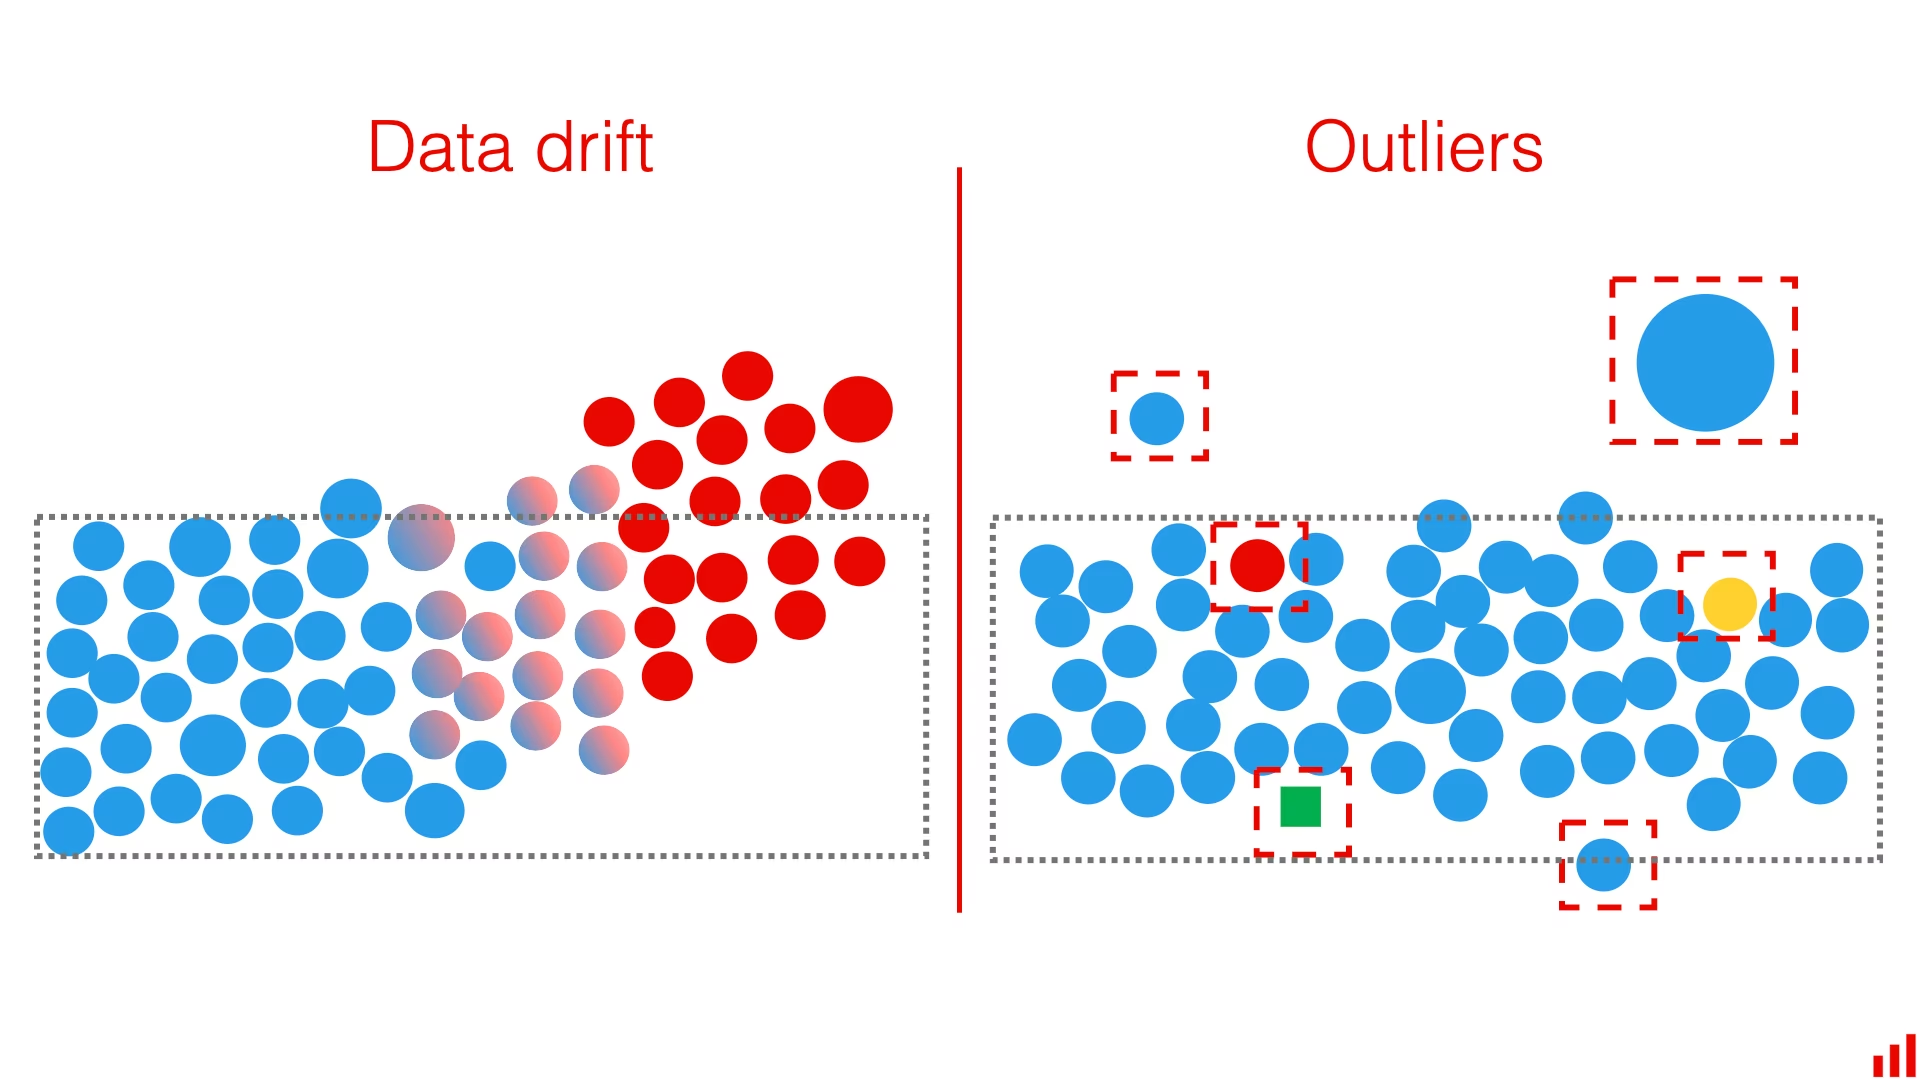
Ecco alcuni metodi per rilevare il data drift:
- Monitoraggio continuo: controlla regolarmente i dati di input e gli output del modello per rilevare eventuali segni di drift. Tieni traccia delle metriche principali e confrontale con i dati storici per individuare cambiamenti significativi.
- Tecniche statistiche: usa metodi come il test di Kolmogorov-Smirnov o l'indice di stabilità della popolazione (PSI) per rilevare i cambiamenti nelle distribuzioni dei dati. Questi test confrontano la distribuzione dei nuovi dati con i dati di addestramento per individuare differenze significative.
- Drift delle caratteristiche: monitora il drift delle singole caratteristiche. A volte la distribuzione complessiva dei dati può rimanere stabile, mentre alcune caratteristiche cambiano. Individuare quali caratteristiche presentano drift aiuta a perfezionare il processo di riaddestramento.
Manutenzione dei modelli#
La manutenzione dei modelli mantiene nel tempo l'accuratezza e la pertinenza dei modelli di visione artificiale aggiornandoli e riaddestrandoli regolarmente, affrontando il data drift e adattandoli ai cambiamenti dei dati e degli ambienti. È la controparte del monitoraggio: il monitoraggio controlla le prestazioni del modello in tempo reale per individuare tempestivamente i problemi, mentre la manutenzione consiste nel risolverli.
Aggiornamenti e riaddestramento regolari#
Dopo aver distribuito un modello, il monitoraggio può rivelare cambiamenti negli schemi dei dati o nelle prestazioni, che indicano un drift del modello. Gli aggiornamenti e il riaddestramento regolari diventano quindi parti essenziali della manutenzione del modello, per assicurarti che sia in grado di gestire nuovi schemi e scenari. Puoi usare diverse tecniche a seconda di come cambiano i dati.
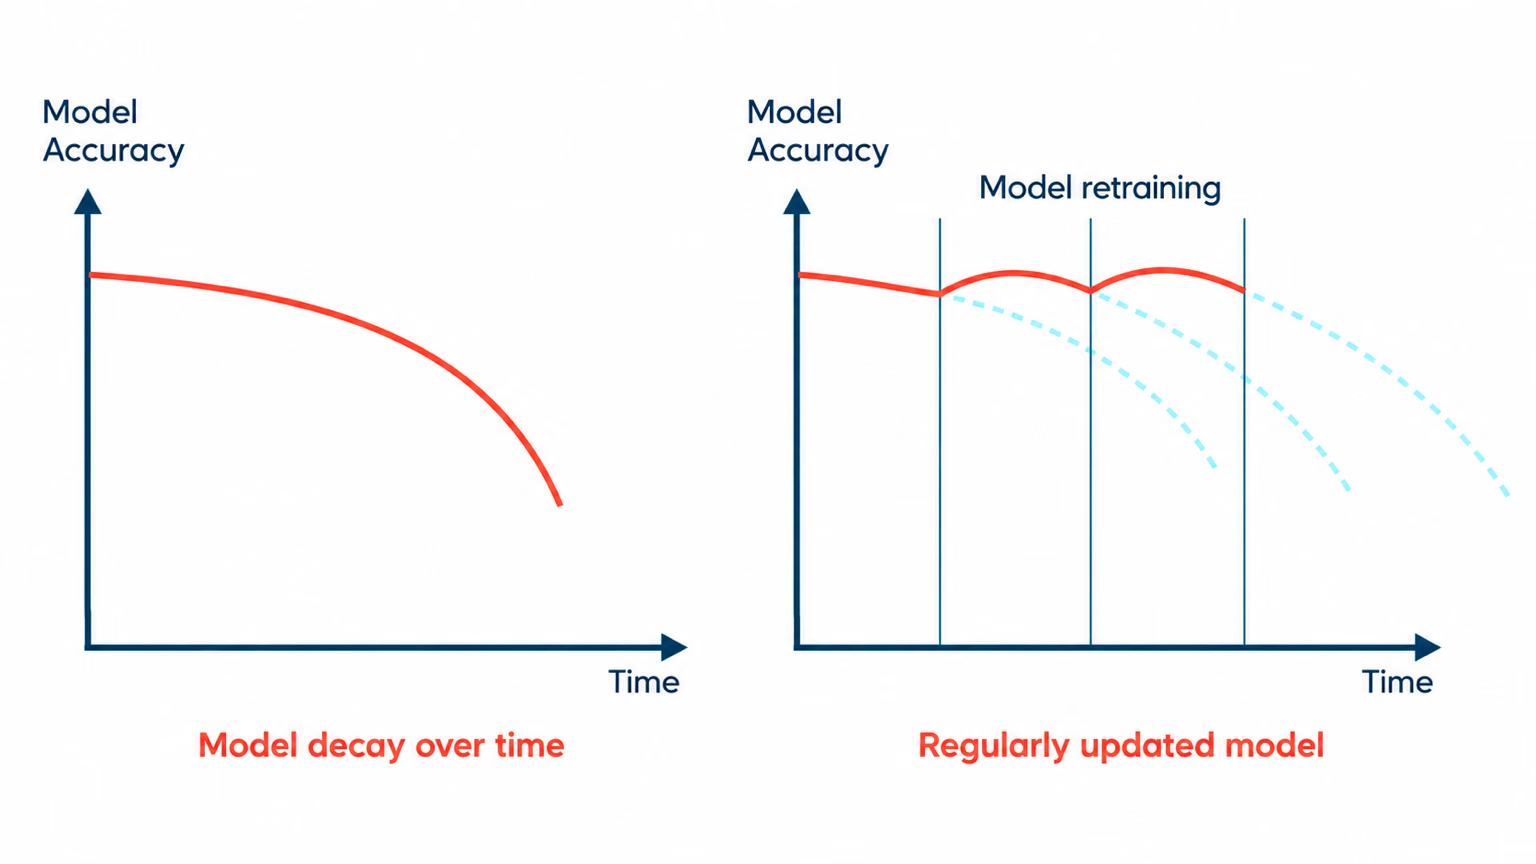
Ad esempio, se i dati cambiano gradualmente nel tempo, l'apprendimento incrementale è un buon approccio. L'apprendimento incrementale consiste nell'aggiornare il modello con nuovi dati senza riaddestrarlo completamente da zero, risparmiando risorse di calcolo e tempo. Se invece i dati sono cambiati drasticamente, un riaddestramento completo periodico potrebbe essere un'opzione migliore per assicurarsi che il modello non faccia overfitting sui nuovi dati perdendo al contempo i modelli precedenti.
Indipendentemente dal metodo, dopo gli aggiornamenti è indispensabile eseguire la convalida e i test. È importante convalidare il modello su un dataset di test separato per verificare eventuali miglioramenti o peggioramenti delle prestazioni.
Decidere quando riaddestrare il modello#
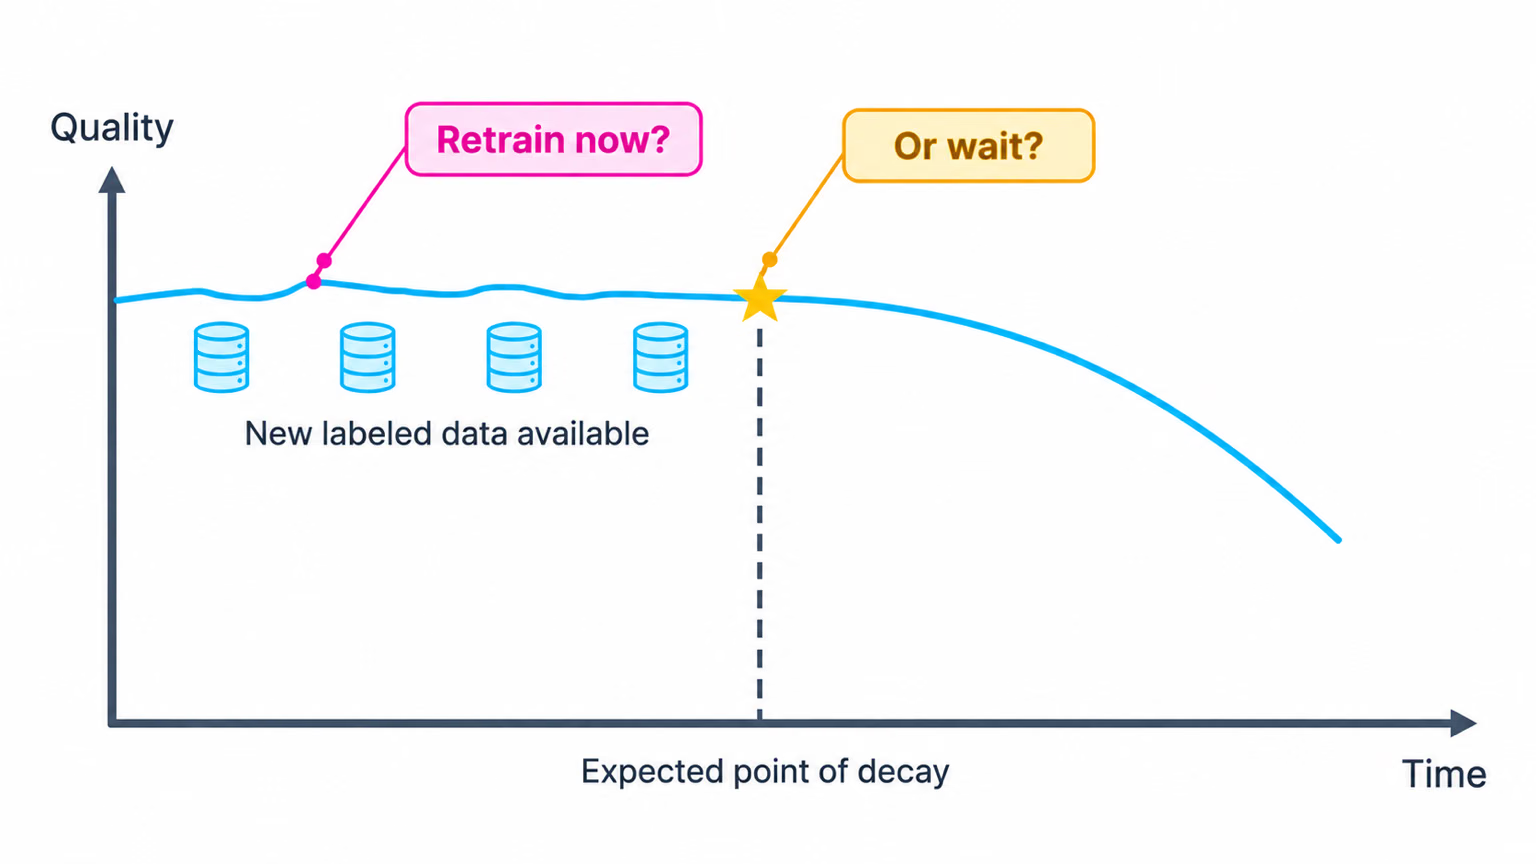
La frequenza con cui riaddestrare il modello di visione artificiale dipende dai cambiamenti nei dati e dalle prestazioni del modello. Riaddestra il modello ogni volta che noti un calo significativo delle prestazioni o rilevi data drift. Le valutazioni periodiche possono aiutarti a stabilire la frequenza corretta, verificando il modello su nuovi dati. Monitorare le metriche delle prestazioni e gli schemi dei dati ti permette di decidere se il modello ha bisogno di aggiornamenti più frequenti per mantenere l'accuratezza.
Documentazione#
Documentare un progetto di visione artificiale ne facilita la comprensione, la riproducibilità e la collaborazione. Una buona documentazione descrive l'architettura del modello, gli iperparametri, i dataset, le metriche di valutazione e altro ancora. Garantisce trasparenza e aiuta i membri del team e gli stakeholder a capire che cosa è stato fatto e perché. La documentazione è utile anche per la risoluzione dei problemi, la manutenzione e i miglioramenti futuri, perché fornisce un riferimento chiaro alle decisioni e ai metodi adottati in precedenza.
Elementi chiave da documentare#
Ecco alcuni degli elementi chiave da includere nella documentazione del progetto:
- Panoramica del progetto: fornisci una sintesi generale del progetto, inclusi il problema da affrontare, l'approccio alla soluzione, i risultati attesi e l'ambito del progetto. Spiega il ruolo della visione artificiale nell'affrontare il problema e descrivi le fasi e i risultati da consegnare.
- Architettura del modello: descrivi in dettaglio la struttura e la progettazione del modello, inclusi i componenti, i layer e i collegamenti. Spiega gli iperparametri scelti e le motivazioni alla base di queste scelte.
- Preparazione dei dati: descrivi le fonti, i tipi, i formati e le dimensioni dei dati, nonché le fasi di preelaborazione. Esamina la qualità e l'affidabilità dei dati e le eventuali trasformazioni applicate prima dell'addestramento del modello.
- Processo di addestramento: documenta la procedura di addestramento, inclusi i dataset utilizzati, i parametri di addestramento e le funzioni di perdita. Spiega come è stato addestrato il modello e le eventuali difficoltà incontrate durante l'addestramento.
- Metriche di valutazione: specifica le metriche utilizzate per valutare le prestazioni del modello, come accuratezza, precisione, richiamo e punteggio F1. Includi i risultati delle prestazioni e un'analisi di queste metriche.
- Fasi di distribuzione: descrivi i passaggi seguiti per distribuire il modello, inclusi gli strumenti e le piattaforme utilizzati, le configurazioni di distribuzione e le eventuali difficoltà o considerazioni specifiche.
- Procedura di monitoraggio e manutenzione: fornisci un piano dettagliato per monitorare le prestazioni del modello dopo la distribuzione. Includi metodi per rilevare e affrontare la deriva dei dati e del modello e descrivi il processo per gli aggiornamenti regolari e il riaddestramento.
Conclusione#
Monitorare, mantenere e documentare il tuo modello è ciò che permette a un progetto di visione artificiale di continuare ad avere successo molto tempo dopo la distribuzione: il monitoraggio continuo rileva tempestivamente i problemi, il riaddestramento regolare adatta il modello ai nuovi dati e alla deriva, e una documentazione chiara semplifica ogni aggiornamento futuro. Consideralo un ciclo continuo e rivedi le fasi del tuo progetto di visione artificiale man mano che evolvono i dati e i requisiti.
Domande frequenti#
Per monitorare un modello di visione artificiale distribuito, tieni traccia in produzione del volume di richieste, del tasso di errore e della latenza, prestando attenzione alle anomalie e alla deriva dei dati che segnalano un calo dell'accuratezza. La dashboard Deploy della Ultralytics Platform copre subito gli aspetti relativi alle metriche di produzione, offrendo metriche in tempo reale, controlli automatici dello stato e log filtrati per gravità. Monitora regolarmente gli input e gli output, configura avvisi per comportamenti insoliti e usa fonti di dati diverse per ottenere una visione completa delle prestazioni del tuo modello. Per maggiori dettagli, consulta la sezione dedicata al monitoraggio del modello.
La manutenzione dei modelli di visione artificiale richiede aggiornamenti, riaddestramento e monitoraggio regolari, per garantirne l'accuratezza e la pertinenza nel tempo. Le best practice includono:
- Monitoraggio continuo: tieni regolarmente traccia delle metriche delle prestazioni e della qualità dei dati.
- Rilevamento della deriva dei dati: usa tecniche statistiche per individuare i cambiamenti nelle distribuzioni dei dati.
- Aggiornamenti e riaddestramento regolari: implementa l'apprendimento incrementale o un riaddestramento completo periodico in base ai cambiamenti dei dati.
- Documentazione: mantieni una documentazione dettagliata dell'architettura del modello, dei processi di addestramento e delle metriche di valutazione. Per approfondire, visita la sezione dedicata alla manutenzione del modello.
Il rilevamento della deriva dei dati è essenziale perché aiuta a individuare quando le proprietà statistiche dei dati di input cambiano nel tempo, con il rischio di ridurre le prestazioni del modello. Tecniche come il monitoraggio continuo, i test statistici (ad esempio, il test di Kolmogorov-Smirnov) e l'analisi della deriva delle feature possono aiutare a identificare tempestivamente i problemi. Affrontare la deriva dei dati garantisce che il modello rimanga accurato e pertinente in ambienti in evoluzione. Scopri di più sul rilevamento della deriva dei dati nella nostra sezione dedicata al rilevamento della deriva dei dati.
Per rilevare anomalie nei modelli di visione artificiale, definisci livelli di prestazione standard per le metriche chiave e attiva avvisi ogni volta che i valori superano tali limiti. La Ultralytics Platform offre questa funzionalità con metriche in tempo reale sul tasso di errore e sulla latenza, controlli automatici dello stato e log filtrati per gravità che evidenziano rapidamente i comportamenti insoliti. Gli avvisi configurabili e i messaggi standardizzati ti aiutano a reagire rapidamente ai potenziali problemi. Approfondisci nella nostra sezione dedicata ai sistemi di rilevamento delle anomalie e di allerta.
Una documentazione efficace di un progetto di visione artificiale dovrebbe includere:
- Panoramica del progetto: sintesi generale, descrizione del problema e approccio alla soluzione.
- Architettura del modello: dettagli sulla struttura del modello, sui componenti e sugli iperparametri.
- Preparazione dei dati: informazioni sulle fonti dei dati, sulle fasi di preelaborazione e sulle trasformazioni.
- Processo di addestramento: descrizione della procedura di addestramento, dei dataset utilizzati e delle difficoltà incontrate.
- Metriche di valutazione: metriche utilizzate per valutare e analizzare le prestazioni.
- Fasi di distribuzione: passaggi seguiti per la distribuzione del modello ed eventuali difficoltà specifiche.
- Procedura di monitoraggio e manutenzione: piano per il monitoraggio e la manutenzione continui. Per linee guida più complete, consulta la sezione Documentazione.


Commenti4
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
SunyuKy
Hello, I am training my own dataset using yolov11. My dataset usually only contains one small target, so a large part of the image is background, which makes it easy for the model to recognize the target class as the background class. How can I modify the configuration file to improve the model performance? Will adjusting the loss gain of box and cls work?
 Glenn JocherUltralytics
@SunyuKy to improve model performance on a dataset with a small target and large background, consider adjusting the
boxandclsloss gains in the configuration file. This can help the model focus more on the target class. Additionally, experimenting with data augmentation techniques might enhance detection accuracy. For more detailed guidance, you can refer to our documentation on model monitoring and maintenance.Thank you for your reply!I would like to know in which direction the loss gain of the bounding box and classification should be adjusted. I guess I should increase the loss gain of the classification. So, should the loss gain of the bounding box be increased or decreased?
- Glenn JocherUltralytics(modificato)
To improve performance, try increasing the classification loss gain (
cls) to emphasize the target class. For the bounding box loss (box), you might experiment with both increasing and decreasing it and compare validation results.