Guida alla distribuzione di YOLO26 su Amazon SageMaker Endpoints
Gli endpoint di Amazon SageMaker offrono hosting gestito e scalabile per modelli di visione artificiale come Ultralytics YOLO26 nelle applicazioni di machine learning in produzione. Per distribuire correttamente un modello, è necessario comprendere i passaggi di configurazione e distribuzione sia per il modello sia per AWS.
Questa guida ti accompagnerà passo dopo passo nella distribuzione di modelli YOLO26 PyTorch su Amazon SageMaker Endpoints. Imparerai gli elementi essenziali per preparare il tuo ambiente AWS, configurare il modello in modo appropriato e usare strumenti come AWS CloudFormation e AWS Cloud Development Kit (CDK) per la distribuzione.
Amazon SageMaker#
Amazon SageMaker è un servizio di machine learning di Amazon Web Services (AWS) che semplifica la creazione, il training e la distribuzione di modelli di machine learning. Offre un'ampia gamma di strumenti per gestire vari aspetti dei flussi di lavoro di machine learning. Include funzionalità automatizzate per ottimizzare i modelli, opzioni per addestrarli su larga scala e metodi semplici per distribuirli in produzione. SageMaker supporta i framework di machine learning più diffusi e offre la flessibilità necessaria per progetti diversi. Le sue funzionalità comprendono anche l'etichettatura dei dati, la gestione dei flussi di lavoro e l'analisi delle prestazioni.
Distribuzione di YOLO26 su Amazon SageMaker Endpoints#
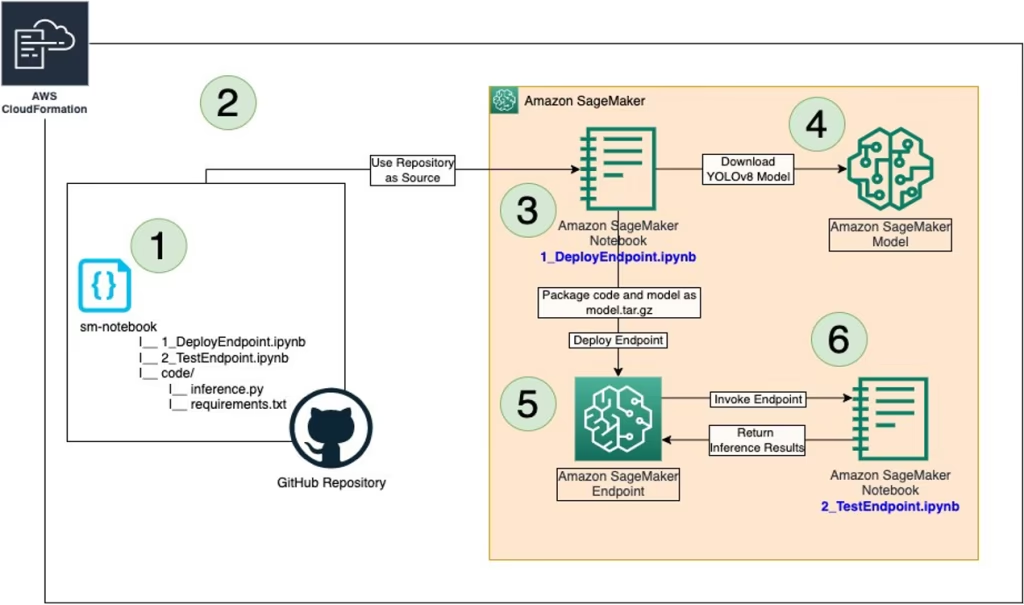
Distribuire YOLO26 su Amazon SageMaker ti permette di usare il suo ambiente gestito per l'inferenza in tempo reale e di sfruttare funzionalità come l'autoscaling. Dai un'occhiata all'architettura AWS qui sotto.
Passaggio 1: configura il tuo ambiente AWS#
Per prima cosa, assicurati di avere a disposizione i seguenti prerequisiti:
-
Un account AWS: se non ne hai già uno, registrati per crearne uno.
-
Ruoli IAM configurati: ti servirà un ruolo IAM con le autorizzazioni necessarie per Amazon SageMaker, AWS CloudFormation e Amazon S3. Il ruolo deve avere policy che consentano l'accesso a questi servizi.
-
AWS CLI: se non è già installata, scarica e installa l'interfaccia della riga di comando AWS (CLI) e configúrala con i dati del tuo account. Per l'installazione, segui le istruzioni per AWS CLI.
-
AWS CDK: se non è già installato, installa AWS Cloud Development Kit (CDK), che verrà usato per creare gli script di distribuzione. Per l'installazione, segui le istruzioni per AWS CDK.
-
Quota di servizio adeguata: verifica di disporre di quote sufficienti per due risorse distinte in Amazon SageMaker: una per
ml.m5.4xlargeper l'uso degli endpoint e un'altra perml.m5.4xlargeper l'uso delle istanze notebook. Per ciascuna risorsa è richiesto un valore di quota minimo pari a uno. Se le quote attuali sono inferiori a questo requisito, è importante richiedere un aumento per ognuna. Puoi richiedere un aumento della quota seguendo le istruzioni dettagliate nella documentazione di AWS Service Quotas.
Passaggio 2: clona il repository SageMaker di YOLO26#
Il passaggio successivo consiste nel clonare il repository AWS specifico che contiene le risorse necessarie per distribuire YOLO26 su SageMaker. Ospitato su GitHub, questo repository include gli script CDK e i file di configurazione necessari.
-
Clona il repository GitHub: esegui il seguente comando nel terminale per clonare il repository host-yolov8-on-sagemaker-endpoint:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git -
Passa alla directory clonata: spostati nella directory del repository clonato:
cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk
Passaggio 3: configura l'ambiente CDK#
Ora che hai il codice necessario, configura l'ambiente per la distribuzione con AWS CDK.
-
Crea un ambiente virtuale Python: in questo modo isoli l'ambiente Python e le relative dipendenze. Esegui:
python3 -m venv .venv -
Attiva l'ambiente virtuale:
source .venv/bin/activate -
Installa le dipendenze: installa le dipendenze Python richieste dal progetto:
pip3 install -r requirements.txt -
Aggiorna la libreria AWS CDK: assicurati di avere la versione più recente della libreria AWS CDK:
pip install --upgrade aws-cdk-lib
Passaggio 4: crea lo stack AWS CloudFormation#
-
Sintetizza l'applicazione CDK: genera il template AWS CloudFormation dal tuo codice CDK:
cdk synth -
Esegui il bootstrap dell'applicazione CDK: prepara l'ambiente AWS per la distribuzione con CDK:
cdk bootstrap -
Distribuisci lo stack: verranno create le risorse AWS necessarie e distribuito il tuo modello:
cdk deploy
Passaggio 5: distribuisci il modello YOLO#
Dopo aver creato lo stack AWS CloudFormation, il passaggio successivo consiste nel distribuire YOLO26.
-
Apri l'istanza notebook: vai alla console AWS e apri il servizio Amazon SageMaker. Seleziona "Istanze notebook" nel pannello di controllo, quindi individua l'istanza notebook creata dallo script di distribuzione CDK. Apri l'istanza notebook per accedere all'ambiente Jupyter.
-
Accedi a inference.py e modificalo: dopo aver aperto l'istanza notebook SageMaker in Jupyter, individua il file inference.py. Modifica la funzione output_fn in inference.py come mostrato qui sotto e salva le modifiche allo script, assicurandoti che non ci siano errori di sintassi.
import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" print("Executing output_fn from inference.py ...") infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() if result.masks is not None: infer["masks"] = result.masks.numpy().data.tolist() if result.keypoints is not None: infer["keypoints"] = result.keypoints.numpy().data.tolist() if result.obb is not None: infer["obb"] = result.obb.numpy().data.tolist() if result.probs is not None: infer["probs"] = result.probs.numpy().data.tolist() return json.dumps(infer) -
Distribuisci l'endpoint usando 1_DeployEndpoint.ipynb: nell'ambiente Jupyter, apri il notebook 1_DeployEndpoint.ipynb che si trova nella directory sm-notebook. Imposta
model_namenel notebook su un checkpoint YOLO26, ad esempioyolo26n.pt(per impostazione predefinita usa un modello YOLOv8), quindi esegui le celle per scaricare il modello, inserirlo in un pacchetto con il codice di inferenza aggiornato e caricarlo in un bucket Amazon S3. Il notebook ti guiderà nella creazione e distribuzione di un endpoint SageMaker per il modello YOLO26.
Passaggio 6: testa la distribuzione#
Ora che il modello YOLO26 è distribuito, è importante verificarne le prestazioni e il funzionamento.
-
Apri il notebook di test: nello stesso ambiente Jupyter, individua e apri il notebook 2_TestEndpoint.ipynb, anch'esso nella directory sm-notebook.
-
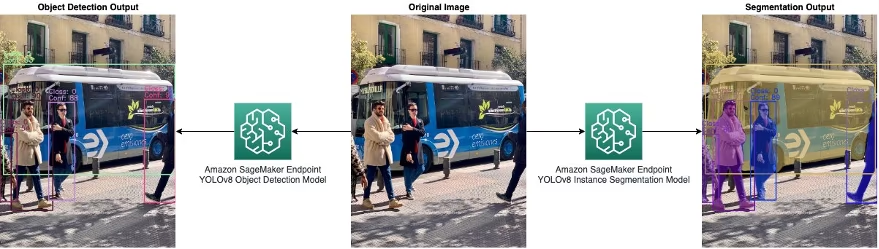
Esegui il notebook di test: segui le istruzioni nel notebook per testare l'endpoint SageMaker distribuito. In questo modo invierai un'immagine all'endpoint ed eseguirai inferenze. Poi traccerai l'output per visualizzare le prestazioni e la precisione del modello, come mostrato qui sotto.
- Pulisci le risorse: il notebook di test ti guiderà anche nella pulizia dell'endpoint e del modello ospitato. È un passaggio importante per gestire efficacemente i costi e le risorse, soprattutto se non prevedi di usare subito il modello distribuito.
Passaggio 7: monitoraggio e gestione#
Dopo i test, è essenziale monitorare e gestire continuamente il modello distribuito.
-
Monitora con Amazon CloudWatch: controlla regolarmente le prestazioni e lo stato di salute del tuo endpoint SageMaker usando Amazon CloudWatch.
-
Gestisci l'endpoint: usa la console SageMaker per la gestione continua dell'endpoint. Potrai ridimensionare, aggiornare o ridistribuire il modello secondo necessità.
Completati questi passaggi, avrai distribuito e testato un modello YOLO26 sugli endpoint di Amazon SageMaker. Lo stesso flusso di lavoro si applica alla distribuzione di altri modelli su AWS.
Riepilogo#
Questa guida ti ha accompagnato passo dopo passo nella distribuzione di YOLO26 sugli endpoint di Amazon SageMaker usando AWS CloudFormation e AWS Cloud Development Kit (CDK). Il processo include la clonazione del repository di esempio AWS citato nel post del blog AWS Machine Learning su come ospitare modelli YOLOv8 PyTorch sugli endpoint di Amazon SageMaker, la configurazione dell'ambiente CDK, la distribuzione del modello tramite i servizi AWS e il test delle sue prestazioni su SageMaker.
Domande frequenti#
Per distribuire il modello Ultralytics YOLO26 su Amazon SageMaker Endpoints, segui questi passaggi:
- Configura l'ambiente AWS: assicurati di avere un account AWS, ruoli IAM con le autorizzazioni necessarie e AWS CLI configurato. Installa AWS CDK, se non l'hai già fatto (consulta le istruzioni per AWS CDK).
- Clona il repository YOLO26 SageMaker:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk - Configura l'ambiente CDK: crea un ambiente virtuale Python, attivalo, installa le dipendenze e aggiorna la libreria AWS CDK.
python3 -m venv .venv source .venv/bin/activate pip3 install -r requirements.txt pip install --upgrade aws-cdk-lib - Esegui la distribuzione con AWS CDK: sintetizza e distribuisci lo stack CloudFormation, quindi avvia il bootstrap dell'ambiente.
cdk synth
cdk bootstrap
cdk deploy
Per distribuire YOLO26 su Amazon SageMaker, assicurati di avere i seguenti prerequisiti:
- Account AWS: un account AWS attivo (registrati ad AWS.)
- Ruoli IAM: ruoli IAM configurati con autorizzazioni per SageMaker, CloudFormation e Amazon S3.
- AWS CLI: interfaccia a riga di comando AWS installata e configurata (guida all'installazione di AWS CLI).
- AWS CDK: Kit di sviluppo cloud AWS installato (guida alla configurazione di CDK).
- Quote dei servizi: quote sufficienti per le istanze
ml.m5.4xlargesia per l'uso degli endpoint sia per quello dei notebook (richiedi un aumento della quota).
L'uso di Ultralytics YOLO26 su Amazon SageMaker offre diversi vantaggi:
- Scalabilità e gestione: SageMaker offre un ambiente gestito con funzionalità come la scalabilità automatica, utile per le esigenze di inferenza in tempo reale.
- Integrazione con i servizi AWS: integra il sistema con altri servizi AWS, come S3 per l'archiviazione dei dati, CloudFormation per l'infrastruttura come codice e CloudWatch per il monitoraggio.
- Facilità di distribuzione: configurazione semplificata tramite gli script AWS CDK e processi di distribuzione ottimizzati.
- Prestazioni: usa l'infrastruttura gestita di Amazon SageMaker per eseguire carichi di lavoro di inferenza su larga scala.
Sì, puoi personalizzare la logica di inferenza di YOLO26 su Amazon SageMaker:
-
Modifica
inference.py: individua e personalizza la funzioneoutput_fnnel fileinference.pyper adattare i formati di output.import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() # Aggiungi altra logica di elaborazione, se necessario return json.dumps(infer) -
Distribuisci il modello aggiornato: assicurati di distribuire nuovamente il modello usando i notebook Jupyter forniti (
1_DeployEndpoint.ipynb) per includere queste modifiche.
Consulta i passaggi dettagliati per distribuire il modello modificato.
-
Per testare il modello YOLO26 distribuito su Amazon SageMaker:
- Apri il notebook di test: individua il notebook
2_TestEndpoint.ipynbnell'ambiente Jupyter di SageMaker. - Esegui il notebook: segui le istruzioni del notebook per inviare un'immagine all'endpoint, eseguire l'inferenza e visualizzare i risultati.
- Visualizza i risultati: usa il codice di visualizzazione del notebook per disegnare i riquadri di delimitazione previsti sull'immagine di test.
Per istruzioni complete sui test, visita la sezione dedicata ai test.
- Apri il notebook di test: individua il notebook


Commenti10
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
 User
I want to upload the YOLOv8 model I trained on my own dataset to Jupyter, and then compress it into a
model.tar.gzfile following the officialdeployendpointsteps. However, when I usetestendpoint, I encounter an error. If I rename my trained model toyolov8, the test succeeds, but it uses the original model from the official website instead of my custom one. How should I modifyinference.pyto ensure it loads my trained model?1 Glenn JocherUltralytics
@lijoe123 to ensure your custom YOLOv8 model is used, modify the
inference.pyto load your model by specifying its path directly. Ensure the model name in your deployment matches your custom model's name. For detailed steps, refer to the Ultralytics documentation on Amazon SageMaker.- User
Thank you for your answer. I had followed the
1_DeployEndpoint.ipynbto delpoy my own model. In the 1.4 Create the SageMaker PyTorchModel, I had set theenv={'TS_MAX_RESPONSE_SIZE':'20000000', 'MY_MODEL': 'my_own_model'}. And in theinference.py:def model_fn(model_dir): print("Executing model_fn from inference.py ...") env = os.environ model = YOLO(os.path.join(model_dir, env['MY_MODEL'])) return modelI think it will be use my own model directly. But it failed, and it occur this problem:
ModelError: An error occurred (ModelError) when calling the InvokeEndpoint operation: Received server error (0)from primary with message "Your invocation timed out while waiting for a response from container primary. Reviewthe latency metrics for each container in Amazon Cloudatch, resolve the issue, and try again.". See https://useast-1. console. aws. aazon. com/cloudwatch/home?region=us-east-1#logEventViewer: group=/aws/sagemaker Endpoints/yolov8-pytorch-2024-09-06-11-33-49-418696 in account 211125332801 for more information.Could you tell me how to modify the
inference.pyto load my own model. Thank you so much. - Glenn JocherUltralytics
To ensure your custom YOLOv8 model is used, verify that the
model_fnininference.pycorrectly points to your model's path. Ensure theMY_MODELenvironment variable matches your model's filename. If issues persist, check CloudWatch logs for detailed error messages. For further guidance, refer to the Ultralytics documentation on Amazon SageMaker.
SJTUPanda
Thanks for your sharing, it's very clear and useful. My own deployment workflow on AWS has already built but the test result is not so satisfying. The performance of detection result of yolo11-xl on AWS is worse than on my own laptop. I not sure if there is some default quantization when it's deployed to the AWS(I did not modified much to host-yolov8-on-sagemaker-endpoint), or do you have some other ideas about which would bring this significant performance differences?
- Glenn JocherUltralytics
@SJTUPanda thank you for your feedback! The performance difference could stem from several factors like hardware disparities (AWS instance vs laptop GPU), inference settings, or environment configurations. First, verify that your SageMaker instance type matches your local hardware capabilities, and ensure identical inference parameters (e.g.,
imgsz,batch). Check our Amazon SageMaker deployment guide for optimization tips and consider profiling both environments withyolo valto isolate bottlenecks. Let us know if specific metrics differ! 🚀 Thanks for your quick reply. The issue is fixed after I comment out resize related code. Although the model is trained with (640,640) and the input image size is (720,440), using the raw images directly as input is better than resized it. I am curious the input images would be auto-resized by the model just as in the training/testing part? And why resized by myself has so much impact on the results? If these part code should be update because yolo version updating?
image_height, image_width, _ = orig_image.shape model_height, model_width = 640, 640 x_ratio = image_width/model_width y_ratio = image_height/model_height # Resize the image as numpy array resized_image = cv2.resize(orig_image, (model_height, model_width)) # Conver the array into jpeg resized_jpeg = cv2.imencode('.jpg', resized_image)[1] # Serialize the jpg using base 64 payload = base64.b64encode(resized_jpeg).decode('utf-8')- Glenn JocherUltralytics
Thank you for sharing your findings! YOLO models do automatically resize inputs to match their training dimensions while preserving aspect ratio with letterboxing. Manual resizing can distort aspect ratios or introduce artifacts, potentially degrading performance. We recommend using the model's native preprocessing by feeding full-size images directly, as this maintains proper scaling and aspect ratio handling. For implementation details, refer to our model deployment best practices regarding input consistency.
NikoXanthidis
Gostaria de saber se esses recursos são pagos.
- Glenn JocherUltralytics
Olá! 👋 Os recursos mencionados para implementar o YOLOv8 no Amazon SageMaker não são pagos por si só. No entanto, o uso do Amazon SageMaker e outros serviços da AWS associados à implementação e execução do modelo podem incorrer em custos conforme o uso. A AWS oferece uma camada gratuita que você pode aproveitar para experimentar alguns serviços sem custo, mas é sempre bom verificar a página de preços do SageMaker para detalhes específicos. Se precisar de ajuda para estimar os custos ou tiver outras dúvidas, estou aqui para ajudar! 🚀