YOLOv10: rilevamento di oggetti end-to-end in tempo reale
YOLOv10, rilasciato a maggio 2024 e basato sul pacchetto Python di Ultralytics da ricercatori della Tsinghua University, introduce un nuovo approccio al rilevamento di oggetti in tempo reale, affrontando i limiti della post-elaborazione e dell’architettura dei modelli presenti nelle versioni YOLO precedenti. Eliminando la soppressione dei massimi non locali (NMS) e ottimizzando diversi componenti del modello, al momento del rilascio YOLOv10 ha ottenuto prestazioni elevate riducendo notevolmente il carico computazionale. La sua architettura end-to-end senza NMS ha introdotto un approccio poi ulteriormente sviluppato in YOLO26.
Guarda: Come addestrare YOLOv10 sul dataset SKU-110k usando Ultralytics | Dataset per il retail
Panoramica#
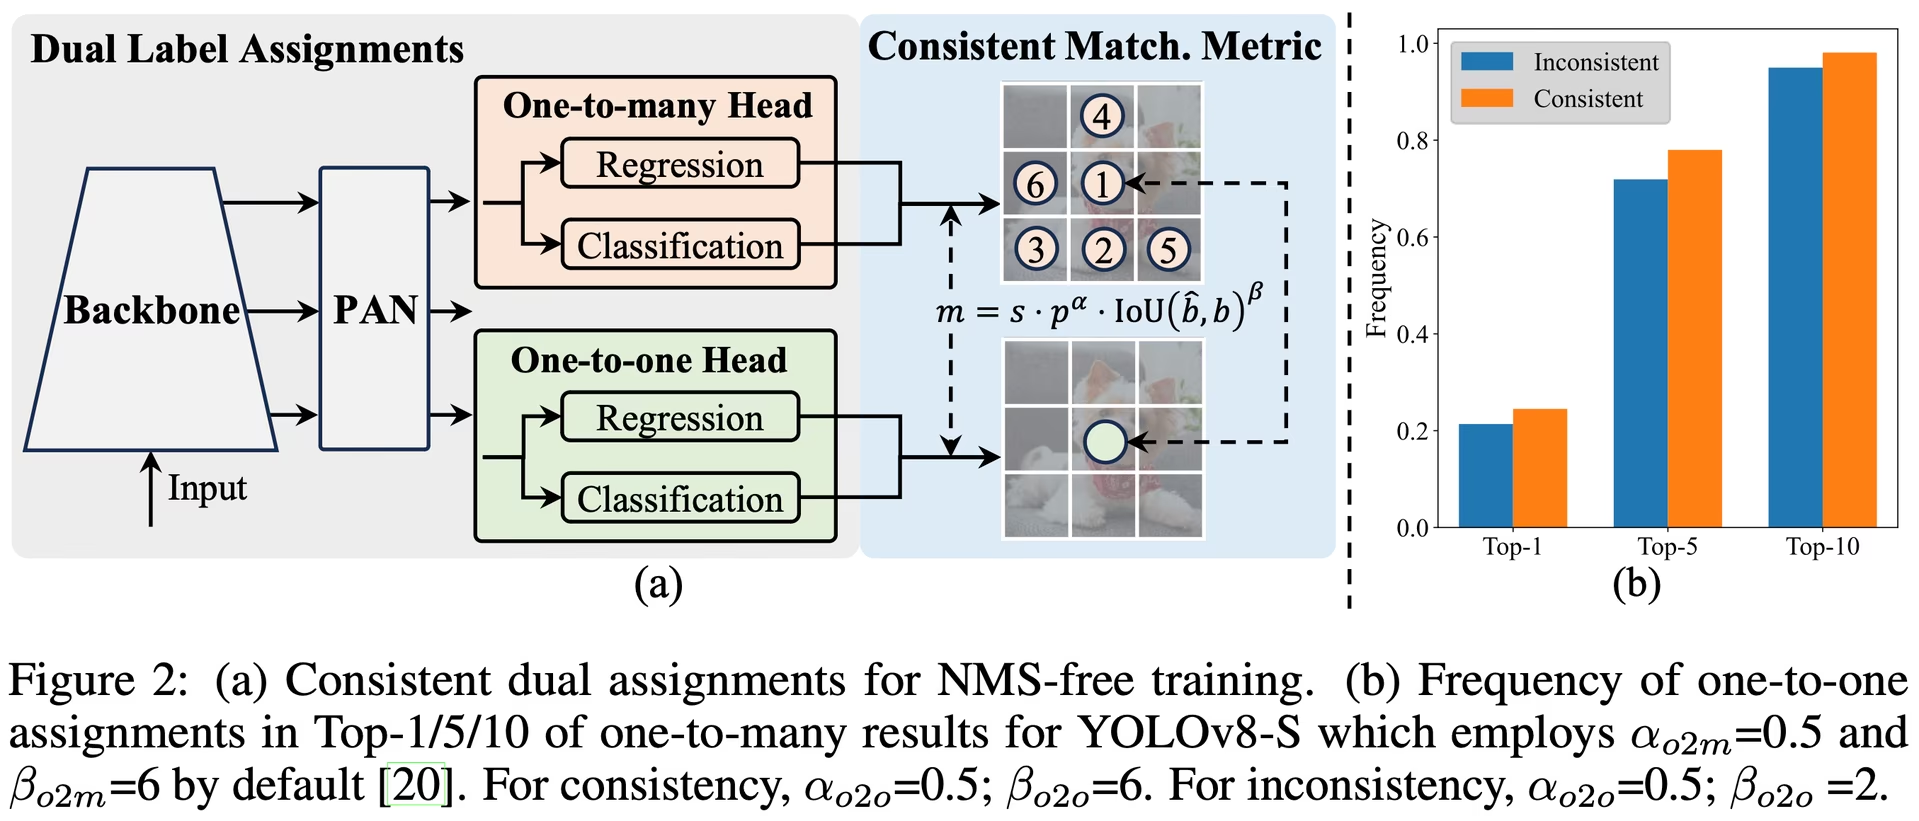
Il rilevamento di oggetti in tempo reale mira a prevedere con precisione le categorie e le posizioni degli oggetti nelle immagini, con bassa latenza. La serie YOLO è all’avanguardia in questa ricerca grazie all’equilibrio tra prestazioni ed efficienza. Tuttavia, la dipendenza da NMS e le inefficienze architetturali hanno ostacolato il raggiungimento delle prestazioni ottimali. YOLOv10 affronta questi problemi introducendo assegnazioni duali coerenti per l’addestramento senza NMS e una strategia olistica di progettazione dei modelli basata sull’equilibrio tra efficienza e precisione.
Architettura#
L'architettura di YOLOv10 si basa sui punti di forza dei precedenti modelli YOLO e introduce al contempo diverse innovazioni chiave. L'architettura del modello è composta dai seguenti elementi:
- Backbone: Il backbone di YOLOv10, responsabile dell'estrazione delle feature, usa una versione potenziata di CSPNet (Cross Stage Partial Network) per migliorare il flusso dei gradienti e ridurre la ridondanza computazionale.
- Neck: Il neck è progettato per aggregare feature provenienti da scale diverse e passarle alla head. Include livelli PAN (Path Aggregation Network) per una fusione efficace delle feature multiscala.
- Head one-to-many: Genera più previsioni per oggetto durante l'addestramento, fornendo segnali di supervisione ricchi e migliorando l'accuratezza dell'apprendimento.
- Testa one-to-one: genera un'unica previsione migliore per oggetto durante l'inferenza, eliminando così la necessità di NMS e riducendo la latenza e migliorando l'efficienza.
Funzionalità principali#
- Addestramento senza NMS: utilizza assegnazioni duali coerenti per eliminare la necessità di NMS, riducendo la latenza di inferenza.
- Progettazione olistica del modello: ottimizzazione completa di vari componenti dal punto di vista sia dell'efficienza sia dell'accuratezza, tra cui teste di classificazione leggere, downsampling con separazione spaziale e dei canali e progettazione dei blocchi guidata dal rango.
- Funzionalità del modello migliorate: integra convoluzioni con kernel di grandi dimensioni e moduli di autoattenzione parziale per migliorare le prestazioni senza costi computazionali significativi.
Varianti del modello#
YOLOv10 è disponibile in diverse dimensioni per adattarsi alle esigenze delle varie applicazioni:
- YOLOv10n: versione Nano per ambienti con risorse estremamente limitate.
- YOLOv10s: versione Small che bilancia velocità e accuratezza.
- YOLOv10m: versione Medium per uso generico.
- YOLOv10b: versione bilanciata, con larghezza aumentata per una maggiore accuratezza.
- YOLOv10l: versione Large per una maggiore accuratezza, a costo di un maggiore impiego di risorse computazionali.
- YOLOv10x: versione Extra-large per la massima accuratezza e prestazioni.
Prestazioni#
Al momento del rilascio, YOLOv10 superava le versioni precedenti di YOLO e altri modelli all’avanguardia in termini di precisione ed efficienza. Per esempio, YOLOv10s è 1,8 volte più veloce di RT-DETR-R18 con un AP simile sul dataset COCO, mentre YOLOv10b ha una latenza inferiore del 46% e il 25% di parametri in meno rispetto a YOLOv9-C, a parità di prestazioni.
Latenza misurata con TensorRT FP16 su GPU T4.
| Modello | Dimensione dell'input | APval50-95 | FLOPs (G) | Latenza (ms) |
|---|---|---|---|---|
| [YOLOv10n][1] | 640 | 38.5 | 6.7 | 1.84 |
| [YOLOv10s][2] | 640 | 46.3 | 21.6 | 2.49 |
| [YOLOv10m][3] | 640 | 51.1 | 59.1 | 4.74 |
| [YOLOv10b][4] | 640 | 52.5 | 92.0 | 5.74 |
| [YOLOv10l][5] | 640 | 53.2 | 120.3 | 7.28 |
| [YOLOv10x][6] | 640 | 54.4 | 160.4 | 10.70 |
Metodologia#
Assegnazioni duali coerenti per l'addestramento senza NMS#
YOLOv10 usa assegnazioni duali delle etichette, combinando le strategie one-to-many e one-to-one durante l’addestramento per garantire una supervisione ricca e una distribuzione end-to-end efficiente. Per impostazione predefinita, la predizione e la convalida di Ultralytics usano la testa one-to-many con NMS; imposta nms=False per selezionare la testa senza NMS. La metrica di corrispondenza coerente allinea la supervisione tra le due strategie, migliorando la qualità delle predizioni durante l’inferenza.
Progettazione olistica del modello basata sull’equilibrio tra efficienza e precisione#
Miglioramenti dell'efficienza#
- Testa di classificazione leggera: riduce il sovraccarico computazionale della testa di classificazione utilizzando convoluzioni separabili depth-wise.
- Downsampling con separazione spaziale e dei canali: separa la riduzione spaziale dalla modulazione dei canali per ridurre al minimo la perdita di informazioni e i costi computazionali.
- Progettazione dei blocchi guidata dal rango: adatta la progettazione dei blocchi in base alla ridondanza intrinseca degli stadi, garantendo un utilizzo ottimale dei parametri.
Miglioramenti dell'accuratezza#
- Convoluzione con kernel di grandi dimensioni: amplia il campo ricettivo per migliorare la capacità di estrazione delle caratteristiche.
- Self-attention parziale (PSA): integra moduli di self-attention per migliorare l'apprendimento di rappresentazioni globali con un sovraccarico minimo.
Esperimenti e risultati#
YOLOv10 è stato valutato su benchmark standard come COCO. Al momento del rilascio, tutte le varianti miglioravano il compromesso tra latenza e precisione rispetto alle versioni precedenti di YOLO e ad altri rilevatori contemporanei.
Confronti#
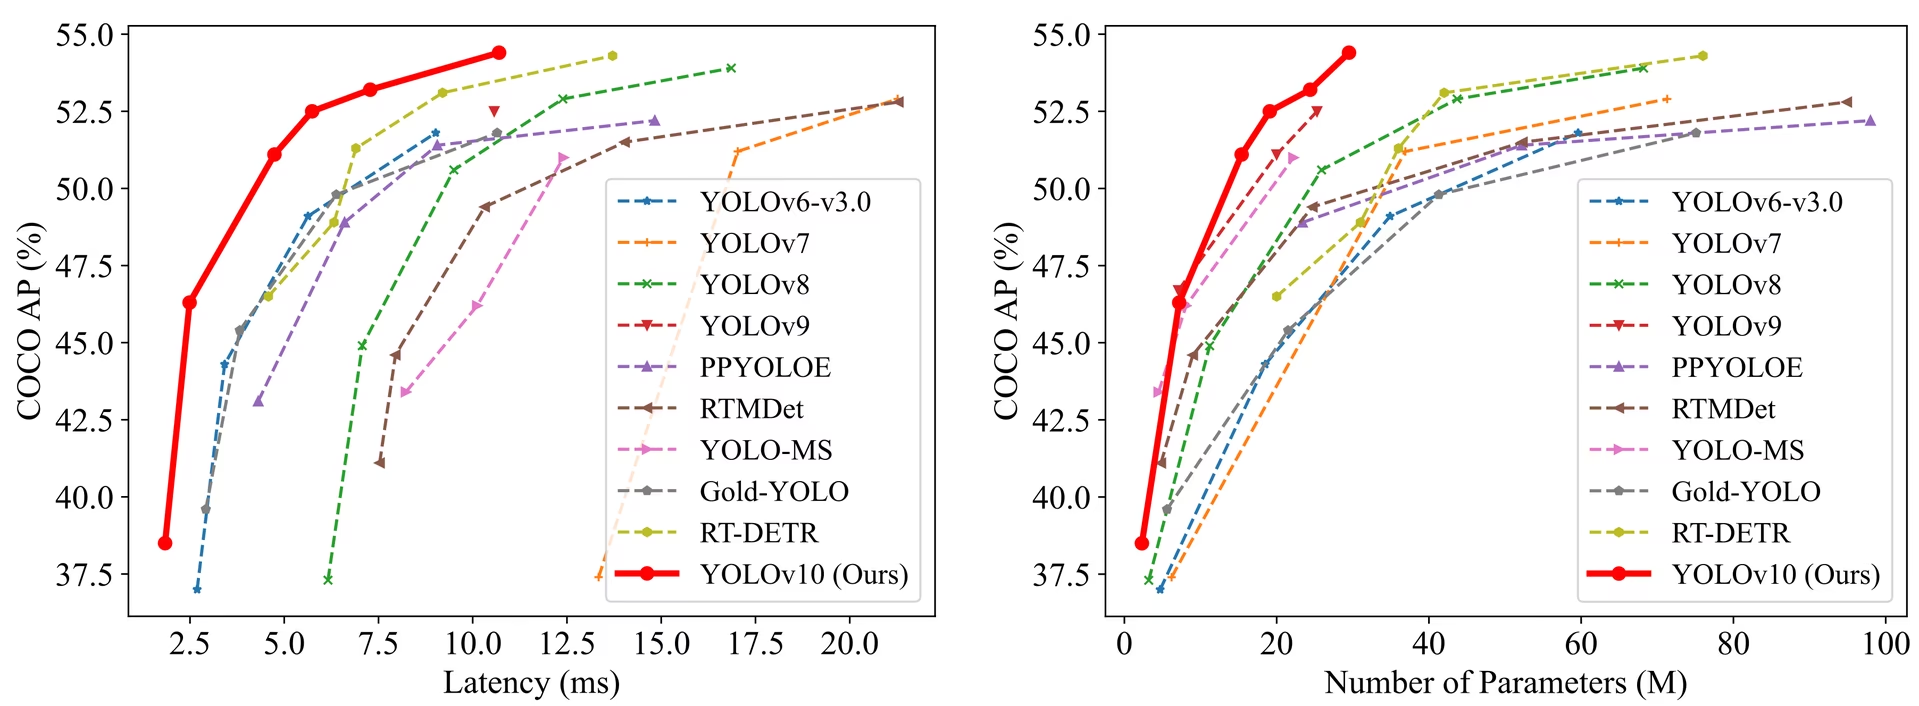
Rispetto ad altri rilevatori all'avanguardia:
- YOLOv10s / x sono 1,8× / 1,3× più veloci di RT-DETR-R18 / R101 con accuratezza simile
- YOLOv10b ha il 25% di parametri in meno e una latenza inferiore del 46% rispetto a YOLOv9-C, a parità di accuratezza
- YOLOv10l / x superano YOLOv8l / x di 0,3 AP / 0,5 AP con 1,8× / 2,3× parametri in meno
Le figure seguenti sono riportate nell'articolo di YOLOv10 e sono state misurate secondo il relativo protocollo; pertanto, non sono direttamente confrontabili con i valori riportati nelle pagine dei modelli Ultralytics:
| Modello | Parametri (M) | FLOPs (G) | mAPval50-95 | Latenza (ms) | Latenza-inferenza (ms) |
|---|---|---|---|---|---|
| YOLOv6-3.0-N | 4.7 | 11.4 | 37.0 | 2.69 | 1.76 |
| Gold-YOLO-N | 5.6 | 12.1 | 39.6 | 2.92 | 1.82 |
| YOLOv8n | 3.2 | 8.7 | 37.3 | 6.16 | 1.77 |
| YOLOv10n | 2.3 | 6.7 | 38.5 | 1.84 | 1.79 |
| YOLOv6-3.0-S | 18.5 | 45.3 | 44.3 | 3.42 | 2.35 |
| Gold-YOLO-S | 21.5 | 46.0 | 45.4 | 3.82 | 2.73 |
| YOLOv8s | 11.2 | 28.6 | 44.9 | 7.07 | 2.33 |
| YOLOv10s | 7.2 | 21.6 | 46.3 | 2.49 | 2.39 |
| RT-DETR-R18 | 20.0 | 60.0 | 46.5 | 4.58 | 4.49 |
| YOLOv6-3.0-M | 34.9 | 85.8 | 49.1 | 5.63 | 4.56 |
| Gold-YOLO-M | 41.3 | 87.5 | 49.8 | 6.38 | 5.45 |
| YOLOv8m | 25.9 | 78.9 | 50.6 | 9.50 | 5.09 |
| YOLOv10m | 15.4 | 59.1 | 51.1 | 4.74 | 4.63 |
| YOLOv6-3.0-L | 59.6 | 150.7 | 51.8 | 9.02 | 7.90 |
| Gold-YOLO-L | 75.1 | 151.7 | 51.8 | 10.65 | 9.78 |
| YOLOv8l | 43.7 | 165.2 | 52.9 | 12.39 | 8.06 |
| RT-DETR-R50 | 42.0 | 136.0 | 53.1 | 9.20 | 9.07 |
| YOLOv10l | 24.4 | 120.3 | 53.2 | 7.28 | 7.21 |
| YOLOv8x | 68.2 | 257.8 | 53.9 | 16.86 | 12.83 |
| RT-DETR-R101 | 76.0 | 259.0 | 54.3 | 13.71 | 13.58 |
| YOLOv10x | 29.5 | 160.4 | 54.4 | 10.70 | 10.60 |
I valori di parametri e FLOPs si riferiscono al modello fuso dopo model.fuse(), che unisce i livelli Conv e BatchNorm e rimuove la testa ausiliaria di rilevamento uno-a-molti. I checkpoint preaddestrati mantengono l'architettura di addestramento completa e possono mostrare valori più elevati.
Esempi d'uso#
Puoi anche addestrare i modelli su GPU cloud tramite Ultralytics Platform. Per eseguire previsioni su nuove immagini con YOLOv10:
from ultralytics import YOLO

# Carica un modello YOLOv10n preaddestrato
model = YOLO("yolov10n.pt")

# Esegui il rilevamento degli oggetti su un'immagine
results = model("image.jpg")

# Visualizza i risultati
results[0].show()
Per addestrare YOLOv10 su un dataset personalizzato:
from ultralytics import YOLO

# Carica il modello YOLOv10n da zero
model = YOLO("yolov10n.yaml")

# Addestra il modello
model.train(data="coco8.yaml", epochs=100, imgsz=640)
Attività e modalità supportate#
La serie di modelli YOLOv10 offre diversi modelli, ciascuno ottimizzato per il rilevamento di oggetti. Le varianti coprono diversi budget computazionali e requisiti di precisione.
| Modello | Nomi dei file | Attività | Addestramento | Validazione | Inferenza | Esporta |
|---|---|---|---|---|---|---|
| YOLOv10 | yolov10n.pt yolov10s.pt yolov10m.pt yolov10b.pt yolov10l.pt yolov10x.pt | Rilevamento di oggetti | ✅ | ✅ | ✅ | ✅ |
Esportazione di YOLOv10#
A causa delle nuove operazioni introdotte con YOLOv10, al momento non sono supportati tutti i formati di esportazione forniti da Ultralytics. La tabella seguente elenca i formati che Ultralytics è riuscita a convertire per YOLOv10. Sono benvenute le pull request che aggiungono il supporto all’esportazione per altri formati.
| Formato di esportazione | Supporto all'esportazione | Inferenza del modello esportato | Note |
|---|---|---|---|
| TorchScript | ✅ | ✅ | Formato standard per i modelli PyTorch. |
| ONNX | ✅ | ✅ | Ampio supporto per la distribuzione. |
| OpenVINO | ✅ | ✅ | Ottimizzato per l'hardware Intel. |
| TensorRT | ✅ | ✅ | Ottimizzato per le GPU NVIDIA. |
| CoreML | ✅ | ✅ | Limitato ai dispositivi Apple. |
| TF SavedModel | ✅ | ✅ | Formato standard per i modelli TensorFlow. |
| TF GraphDef | ✅ | ✅ | Formato TensorFlow legacy. |
| TF Edge TPU | ✅ | ✅ | Specifico per i dispositivi Edge TPU di Google. |
| LiteRT | ✅ | ✅ | Ottimizzato per dispositivi mobili, sistemi embedded e browser (LiteRT.js). |
| PaddlePaddle | ✅ | ✅ | Diffuso in Cina; supporto globale più limitato. |
| NCNN | ✅ | ✅ | Ottimizzato per dispositivi mobili e integrati. |
Conclusione#
Al momento del rilascio, YOLOv10 ha fatto progredire il rilevamento di oggetti in tempo reale eliminando la post-elaborazione NMS e riprogettando i componenti del modello per migliorarne efficienza e precisione. Il suo approccio senza NMS ha introdotto il rilevamento di oggetti end-to-end nella famiglia YOLO. YOLO26, il modello Ultralytics più recente, si basa su questo approccio con prestazioni migliorate e inferenza senza NMS.
Citazioni e ringraziamenti#
Desideriamo ringraziare gli autori di YOLOv10 della Tsinghua University per la loro approfondita ricerca e il contributo significativo al framework Ultralytics:
@inproceedings{wang2024yolov10,
  title={YOLOv10: Real-Time End-to-End Object Detection},
  author={Wang, Ao and Chen, Hui and Liu, Lihao and Chen, Kai and Lin, Zijia and Han, Jungong and Ding, Guiguang},
  booktitle={Advances in Neural Information Processing Systems},
  doi = {10.52202/079017-3429},
  url = {https://proceedings.neurips.cc/paper_files/paper/2024/file/c34ddd05eb089991f06f3c5dc36836e0-Paper-Conference.pdf},
  volume={37},
  pages={107984--108011},
  year={2024}
}
Per informazioni dettagliate sull'implementazione, le innovazioni architetturali e i risultati sperimentali, consulta l'articolo di ricerca su YOLOv10 e il repository GitHub del team della Tsinghua University.
Domande frequenti#
YOLOv10, sviluppato da ricercatori della Tsinghua University, introduce diverse innovazioni chiave nel rilevamento degli oggetti in tempo reale. Elimina la necessità della soppressione dei massimi non locali (NMS) impiegando assegnazioni doppie coerenti durante l'addestramento e ottimizza i componenti del modello per ridurre il sovraccarico computazionale.
Esegui l’inferenza con l’API Python di Ultralytics o l’interfaccia a riga di comando (CLI). Di seguito trovi alcuni esempi di predizione su nuove immagini con YOLOv10:
Esempiofrom ultralytics import YOLO # Carica il modello YOLOv10n preaddestrato model = YOLO("yolov10n.pt") results = model("image.jpg") results[0].show()Per altri esempi di utilizzo, visita la sezione Esempi di utilizzo.
YOLOv10 offre diverse varianti di modello per soddisfare differenti casi d'uso:
- YOLOv10n: adatto ad ambienti con risorse estremamente limitate
- YOLOv10s: bilancia velocità e precisione
- YOLOv10m: uso generico
- YOLOv10b: maggiore precisione con una larghezza aumentata
- YOLOv10l: elevata precisione a fronte di maggiori risorse di calcolo
- YOLOv10x: massima precisione e prestazioni
Ogni variante è progettata per esigenze di calcolo e requisiti di precisione diversi, risultando così versatile per numerose applicazioni. Consulta la sezione Varianti del modello per saperne di più.
YOLOv10 viene addestrato con assegnazioni duali coerenti, affinché la sua testa one-to-one produca una sola previsione ottimale per oggetto, eliminando così la necessità della soppressione dei massimi (NMS) durante l'inferenza. Per impostazione predefinita, la previsione e la convalida di Ultralytics usano la testa one-to-many con NMS; imposta
nms=Falseper selezionare la testa senza NMS e saltare il passaggio NMS. Per una spiegazione dettagliata, consulta la sezione Assegnazioni duali coerenti per l'addestramento senza NMS.YOLOv10 supporta diversi formati di esportazione, tra cui TorchScript, ONNX, OpenVINO e TensorRT. Tuttavia, a causa delle nuove operazioni del modello, al momento YOLOv10 non supporta tutti i formati di esportazione disponibili con Ultralytics. Per i dettagli sui formati supportati e le istruzioni per l'esportazione, visita la sezione Esportazione di YOLOv10.
Al momento del rilascio, YOLOv10 superava le versioni precedenti di YOLO e gli altri modelli all’avanguardia sia in precisione sia in efficienza. Per esempio, YOLOv10s è 1,8 volte più veloce di RT-DETR-R18 con un AP simile sul dataset COCO. YOLOv10b presenta una latenza inferiore del 46% e il 25% di parametri in meno rispetto a YOLOv9-C, a parità di prestazioni. Trovi benchmark dettagliati nella sezione Confronti.


Commenti188
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
 Glenn JocherUltralytics(modificato)
I'm super excited about the groundbreaking work on YOLOv10 by the researchers at Tsinghua University. Just a week ago, @pderrenger and I had the privilege of presenting YOLO to ML graduate students at Tsinghua University in Shenzhen, and I was thoroughly impressed by their enthusiasm and expertise.
Now, seeing the remarkable advancements in real-time object detection with YOLOv10, I'm thrilled to collaborate with the Tsinghua team to officially bring YOLOv10 support to the Ultralytics Python package soon. The innovative approach to NMS-free training and holistic model design optimizations demonstrates their commitment to pushing the boundaries of what's possible.
Stay tuned for the official release of YOLOv10 support in the Ultralytics package, and get ready to experience the incredible capabilities of this revolutionary real-time object detector!
38jameslahm
Thank you so much for your great support for YOLOv10! We are truly grateful for your efforts to bring YOLOv10 to the Ultralytics package. ❤️
2
heynewyeah
您好。如果我想在训练结束后,以last.pt的模型权重继续训练(因为还未收敛),有什么办法能获取last epoch的优化器状态吗,用于继续训练。或者有什么其他方法能够完成继续训练吗?
alephpi(modificato)
from ultralytics import YOLO

# Load a model
model = YOLO("path/to/last.pt")  # load a partially trained model

# Resume training
results = model.train(resume=True)
Anser1
Hello, I'm sorry to disturb you. I want to conduct the training for the segmentation task based on YOLOv10, but I found that there seems to be no YAML structure file for the segmentation model. What should I do?
zlj127
Does YOLOv10 have the pose function? Currently, I have only found a pre-trained model for gestures under the GitHub of the Hagrid dataset, but it is still used for detection.
- Glenn JocherUltralytics(modificato)
@zlj127 YOLOv10 currently focuses on object detection tasks and does not include built-in pose estimation functionality. For pose/keypoint estimation, we recommend using YOLO26 which offers integrated support for pose estimation along with detection, segmentation, and classification. See the YOLO26 Pose documentation for implementation details and code examples.
ok,thank you
- Glenn JocherUltralytics(modificato)
@zlj127 you're welcome! For pose estimation tasks, we recommend using YOLO26 which offers integrated support. Let us know if you need help getting started with the Pose documentation.
gniqeh
It is important to configure the correct threshold of dual label assignments in the paper. But how can we change the threshold in yolov10 of ultralytics module?
Es importante configurar el umbral correcto de asignaciones de etiquetas duales en el documento. pero ¿cómo podemos cambiar el umbral en yolov10 del módulo ultralytics?
- Glenn JocherUltralytics(modificato)
@gniqeh the dual label assignment settings are not exposed in the model YAML or as training arguments. They are set in the loss code (
E2EDetectLossinultralytics/utils/loss.py), where the one-to-many branch usestal_topk=10and the one-to-one branch usestal_topk=1. To change them, edit those values in a local copy of the package. For details, see the YOLOv10 Ultralytics documentation. Let us know if you need further clarification! Thx for your reply my friend, I have checked the documentation and API ref. of yolov10 but there is only the basical introductiong about it. And i am pleasure if u can provide further implementation explaining. Thanks again!
- Glenn JocherUltralytics
Thank you for your feedback! For a deeper understanding of YOLOv10 implementation, you can explore the specifics of its architecture and features in the YOLOv10 documentation. If you have particular aspects or technical details you'd like clarified, feel free to let us know!
Ly2003ykjy
Are YOLOV10 and 11 really superior to v7 and v8 in small target detection?
- Glenn JocherUltralytics
YOLOv10 and YOLO11 introduce innovations like NMS-free training, which can enhance small target detection performance compared to YOLOv7 and YOLOv8, but results may vary based on specific use cases and datasets.
abaldanz
Hello, do you plan to provide weights for the pre-trained model on 1280p size images?
- Glenn JocherUltralytics
@abaldanz thank you for your interest. Currently, we don't have plans to provide pre-trained weights specifically for 1280p images. For updates, please keep an eye on our repository and documentation.
Yuwenliula
请问一下,yolov10是否内置了IOU计算的功能,在val结果中未见到IOU的输出,如果没有的话,能方便提供代码进行IOU计算吗?
- Glenn JocherUltralytics
@Yuwenliula yOLOv10 does not directly output IoU in validation results. You can calculate IoU using the bounding box coordinates from the model's predictions. If you need further assistance, please refer to the Ultralytics documentation for guidance.
qruiwu
what is the each parameter mean in results.csv after training a model?
- Glenn JocherUltralytics
@wuqrcn the
results.csvfile contains metrics such as precision, recall, mAP, and loss values for each epoch during training. These metrics help evaluate the model's performance and convergence. For more details, please refer to the documentation.
alifazeli00
Why do the weights uploaded here: https://github.com/THU-MIG/yolov10?tab=readme-ov-file#performance not give the same results on the dataset as the weights uploaded on Ultralytics? I checked their architectures, and they seem to be identical.
- Glenn JocherUltralytics
@alifazeli00 the difference in results might be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
They are all the same except for the val_period parameter, which is only present in the THU-MIG model. However, the Ultralytics model performs better. I tested x and noticed differences in the weights. Are you saying that these two models should produce identical results?
- Glenn JocherUltralytics
The differences in results could be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
-1