Kaggleを使ってYOLO26モデルをトレーニングする方法
AIについて学びながら小規模なプロジェクトに取り組んでいる場合、まだ高性能なコンピューティングリソースを利用できないことがあり、高性能ハードウェアは高価です。Googleが所有するプラットフォームのKaggleは、GPUリソースの利用、大規模なデータセットの処理、多様なデータサイエンティストや機械学習愛好家とのコラボレーションができる、無料のクラウドベース環境を提供します。
Kaggleは、Ultralytics YOLO26モデルのトレーニングや実験に実用的な選択肢です。Kaggle Notebooksには、人気の機械学習ライブラリやフレームワークが事前インストールされています。このガイドでは、Kaggleの主な機能を紹介し、プラットフォーム上でYOLO26モデルをトレーニングする方法を説明します。
Kaggleとは何ですか?#
Kaggleは、世界中のデータサイエンティストが集まり、協力しながら学び、現実世界のデータサイエンスの課題解決を競うプラットフォームです。2010年にAnthony GoldbloomとJeremy Howardによって設立され、2017年にGoogleに買収されたKaggleでは、ユーザーは他のユーザーとつながり、データセットを見つけて共有し、GPU搭載のノートブックを使用し、データサイエンスコンペティションに参加できます。このプラットフォームは、経験豊富な専門家と学習者の両方を対象としています。
2022年時点で1,000万人以上のユーザーを擁するKaggleは、機械学習モデルの開発や実験に適した充実した環境を提供します。ローカルマシンのスペックやセットアップを気にする必要はありません。KaggleアカウントとWebブラウザーがあれば利用できます。
インストール#
KaggleでYOLO26モデルのトレーニングを始める前に、ノートブック環境が適切に設定されていることを確認してください。次の手順に従ってください。
インターネットアクセスを有効にする#
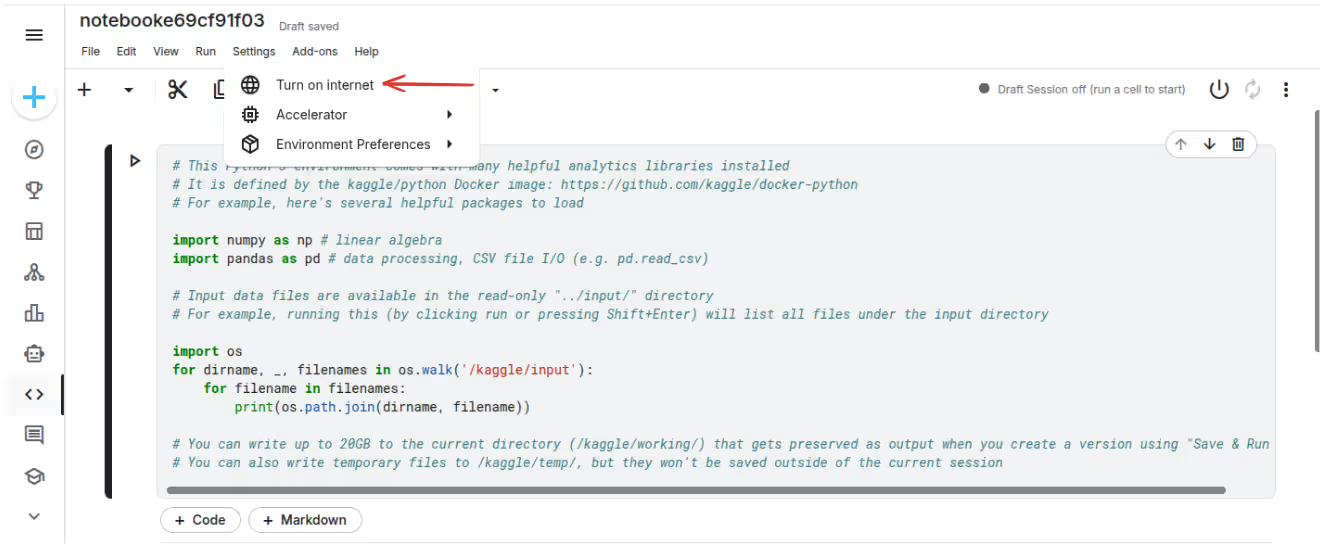
Kaggleノートブックでは、パッケージや依存関係をダウンロードするためにインターネットアクセスが必要です。Kaggleノートブックでインターネットを有効にする手順は次のとおりです。
- Kaggleノートブックを開きます。
- ノートブック画面の右側にあるSettingsパネルをクリックします。
- 下にスクロールしてInternetセクションを表示します。
- スイッチをONに切り替えてインターネット接続を有効にします。
注: Ultralyticsパッケージのインストールや、事前学習済みモデルまたはデータセットのダウンロードにはインターネット接続が必要です。インターネットを有効にしていないと、パッケージのインストールに失敗します。
Ultralyticsのインストール#
インターネットアクセスを有効にしたら、ノートブックのセルで次のコマンドを実行してUltralyticsパッケージをインストールします。
!pip install ultralytics最新の開発バージョンをインストールするには、GitHubから直接インストールできます。
!pip install git+https://github.com/ultralytics/ultralytics.git依存関係の競合を解決する#
インストール中に、特にopencv-python、numpy、torchなどのパッケージで依存関係の競合が発生することがあります。一般的な解決方法は次のとおりです。
方法 1: --upgradeを使って強制的に再インストールする#
既存のパッケージとの競合が発生した場合は、強制的にアップグレードします。
!pip install --upgrade --force-reinstall ultralytics方法2:インストール後にカーネルを再起動する#
インポートに関する問題を解決するため、インストール後にカーネルの再起動が必要になることがあります。
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menuよくあるエラーの解決方法#
エラー: "No module named 'ultralytics'"
- 解決方法: インターネットが有効になっていることを確認し、インストールコマンドをもう一度実行します。
- インストール後にカーネルを再起動します。
エラー: "ERROR: pip's dependency resolver does not currently take into account..."
- 解決方法: 通常は警告であり、安全に無視できます。このメッセージが表示されても、多くの場合インストールは正常に完了します。
エラー: インストール後に"ModuleNotFoundError"が発生する
- 解決方法: ノートブック画面の再起動ボタンを使ってカーネルを再起動します。
- 新しいセルでインポート文をもう一度実行します。
インストールを確認する#
インストール後、次のコマンドを実行してUltralyticsが正しくインストールされていることを確認します。
import ultralytics

ultralytics.checks()
システム情報が表示され、すべての依存関係が正しくインストールされていることを確認できます。
Kaggleを使ったYOLO26のトレーニング#
Kaggleの無料GPUを使えば、YOLO26モデルを簡単にトレーニングできます。
始めるには、KaggleのUltralytics YOLO26チュートリアルノートブックを開きます。Kaggleの環境には、TensorFlowやPyTorchなどのライブラリが事前インストールされているため、セットアップが簡単です。
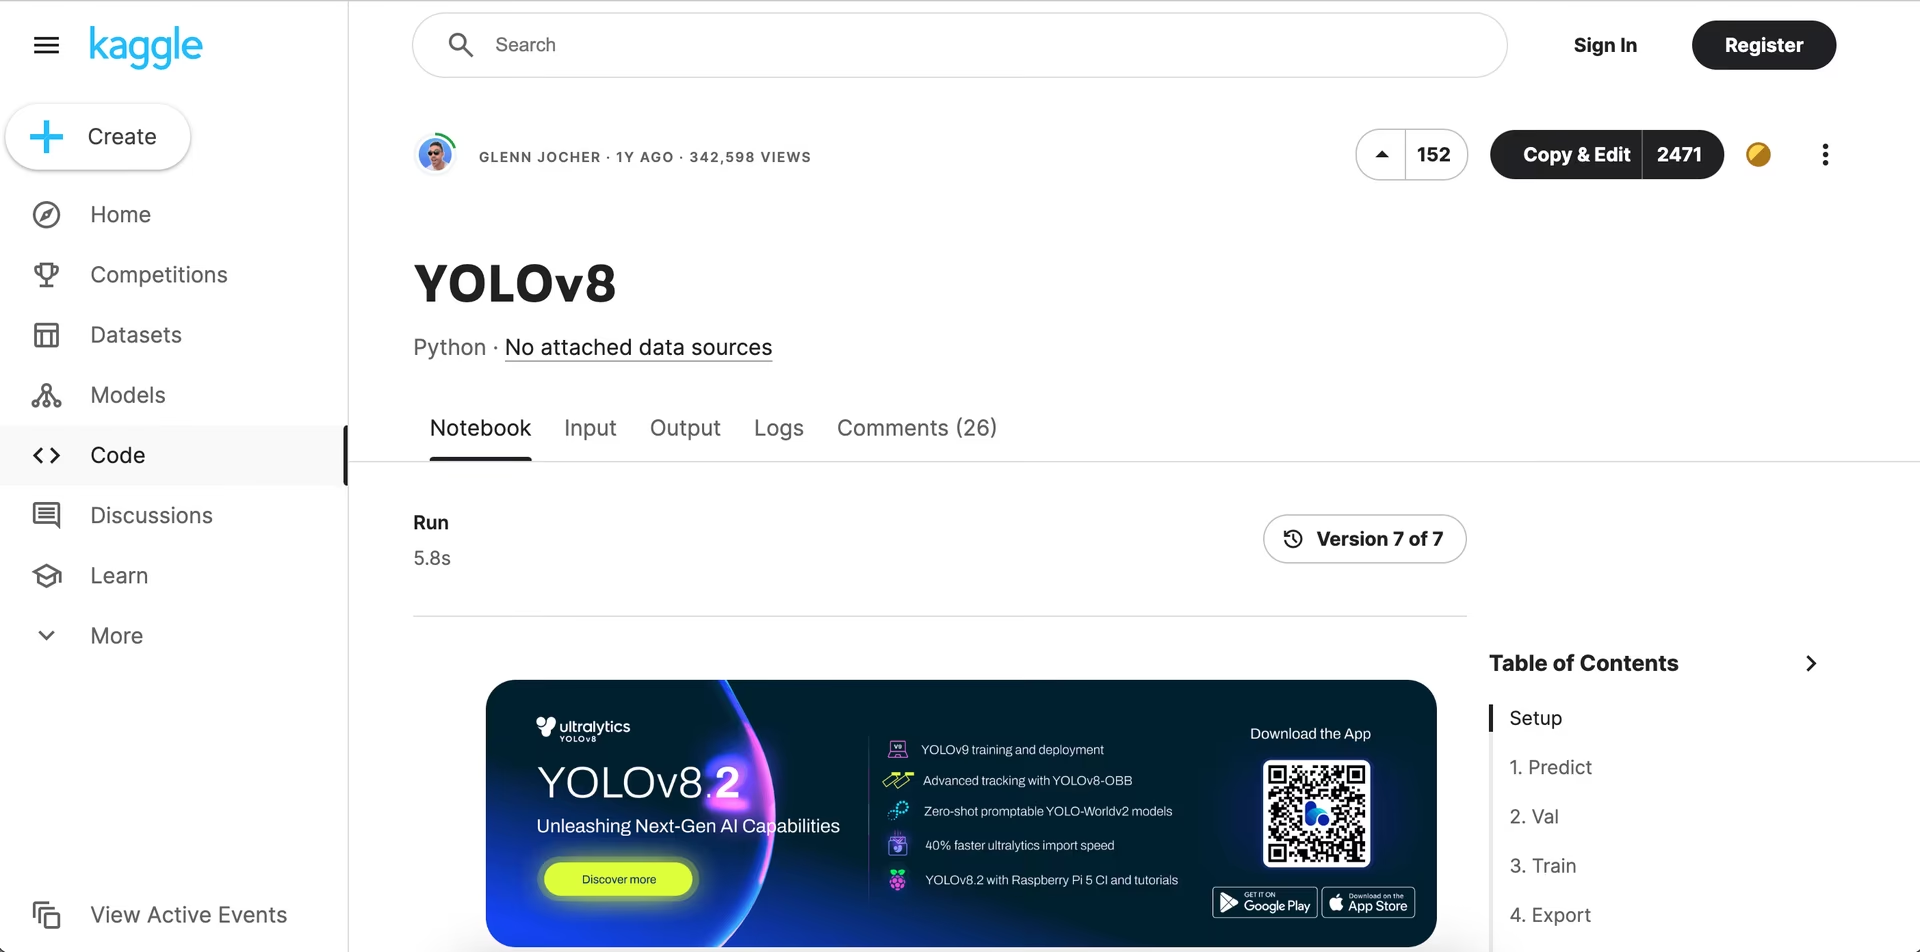
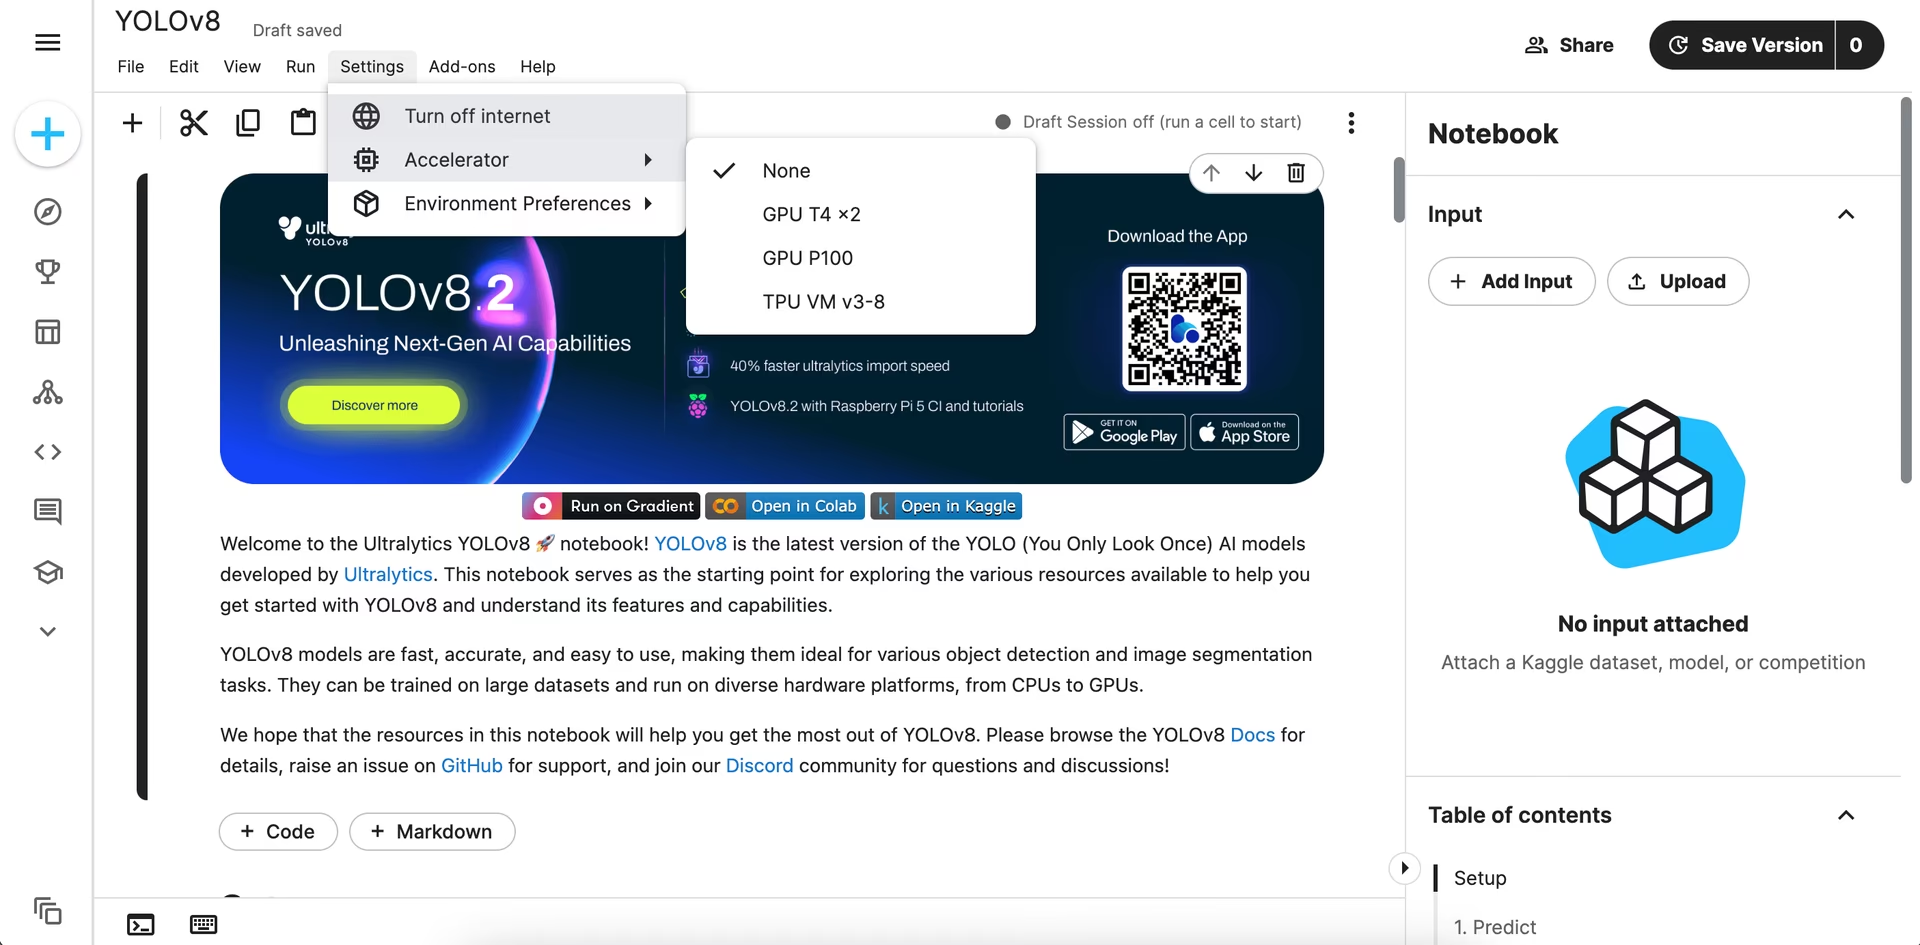
Kaggleアカウントにサインインすると、ノートブックが編集可能な自分用のコピーとして開きます。アクセラレーター設定でGPUを選択し、ノートブックのセルを実行してモデルのトレーニングを開始します。モデルのトレーニングプロセスとベストプラクティスについて詳しくは、YOLO26モデルのトレーニングガイドをご覧ください。
Kaggleの利用中によくある問題#
Kaggleを利用する際、よくある問題に遭遇する場合があります。プラットフォームをスムーズに利用するための重要なポイントを以下に示します。
- GPUの利用: Kaggleノートブックでは、いつでもGPUを有効にでき、週あたり最大30時間まで利用できます。Kaggleは、16GBのメモリを搭載したNVIDIA Tesla P100 GPUに加え、NVIDIA T4 x2オプションも提供しています。GPUアクセラレーションにより、モデルのトレーニングと推論が大幅に高速化します。
- Kaggleカーネル: Kaggleカーネルは、GPUを統合できる無料のJupyterノートブックサーバーで、クラウドコンピューター上で機械学習処理を実行できます。自分のコンピューターのCPUに頼る必要がないため、過負荷を避け、ローカルリソースを解放できます。
- Kaggleデータセット: Kaggleのデータセットは無料でダウンロードできます。ただし、使用上の制限を把握するため、各データセットのライセンスを確認することが重要です。学術出版物や商用利用に制限があるデータセットもあります。データセットはKaggleノートブックに直接ダウンロードするか、Kaggle APIを使って他の場所にダウンロードできます。
- ノートブックの保存とコミット: Kaggleでノートブックを保存してコミットするには、「バージョンを保存」をクリックします。これにより、ノートブックの現在の状態が保存されます。バックグラウンドカーネルによる出力ファイルの生成が完了すると、ノートブックのメインページにある「出力」タブからファイルにアクセスできます。
- コラボレーション: Kaggleはコラボレーションに対応していますが、複数のユーザーが同時にノートブックを編集することはできません。Kaggleでのコラボレーションは非同期で行われるため、ユーザーは異なる時間に同じノートブックを共有して作業できます。
- 以前のバージョンに戻す: ノートブックを以前のバージョンに戻すには、ノートブックを開き、右上にある縦の三点リーダーをクリックして「バージョンを表示」を選択します。戻したいバージョンを見つけ、その横にある「...」メニューをクリックして、「このバージョンに戻す」を選択します。ノートブックが以前の状態に戻ったら、「バージョンを保存」をクリックして変更をコミットします。
Kaggleの主な機能#
データサイエンスと機械学習向けにKaggleが提供する主な機能をいくつか紹介します。
- データセット: Kaggleは、さまざまなトピックのデータセットを多数ホストしています。これらのデータセットを検索してプロジェクトで利用できます。YOLO26モデルのトレーニングやテストに特に便利です。
- コンペティション: Kaggleのコンペティションでは、データサイエンティストや機械学習の実践者が現実世界の課題を解決します。参加することで、スキルを高め、新しい手法を学び、コミュニティ内で評価を得られます。
- TPUの無料利用: Kaggleは、対応フレームワーク向けにTPUへの無料アクセスを提供します。Ultralytics YOLO26のトレーニングはKaggleのGPUまたはCPUで実行され、TPUでは実行されません。
- GitHubとの統合: Kaggleでは、GitHubリポジトリを接続してノートブックをアップロードし、作業を保存できます。この統合により、ファイルを簡単に管理してアクセスできます。
- コミュニティとディスカッション: Kaggleには、データサイエンティストや機械学習の実践者から成る大規模なコミュニティがあります。ディスカッションフォーラムや共有ノートブックは、学習やトラブルシューティングに役立つリソースです。質問したり、知識を共有したり、他のユーザーと共同作業したりできます。
YOLO26プロジェクトにKaggleを使うべき理由#
機械学習モデルのトレーニングや評価に使用できるプラットフォームは複数あります。機械学習プロジェクトでKaggleを利用するメリットをいくつか紹介します。
- 公開ノートブック: Kaggleノートブックを公開すると、他のユーザーが作業を閲覧、評価、フォークして、議論できるようになります。Kaggleはコラボレーション、フィードバック、アイデアの共有を促進し、YOLO26モデルの改善に役立ちます。
- ノートブックのコミット履歴: Kaggleでは、ノートブックのコミット履歴が詳細に記録されます。時間の経過に伴う変更を確認、追跡できるため、プロジェクトの進展を把握しやすく、必要に応じて以前のバージョンに戻せます。
- コンソールへのアクセス: Kaggleはコンソールを提供しており、環境をより細かく制御できます。この機能を使うと、コマンドラインからさまざまなタスクを直接実行できます。
- リソースの利用可能性: Kaggleの各ノートブック編集セッションでは、CPUおよびGPUセッションに12時間、TPUセッションに9時間の実行時間と、自動保存される20ギガバイトのディスク容量が提供されます。
- ノートブックのスケジュール設定: Kaggleでは、ノートブックを指定した時刻に実行するようスケジュールできます。たとえば、一定間隔でモデルをトレーニングするなど、繰り返しのタスクを手動操作なしで自動化できます。
Kaggleについてさらに学ぶ#
Kaggleについて詳しく知りたい場合は、学習に役立つ次のリソースをご覧ください。
- Kaggle Learn: Kaggle Learnで、無料のインタラクティブなチュートリアルを幅広く利用できます。これらのコースでは、実践的な演習を通じてデータサイエンスの重要なトピックを学べます。
- Kaggle入門: コンペティションへの参加から最初のノートブックの作成まで、Kaggleの基本を順を追って説明します。
- KaggleのMediumページ: KaggleのMediumページで、チュートリアル、最新情報、コミュニティからの投稿をご覧ください。
- Kaggle統合を使用したUltralytics YOLOモデルのトレーニング: このブログ記事では、Ultralytics YOLOモデルにKaggleを活用する方法を紹介します。
概要#
Kaggleでは、YOLO26プロジェクトでモデルのトレーニングや評価にGPUを無料で利用でき、ライブラリも事前インストールされているため、すぐにセットアップできます。Ultralytics YOLO26とKaggleを組み合わせると、高価なハードウェアを使わずにコンピュータービジョンモデルを開発、トレーニング、デプロイできます。
詳しくは、Kaggleのドキュメントをご覧ください。
よくある質問#
KaggleにUltralytics YOLO26をインストールするには、次の手順を実行します。
- インターネットを有効化: 設定パネルを開き、「インターネット」の切り替えをオンにします
- パッケージをインストール: ノートブックのセルで
!pip install ultralyticsを実行します - インストールを確認:
import ultralytics; ultralytics.checks()を実行して確認します
依存関係の競合が発生した場合は、
!pip install --upgrade --force-reinstall ultralyticsを試すか、インストール後にカーネルを再起動してください。詳しいトラブルシューティングについては、上記のインストールのセクションをご覧ください。KaggleでYOLO26モデルをトレーニングするのは簡単です。まず、KaggleのUltralytics YOLO26チュートリアルノートブックを開きます。Kaggleアカウントにサインインし、アクセラレーター設定でGPUを選択します。ノートブックのセルを実行してトレーニングを開始します。詳しい手順については、YOLO26モデルのトレーニングガイドをご覧ください。
Kaggleを使ってYOLO26モデルをトレーニングすることには、いくつかのメリットがあります。
- GPUの無料利用: NVIDIA Tesla P100やT4 x2などのGPUを週あたり最大30時間まで利用できます。
- ライブラリの事前インストール: TensorFlowやPyTorchなどのライブラリがあらかじめインストールされているため、セットアップが簡単です。
- コミュニティとのコラボレーション: データサイエンティストや機械学習愛好家から成る大規模なコミュニティに参加できます。
- バージョン管理: ノートブックの異なるバージョンを管理し、必要に応じて以前のバージョンに戻せます。
よくある問題には、次のものがあります。
- GPUへのアクセス: ノートブックの設定でGPUを有効にしてください。Kaggleでは、GPUを週あたり最大30時間使用できます。
- インターネットが無効: パッケージをインストールする前に、設定パネルでインターネットを有効にしてください。
- 依存関係の競合:
!pip install --upgrade --force-reinstall ultralyticsを使用してください。 - データセットのライセンス: 使用上の制限を把握するため、各データセットのライセンスを確認してください。
- ノートブックの保存とコミット: 「バージョンを保存」をクリックしてノートブックの状態を保存し、「出力」タブから出力ファイルにアクセスします。
- コラボレーション: Kaggleは非同期のコラボレーションに対応していますが、複数のユーザーが同時にノートブックを編集することはできません。
その他のトラブルシューティングについては、インストールのセクションとよくある問題のガイドをご覧ください。
Kaggleには、Google Colabと異なる特徴がいくつかあります。
- 公開ノートブック: 作業をコミュニティと共有して、フィードバックやコラボレーションを得られます。
- 詳細な履歴: ノートブックのコミット履歴を詳しく確認して、時間の経過に伴う変更を追跡できます。
- リソースの利用可能性: 各ノートブックセッションでは、CPUおよびGPUセッションで12時間の実行時間を含む、豊富なリソースが提供されます。
以前のバージョンに戻すには、次の手順を実行します。
- ノートブックを開き、右上にある縦の三点リーダーをクリックします。
- 「バージョンを表示」を選択します。
- 戻したいバージョンを見つけ、その横にある「...」メニューをクリックして、「このバージョンに戻す」を選択します。
- 「バージョンを保存」をクリックして変更をコミットします。


コメント3
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?