Ultralytics Platform#
Ultralytics Platformは、データ準備からモデルのデプロイまで、MLワークフロー全体を効率化する包括的なエンドツーエンドのコンピュータービジョンプラットフォームです。インフラストラクチャの複雑さを伴わずに、本番環境ですぐに使えるコンピュータービジョンソリューションを必要とするチームや個人向けに構築されています。
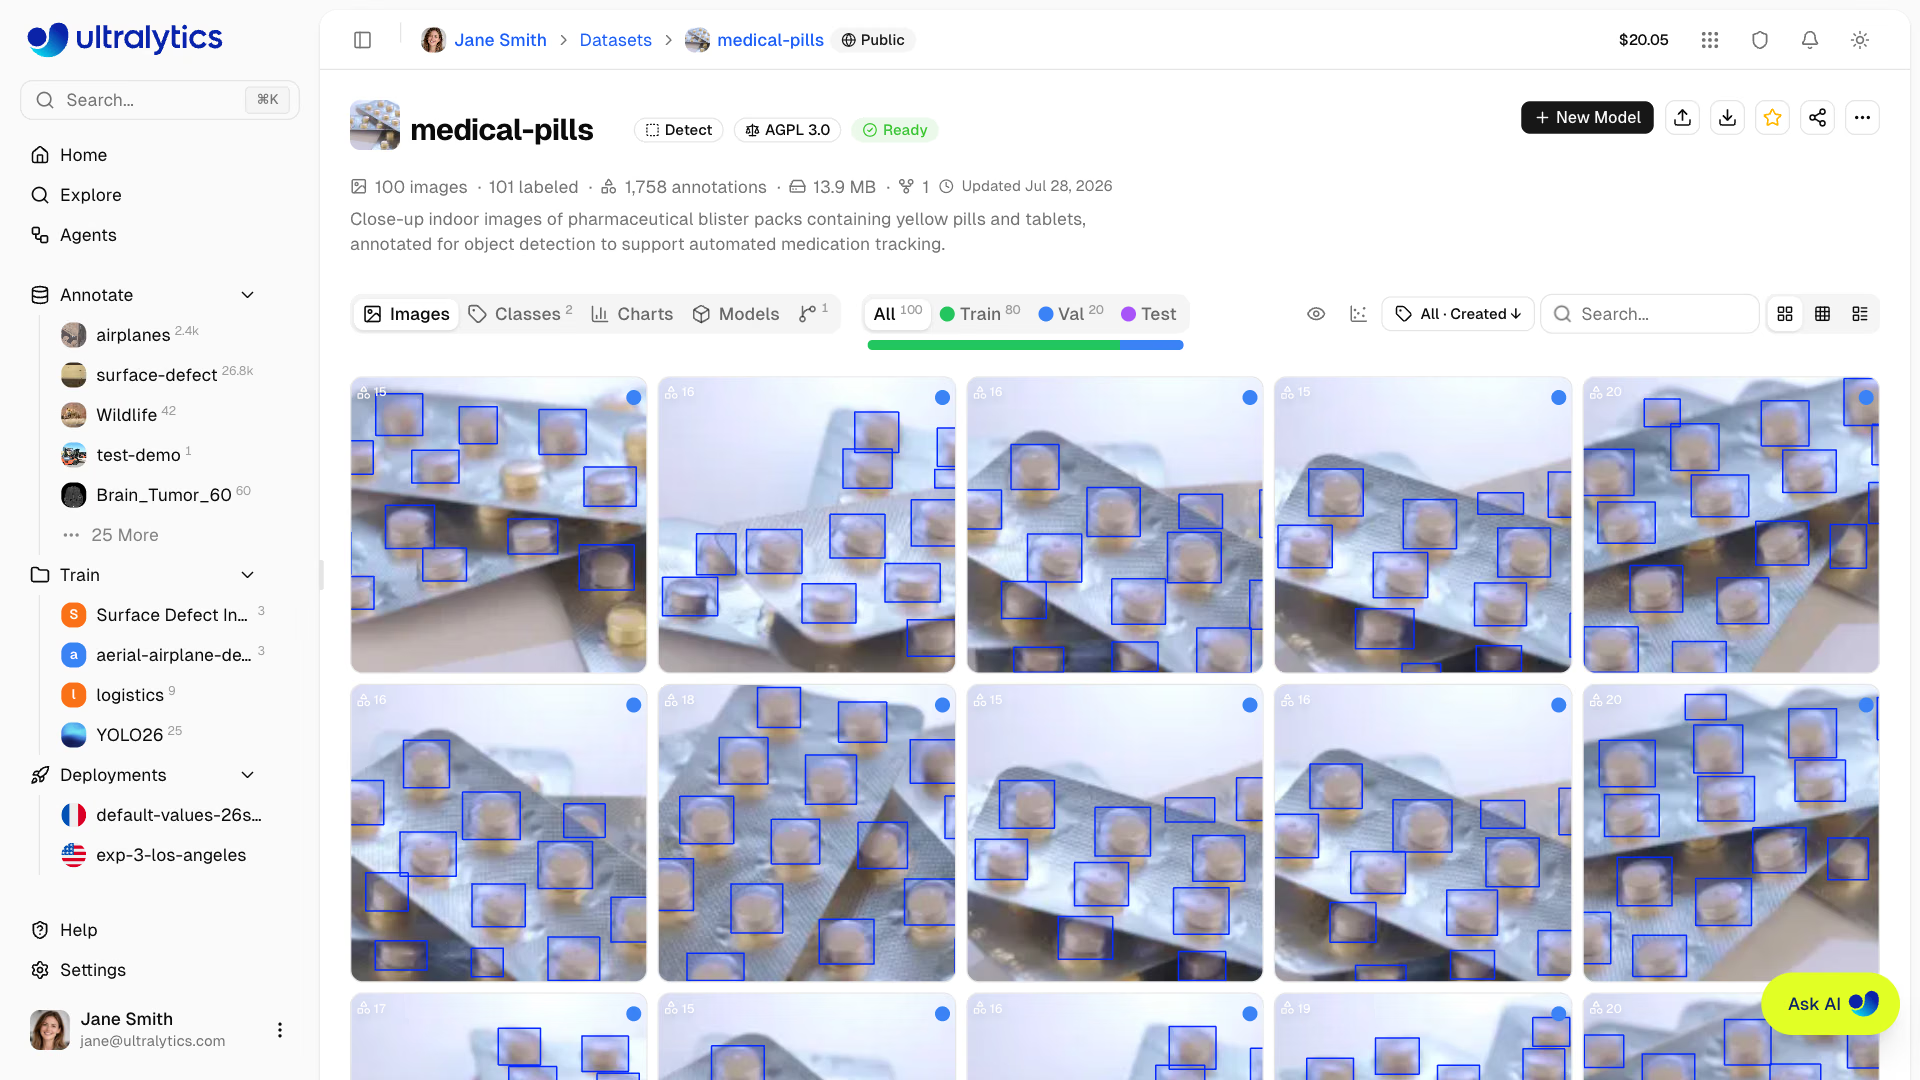
Ultralytics Platformとは何ですか?#
Ultralytics Platformは、データセット管理とアノテーション、実験追跡、クラウドおよびリモートトレーニング、モデルのエクスポート、専用推論エンドポイント、デプロイのモニタリングを1つのワークスペースに集約します。YOLO26、YOLO11、YOLOv8、YOLOv5モデルをネイティブサポートしています。
ワークフロー:アップロード → アノテーション → トレーニング → エクスポートまたはデプロイ#
Platformはエンドツーエンドのワークフローを提供します。
| ステージ | 機能 |
|---|---|
| アップロード | マシン、URL、クラウドストレージ、またはオンプレミスホストから、画像(50MB)、動画(1GB)、データセットファイル(ZIP、.tar.gz/.tgzを含むTAR、NDJSON)をアップロードできます。 |
| アノテーション | 6種類のタスクに対応する手動アノテーションツールに加えて、検出、セグメンテーション、セマンティック、OBBに対応するSAMモデルを使ったスマートアノテーション、これらのタスクとポーズに対応するYOLOモデル、または1~200クラスの検出データセットに対応するクラスプロンプト型モデル(ホスト型オープンソースモデルまたは有料プロバイダーモデル)を利用できます(対応タスクタイプをご覧ください)。 |
| トレーニング | クラウドGPU(全プランで24基、Pro/Enterprise限定でさらに2基:B200、B300)、リアルタイムメトリクス、プロジェクトの整理 |
| エクスポート | 22種類のデプロイ形式(ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascendなど。対応形式を参照してください) |
| デプロイ | 世界42地域の専用エンドポイント。デフォルトでスケールゼロ(アクティブなインスタンスは1つ)に対応し、モニタリング機能も利用できます。 |
できること:
- アップロード:画像、動画、データセットファイルをアップロードして、トレーニング用データセットを作成します
- 可視化:アノテーションエディターがサポートする6種類のYOLOタスクタイプについて、インタラクティブなオーバーレイでアノテーションを表示します(対応タスクタイプをご覧ください)
- トレーニング:クラウドGPU(全プランで24基、B200およびB300に対応するProまたはEnterpriseでは26基)でモデルをトレーニングし、リアルタイムメトリクスを確認できます
- 22種類のデプロイ形式にエクスポートします(ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascendなど)。
- デプロイ:ワンクリックで専用エンドポイントを世界42地域にデプロイできます
- モデル、条件、データセット収集、Slackアラート、Webhookを連携するAgentsワークフローを構築できます
- モニタリング:トレーニングの進捗、デプロイの健全性、使用状況のメトリクスを監視します
- 接続:クラウドストレージ、アノテーションツール、Slackを連携機能で接続します
- コラボレーション:プロジェクトやデータセットをコミュニティに公開して共同作業できます
マルチリージョンインフラストラクチャ#
データは選択したリージョン内に保持されます。Ultralytics Platformは世界3か所のリージョンでインフラストラクチャを運用しています。
| リージョン | ラベル | 場所 | 最適な用途 |
|---|---|---|---|
| US | 南北アメリカ | 米国アイオワ州 | 南北アメリカのユーザー向け。南北アメリカで最速 |
| EU | ヨーロッパ、中東、アフリカ | ヨーロッパ、ベルギー | ヨーロッパのユーザー向け。GDPRに準拠 |
| AP | アジア太平洋 | アジア太平洋、台湾 | アジア太平洋のユーザー向け。APACで最小のレイテンシ |
オンボーディング中にデータリージョンを選択します。データセット、モデル、管理対象のトレーニングデータは選択したリージョン内に保持されます。 専用エンドポイントは、グローバルデプロイマップから選択したリージョンに個別にデプロイされます。
アカウント作成後、ご自身でデータリージョンを変更することはできません。オンボーディング中に、Platformが各リージョンへのレイテンシを測定し、最も近いリージョンを推奨します。後からリージョンの変更を希望する場合は、サポートにお問い合わせください。これはデータセットとモデルのコンテンツに適用されます。プロフィール、請求、アクティビティの記録などのアカウントレベルのデータは、プライバシーポリシーおよびデータ処理契約に記載されているとおり、グローバルに処理されます。
主な機能#
データ準備#
- データセット管理:ローカルファイル、URL、接続済みのクラウドストレージ、またはオンプレミスホストから、処理を自動化してデータセットを作成できます
- アノテーションエディター:6種類のYOLOタスクタイプ(検出、セグメンテーション、セマンティック、分類、ポーズ、OBB)に対応する手動アノテーションツール(対応タスクタイプをご覧ください)
- スケルトンテンプレート:ポーズアノテーションをワンクリックで行える組み込みテンプレート(人物、手、犬、顔、ボックス)とカスタムスケルトンテンプレート
- スマートアノテーション:アノテーションツールバーから SAM 2.1(Tiny、Small、Base、Large)、SAM 3、または SAM 3.1(デフォルト)を使用して、検出、セグメンテーション、セマンティック、OBBタスクに対応できます。これらのタスクとポーズには、事前学習済みUltralytics YOLOモデルや独自にファインチューニングしたYOLOモデルも利用できます。1~200クラスの検出データセットでは、クラスプロンプト型モデル(ホスト型オープンソースモデル6種(デフォルトはMoondream 3.1)、ホスト型テキストプロンプト対応SAM 3およびSAM 3.1)、またはSettings > API Keysでプロバイダーキーを設定して利用するOpenAI、Anthropic、Google、Meta、SpaceXAI、DeepSeek、Z.ai、Kimi、Xiaomi MiMoの有料ビジョンモデルを使用できます。
- データセットのバージョン管理:説明を付けて番号付きのNDJSONスナップショットを作成し、再現性の高いトレーニングのために任意のバージョンをダウンロードまたは復元できます
- 統計情報:クラス分布、データ分割の分布、位置ヒートマップ、バウンディングボックスの寸法分析
モデルのトレーニング#
- クラウドトレーニング:クラウドGPU(全プランで24基、B200およびB300に対応するProまたはEnterpriseでは26基)でトレーニングできます。リアルタイムメトリクスと現在の費用見積もりも利用できます
- リモートトレーニング:任意の場所でトレーニングし、メトリクスをUltralytics Platformにストリーミングできます
- 詳細設定:トレーニングダイアログ内の組み込みYAMLエディターから、任意のUltralyticsトレーニング引数を上書きできます
- プロジェクトの整理:関連するモデルをグループ化し、実験を比較して、アクティビティを追跡できます
- 22種類のエクスポート形式:ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascendなど(対応形式を参照してください)
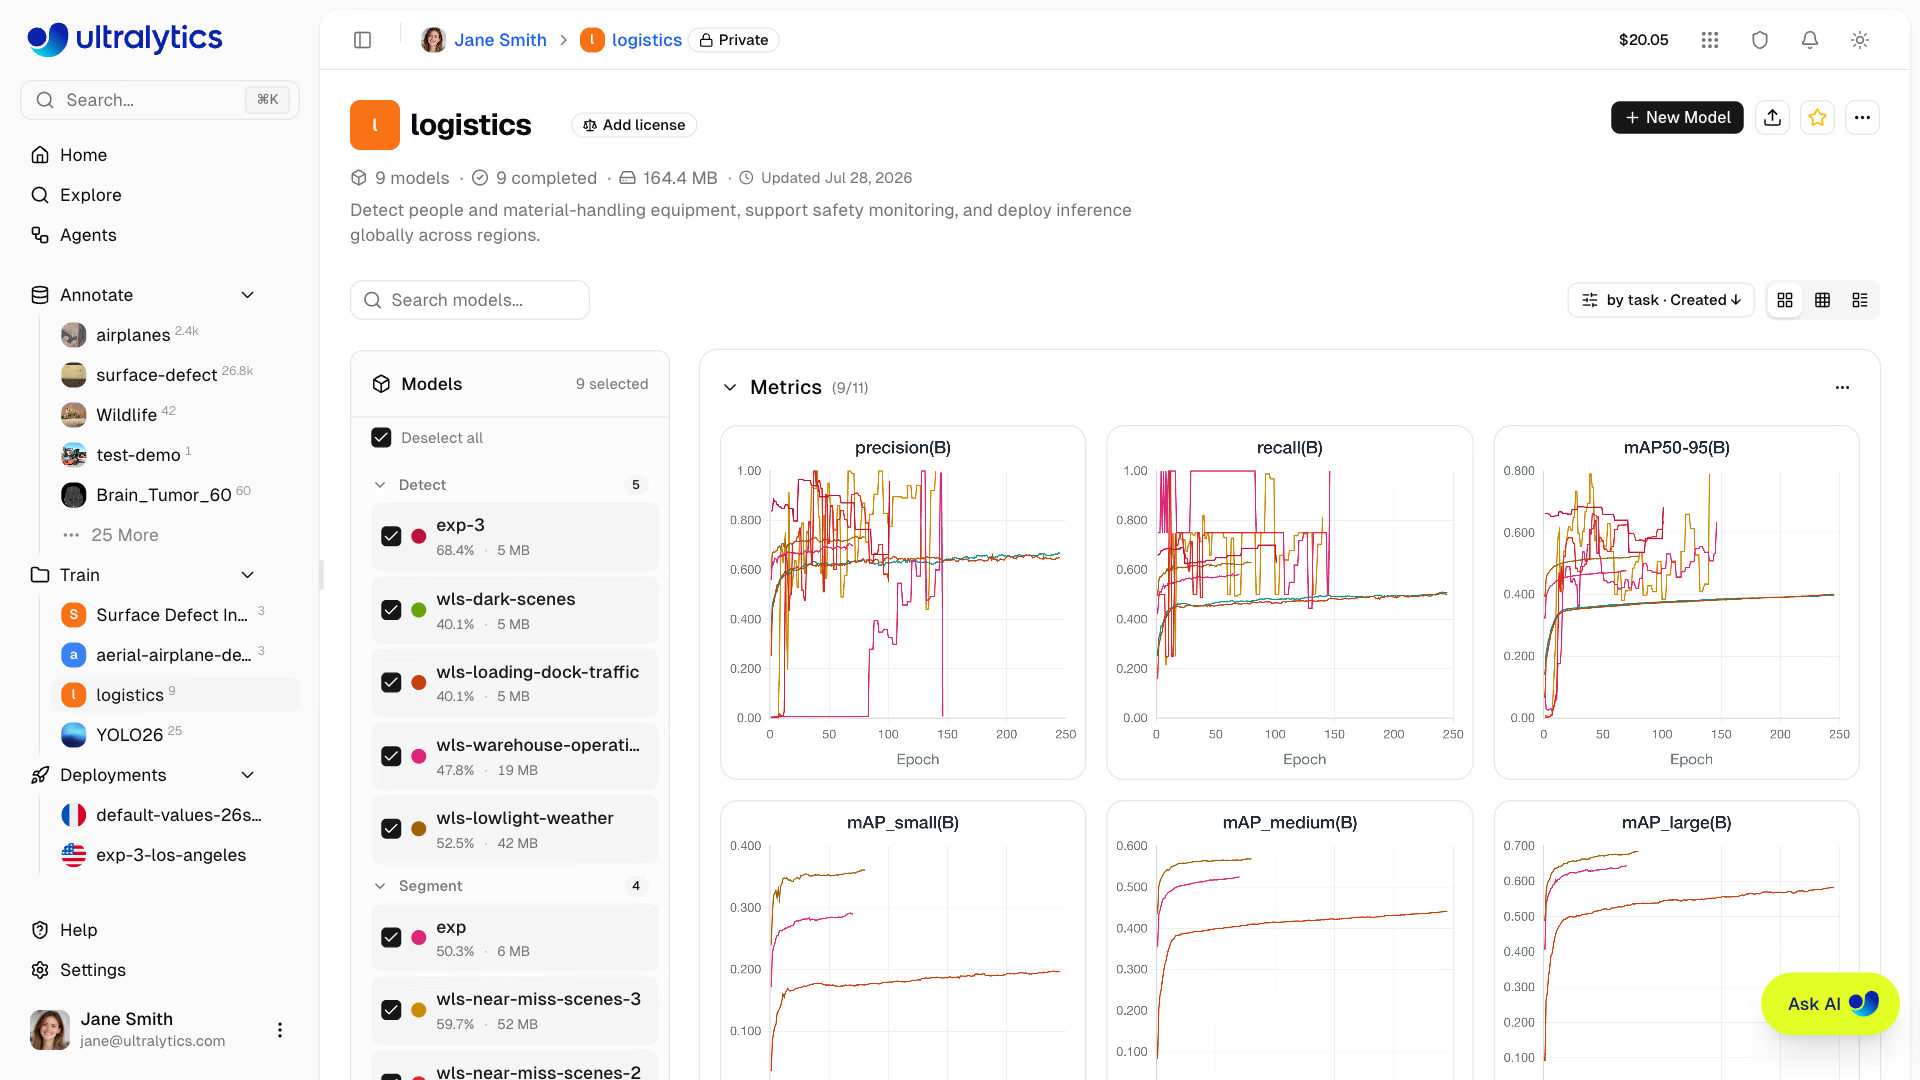
モデルはWeb UI(クラウドトレーニング)またはご自身のマシン(リモートトレーニング)からトレーニングできます。
- プロジェクトに移動します
New Modelをクリックします- データセット、モデル、GPU、エポック数を選択します
- 損失曲線とメトリクスをリアルタイムで確認します
デプロイ#
- 推論テスト:独自の画像、ウェブカメラのキャプチャ、または組み込みサンプルを使用して、ブラウザー上で直接モデルをテストできます
- 専用エンドポイント:デフォルトでスケールゼロ(アクティブなインスタンスは1つ)に設定し、世界42地域にデプロイできます
- モニタリング: リアルタイムのメトリクス、リクエストログ、パフォーマンスダッシュボード
デプロイ後は、任意の言語からエンドポイントを呼び出せます。conf、iou、imgszは省略可能なフォームフィールドで、デフォルト値は 0.25、0.7、およびモデルのトレーニング時の画像サイズ(取得できない場合は640)です。
import requests

url = "https://your-deployment-url.run.app/predict"
api_key = "YOUR_API_KEY"
args = {"conf": 0.25, "iou": 0.7, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(
        url,
        headers={"Authorization": f"Bearer {api_key}"},
        data=args,
        files={"file": f},
    )

print(response.json())アカウント管理#
- チームと組織: チームメンバーと共同作業し、ロールや招待を管理できます。また、アカウントメニューからワークスペースを切り替えられます
- APIキー: リモートトレーニングとAPIアクセスに使用するキーを安全に管理できます
- クレジットと請求: 透明性の高い料金体系で、従量課金制のトレーニングを利用できます。5~1,000ドルの範囲でチャージできます
- アクティビティフィード: アカウント内のすべてのイベントと操作を追跡できます
- ゴミ箱と復元: 30日間の論理削除とアイテムの復元に対応しています
- GDPRへの準拠: データのエクスポートとアカウントの削除に対応しています
現在の制限、GPUアクセス、コラボレーション、ライセンスについては、Free、Pro、Enterpriseの正式な比較をご覧ください。
クイックリンク#
以下のリソースから始めましょう:
- クイックスタート: 最初のプロジェクトを作成し、数分でモデルをトレーニングできます
- 探索: 公開データセットやプロジェクトを閲覧・クローンし、画像に何が写っているかで検索できます
- データ: データセットの準備についての概要
- データセット: トレーニングデータをアップロードして管理できます
- アノテーション: 手動ツールやAI支援ツールでデータにラベルを付けられます
- トレーニング: トレーニングの概要
- プロジェクト: モデルや実験を整理できます
- モデル: モデルのページ、ダウンロード、エクスポート
- クラウドトレーニング: クラウドGPUでトレーニングできます
- デプロイ: デプロイの概要
- 推論: モデルをテストできます
- エンドポイント: モデルを本番環境にデプロイできます
- モニタリング: デプロイのパフォーマンスを追跡できます
- アカウント: アカウントの概要
- 設定: プロフィールとワークスペースの設定
- チーム: メンバー、ロール、招待
- APIキー: APIアクセスを管理できます
- 請求: クレジットと支払い
- アクティビティ: アカウントのイベントを追跡できます
- ゴミ箱: 削除したアイテムを復元できます
- インテグレーション: クラウドストレージ、アノテーションツール、Slack
- REST API: APIリファレンス
トラブルシューティング#
データセットの問題#
| 問題 | ソリューション |
|---|---|
| データセットを処理できない | ファイル形式がサポートされていることを確認してください(画像形式: JPEG、PNG、WebP、TIFF、HEIC、AVIF、BMP、JP2、DNG、MPO)。ファイルサイズの上限: 画像は50 MB、動画は1 GB、データセットアーカイブはFreeで10 GB / Proで20 GB / Enterpriseで50 GB |
| アノテーションが見つからない | ラベルがYOLO形式で、画像ファイル名に対応する.txtファイルがあることを確認するか、COCO JSONをアップロードしてください |
| 「Train splitが必要です」 | データセットの構成にtrain/フォルダーを追加するか、分割バーを使って分割を再配分してください |
| クラス名が定義されていない | names: リストを含む data.yaml ファイルを追加(YOLO形式を参照)するか、「クラス」タブでクラスを定義します。 |
トレーニングの問題#
| 問題 | ソリューション |
|---|---|
| トレーニングを開始できない | [設定] > [請求]でクレジット残高を確認してください。残高がプラスである必要があります |
| メモリ不足エラー | バッチサイズを小さくする、小型モデル(n/s)を使用する、またはVRAM容量の大きいGPUを選択してください |
| メトリクスが低い | データセットの品質を確認し、エポック数を増やし、データ拡張を試し、クラスのバランスを確認してください |
| トレーニングが遅い | より高速なGPUを選択する、画像サイズを小さくする、データセットがボトルネックになっていないか確認してください |
デプロイの問題#
| 問題 | ソリューション |
|---|---|
| エンドポイントが応答しない | エンドポイントのステータス(ReadyまたはStopped)を確認してください。アイドル状態からのコールドスタートでは、最初のリクエストに最大1分かかることがあります |
| 401 Unauthorized | APIキーが有効で、正しくコピーされていることを確認してください |
| 推論が遅い | モデルサイズを確認し、TensorRTエクスポートを検討して、より近いリージョンを選択してください |
| エクスポートに失敗した | 一部の形式では、特定のモデルアーキテクチャが必要です。幅広い互換性が必要な場合はONNXをお試しください |
よくある質問#
登録後にユーザー名を変更できますか?
いいえ。ユーザー名は固定されており、変更できません。登録時に慎重に選択してください。
データリージョンを変更できますか?
データリージョンはオンボーディング時に選択するもので、ご自身では変更できません。リージョンを切り替える場合は、サポートに連絡して変更を依頼してください。
クレジットを追加するにはどうすればよいですか?
設定 > 請求に移動し、チャージをクリックしてください。5~1,000ドル分のクレジットを購入できます。購入したクレジットに 有効期限はありません。
トレーニングに失敗するとどうなりますか?
クラウドコンピューティングが開始されていた場合、経過したGPU時間分の料金が発生します。GPUの起動前に失敗した場合、コンピューティング料金は 発生しません。
トレーニング済みモデルをダウンロードできますか?
はい。モデルページのダウンロードアイコンをクリックすると、.ptウェイトをダウンロードできます。または、エクスポートタブを開くと、エクスポートが完了した形式を確認できます。
作業を公開して共有するにはどうすればよいですか?
プロジェクトまたはデータセットを開き、上部のナビゲーションバーにある非公開バッジをクリックして、公開するを確定してください。 公開コンテンツはExploreページに表示されます。
ファイルサイズの上限はいくつですか?
画像: 50MB、動画: 1GB、データセット: Freeでは10GB、Proでは20GB、Enterpriseでは50GBです。これより大きなファイルは、複数回に分けてアップロードしてください。
削除したアイテムはゴミ箱にどのくらい保管されますか?
30日間です。その後、アイテムは完全に削除され、復元できなくなります。
Platformのモデルを商用利用できますか?
FreeおよびProプランではAGPLライセンスが適用されます。AGPLの要件なしで商用利用する場合は、Ultralyticsのライセンスをご覧ください。
よくある質問#
Ultralytics Platformを始めるには:
- サインアップ: platform.ultralytics.comでアカウントを作成します
- リージョンを選択: オンボーディング時にデータリージョン(US、EU、またはAP)を選択します
- データセットをアップロード: サイドバーで
Annotateを開き、データをアップロードします - モデルをトレーニング: プロジェクトを作成し、クラウドGPUでトレーニングを開始します
- デプロイ: モデルをテストし、専用エンドポイントにデプロイします
詳しい手順については、クイックスタートページをご覧ください。
Ultralytics Platformでは、次の機能を利用できます:
- 統合ワークフロー: データ、トレーニング、デプロイを1か所で管理できます
- マルチリージョン: 米国、EU、APリージョンでデータを保管できます
- ノーコードトレーニング: コードを記述せずに高度なYOLOモデルをトレーニングできます
- リアルタイムメトリクス: トレーニングの進捗をストリーミングし、デプロイをモニタリングできます
- 42のデプロイリージョン: 世界中のユーザーに近い場所にモデルをデプロイできます
- 7種類のタスク: 検出、インスタンスセグメンテーション、セマンティックセグメンテーション、深度推定、分類、姿勢推定、OBBに対応しています(タスクのドキュメントを参照)
- AI支援アノテーション: SAM、YOLO、クラスプロンプト対応モデルを使ったスマートアノテーション(1~200クラスの検出データセットに対応)で、データ準備を効率化できます
Ultralytics Platformは、クラウドトレーニング向けに複数のGPUタイプをサポートしています。
GPU 世代 VRAM 時間あたりのコスト 最適な用途 RTX 2000 Ada Ada 16 GB $0.24 小規模データセット、テスト RTX A4500 Ampere 20 GB $0.25 小~中規模のデータセット RTX 4000 Ada Ada 20 GB $0.26 中規模のデータセット RTX A5000 Ampere 24 GB $0.27 中規模のデータセット L4 Ada 24 GB $0.39 推論に最適化 A40 Ampere 48 GB $0.44 大きなバッチサイズ RTX 3090 Ampere 24 GB $0.46 一般的なトレーニング RTX A6000 Ampere 48 GB $0.49 大規模モデル RTX PRO 4000 Blackwell 24 GB $0.57 低予算向けBlackwell RTX PRO 4500 Blackwell 32 GB $0.64 価格性能比に優れる RTX 4090 Ada 24 GB $0.69 最高の価格性能比 RTX 6000 Ada Ada 48 GB $0.77 大きなバッチでのトレーニング L40S Ada 48 GB $0.86 大きなバッチでのトレーニング RTX PRO 5000 Blackwell 48 GB $0.96 大きなバッチでのトレーニング RTX 5090 Blackwell 32 GB $0.99 最新のコンシューマー向け世代 L40 Ada 48 GB $0.99 大規模モデル A100 PCIe Ampere 80 GB $1.39 本番環境向けトレーニング A100 SXM Ampere 80 GB $1.49 本番環境向けトレーニング RTX PRO 6000 Blackwell 96 GB $2.09 推奨デフォルト H100 PCIe Hopper 80 GB $2.89 高性能トレーニング H100 NVL Hopper 94 GB $3.19 最大限のパフォーマンス H100 SXM Hopper 80 GB $3.29 最速のトレーニング H200 NVL Hopper 143 GB $3.39 最大メモリ H200 SXM Hopper 141 GB $4.39 最大限のパフォーマンス B200 Blackwell 180 GB $5.89 大規模モデル(Pro+) B300 Blackwell 288 GB $7.39 最大規模のモデル(Pro+) 料金とGPUオプションの全容については、Cloud Trainingをご覧ください。
お使いのハードウェアでモデルをトレーニングし、リアルタイムのメトリクスをUltralytics Platformにストリーミングできます。
パッケージのバージョン要件Platformとの連携には、Python>=3.11およびultralytics>=8.4.120が必要です。これより古いバージョンはPlatformで動作しません。
pip install "ultralytics>=8.4.120"# Set your API key export ULTRALYTICS_API_KEY="YOUR_API_KEY" # Train with project/name to stream metrics yolo train model=yolo26n.pt data=coco.yaml epochs=100 project=username/my-project name=exp1リモートトレーニングの詳細については、Cloud Trainingをご覧ください。
Platformには、次の機能をサポートする高機能なアノテーションエディターが含まれています。
- 手動ツール:バウンディングボックス、ポリゴン、スケルトンテンプレートを使ったキーポイント、回転ボックス、分類
- スケルトンテンプレート:組み込み(Person、Hand、Dog、Face、Box)またはカスタムのテンプレートを使って、すべてのキーポイントを一度に配置できます
- スマートアノテーション:SAM 2.1、SAM 3、または SAM 3.1(デフォルト)を使って、検出、セグメンテーション、セマンティック、OBBデータセットでクリック操作によるアノテーションを行えます。ツールバーから、これらのタスクやポーズタスク向けに、事前学習済みのUltralytics YOLOモデルや独自にファインチューニングしたYOLOモデルを実行できます。また、1~200クラスの検出データセットでは、クラスプロンプト対応モデルを実行できます。選択肢は、ホスト型オープンソースモデル6種類(デフォルトはMoondream 3.1)、ホスト型のテキストプロンプト対応SAM 3およびSAM 3.1、またはSettings > API Keysからプロバイダーキーを登録して利用するOpenAI、Anthropic、Google、Meta、SpaceXAI、DeepSeek、Z.ai、Kimi、Xiaomi MiMoの有料ビジョンモデルです。
- キーボードショートカット:エディターのショートカットポップオーバーに一覧表示されるホットキーを使って、効率的なワークフローを実現できます
ショートカット 操作 V手動(描画)モード Sスマートモード(SAM、YOLO、またはクラスプロンプト対応モデル) P予測(スマートモード時) A自動適用の切り替え(SAMスマートモード) 1-9番号でクラスを選択 Hアノテーション表示の切り替え Space+ ドラッグ、または中クリックしながらドラッグキャンバスをパン Delete/Backspace選択したアノテーションを削除 Ctrl+Sアノテーションを保存 Ctrl+Z元に戻す Ctrl+Yやり直す Escape保存/選択解除/終了 完全なガイドについては、Annotationをご覧ください。
Platformは、UltralyticsのExportモードと同じ22種類のデプロイ形式に対応しています。ソース形式はPyTorchです。
format引数がある各行は、エクスポート先の形式です。形式 format引数モデル メタデータ 引数 PyTorch - yolo26n.pt✅ - TorchScript torchscriptyolo26n.torchscript✅ imgsz,quantize,dynamic,nms,batch,deviceONNX onnxyolo26n.onnx✅ imgsz,quantize,dynamic,simplify,opset,nms,batch,data,fraction,deviceOpenVINO openvinoyolo26n_openvino_model/✅ imgsz,quantize,dynamic,nms,batch,data,fraction,deviceTensorRT engineyolo26n.engine✅ imgsz,quantize,dynamic,simplify,opset,workspace,nms,batch,data,fraction,deviceCoreML coremlyolo26n.mlpackage✅ imgsz,dynamic,quantize,nms,batch,deviceApple Core AI coreaiyolo26n.aimodel✅ imgsz,batch,quantizeTF SavedModel saved_modelyolo26n_saved_model/✅ imgsz,quantize,opset,nms,batch,data,fraction,deviceTF GraphDef pbyolo26n.pb❌ imgsz,opset,batch,deviceTF Edge TPU edgetpuyolo26n_edgetpu.tflite✅ imgsz,quantize,opset,data,fraction,deviceLiteRT litertyolo26n.tflite✅ imgsz,quantize,batch,data,fraction,devicePaddlePaddle paddleyolo26n_paddle_model/✅ imgsz,batch,deviceMNN mnnyolo26n.mnn✅ imgsz,batch,dynamic,quantize,simplify,opset,nms,deviceNCNN ncnnyolo26n_ncnn_model/✅ imgsz,quantize,batch,deviceIMX500 imxyolo26n_imx_model/✅ imgsz,quantize,data,fraction,nms,deviceRKNN rknnyolo26n_rknn_model/✅ imgsz,batch,name,quantize,simplify,opset,data,fraction,deviceExecuTorch executorchyolo26n_executorch_model/✅ imgsz,batch,deviceAxelera axelerayolo26n_axelera_model/✅ imgsz,batch,quantize,data,fraction,deviceDEEPX deepxyolo26n_deepx_model/✅ imgsz,quantize,simplify,opset,data,optimize,deviceQualcomm QNN qnnyolo26n_qnn.onnx✅ imgsz,batch,name,quantize,simplify,opset,data,fraction,deviceHailo hailoyolo26n_hailo_model/✅ imgsz,name,quantize,data,fraction,simplify,conf,iou,deviceHuawei Ascend ascendyolo26n_ascend_model/✅ imgsz,batch,name,quantize,opset,simplify,nms,deviceAMD Xilinx xilinxyolo26n_xilinx_model/✅ imgsz,name,quantize,data,fraction,opset,simplify,devicenms=Noneは外部NMS向けにraw出力をデフォルトで使用します。利用可能なNMSフリーヘッドを選択するには、nms=Falseを設定してください。未対応のフォーマットでは、ネイティブの出力パスにフォールバックします。上記のnmsの項目は、nms=Trueを使用してNMSを埋め込めるフォーマットを示しています。形式ごとのオプションについては、Models Export、エクスポートモードガイド、インテグレーション一覧をご覧ください。