Neural MagicのDeepSparseでYOLOv5をデプロイする#
Neural Magicは2025年1月にRed Hatに買収され、2025年6月2日にDeepSparse、SparseML、SparseZoo、Sparsifyのコミュニティ版を非推奨としました。これらのツールは引き続き動作しますが、更新やサポートは提供されなくなりました。継続的にメンテナンスされるCPUアクセラレーションについては、OpenVINOおよびONNXの統合をご覧ください。
ソフトウェアで実現するAIの世界へようこそ。
このガイドでは、Neural MagicのDeepSparseを使用してYOLOv5をデプロイする方法を説明します。
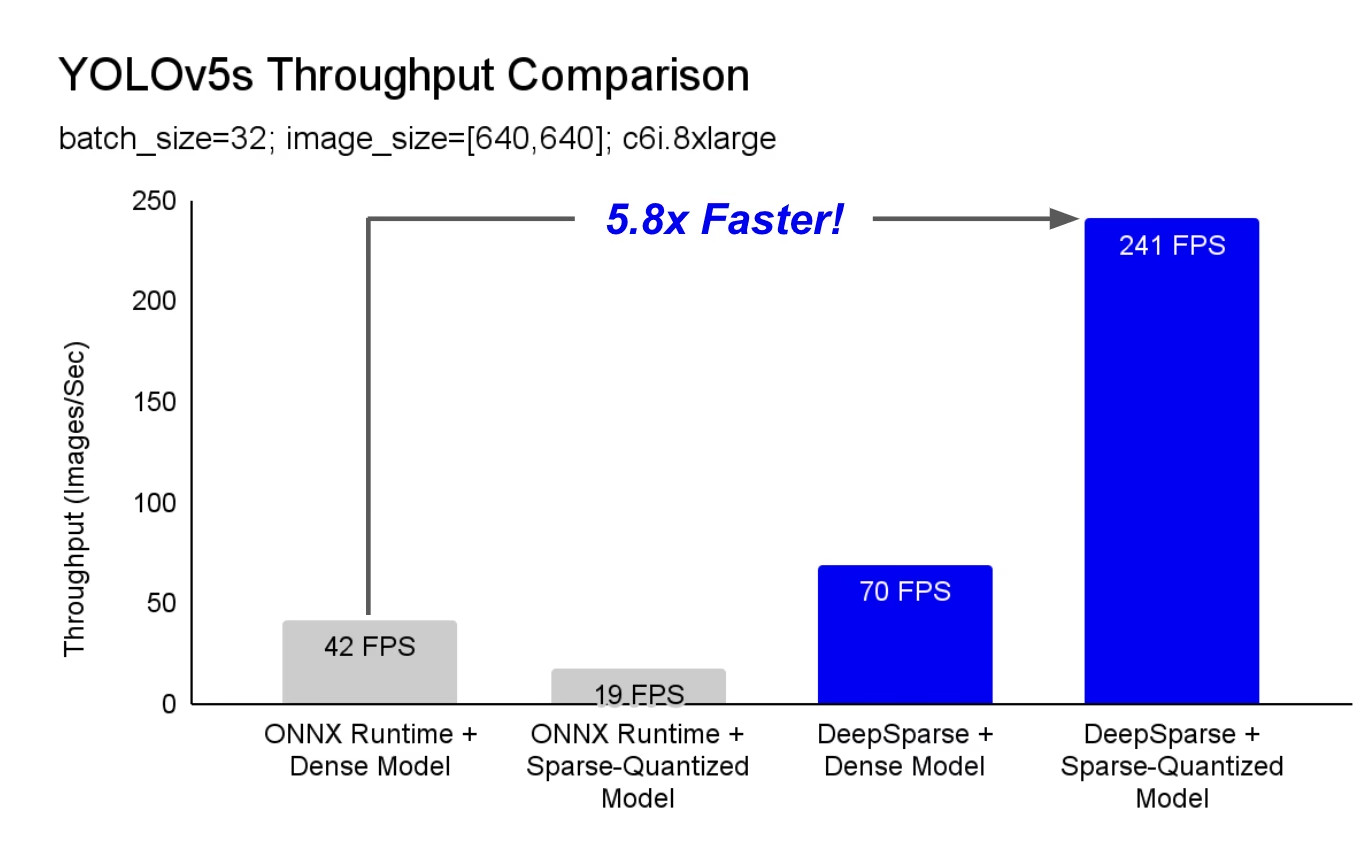
DeepSparseは、CPU上で優れたパフォーマンスを発揮する推論ランタイムです。たとえば、ONNX Runtimeのベースラインと比較して、同じマシン上でYOLOv5sを実行した場合、DeepSparseは5.8倍の速度を実現します。
ハードウェアアクセラレーターの複雑さやコストをかけずに、初めてディープラーニングのワークロードで本番環境のパフォーマンス要件を満たせるようになります。簡単に言えば、DeepSparseはGPUのパフォーマンスとソフトウェアのシンプルさを両立します。
- 柔軟なデプロイ: IntelからAMD、ARMまで、あらゆるハードウェアプロバイダーを利用して、クラウド、データセンター、エッジ環境で一貫して実行できます。
- 無制限のスケーラビリティ: 最大数百コアまで垂直スケールし、標準的なKubernetesで水平スケールするか、サーバーレスで完全に抽象化できます。
- 簡単な統合: モデルをアプリケーションに統合し、本番環境で監視するためのシンプルなAPIを提供します。
DeepSparseはどのようにしてGPUクラスのパフォーマンスを実現しますか?#
DeepSparseはモデルのスパース性を活用して、パフォーマンスを向上させます。
プルーニングと量子化によるスパース化は広く研究されている手法であり、高い精度を維持しながら、ネットワークの実行に必要なサイズと計算量を桁違いに削減できます。DeepSparseはスパース性を認識するため、ゼロ化されたパラメーターをスキップし、フォワードパスの計算量を削減します。スパース計算がメモリ律速になるため、DeepSparseはネットワークを深さ方向に実行し、問題をキャッシュに収まる計算の垂直ストライプであるTensor Columnに分割します。
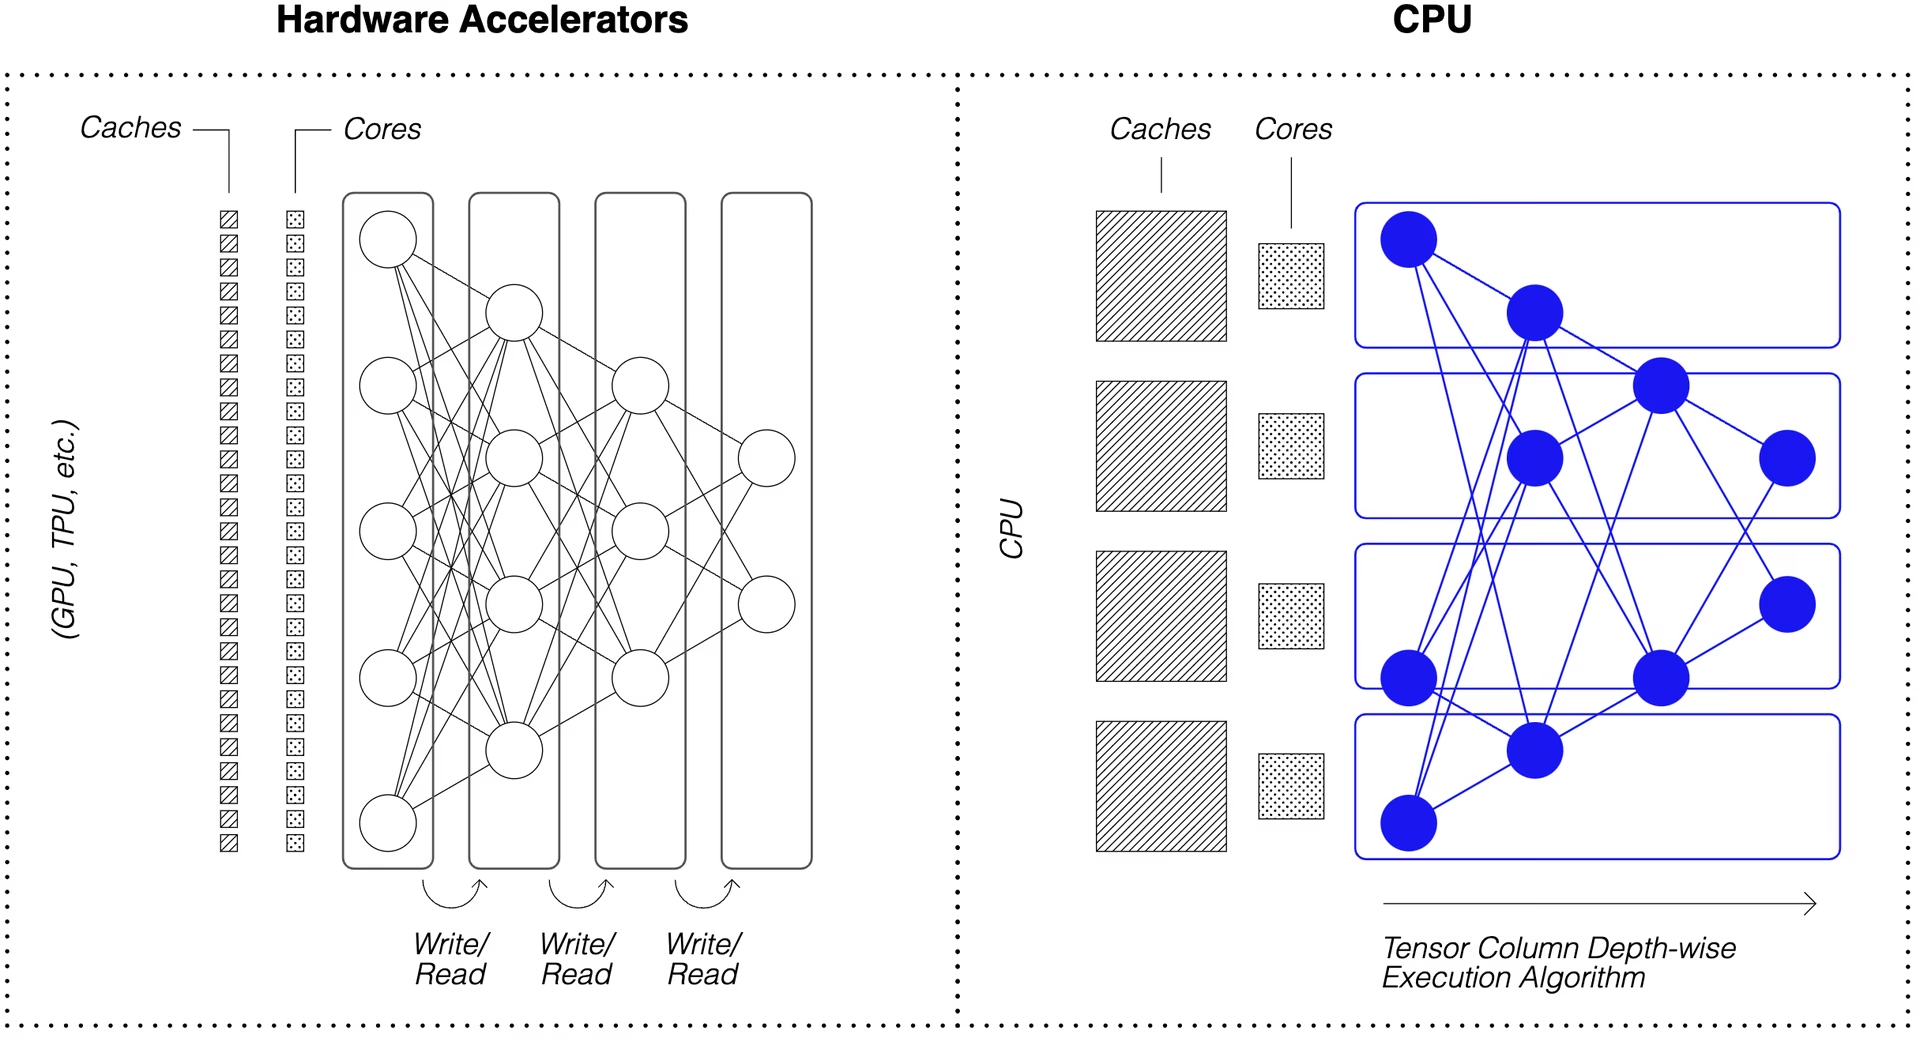
圧縮された計算をキャッシュ内で深さ方向に実行するスパースネットワークにより、DeepSparseはCPU上でGPUクラスのパフォーマンスを実現します。
自分のデータで学習したYOLOv5のスパース版を作成するにはどうすればよいですか?#
Neural MagicのオープンソースモデルリポジトリであるSparseZooには、各YOLOv5モデルの事前スパース化済みチェックポイントが含まれています。Ultralyticsと統合されているSparseMLを使用すれば、1つのCLIコマンドでスパースチェックポイントを自分のデータに合わせてファインチューニングできます。
詳細については、SparseMLとYOLOv5の統合をご覧ください。
DeepSparseの使用方法#
DeepSparseを使用してYOLOv5sのスパース版をベンチマークし、デプロイする例を順に説明します。
DeepSparseのインストール#
次のコマンドを実行してDeepSparseをインストールします。Pythonの仮想環境を使用することをおすすめします。
pip install "deepsparse[server,yolo,onnxruntime]"ONNXファイルを用意する#
DeepSparseでは、次のいずれかの形式で渡されたONNX形式のモデルを使用できます。
- SparseZoo内のONNXファイルを指定するSparseZooスタブ
- ファイルシステム内にあるONNXモデルのローカルパス
以下の例では、次のSparseZooスタブで指定される、標準の密なYOLOv5sチェックポイントと、プルーニングおよび量子化済みのYOLOv5sチェックポイントを使用します。
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-noneモデルのデプロイ#
DeepSparseは、モデルをアプリケーションに統合するための便利なAPIを提供します。
以下のデプロイ例を試すには、次のコマンドを使ってサンプル画像をダウンロードし、basilica.jpgとして保存してください。
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgPython API#
Pipelinesはランタイムの前処理と出力の後処理をラップし、DeepSparseをアプリケーションに追加するためのシンプルなインターフェースを提供します。DeepSparseとUltralyticsの統合には、未加工の画像を受け取り、バウンディングボックスを出力する、すぐに使えるPipelineが含まれています。
Pipelineを作成し、推論を実行します。
from deepsparse import Pipeline

# ローカルファイルシステム内の画像リスト
images = ["basilica.jpg"]

# Pipelineを作成
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# 画像に対して推論を実行し、バウンディングボックスとクラスを取得
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)クラウドで実行している場合、OpenCVがlibGL.so.1を見つけられないというエラーが発生することがあります。不足しているライブラリをインストールする方法があります。
apt-get install libgl1または、GUI依存関係を完全に回避できるヘッドレス版のOpenCVを使用します。
pip install opencv-python-headlessHTTPサーバー#
DeepSparse Serverは、人気のあるWebフレームワークであるFastAPIとWebサーバーのUvicorn上で動作します。CLIコマンドを1つ実行するだけで、DeepSparseを使用したモデルサービスのエンドポイントを簡単に設定できます。Serverは、YOLOv5を使用した物体検出を含む、DeepSparseのあらゆるPipelineに対応しており、未加工の画像をエンドポイントに送信してバウンディングボックスを受け取ることができます。
プルーニングおよび量子化済みのYOLOv5sを使ってServerを起動します。
deepsparse.server \
  --task yolo \
--model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-nonePythonのrequestsパッケージを使用したリクエストの例です。
import json
from contextlib import ExitStack

import requests

# 推論用の画像リスト(クライアント側のローカルファイル)
path = ["basilica.jpg"]

# HTTP経由で/predict/from_filesエンドポイントにリクエストを送信
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# レスポンスはJSONで返される
annotations = json.loads(resp.text)  # アノテーション結果の辞書
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]アノテーションCLI#
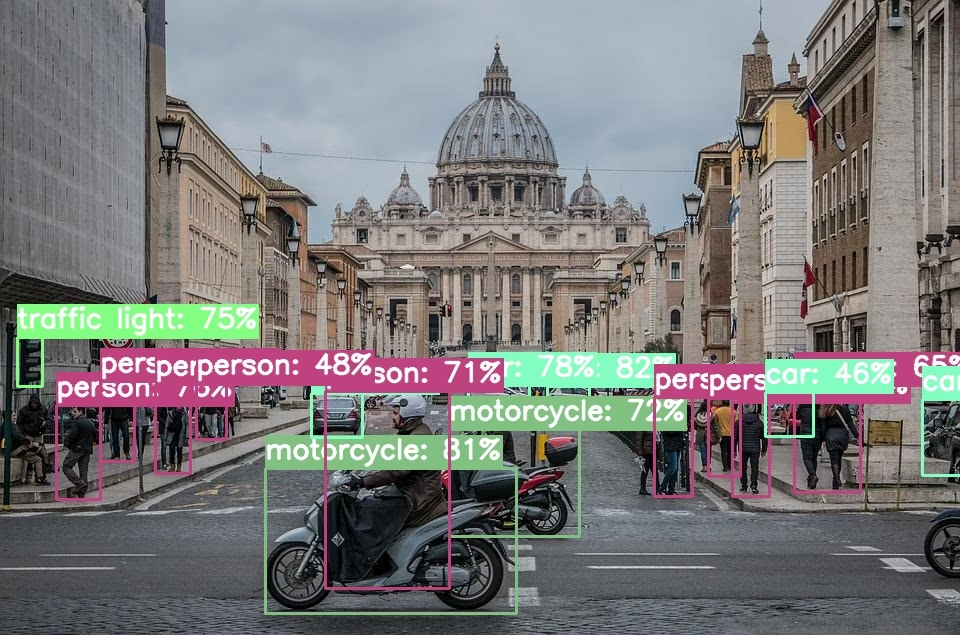
annotateコマンドを使用すると、エンジンでアノテーション済みの写真をディスクに保存することもできます。--source 0を試して、ライブのWebカメラ映像にアノテーションを付けてみてください。
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpg上記のコマンドを実行すると、annotation-resultsフォルダーが作成され、注釈付き画像がその中に保存されます。
パフォーマンスのベンチマーク#
DeepSparseのスループットとONNX Runtimeのスループットを、YOLOv5sでDeepSparseのベンチマークスクリプトを使用して比較します。
ベンチマークはAWSのc6i.8xlargeインスタンス(16コア)で実行しました。
バッチサイズ32でのパフォーマンス比較#
ONNX Runtimeのベースライン#
バッチサイズ32の場合、ONNX Runtimeは標準のDense YOLOv5sで毎秒42枚の画像を処理します。
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025DeepSparseのDenseモデルでのパフォーマンス#
DeepSparseは最適化されたSparseモデルで最高のパフォーマンスを発揮しますが、標準のDense YOLOv5sでも優れた性能を発揮します。
バッチサイズ32の場合、DeepSparseは標準のDense YOLOv5sで毎秒70枚の画像を処理し、ORTと比べてパフォーマンスが1.7倍向上します。
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546DeepSparseのSparseモデルでのパフォーマンス#
モデルにスパース性を適用すると、DeepSparseはONNX Runtimeに対してさらに大きなパフォーマンス向上を実現します。
バッチサイズ32の場合、DeepSparseはプルーニングと量子化を適用したYOLOv5sで毎秒241枚の画像を処理し、ORTと比べてパフォーマンスが5.8倍向上します。
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452バッチサイズ1でのパフォーマンス比較#
レイテンシが重視されるバッチサイズ1のシナリオでも、DeepSparseはONNX Runtimeより高速に処理できます。
ONNX Runtimeのベースライン#
バッチサイズ1の場合、ONNX Runtimeは標準のDense YOLOv5sで毎秒48枚の画像を処理します。
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921DeepSparseのSparseモデルでのパフォーマンス#
バッチサイズ1の場合、DeepSparseはプルーニングと量子化を適用したYOLOv5sで毎秒135項目を処理し、ONNX Runtimeと比べてパフォーマンスが2.8倍向上します。
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468c6i.8xlargeインスタンスにはVNNI命令が搭載されているため、重みを4個単位のブロックでプルーニングすると、DeepSparseのスループットをさらに高められます。
バッチサイズ1の場合、DeepSparseは4ブロック単位でプルーニングと量子化を適用したYOLOv5sで毎秒180項目を処理し、ONNX Runtimeと比べてパフォーマンスが3.7倍向上します。
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375DeepSparseを使い始める#
研究またはテストをお考えですか? DeepSparse Communityは、研究およびテストに無料でご利用いただけます。DeepSparse READMEから使い始めてください。
DeepSparseを使ったYOLOv5のデプロイについて詳しくは、DeepSparseのYOLOv5サンプルとDeepSparse連携に関するUltralyticsのブログ記事をご覧ください。
よくある質問#
いいえ。DeepSparseはCPUランタイムです。上記のベンチマークは、アクセラレーターを使用せず、16コアのAWS
c6i.8xlargeインスタンスで測定しました。python export.py --weights best.pt --include onnxを使ってONNXにエクスポートし、SparseZooスタブの代わりにファイルパスをmodel_pathとして渡します。Denseモデルでもランタイムによる高速化が得られ、プルーニングと量子化を適用したモデルで最大の効果が得られます。SparseMLを使い、事前にスパース化されたSparseZooチェックポイントのいずれかをデータでファインチューニングします。SparseMLはトレーニング中にスパース構造を維持します。その後、ONNXにエクスポートします。
いいえ。コミュニティ版は2025年6月2日に非推奨となり、PyPI上のパッケージは更新が停止されています。既存のパイプラインは引き続き動作しますが、新しいデプロイでは、現在も積極的にメンテナンスされているOpenVINOまたはONNX Runtimeの利用をご検討ください。