Ultralytics YOLOv5アーキテクチャ
YOLOv5(v6.0/6.1)は、Ultralyticsが開発した物体検出アルゴリズムです。この記事では、YOLOv5のアーキテクチャ、データ拡張戦略、トレーニング手法、損失計算の手法について説明します。これらを理解すると、監視、自動運転車、画像認識などの分野で物体検出を活用できます。
1. モデル構造#
YOLOv5のアーキテクチャは、主に次の3つの部分で構成されています:
- バックボーン: ネットワークの主要部分です。YOLOv5のバックボーンは、以前のバージョンで使用されていたDarknetアーキテクチャを改良した
CSPDarknet53構造で設計されています。 - ネック: バックボーンとヘッドを接続する部分です。YOLOv5では、
SPPF(Spatial Pyramid Pooling - Fast)およびPANet(Path Aggregation Network)構造を使用しています。 - ヘッド: 最終出力を生成する部分です。YOLOv5では、この目的に
YOLOv3 Headを使用します。
モデルの構造を以下の画像に示します。モデル構造の詳細については、models/yolov5l.yamlをご覧ください。
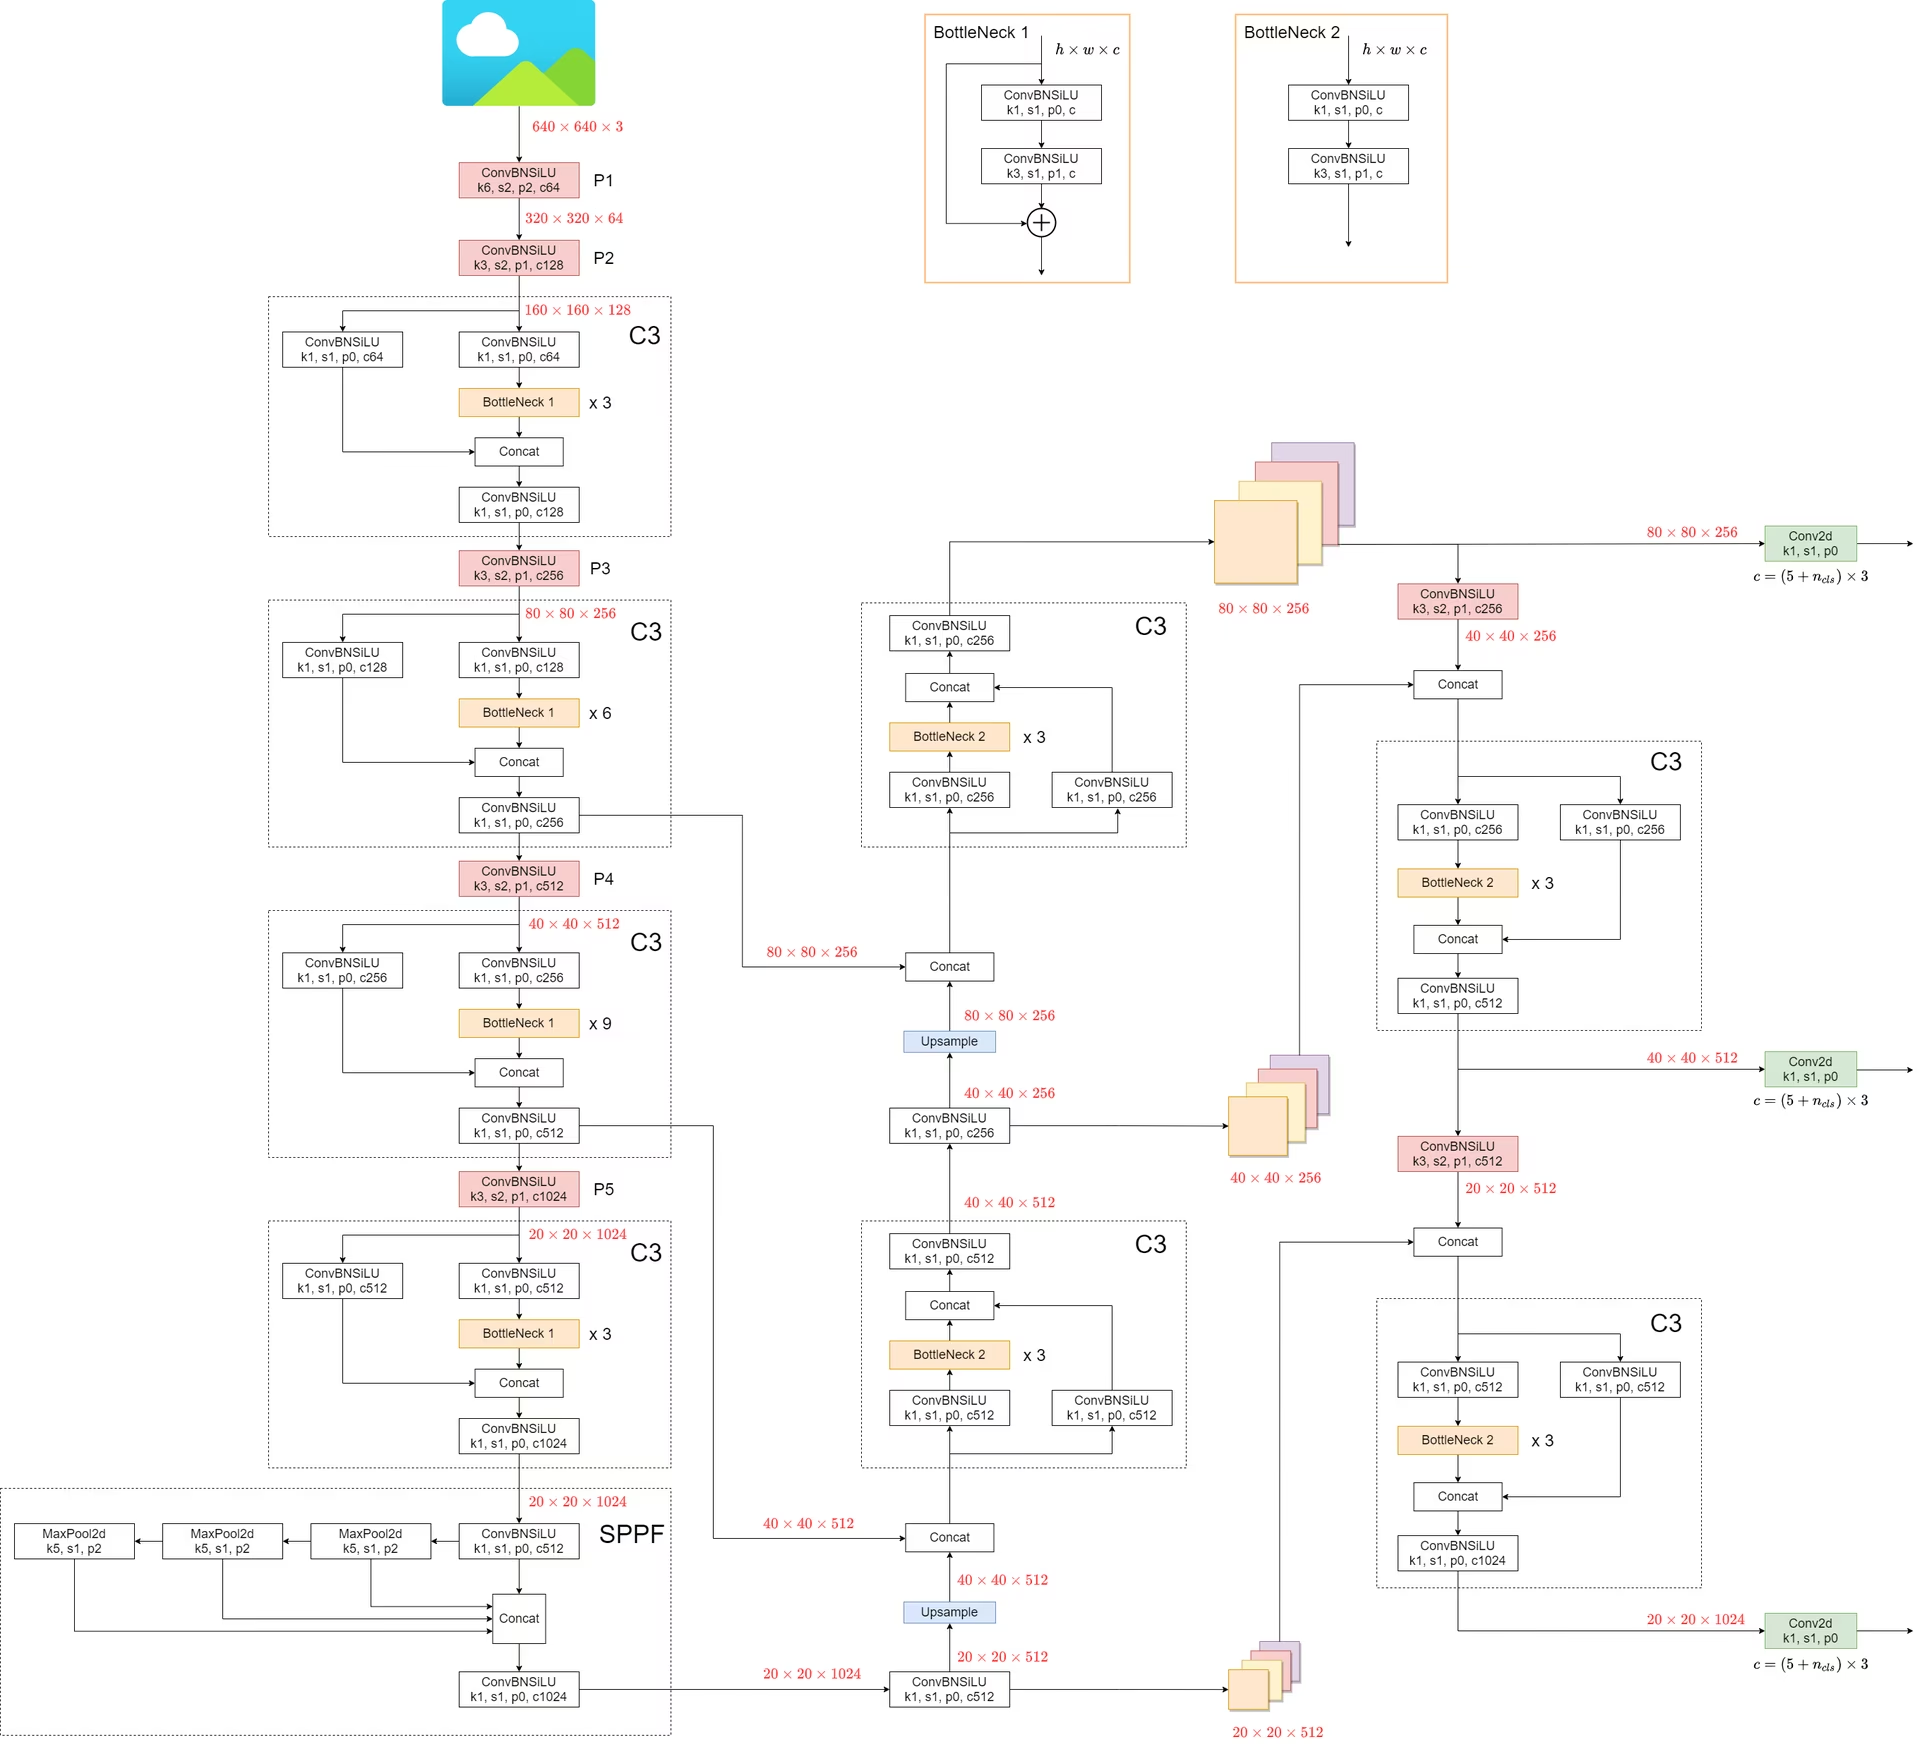
YOLOv5では、従来のバージョンと比べて、注目すべき改良がいくつか導入されています:
- 以前のバージョンで使用されていた
Focus構造は、6x6 Conv2d構造に置き換えられています。この変更により効率が向上します #4825。 SPP構造はSPPFに置き換えられています。この変更により、同じ出力を維持しながら処理速度が2倍以上に向上します。
SPPとSPPFの速度をテストするには、次のコードを使用できます:
SPPとSPPFの速度プロファイリング例(クリックして開く)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
結果:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. データ拡張手法#
YOLOv5では、モデルの汎化能力を高め、過学習を抑えるために、さまざまなデータ拡張手法を使用します。次のような手法があります:
-
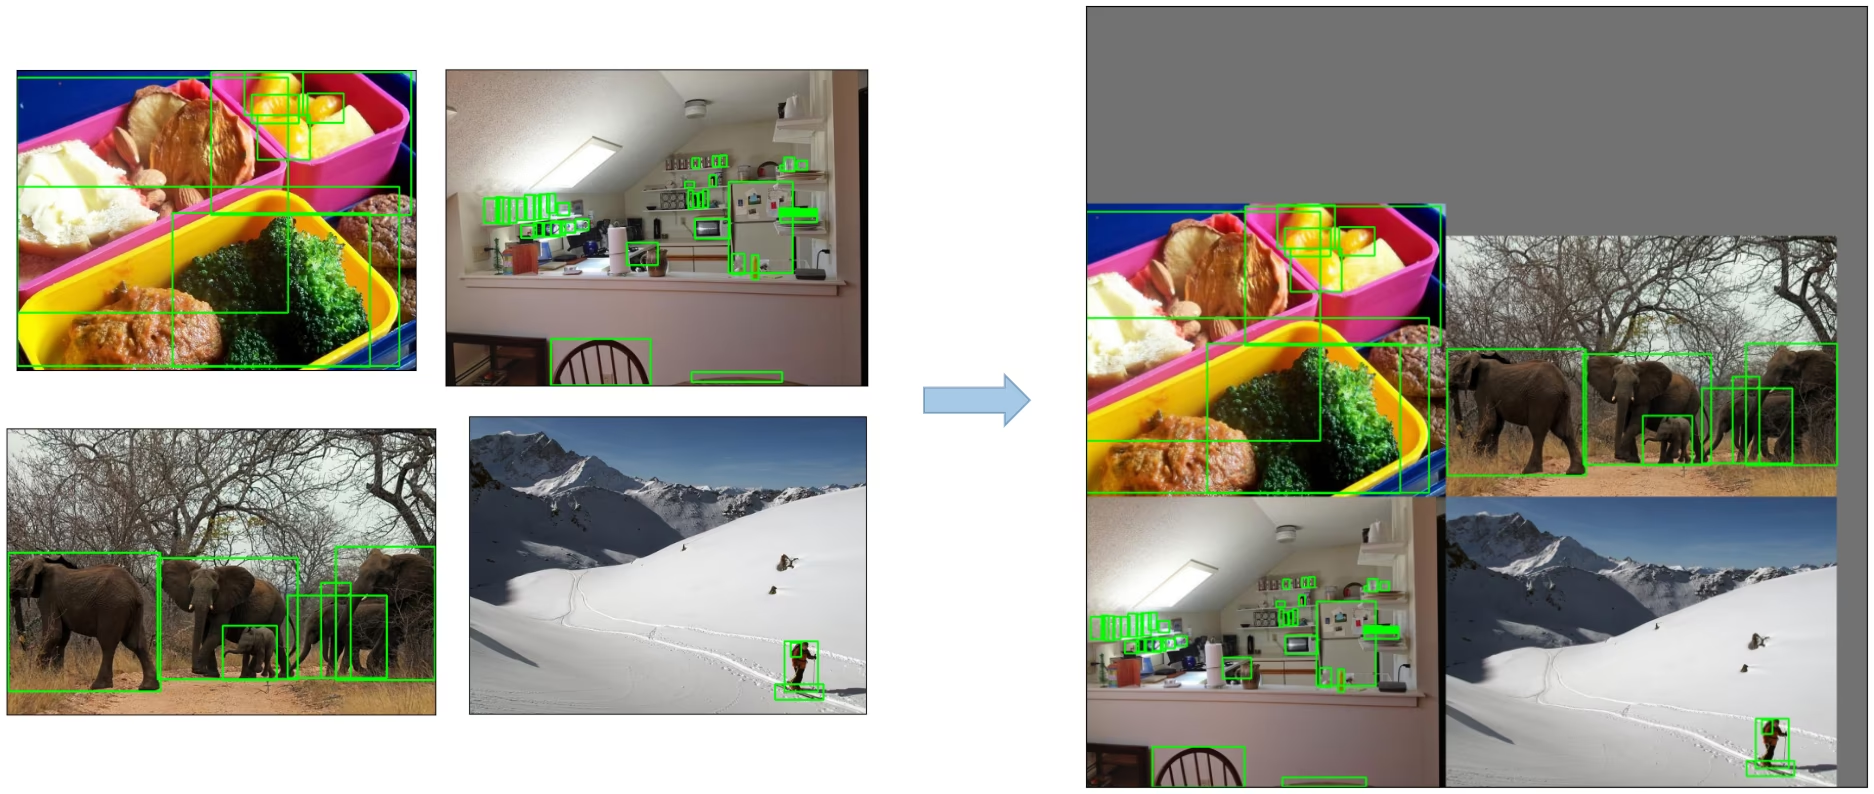
モザイク拡張: 4枚のトレーニング画像を1枚に組み合わせる画像処理手法です。物体検出モデルがさまざまな物体のスケールや位置ずれに対応しやすくなるよう促します。
-
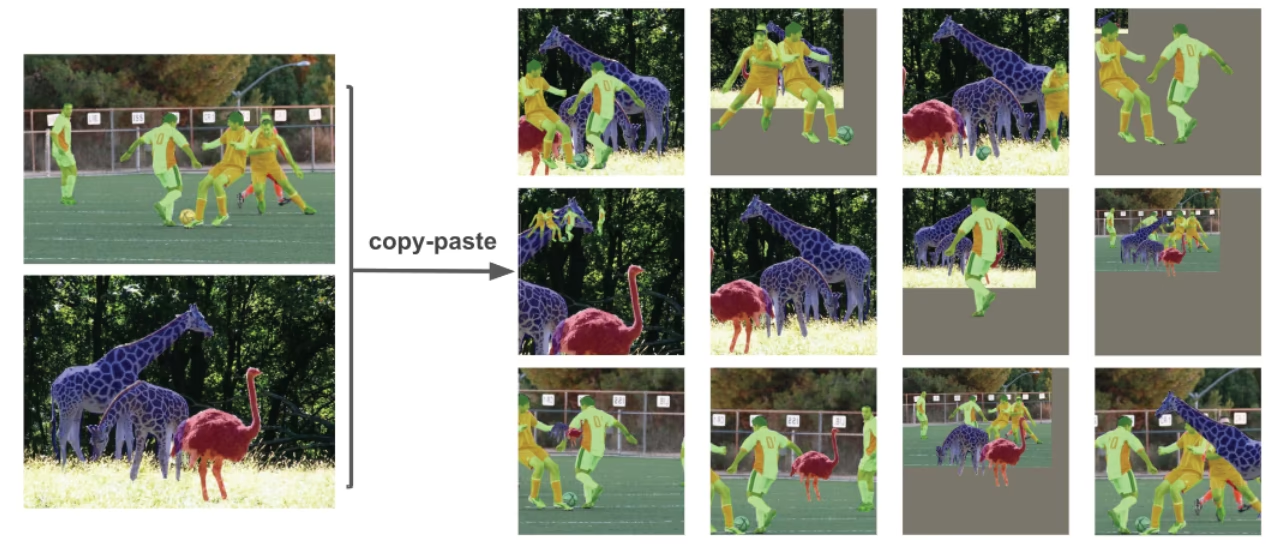
コピー&ペースト拡張: セグメンテーションマスクを使って物体インスタンスをコピーし、トレーニング画像に貼り付けて新しいトレーニングサンプルを生成するデータ拡張手法です。
-
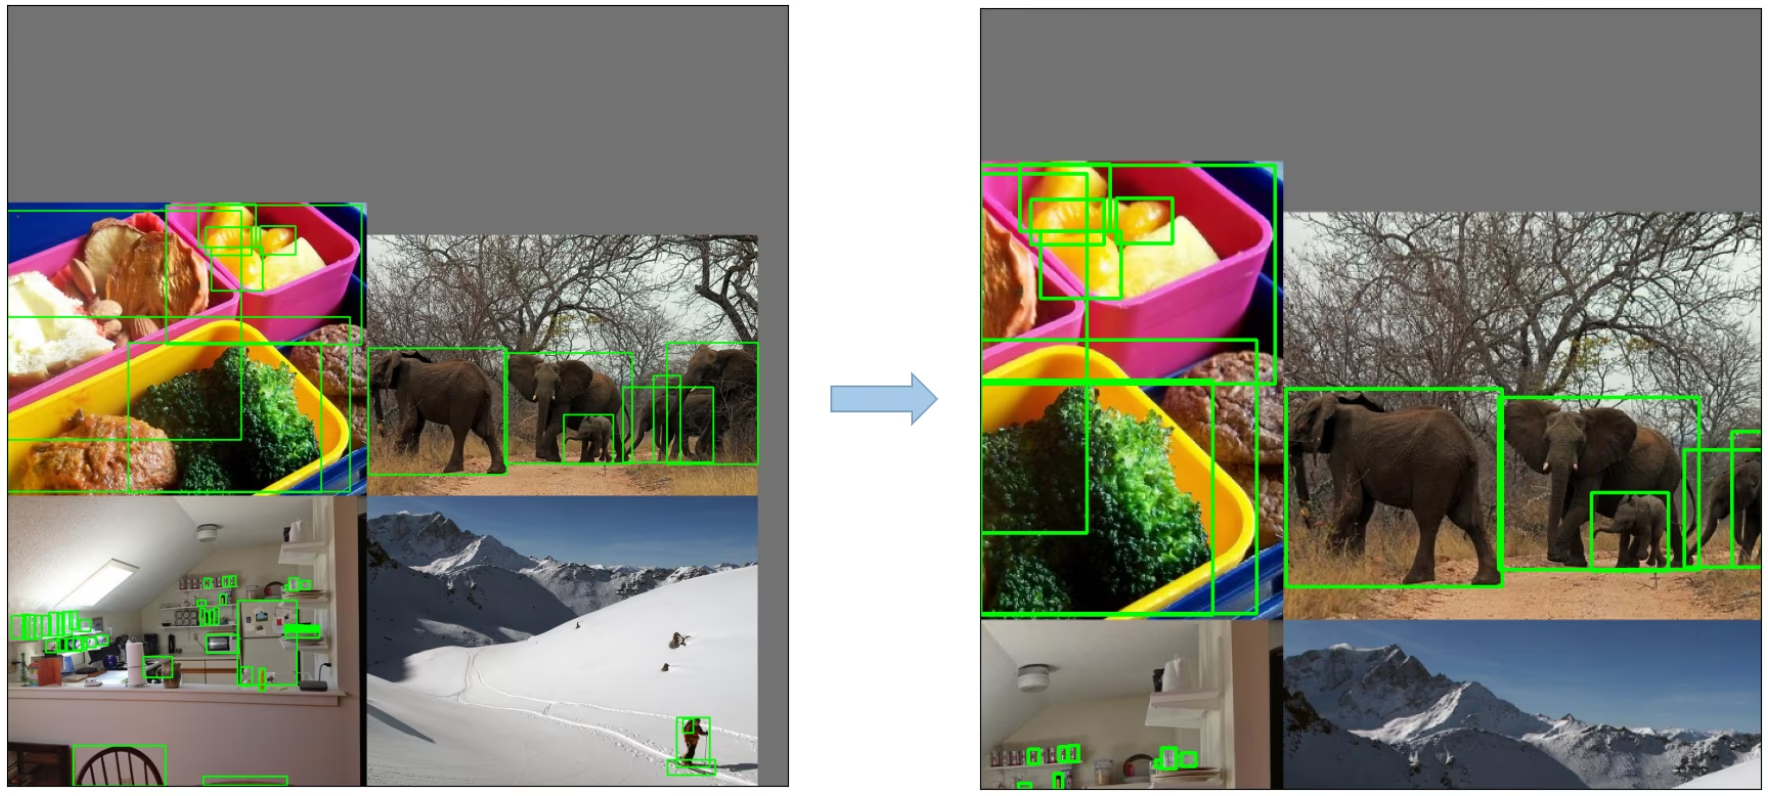
ランダムアフィン変換: 画像をランダムに回転、拡大縮小、平行移動、せん断する手法です。
-
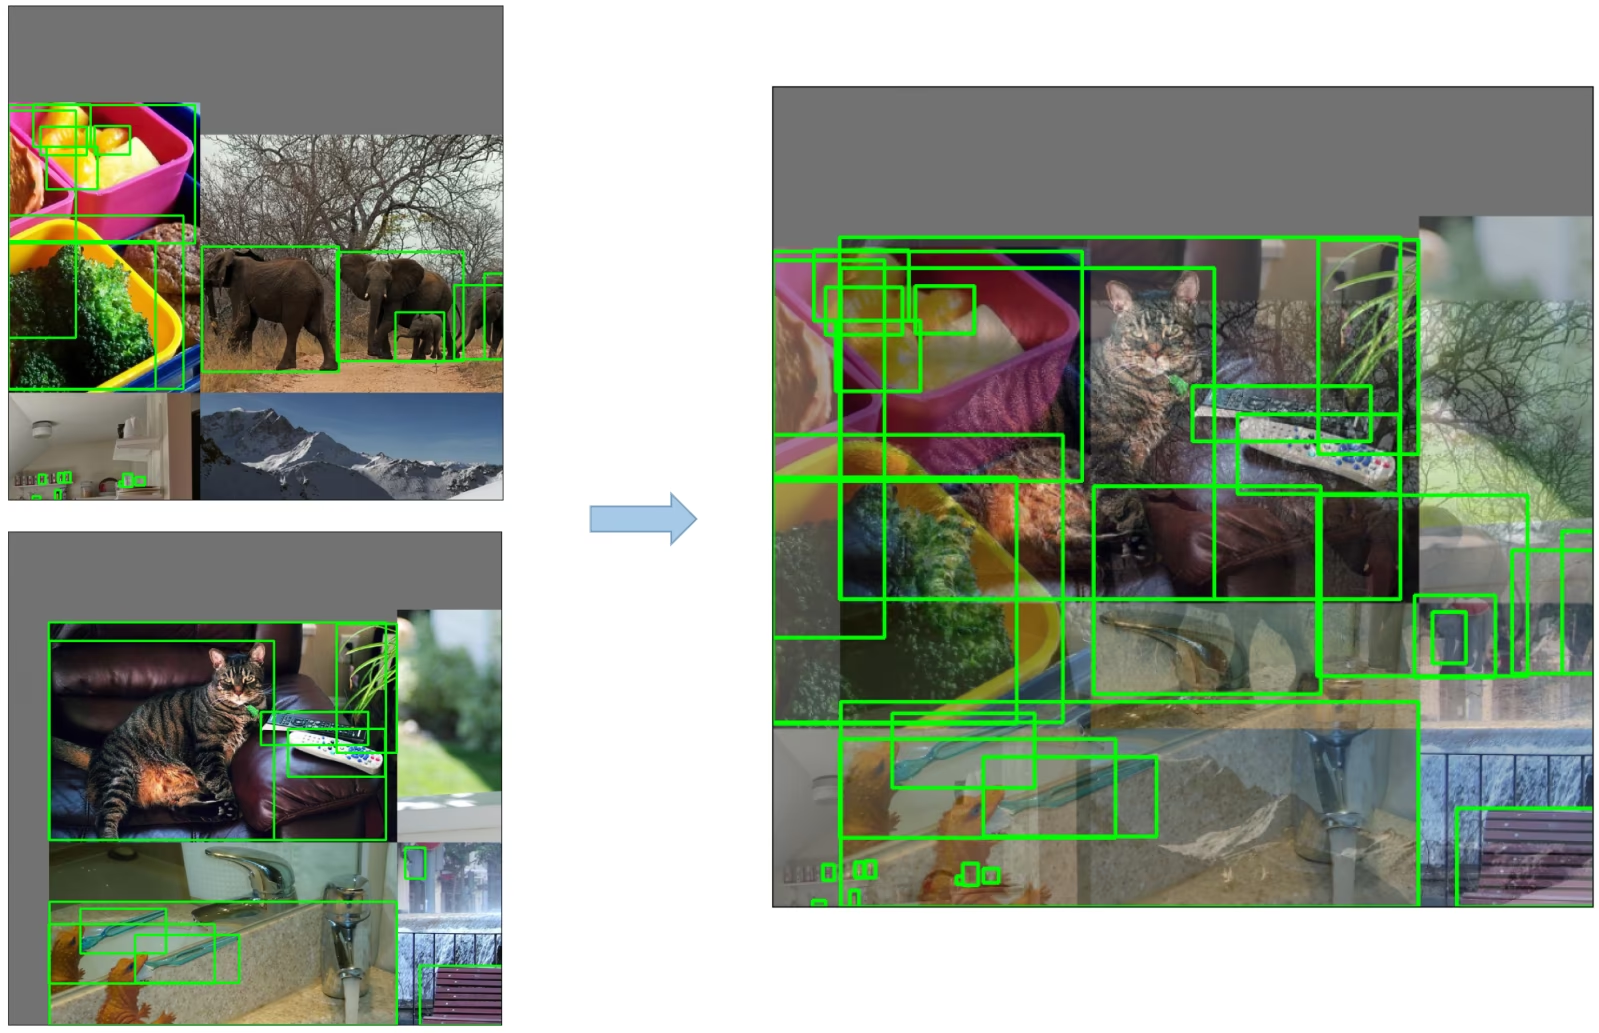
MixUp拡張: 2枚の画像とそれぞれに対応するラベルの線形結合によって、合成画像を作成する手法です。
-
Albumentations:幅広いデータ拡張手法に対応する画像拡張ライブラリです。
-
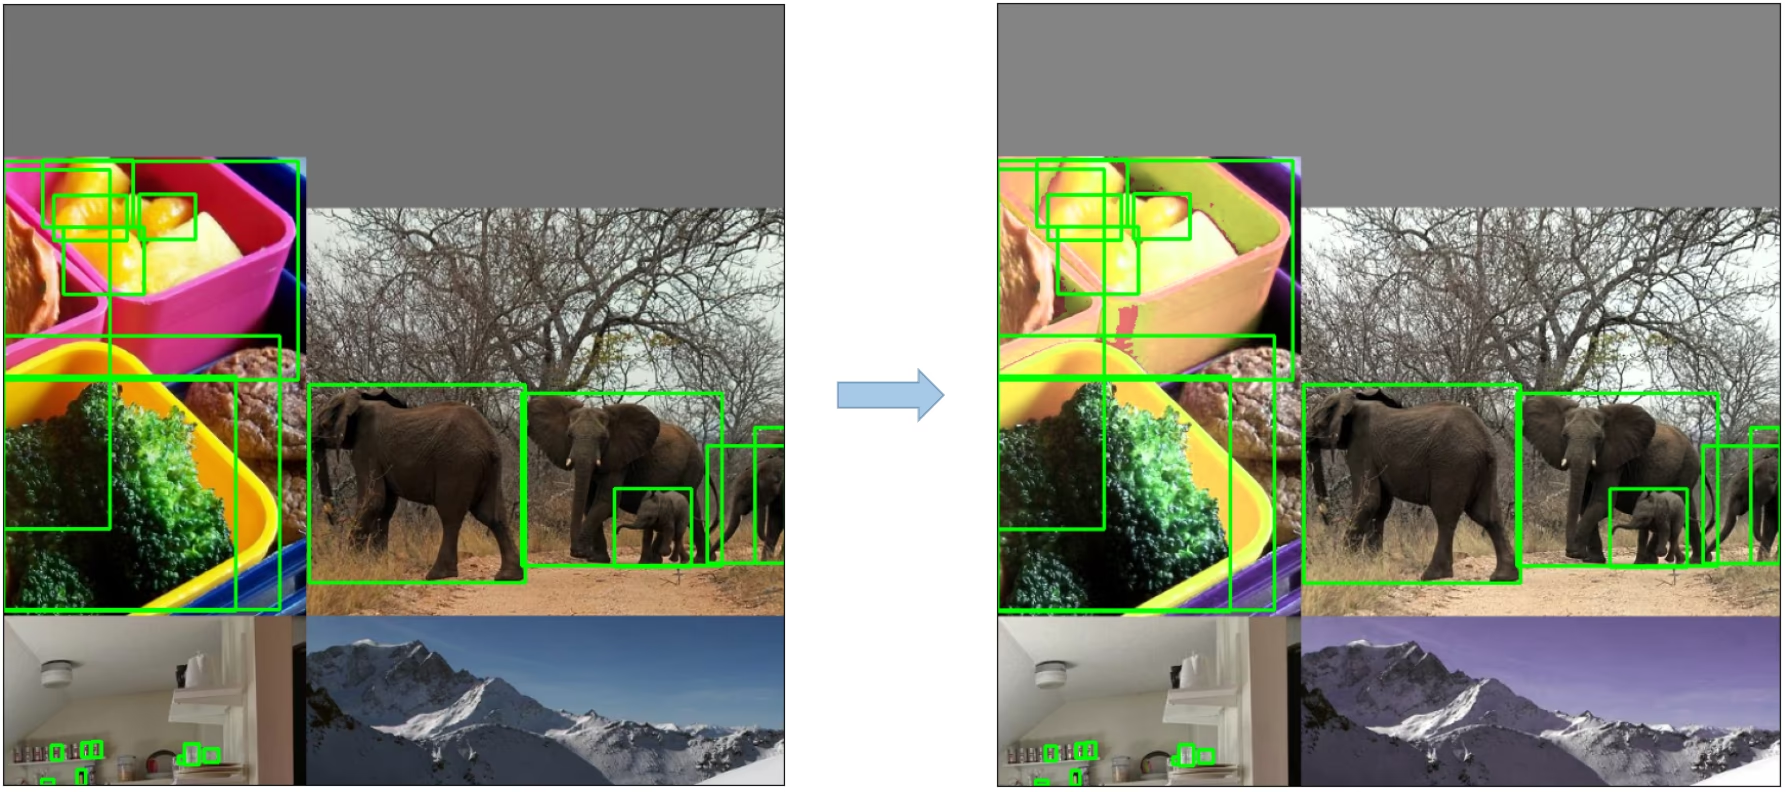
HSV拡張: 画像の色相、彩度、明度をランダムに変更します。
-
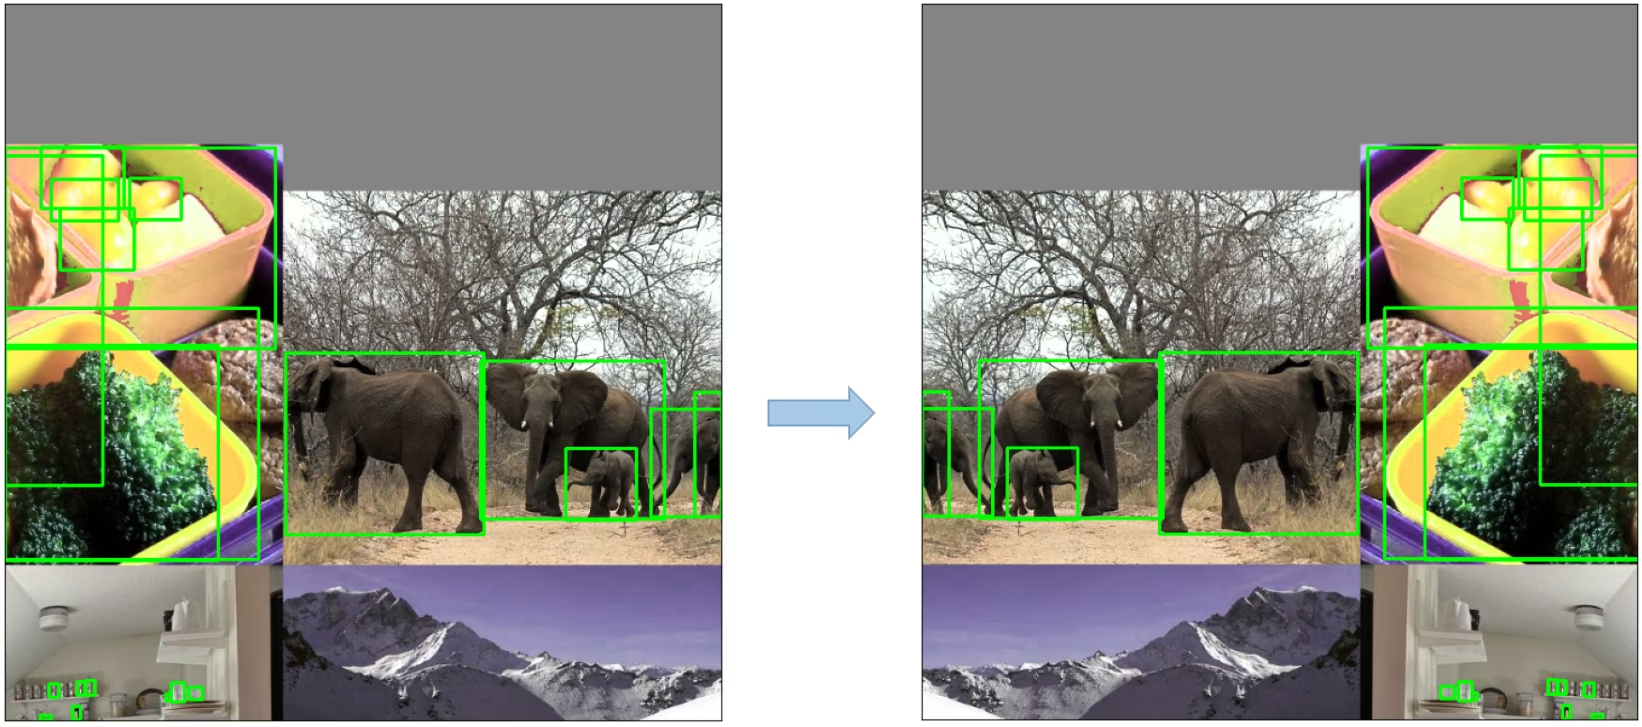
ランダム水平反転: 画像を水平方向にランダムに反転するデータ拡張手法です。
3. トレーニング戦略#
YOLOv5では、モデルの性能を高めるために複数のトレーニング戦略を適用します。次のような戦略があります。
- マルチスケールトレーニング: トレーニング中に、入力画像を元のサイズの0.5~1.5倍の範囲でランダムにリスケーリングします。
- AutoAnchor: この戦略では、事前のアンカーボックスを最適化し、カスタムデータの正解ボックスの統計的特性に合わせます。
- Warmup and Cosine LR Scheduler: モデルのパフォーマンスを向上させるために学習率を調整する方法です。
- 指数移動平均 (EMA): 過去のステップにおけるパラメーターの平均を使用して、学習プロセスを安定させ、汎化誤差を低減する戦略です。
- 混合精度トレーニング: 演算を半精度形式で実行する手法です。メモリ使用量を削減し、計算速度を高めます。
- ハイパーパラメーターの進化的最適化: 最適なパフォーマンスを得るために、ハイパーパラメーターを自動的に調整する戦略です。ハイパーパラメーターの進化的最適化のチュートリアルをご覧ください。
4. 追加機能#
4.1 損失の計算#
YOLOv5の損失は、次の3つの個別の損失成分を組み合わせて計算されます。
- クラス損失 (BCE Loss): 二値交差エントロピー損失で、分類タスクの誤差を測定します。
- 物体存在損失 (BCE Loss): もう1つの二値交差エントロピー損失で、特定のグリッドセルに物体が存在するかどうかを検出する際の誤差を計算します。
- 位置損失(CIoU損失): 完全IoU損失であり、グリッドセル内で物体を位置特定する際の誤差を測定します。
全体の損失関数は次のように表されます。
4.2 損失のバランス調整#
3つの予測レイヤー(P3、P4、P5)の物体存在損失には、それぞれ異なる重みが設定されています。バランス調整の重みは、それぞれ[4.0, 1.0, 0.4]です。この方法により、異なるスケールの予測が合計損失に適切に寄与します。
4.3 グリッド感度の解消#
YOLOv5のアーキテクチャでは、以前のYOLOバージョンと比べて、ボックス予測方法にいくつかの重要な変更が加えられています。YOLOv2とYOLOv3では、最終レイヤーの活性化関数を用いてボックス座標を直接予測していました。

一方、YOLOv5では、グリッド感度を低減し、モデルが上限のないボックス寸法を予測しないように、ボックス座標の予測式が更新されています。
予測されるバウンディングボックスを計算するための改訂後の式は次のとおりです。
スケーリング前後の中心点オフセットを比較します。中心点オフセットの範囲は(0, 1)から(-0.5, 1.5)に調整されます。そのため、オフセットが0または1に到達しやすくなります。

アンカーに対する高さと幅のスケーリング比率を、調整前後で比較します。従来のYOLO/Darknetのボックス方程式には重大な欠陥があります。単純にout=exp(in)となるため、幅と高さに上限がありません。これにより勾配の暴走、不安定性、NaN損失が発生し、最終的にはトレーニングが完全に失敗する可能性があり、危険です。

4.4 ターゲットの構築#
YOLOv5のターゲット構築プロセスは、学習効率とモデルの精度に不可欠です。このプロセスでは、出力マップ内の適切なグリッドセルに正解ボックスを割り当て、適切なアンカーボックスとマッチングします。
このプロセスは次の手順で行います。
- 正解ボックスの寸法と各アンカーテンプレートの寸法の比率を計算します。

- 計算された比率がしきい値以内であれば、正解ボックスを対応するアンカーとマッチングします。

- マッチしたアンカーを適切なセルに割り当てます。中心点オフセットが改訂され、その範囲が(0, 1)から(-0.5, 1.5)に調整されたため、追加のマッチングが可能になり、1つの正解ボックスが複数のアンカーに割り当てられる場合があることに注意してください。

このように、ターゲット構築プロセスでは、学習中に各正解物体が適切に割り当てられ、マッチングされるため、YOLOv5は物体検出タスクをより効果的に学習できます。
結論#
YOLOv5は、リアルタイム物体検出の進化における重要な一歩です。そのアーキテクチャの選択、学習戦略、エンジニアリング上の改良により、以前のYOLOバージョンと比べて高いパフォーマンスと効率を実現しています。
YOLOv5の主な機能強化には、6x6 Conv2dステムやSPPFなどのアーキテクチャの改良、多様なデータ拡張手法、AutoAnchorやEMAなどのトレーニング戦略、損失計算とターゲット構築の調整が含まれます。これらを組み合わせることで、YOLOモデルで知られる速度を維持しながら、物体検出の精度と効率が向上します。
よくある質問#
CSPDarknet53バックボーンが特徴を抽出し、SPPFとPANetのネックがスケール間で特徴を融合します。YOLOv3スタイルのヘッドは、ストライド8、16、32でボックス、物体存在度、クラスを予測します。全レイヤーの一覧は
models/yolov5l.yamlにあります。SPPFでは、5x5、9x9、13x13のプーリングを並列実行する代わりに、5x5の最大プーリングを3回連結します。出力は数学的に同一ですが、上記のプロファイリングスニペットが示すように、実行速度は2倍以上です。
従来のYOLOのオフセットでは、値が正確に0または1になることがなかったため、グリッド境界上に中心がある物体を予測するのは困難でした。シグモイドを(-0.5, 1.5)の範囲にスケーリングすると、グリッド感度が解消されます。また、幅と高さに
2σの2乗を使用すると、予測値はアンカーサイズの4倍に制限され、上限のない指数関数による勾配の暴走を防げます。ボックスに対する幅と高さの比率が
anchor_t(デフォルトでは4.0)以内にあるアンカーはすべてマッチします。また、オフセット範囲が拡張されているため、ボックスは隣接する2つのグリッドセルにも割り当てられます。そのため、1つの物体から複数の正例ターゲットが生成され、収束が速くなります。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。