YOLOv5での凍結レイヤーを用いた転移学習#
📚 このガイドでは、転移学習を実装する際にYOLOv5 🚀のレイヤーを凍結する方法を説明します。転移学習は、ネットワーク全体を最初から再トレーニングせずに、新しいデータでモデルをすばやく再トレーニングできる強力な機械学習(ML)手法です。初期レイヤーの重みを凍結し、後段のレイヤーのパラメーターだけを更新することで、計算リソースの要件とトレーニング時間を大幅に削減できます。ただし、この方法では最終モデルの精度がわずかに低下する可能性があります。
開始する前に#
まず、YOLOv5リポジトリをクローンし、requirements.txtに記載されている必要な依存関係をインストールします。Python>=3.8.0環境にPyTorch>=1.8がインストールされていることを確認してください。事前学習済みモデルと必要なデータセットは、最新のYOLOv5リリースから自動的にダウンロードされます。
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependenciesレイヤーの凍結の仕組み#
ニューラルネットワークのレイヤーを凍結すると、トレーニング中にそのパラメーター(重みとバイアス)が更新されなくなります。PyTorchでは、レイヤーのテンソルのrequires_grad属性をFalseに設定することで実現します。その結果、誤差逆伝播中にこれらのレイヤーの勾配が計算されず、計算量とメモリを節約できます。
YOLOv5では、トレーニングスクリプトで次のようにレイヤーの凍結を実装しています:
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
v.requires_grad = False # Disable gradient calculation for frozen layersモデルアーキテクチャの確認#
どのレイヤーを凍結するか判断するには、YOLOv5モデルの構造を理解することが重要です。次のPythonスニペットを使用して、すべてのモジュール名とそのパラメーターを確認できます:
# 'model'が読み込み済みのYOLOv5モデルインスタンスであると仮定します
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""YOLOv5アーキテクチャは通常、特徴抽出を担うバックボーン(YOLOv5s/m/l/xなどの標準構成ではレイヤー0~9)と、物体検出を行うヘッド(残りのレイヤー)で構成されます。
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
# ... subsequent head layers for feature fusion and detection凍結オプション#
トレーニングコマンドの--freeze引数を使用して、凍結するレイヤーを制御できます。この引数では、最初の凍結解除済みモジュールのインデックスを指定します。このインデックスより前のすべてのモジュールの重みが凍結されます。代わりに複数のインデックス(例: --freeze 0 1 2)を渡すと、指定したモジュールだけが凍結されます。特定のブロックに対応するインデックスを確認する必要がある場合は、model.model(nn.Sequential)を使用してモジュールの順序を確認してください。
バックボーンのみを凍結する#
大規模なデータセット(COCOなど)で学習した汎用的な特徴抽出能力を維持しながら、新しい物体クラスにモデルを適応させる場合によく使われる方法として、バックボーン全体(レイヤー0~9)を凍結します:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10この方法は、対象データセットに元のトレーニングデータ(例: COCO)と類似した低レベルの視覚的特徴(エッジやテクスチャ)がありながら、物体カテゴリが異なる場合に効果的です。
最終検出レイヤー以外をすべて凍結する#
ネットワークのほぼ全体を凍結し、最終出力の畳み込みレイヤー(Detectモジュールの一部で、通常は最後のモジュールです。例: YOLOv5sのモジュール24)だけをトレーニング可能にするには、次のようにします:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24この方法は、学習済み特徴の大部分を維持しながら、主に異なる数の出力クラスに合わせてモデルを調整する必要がある場合に便利です。ファインチューニングに必要な計算リソースを最小限に抑えられます。
パフォーマンス比較#
レイヤー凍結の効果を示すため、公式のCOCO事前学習済み重み(yolov5m.pt)を初期値として、Pascal VOCデータセットでYOLOv5mを50エポックトレーニングしました。すべてのレイヤーをトレーニングする場合(--freeze 0)、バックボーンを凍結する場合(--freeze 10)、最終検出レイヤー以外をすべて凍結する場合(--freeze 24)の3つのシナリオを比較しました。
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10精度の結果#
結果から、レイヤーを凍結するとトレーニングを大幅に高速化できますが、最終的なmAP(平均適合率)がわずかに低下する可能性があることがわかります。一般に、すべてのレイヤーをトレーニングすると最高の精度が得られます。一方、凍結するレイヤーを増やすと、性能が低下する可能性がある代わりにトレーニングが高速になります。
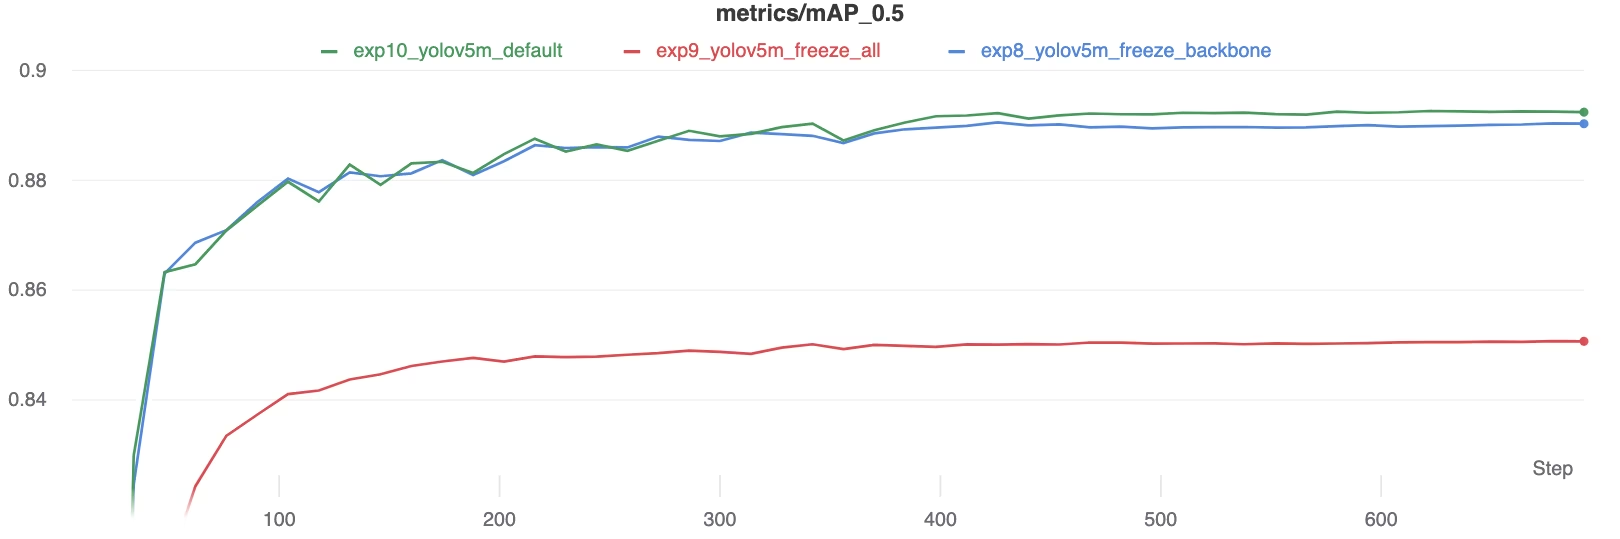 mAP50のトレーニング時の比較
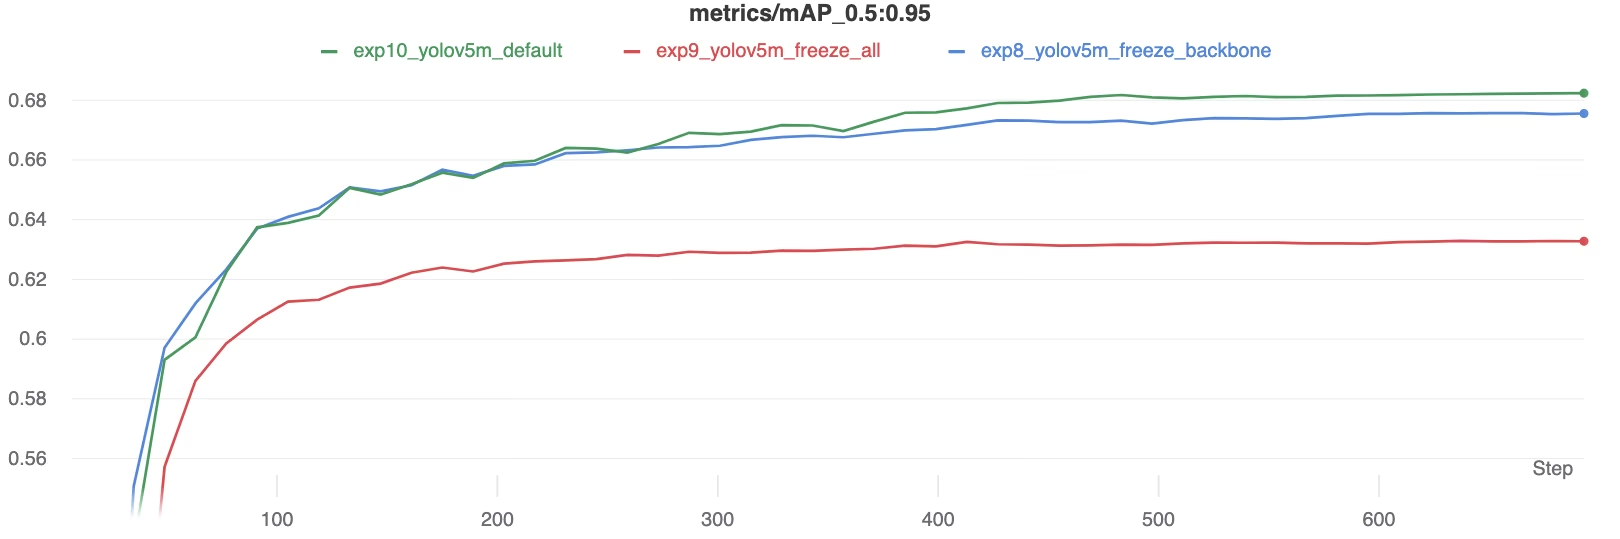 mAP50-95のトレーニング時の比較
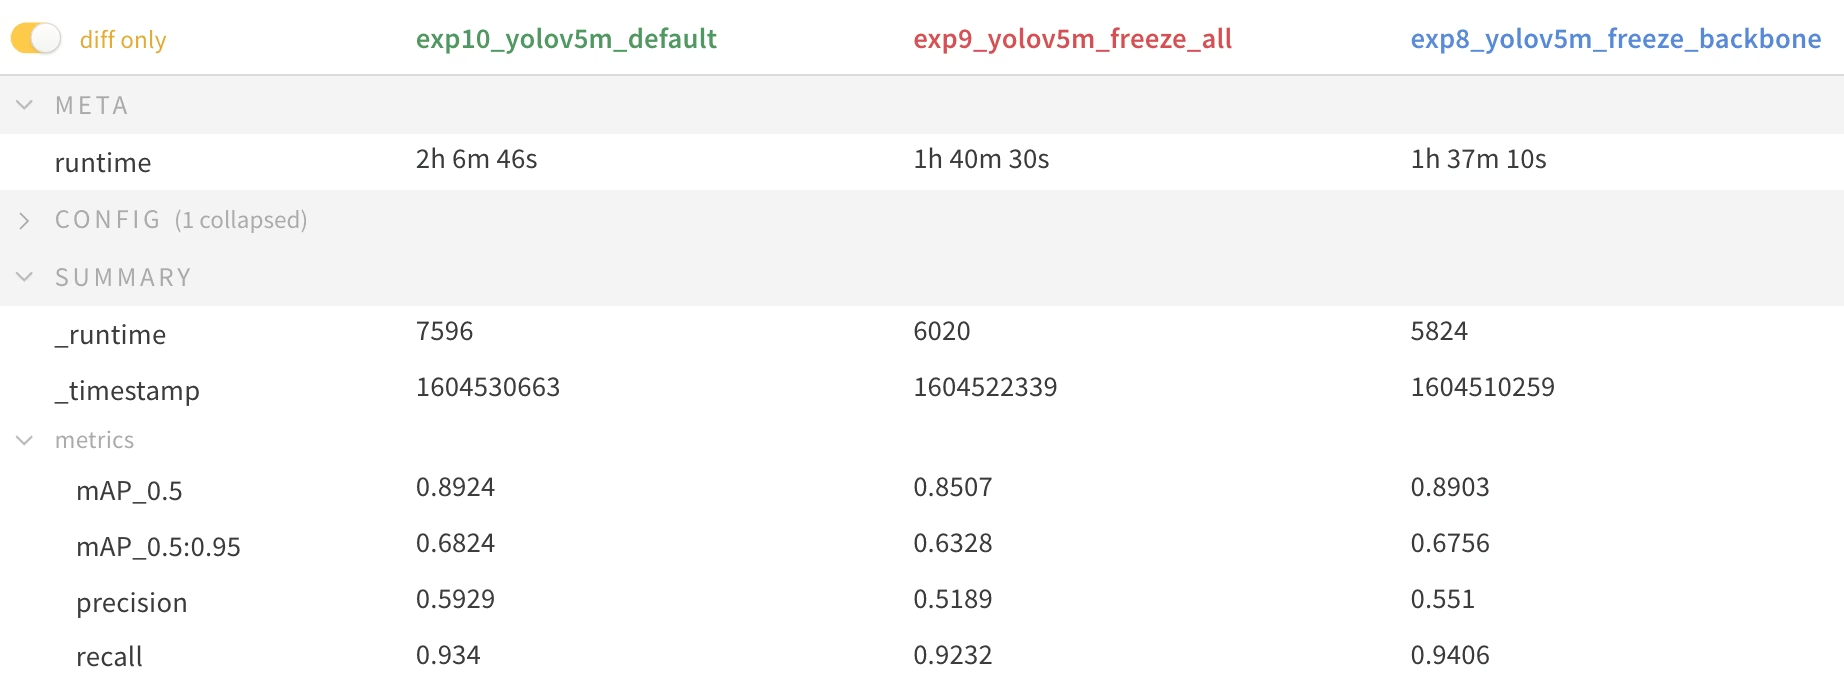 *性能指標の概要表*
リソース使用量#
より多くのレイヤーを凍結すると、GPUメモリの必要量と全体的な使用量が大幅に減少します。そのため、凍結レイヤーを用いた転移学習は、ハードウェアリソースが限られている場合に有効な選択肢です。通常は難しい大規模モデルのトレーニングや、より大きな画像サイズの使用が可能になります。
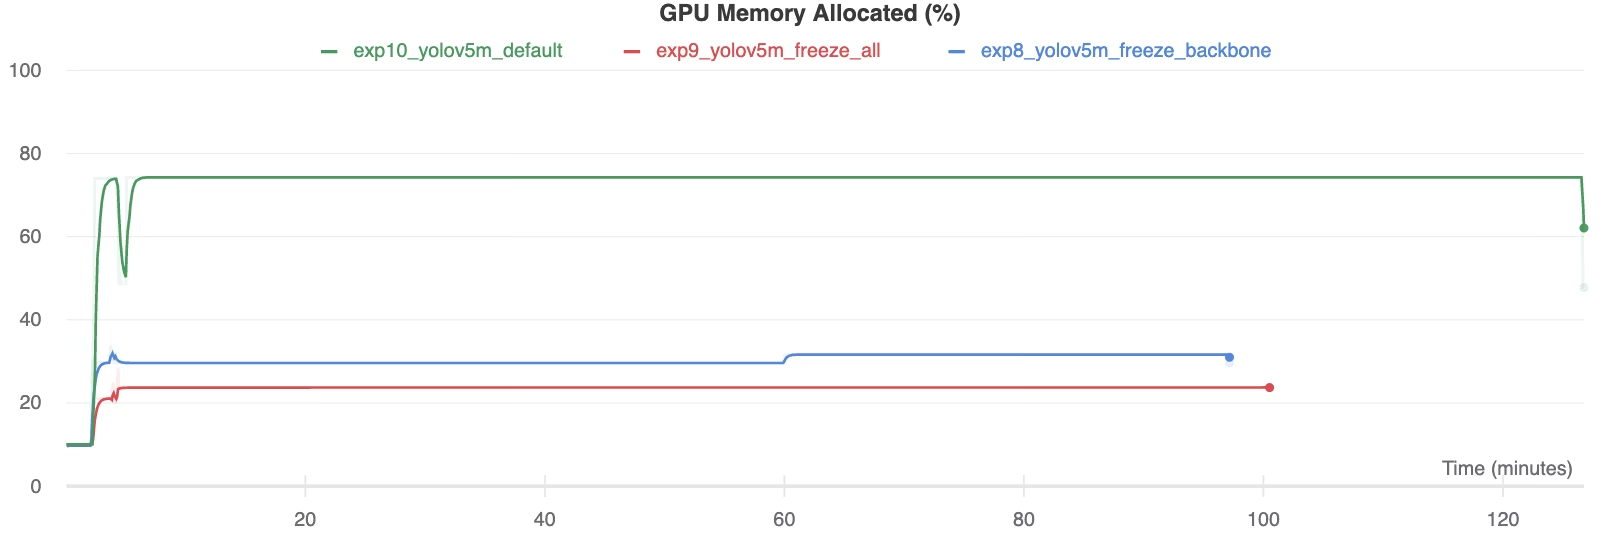 GPUメモリ割り当て量(%)
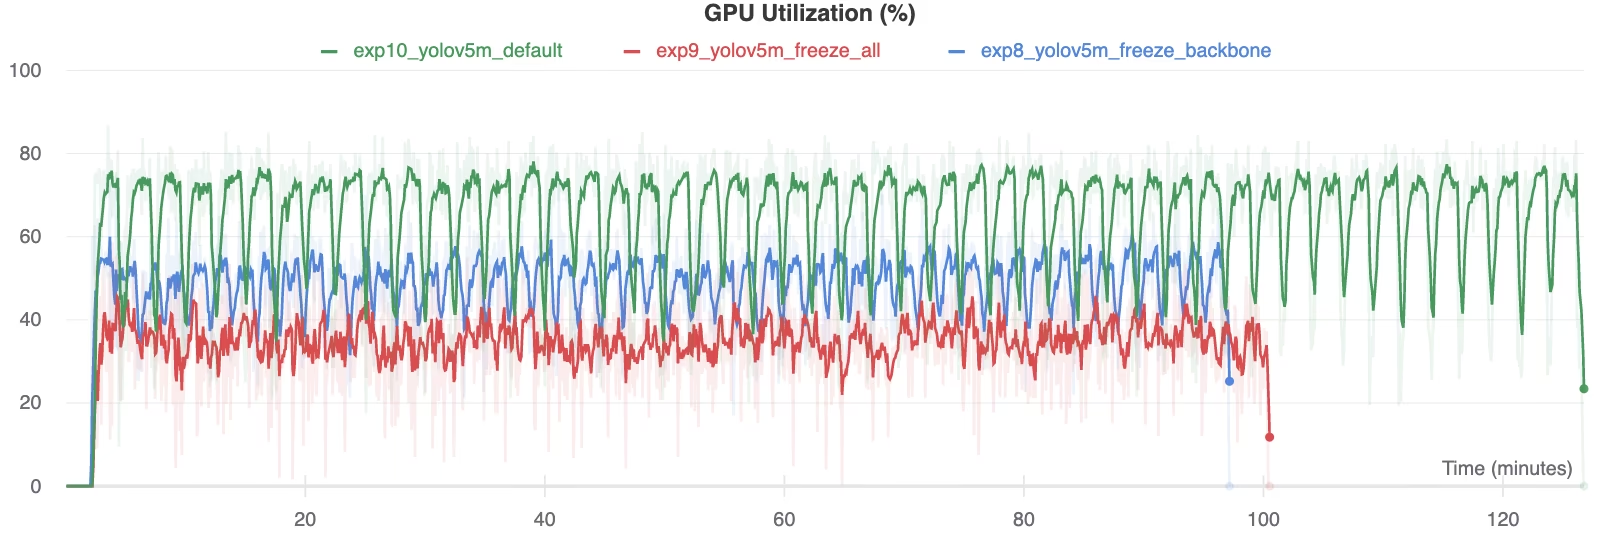 GPU使用率(%)
レイヤー凍結を使用する場面#
転移学習中のレイヤー凍結は、特に次のような状況で有効です:
- 計算リソースが限られている場合: GPUメモリや処理能力に制約がある場合です。
- 小規模なデータセット: 対象データセットが事前学習に使用した元のデータセットより大幅に小さい場合、凍結によって過学習を防ぎやすくなります。
- 迅速なプロトタイピング: 初期評価のために、既存のモデルを新しいタスクやドメインにすばやく適応させる必要がある場合です。
- 特徴ドメインが類似している場合: 新しいデータセットの低レベル特徴が、モデルの事前学習に使用したデータセットの特徴と非常に似ている場合です。
転移学習の詳細については、用語集の項目をご覧ください。また、性能の最適化にはハイパーパラメーターの進化もご検討ください。
サポート対象の環境#
Ultralyticsは、CUDA、CuDNN、Python、PyTorchなどの必須依存関係がプリインストールされた、すぐに使用できるさまざまな環境を提供しています。
- 無料のGPUノートブック:


- Google Cloud: GCPクイックスタートガイド
- Amazon: AWSクイックスタートガイド
- Azure: AzureMLクイックスタートガイド
- Docker: Dockerクイックスタートガイド

プロジェクトのステータス#

このバッジは、YOLOv5 GitHub Actionsの継続的インテグレーション(CI)テストがすべて正常に合格したことを示します。これらのCIテストでは、トレーニング、検証、推論、エクスポート、ベンチマークなどの主要な処理におけるYOLOv5の機能と性能を厳密に評価します。macOS、Windows、Ubuntuで一貫して確実に動作することを確認するため、テストは24時間ごと、および新しいコードがコミットされるたびに自動実行されます。
よくある質問#
model.modelの最初のN個のモジュールを凍結するため、それらの重みは固定され、勾配を受け取りません。--freeze 10はバックボーンを凍結し、--freeze 24は最後のDetectモジュール以外をすべて凍結します。上記のVOC実験では、すべてのレイヤーをトレーニングした場合にmAPが最も高く、バックボーンを凍結すると精度が少し低下し、検出ヘッド以外をすべて凍結すると低下幅が最も大きくなりました。その代わり、凍結した場合はトレーニングが速くなり、GPUメモリの使用量も大幅に減ります。
画像が事前学習データと低レベル特徴を共有している場合、データセットが小さい場合、または限られたハードウェアで迅速にベースラインを作成する必要がある場合に有効です。データセットが大きくなったときや、mAPをさらに高める必要があるときは、すべてのレイヤーをトレーニングしてください。
はい。凍結したモデルの
best.ptから新しい実行を開始し、--freezeを指定せずにネットワーク全体をファインチューニングします。通常は学習率を下げて実行します。