YOLOv5クイックスタート 🚀
このガイドでは、Ultralytics YOLOv5 によるリアルタイム物体検出の基本を説明します。インストール、PyTorch Hub と detect.py を使用した推論、トレーニングを取り上げ、このディープラーニングモデルを独自のプロジェクトに活用できるようにします。
インストール#
YOLOv5 リポジトリをクローンし、Python>=3.8.0 と PyTorch>=1.8 がインストールされた環境に、要件をインストールします。
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
PyTorch Hubでの推論#
PyTorch Hub を介して YOLOv5 の推論を実行します。この方法では、最新の YOLOv5 リリースからモデルが自動的にダウンロードされます。モデルの読み込みと実行には PyTorch を使用するため、簡単に予測を取得できます。
import torch

# モデルの読み込み
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # 「yolov5n」から「yolov5x6」まで、または「custom」を指定できます

# 画像での推論
img = "https://ultralytics.com/images/zidane.jpg"  # ファイル、Path、PIL、OpenCV、numpy、または画像のリストを指定できます

# 推論を実行
results = model(img)

# 結果を表示
results.print()  # or .show(), .save(), .crop(), .pandas(), etc.
detect.py による推論#
幅広いソースに対する推論には detect.py を使用します。最新の YOLOv5 リリースからモデルを自動的に取得し、結果を runs/detect に保存します。このスクリプトは、コマンドラインでの使用や大規模システムへの YOLOv5 の統合に最適で、画像、動画、ディレクトリ、ウェブカメラ、さらにはライブストリームなどの入力に対応しています。
python detect.py --weights yolov5s.pt --source 0                              # webcam
python detect.py --weights yolov5s.pt --source image.jpg                      # image
python detect.py --weights yolov5s.pt --source video.mp4                      # video
python detect.py --weights yolov5s.pt --source screen                         # screenshot
python detect.py --weights yolov5s.pt --source path/                          # directory
python detect.py --weights yolov5s.pt --source list.txt                       # list of images
python detect.py --weights yolov5s.pt --source list.streams                   # list of streams
python detect.py --weights yolov5s.pt --source 'path/*.jpg'                   # glob pattern
python detect.py --weights yolov5s.pt --source 'https://youtu.be/LNwODJXcvt4' # YouTube video
python detect.py --weights yolov5s.pt --source 'rtsp://example.com/media.mp4' # RTSP, RTMP, HTTP streamトレーニング#
以下のトレーニング手順に従って、YOLOv5 COCO データセットのベンチマークを再現します。必要なモデルとデータセット(coco128.yaml や完全版の coco.yaml など)は、最新の YOLOv5 リリースから直接取得されます。V100 GPUで YOLOv5n/s/m/l/x をトレーニングする場合、通常それぞれ 1/2/4/6/8 日かかります(マルチ GPU トレーニング構成では、より高速に処理できます)。可能な限り高い --batch-size を使用するか、YOLOv5 のAutoBatch機能に --batch-size -1 を使用して、パフォーマンスを最大化します。この機能は最適なバッチサイズを自動的に検出します。以下のバッチサイズは V100-16GB GPU に最適です。モデル構成ファイル(*.yaml)の詳細については、アーキテクチャの概要をご覧ください。
# Train YOLOv5n on COCO128 for 3 epochs
python train.py --data coco128.yaml --epochs 3 --weights yolov5n.pt --batch-size 128

# Train YOLOv5s on COCO for 300 epochs
python train.py --data coco.yaml --epochs 300 --weights '' --cfg yolov5s.yaml --batch-size 64

# Train YOLOv5m on COCO for 300 epochs
python train.py --data coco.yaml --epochs 300 --weights '' --cfg yolov5m.yaml --batch-size 40

# Train YOLOv5l on COCO for 300 epochs
python train.py --data coco.yaml --epochs 300 --weights '' --cfg yolov5l.yaml --batch-size 24

# Train YOLOv5x on COCO for 300 epochs
python train.py --data coco.yaml --epochs 300 --weights '' --cfg yolov5x.yaml --batch-size 16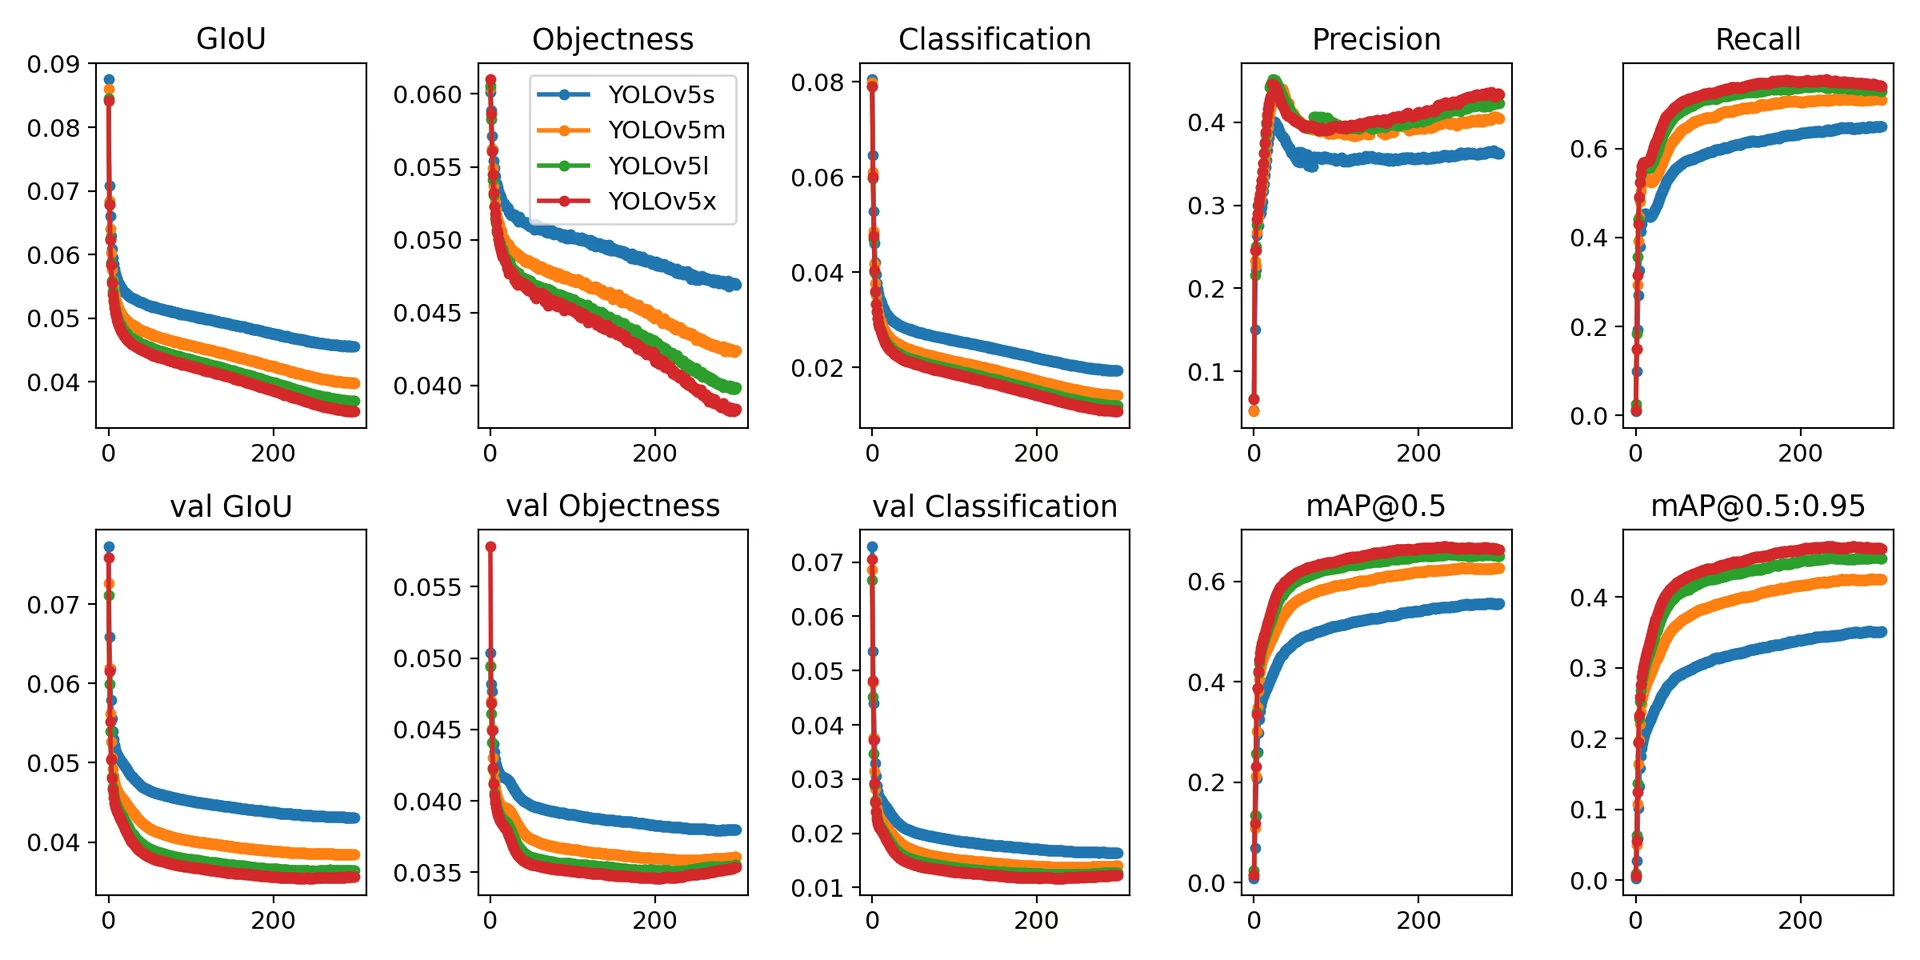
YOLOv5 をコンピュータービジョンプロジェクトに活用する際は、GitHub リポジトリで質問したり、ほかの開発者や研究者と成果を共有したりできます。また、コードを使わずにデータセット管理やモデルのトレーニングを行える Ultralytics Platform を利用したり、実世界での活用例を紹介する Solutions ページを閲覧したりできます。
よくある質問#
推論の場合は不要です。PyTorch Hub は
torch.hub.load("ultralytics/yolov5", "yolov5s")を使用して、必要に応じてコードと重みをダウンロードします。train.py、val.py、detect.py、export.pyの各スクリプトを実行するには、クローンが必要です。ほとんどのプロジェクトでは、速度と精度のバランスに優れた
yolov5s.ptがおすすめです。エッジデバイスにはyolov5n.pt、速度より精度を重視する場合はyolov5m.ptからyolov5x.ptを使用してください。1280 ピクセルでトレーニングする場合は、yolov5s6.ptなどの P6 バリアントを使用します。全モデルの一覧については、事前学習済みチェックポイントの表をご覧ください。画像と YOLO 形式のラベルを、並列の
images/フォルダーとlabels/フォルダーに配置し、dataset.yamlで設定を記述してから、python train.py --data dataset.yaml --weights yolov5s.ptを実行します。カスタムデータのトレーニングチュートリアルでは、各手順を説明しています。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。