カスタムデータでYOLOv5をトレーニングする#
📚 このガイドでは、YOLOv5モデルを使用して、独自のカスタムデータセットをトレーニングする方法を説明します 🚀。カスタムモデルのトレーニングは、一般的な物体検出を超えて、特定の実世界のアプリケーションにコンピュータービジョンソリューションを適合させるための基本的なステップです。
開始する前に#
まず、必要な環境がセットアップされていることを確認します。YOLOv5リポジトリをクローンし、requirements.txt から必要な依存関係をインストールします。Python>=3.8.0環境とPyTorch>=1.8が必要です。モデルとデータセットがローカルに見つからない場合は、最新のYOLOv5リリースから自動的にダウンロードされます。
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependenciesカスタムデータでトレーニングする#
カスタム物体検出モデルの開発は、反復的なプロセスです。
- 画像の収集と整理: 特定のタスクに関連する画像を集めます。高品質で多様なデータが不可欠です。データ収集とアノテーションのガイドをご覧ください。
- オブジェクトのラベル付け: 画像内の対象オブジェクトに正確にアノテーションを付けます。
- モデルのトレーニング: ラベル付きデータを使ってYOLOv5モデルをトレーニングします。事前学習済みの重みから始めることで、転移学習を活用できます。
- デプロイと予測: トレーニング済みモデルを使って、新しい未学習データに対する推論を実行します。
- エッジケースの収集: モデルの性能が低いシナリオ(エッジケース)を特定し、堅牢性を高めるために類似データをデータセットに追加します。このサイクルを繰り返します。
Ultralytics Platformは、データセット管理、モデルのトレーニング、デプロイを含む、この機械学習運用(MLOps)サイクル全体を効率化する、コード不要のソリューションを提供します。
Ultralyticsは、多様な利用シナリオに対応するため、2種類のライセンスを提供しています。
- AGPL-3.0 License: このOSI承認済みのオープンソースライセンスは、オープンな協業と知識共有に熱心な学生、研究者、愛好家に最適です。派生作品を同じライセンスで共有する必要があります。詳細については、LICENSEファイルをご覧ください。
- Enterprise License:開発および本番環境での利用向けのこのライセンスでは、社内ツール、自動化されたワークフロー、本番環境へのデプロイを含むビジネス製品やサービスに、UltralyticsのソフトウェアとAIモデルをシームレスに統合できます。AGPL-3.0のオープンソース要件は適用されません。ご利用を開始するには、Ultralytics Licensingからお問い合わせください。
Ultralytics Licensingページで、ライセンスの選択肢について詳しくご確認ください。
トレーニングを開始する前に、データセットの準備が必要です。
1. データセットを作成する#
YOLOv5モデルがオブジェクトクラスの視覚的特徴を学習するには、ラベル付きデータが必要です。データセットを適切に整理することが重要です。
1.1 dataset.yaml を作成する#
データセット設定ファイル(例: coco128.yaml)には、データセットの構成、クラス名、画像ディレクトリへのパスを記述します。COCO128は、規模の大きいCOCOデータセットから最初の128枚を取り出した小規模なサンプルデータセットです。トレーニングパイプラインの素早いテストや、過学習などの潜在的な問題の診断に役立ちます。
dataset.yaml のファイル構成は次のとおりです。
path: データセットを格納するルートディレクトリです。train、val、test:pathからの相対パスです。トレーニング、検証、テストセットの画像を含むディレクトリ、または画像パスを列挙したテキストファイルを指定します。names: クラスインデックス(0から開始)を対応するクラス名にマッピングする辞書です。
トレーニングをYOLOv5リポジトリのルートから起動する場合、path には絶対ディレクトリ(例: /home/user/datasets/coco128)または ../datasets/coco128 のような相対パスを指定できます。
以下は coco128.yaml の構成です(GitHubで表示。
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 モデルを活用した自動ラベル付け#
手動でのラベル付けは一般的な方法ですが、時間がかかります。基盤モデルを使うと、アノテーションを自動化または半自動化でき、データセットの作成を高速化できます。ラベルの生成に役立つモデルの例を紹介します。
- Google Gemini: Geminiのような大規模マルチモーダルモデルは、高度な画像理解能力を備えています。画像内のオブジェクトの特定と位置の検出を指示でき、バウンディングボックスや説明を生成してYOLO形式のラベルに変換できます。提供されているチュートリアルノートブックで、その可能性をご確認ください。
- SAM2 (Segment Anything Model 2): SAM2のようなセグメンテーションに特化した基盤モデルは、オブジェクトを高精度に特定して輪郭を描画できます。主にセグメンテーション向けですが、生成されたマスクは多くの場合、物体検出タスクに適したバウンディングボックスのアノテーションに変換できます。
- YOLOWorld: このモデルはオープンボキャブラリー検出機能を備えています。対象とするオブジェクトをテキストで説明すると、YOLOWorldは特定のクラスで事前学習されていなくても、画像内のオブジェクトを検出できます。初期ラベルの生成に利用し、その後で調整できます。
これらのモデルを使うと「事前ラベル付け」の工程を設けられ、手作業の負担を軽減できます。ただし、自動生成されたラベルの精度と一貫性を確保するには、確認と調整が不可欠です。ラベルの品質は、トレーニング済みYOLOv5モデルの性能に直接影響します。ラベルを生成し(必要に応じて調整した後)、YOLO形式に準拠していることを確認してください。画像ごとに *.txt ファイルを1つ用意し、各行にオブジェクトを class_index x_center y_center width height(正規化座標、クラスインデックスは0始まり)として記述します。対象オブジェクトがない画像には、対応する *.txt ファイルは必要ありません。
YOLO形式の *.txt ファイルの仕様は厳密に定められています。
- オブジェクトごとに1行のバウンディングボックスを記述します。
- 各行には
class_index x_center y_center width heightを含める必要があります。 - 座標は0から1までの範囲に正規化する必要があります。そのためには、
x_centerとwidthのピクセル値を画像全体の幅で割り、y_centerとheightの値を画像全体の高さで割ります。 - クラスインデックスは0から始まります(つまり、最初のクラスは
0、2番目は1で表し、以降も同様です)。
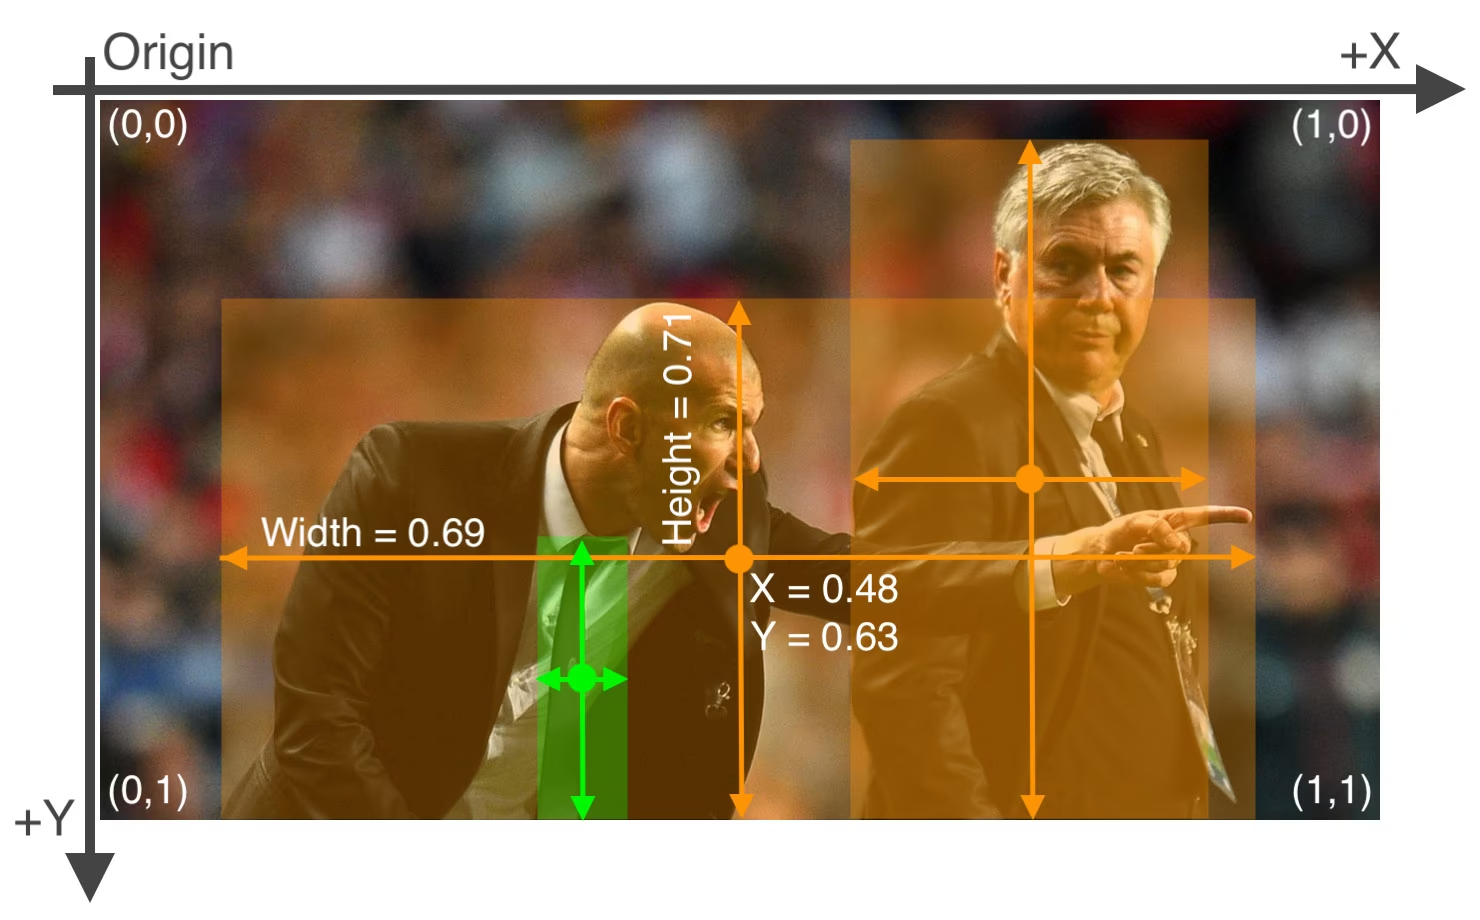
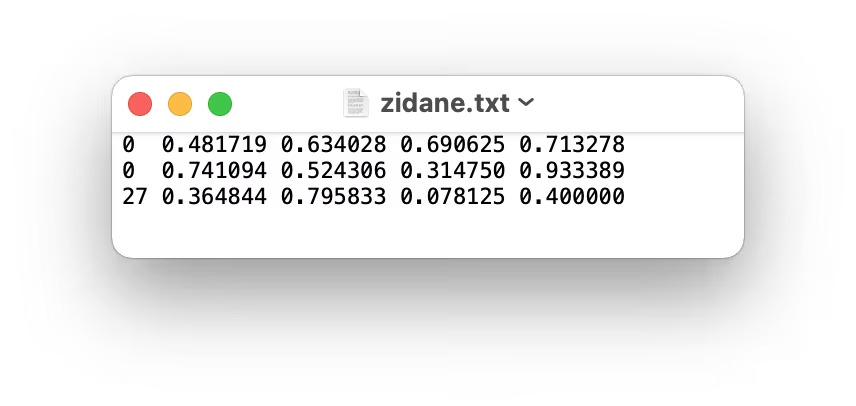
上の画像に対応するラベルファイルには、「person」オブジェクトが2つ(クラスインデックス 0)、「tie」オブジェクトが1つ(クラスインデックス 27)含まれ、次のようになります。
1.3 ディレクトリを整理する#
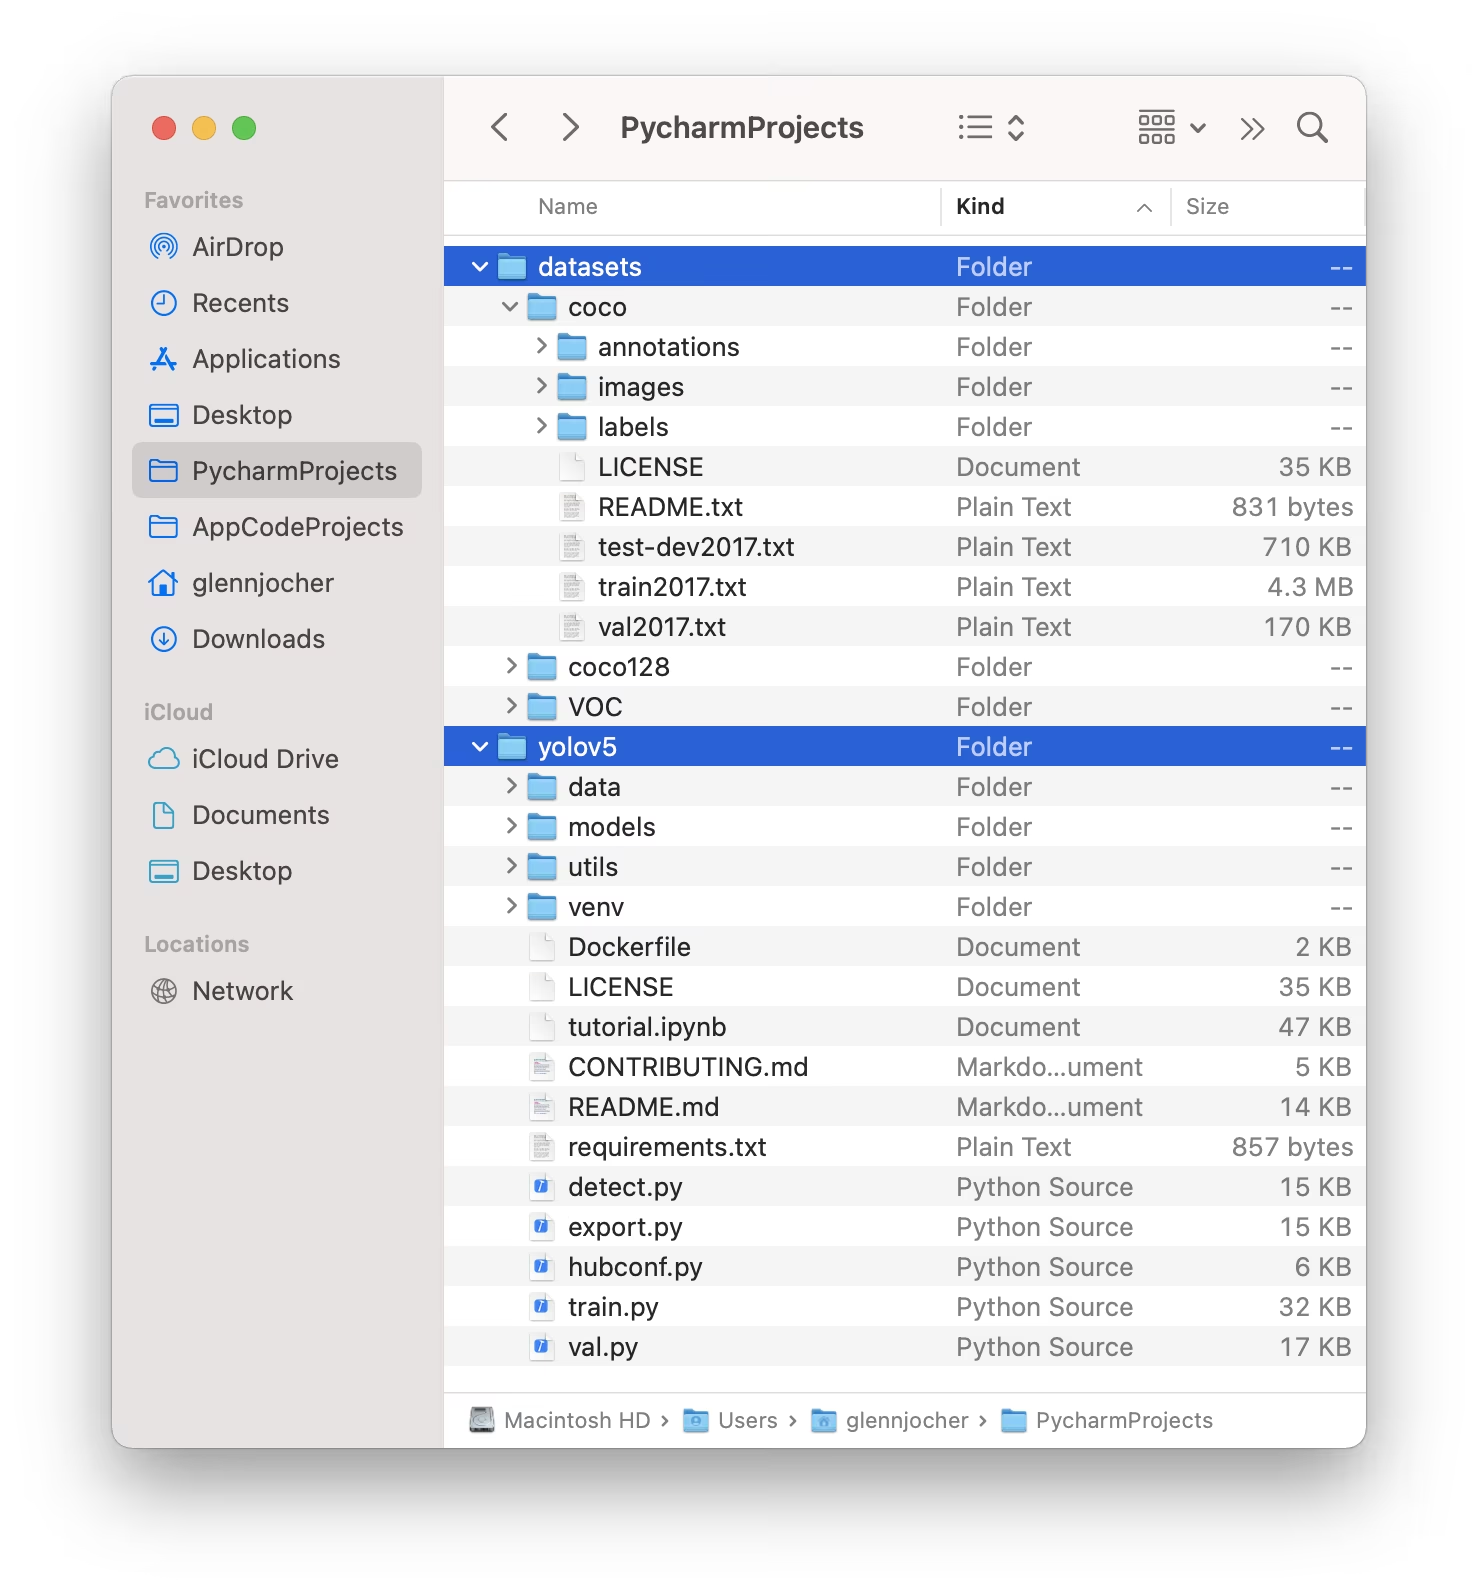
以下の例のようにデータセットディレクトリを構成します。デフォルトでは、YOLOv5はデータセットディレクトリ(例: /coco128)が、/yolov5 リポジトリディレクトリの隣にある /datasets フォルダー内に配置されることを想定しています。
YOLOv5は、画像パス内で最後に出現する /images/ を /labels/ に置き換えて、各画像のラベルを自動的に検索します。例:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
推奨されるディレクトリ構成は次のとおりです。
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. モデルを選択する#
トレーニングを開始するには、事前学習済みモデルを選択します。事前学習済みの重みから始めると、スクラッチからトレーニングする場合に比べて学習が大幅に速くなり、性能も向上します。YOLOv5には、速度と精度のバランスが異なるさまざまなサイズのモデルがあります。たとえば、YOLOv5sは2番目に小さく、2番目に高速なモデルで、リソースが限られた環境に適しています。利用可能なモデルの詳細な比較については、READMEの表をご覧ください。

3. トレーニングする#
train.py スクリプトを使ってモデルのトレーニングを開始します。主な引数は次のとおりです。
--img: 入力画像サイズ(例:--img 640)を定義します。一般に、サイズを大きくすると精度が向上しますが、より多くのGPUメモリが必要になります。--batch: バッチサイズ(例:--batch 16)を指定します。GPUで処理できる最大のサイズを選択してください。--epochs: トレーニングのエポック数(例:--epochs 100)を指定します。1エポックは、トレーニングデータセット全体を1回処理することを意味します。--data:dataset.yamlファイルへのパス(例:--data coco128.yaml)です。--weights: 初期重みファイルへのパスです。事前学習済みの重み(例:--weights yolov5s.pt)を使うと、収束が速くなり、結果も向上するため、強く推奨します。スクラッチからトレーニングする場合(非常に大きなデータセットがあり、特別な要件がある場合を除き推奨しません)は、--weights '' --cfg yolov5s.yamlを使用します。
事前学習済みの重みがローカルに見つからない場合は、最新のYOLOv5リリースから自動的にダウンロードされます。
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt💡 --cache ram または --cache disk を使用すると、データセットの画像をRAMまたはローカルディスクにキャッシュできます。特にデータセットのI/O(入出力)処理がボトルネックの場合、トレーニングを大幅に高速化できます。ただし、十分なRAMまたはディスク容量が必要です。
💡 データセットは必ずローカルに保存してトレーニングしてください。ネットワークドライブ(Google Driveなど)やリモートストレージからデータにアクセスすると、大幅に遅くなり、トレーニング性能が低下する可能性があります。データセットをローカルSSDにコピーするのが最善の方法です。
重みやログを含むすべてのトレーニング出力は、runs/train/ ディレクトリに保存されます。トレーニングセッションごとに、新しいサブディレクトリ(例: runs/train/exp、runs/train/exp2 など)が作成されます。実際に操作しながら学習するには、公式チュートリアルノートブックのトレーニングセクションをご覧ください。

4. 可視化する#
YOLOv5は、トレーニングの進捗の可視化、結果の評価、リアルタイムでの性能監視に使えるさまざまなツールとシームレスに連携します。
Cometによるロギングと可視化#
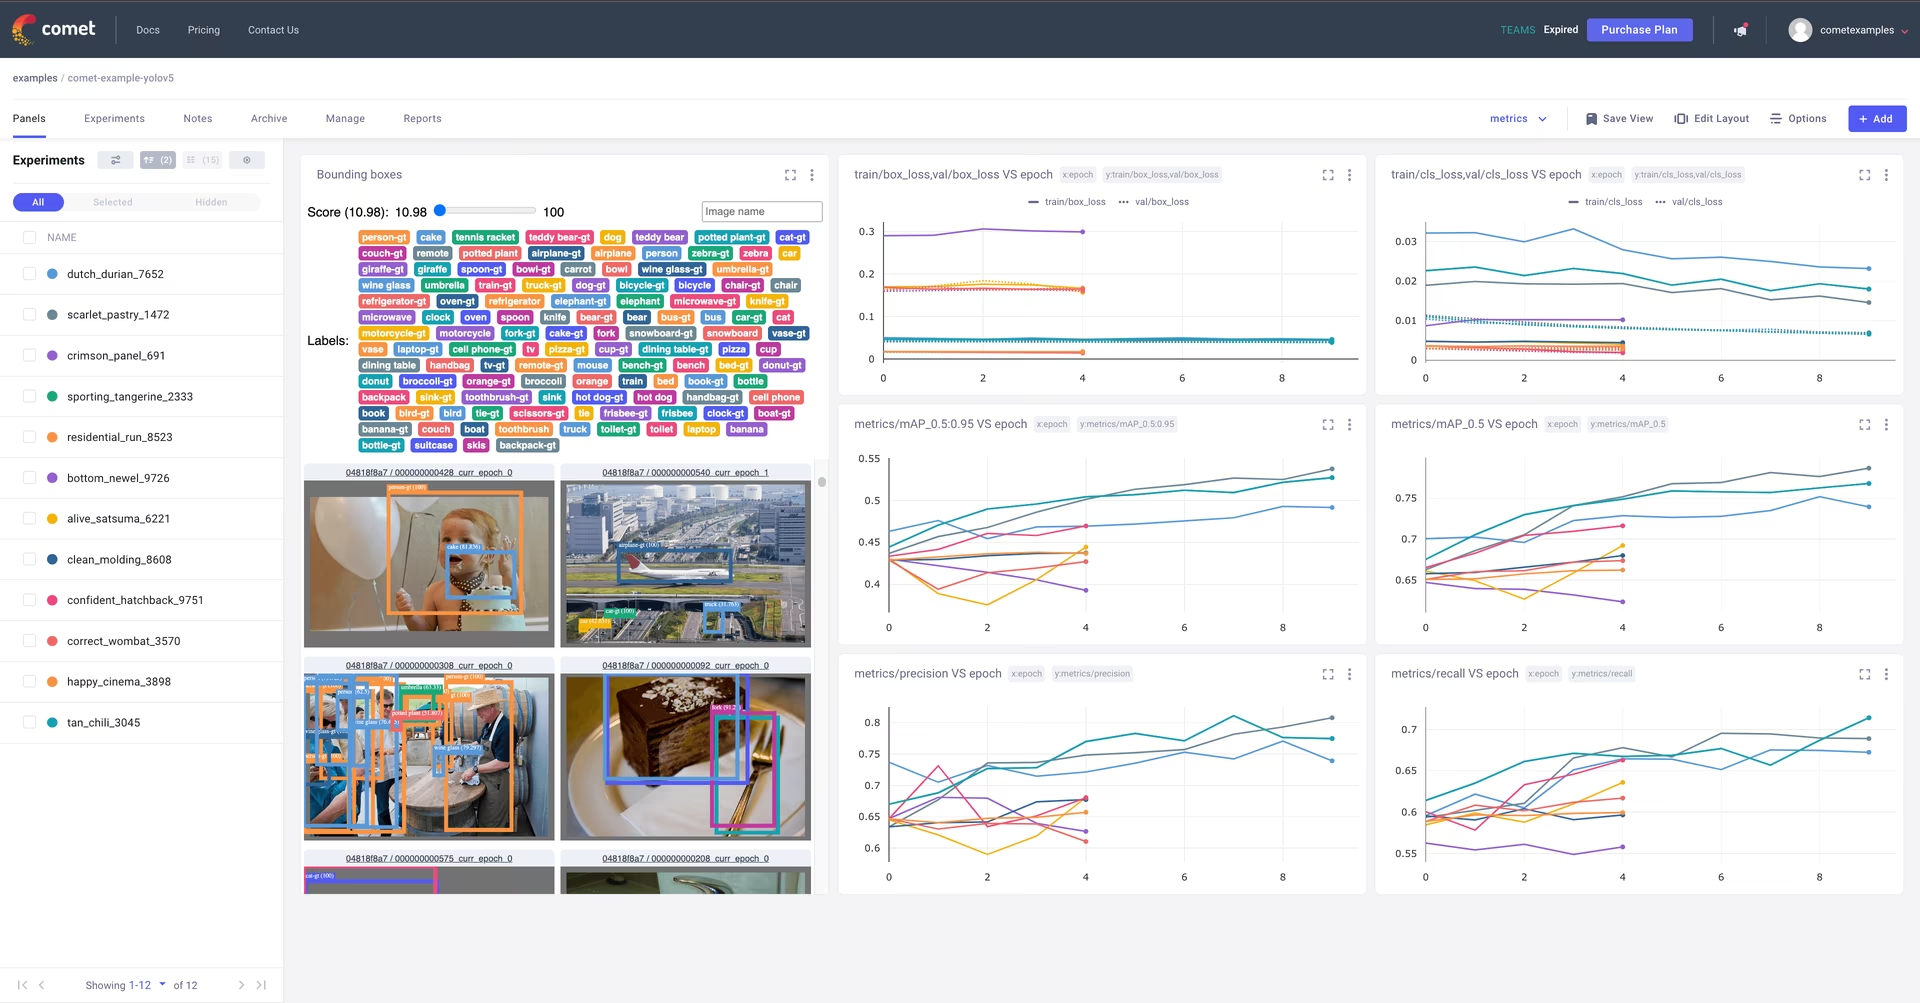
Cometは、包括的な実験追跡のために完全統合されています。メトリクスのリアルタイム表示、ハイパーパラメーターの保存、データセットとモデルのチェックポイントの管理、インタラクティブなComet Custom Panelsを使ったモデル予測の分析が可能です。
簡単な手順で使い始められます。
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!対応機能の詳細は、Comet Integration Guideをご覧ください。Cometの機能については、公式のドキュメントで詳しく確認できます。ライブデモとしてComet Colabノートブックをお試しください:
ClearMLによるロギングと自動化#
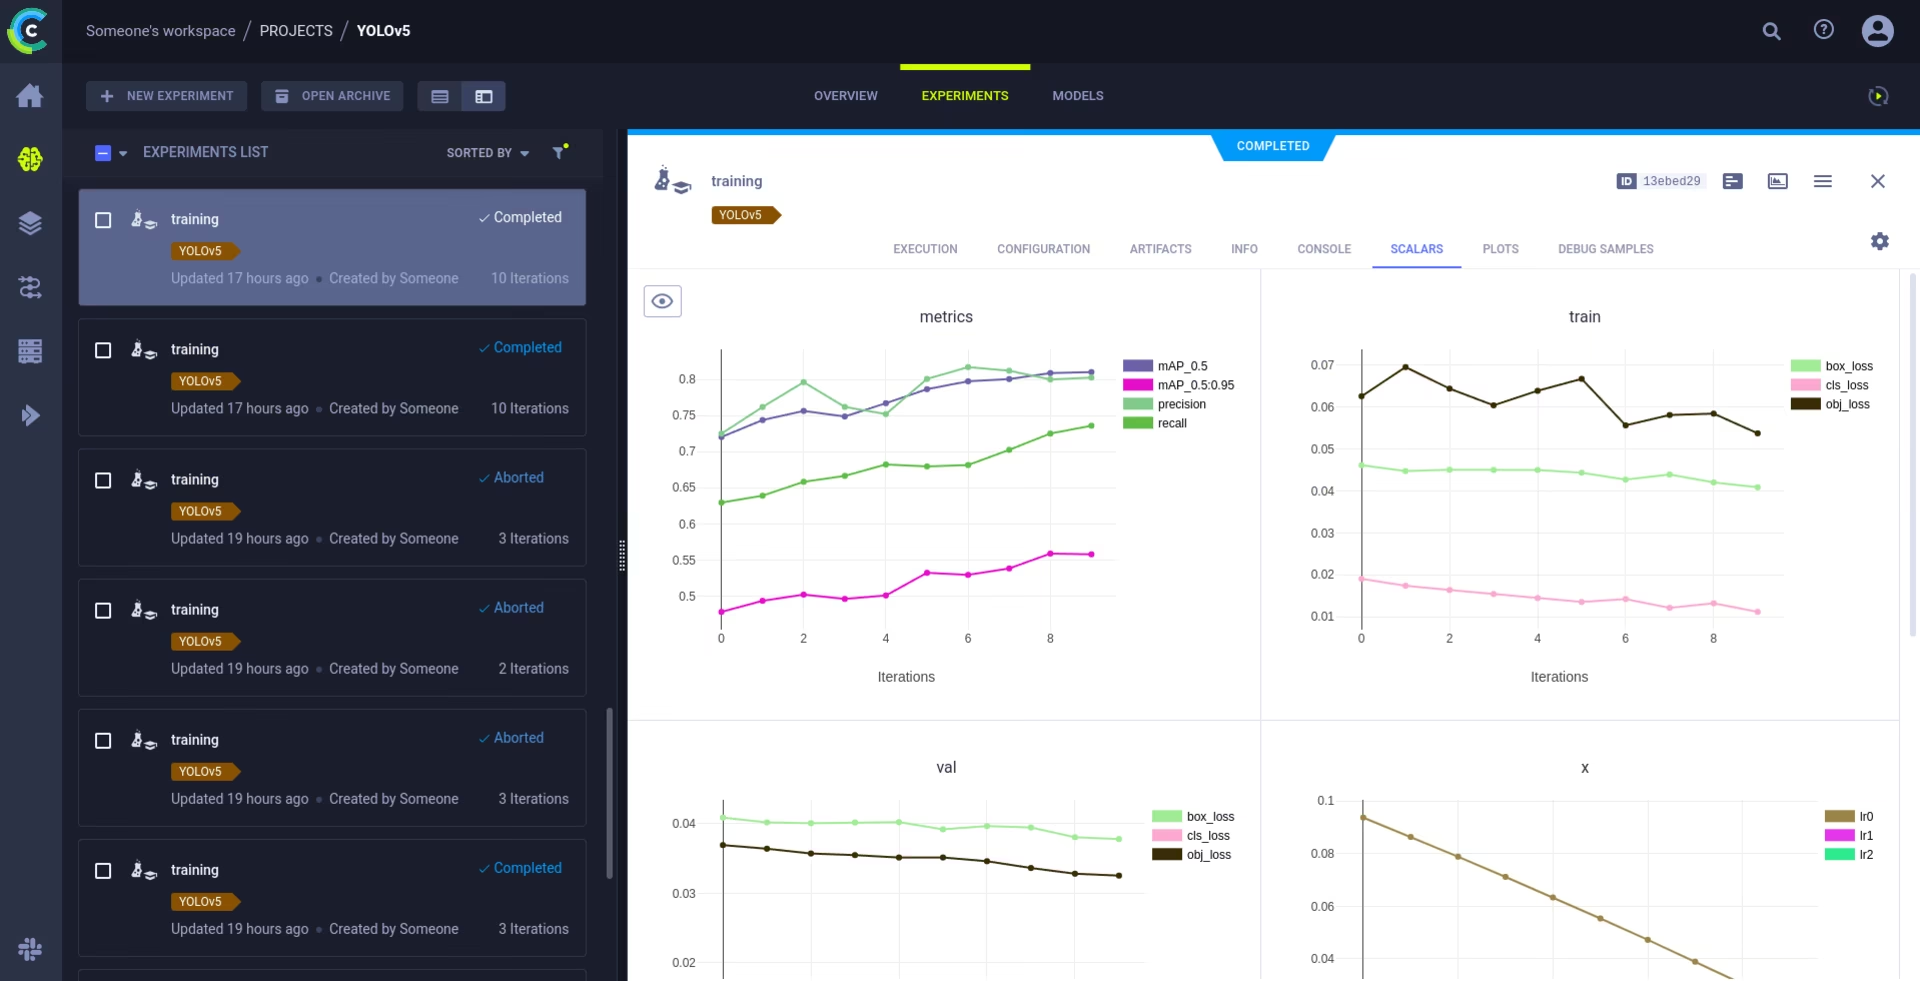
ClearMLとの統合により、詳細な実験追跡、データセットのバージョン管理、トレーニング実行のリモート実行が可能になります。次の簡単な手順でClearMLを有効にできます。
- パッケージをインストールします:
pip install clearml - ClearMLを初期化します:
clearml-initを一度実行して、ClearMLサーバー(セルフホスト型または無料プラン)に接続します。
ClearMLは、実験の詳細、モデルのアップロード、比較、未コミットのコード変更、インストール済みパッケージを自動的に記録し、完全な再現性を確保します。リモートエージェントでトレーニングタスクを簡単にスケジュールし、ClearML Dataを使ってデータセットのバージョンを管理できます。詳しくはClearML Integration Guideをご覧ください。
ローカルでのロギング#
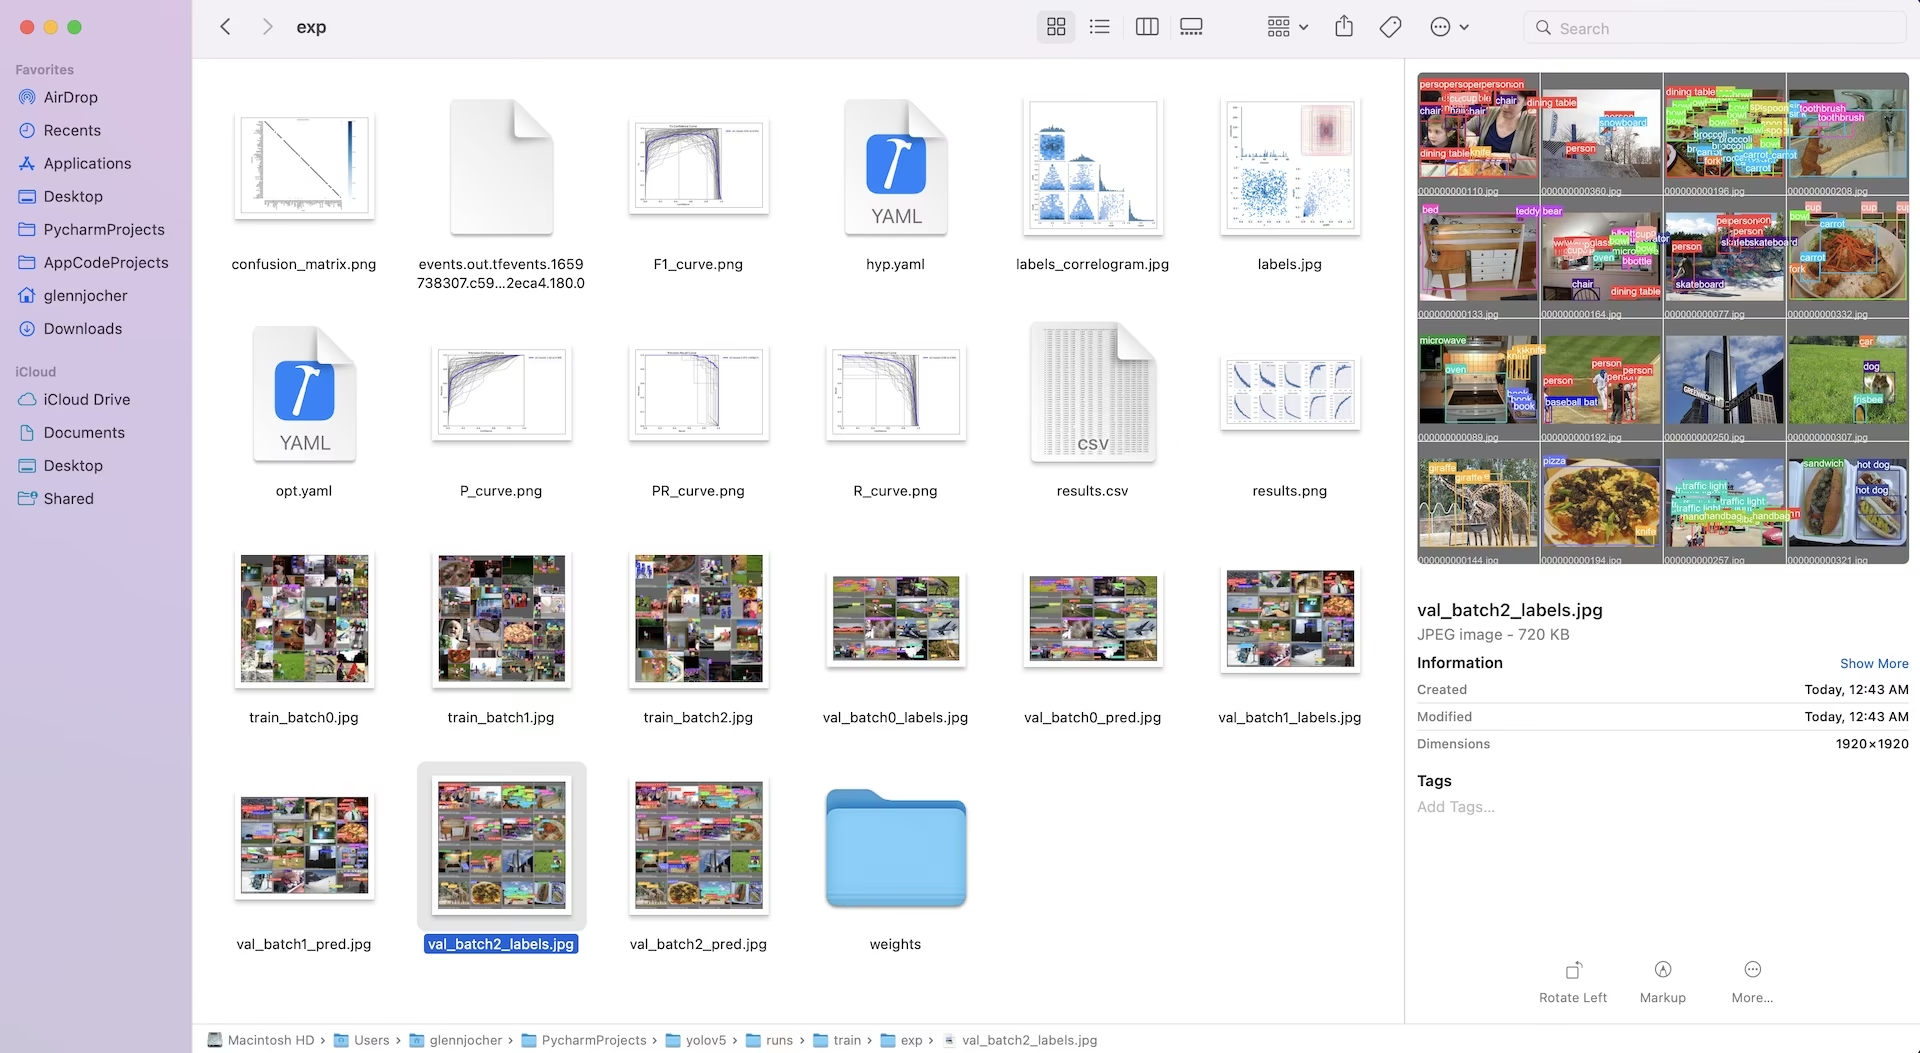
トレーニング結果はTensorBoardで自動的に記録され、各実験ディレクトリ内(例: runs/train/exp)にCSVファイルとして保存されます。記録されるデータは次のとおりです。
- トレーニングと検証の損失および性能メトリクス。
- 適用された拡張(モザイクなど)を示すサンプル画像。
- 目視で確認できるように、正解ラベルとモデルの予測を並べて表示します。
- 適合率-再現率(PR)曲線などの主要な評価メトリクス。
- クラスごとの性能を詳しく分析するための混同行列。
results.csv ファイルは各エポックの後に更新され、トレーニング終了時に results.png としてプロットされます。付属のユーティリティ関数を使って、任意の results.csv ファイルを手動でプロットすることもできます。
from utils.plots import plot_results

# 特定のトレーニング実行ディレクトリの結果をプロットします
plot_results("runs/train/exp/results.csv")  # 同じディレクトリに「results.png」が生成されます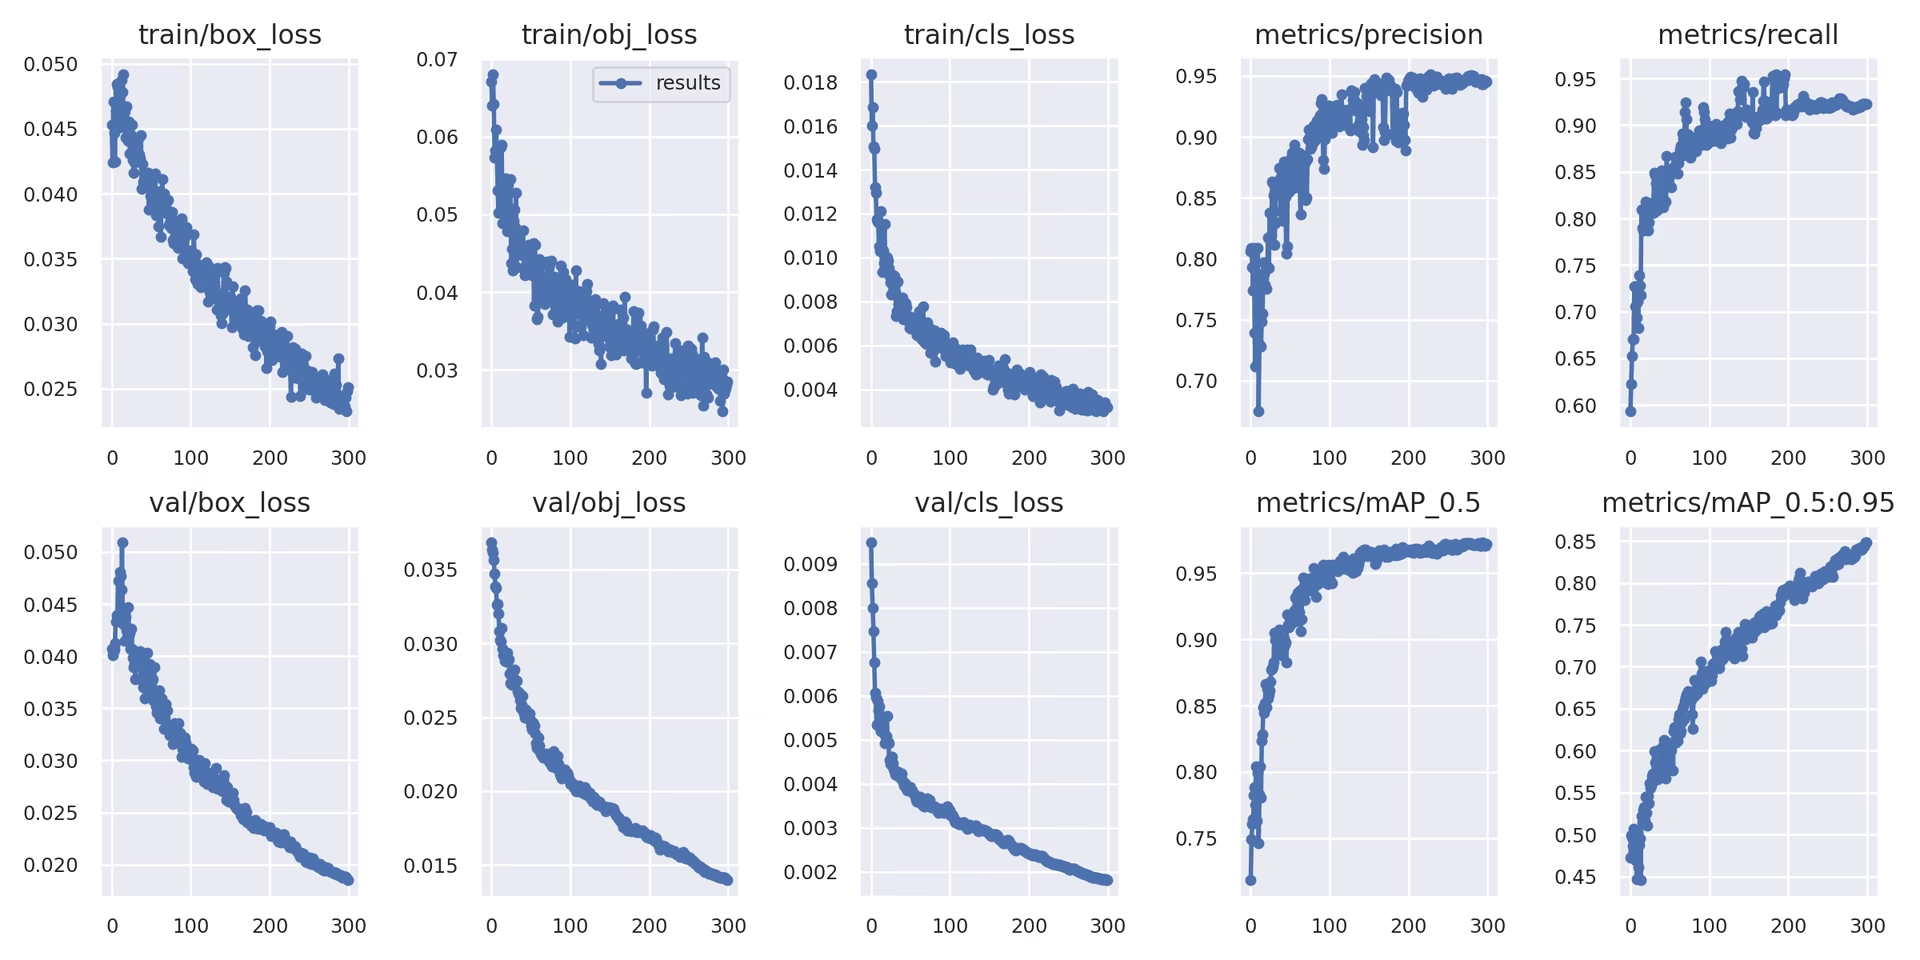
5. 次のステップ#
トレーニングが正常に完了すると、最も性能の高いモデルのチェックポイント(best.pt)が保存され、デプロイまたは追加調整に使用できる状態になります。次のステップとして、以下が考えられます。
- トレーニング済みモデルを使って、CLIまたはPythonから新しい画像や動画の推論を実行します。
val.pyを実行して、異なるデータ分割(例: 保留したテストセット)に対するモデルの精度と汎化性能を評価します。- モデルをエクスポートし、ONNX、TensorFlow SavedModel、TensorRTなど、さまざまなデプロイ形式に変換すると、多様なプラットフォームで推論を最適化できます。
- ハイパーパラメーターの進化を活用し、さらなる性能向上を目指します。
- トレーニング結果を最大化するためのヒントに従い、性能分析に基づいて多様で難易度の高いデータを段階的に追加し、モデルを継続的に改善します。
サポート対象の環境#
Ultralyticsは、CUDA、cuDNN、Python、PyTorchなどの必須依存関係を備えたすぐに使える環境を提供し、スムーズな導入を支援します。
- 無料のGPUノートブック:
- クラウドプラットフォーム:
- Google Cloud: GCPクイックスタートガイド
- Amazon AWS: AWSクイックスタートガイド
- Microsoft Azure: AzureMLクイックスタートガイド
- ローカル環境のセットアップ:
- Docker: Dockerクイックスタートガイド
- Docker: Dockerクイックスタートガイド


プロジェクトのステータス#

このバッジは、すべてのYOLOv5 GitHub Actions 継続的インテグレーション(CI)テストに合格していることを示します。厳格なCIテストでは、macOS、Windows、Ubuntuの各オペレーティングシステムで、トレーニング、検証、推論、エクスポート、ベンチマークなどの主要機能を対象としています。テストは24時間ごと、およびコードのコミットごとに自動実行され、一貫した安定性と最適な性能を確保します。
よくある質問#
カスタムデータセットでYOLOv5をトレーニングするには、いくつかの重要な手順があります。
- データセットを準備する: 画像を収集してアノテーションを付けます。アノテーションが必要なYOLO形式になっていることを確認します。画像とラベルを
train/ディレクトリとval/ディレクトリ(必要に応じてtest/ディレクトリも)に整理します。Google Gemini、SAM2、YOLOWorldなどのモデルを利用して、ラベリングを支援または自動化することもできます(セクション1.2を参照)。 - 環境をセットアップする: YOLOv5リポジトリをクローンし、
pip install -r requirements.txtを使用して依存関係をインストールします。git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - データセット設定を作成する:
dataset.yamlファイルで、データセットのパス、クラス数、クラス名を定義します。 - トレーニングを開始する:
train.pyスクリプトを実行し、dataset.yamlのパス、使用する事前学習済み重み(例:yolov5s.pt)、画像サイズ、バッチサイズ、エポック数を指定します。python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- データセットを準備する: 画像を収集してアノテーションを付けます。アノテーションが必要なYOLO形式になっていることを確認します。画像とラベルを
Ultralytics Platformは、コードを記述せずにYOLOモデル開発のライフサイクル全体を効率化できる総合プラットフォームです。主なメリットは次のとおりです。
- シンプルなトレーニング: 事前設定済みの環境と直感的なユーザーインターフェースを使用して、簡単にモデルをトレーニングできます。
- 統合データ管理: プラットフォーム上でデータセットを効率的にアップロードし、バージョン管理および管理できます。
- リアルタイム監視: トレーニングの進捗を追跡し、パフォーマンス指標が送られてくると同時に可視化できます。
- コラボレーション機能: リソースの共有、プロジェクト管理ツール、簡単なモデル共有により、チームワークを促進します。
- ノーコードでのデプロイ: トレーニング済みモデルをさまざまなターゲットに直接デプロイできます。
実践的な手順については、ブログ記事Ultralytics Platformでカスタムモデルをトレーニングする方法をご覧ください。
手動でアノテーションする場合も、自動化ツール(セクション1.2で紹介したものなど)を使用する場合も、最終的なラベルはYOLOv5で必要となる特定のYOLO形式にする必要があります。
- 画像ごとに
.txtファイルを1つ作成します。ファイル名は画像のファイル名と一致させます(例:image1.jpgはimage1.txtに対応します)。これらのファイルを、images/ディレクトリと同じ階層にあるlabels/ディレクトリ(例:../datasets/mydataset/labels/train/)に配置します。 .txtファイルの各行は1つのオブジェクトのアノテーションを表し、次の形式に従います:class_index center_x center_y width height。- 座標(
center_x、center_y、width、height)は、画像の寸法を基準に正規化する必要があります(値は0.0から1.0の範囲)。 - クラスインデックスはゼロ始まりです(最初のクラスは
0、2番目のクラスは1など)。
多くの手動アノテーションツールには、YOLO形式への直接エクスポート機能があります。自動化モデルを使用する場合は、その出力(バウンディングボックスの座標やセグメンテーションマスクなど)を、この特定の正規化テキスト形式に変換するスクリプトまたは処理が必要です。最終的なデータセット構造が、ガイドに示されている例に準拠していることを確認してください。詳しくは、データ収集とアノテーションのガイドをご覧ください。
- 画像ごとに
Ultralyticsでは、さまざまなニーズに合わせて柔軟なライセンスを提供しています。
- AGPL-3.0ライセンス: このオープンソースライセンスは、学術研究、個人プロジェクト、オープンソースの要件に準拠できる場合に適しています。変更物や派生物もAGPL-3.0の下でオープンソースにすることが義務付けられています。AGPL-3.0ライセンスの詳細をご確認ください。
- エンタープライズライセンス: YOLOv5を独自製品またはサービスに組み込む企業向けの商用ライセンスです。このライセンスではAGPL-3.0のオープンソース要件がなくなり、ソースを非公開にしたまま配布できます。詳しくはライセンスページをご覧いただくか、エンタープライズライセンスをお申し込みください。
プロジェクトの要件と配布モデルに最も適したライセンスを選択してください。