YOLOv5のトレーニング結果を最大限に高めるためのヒント
このガイドでは、YOLOv5 で最高の mAP とトレーニング結果を得る方法を説明します。
ほとんどの場合、データセットのサイズが十分で、適切にラベル付けされていれば、モデルやトレーニング設定を変更しなくても良い結果を得られます。最初に良い結果が得られなくても、改善のためにできることはありますが、変更を検討する前に、まずはすべてのデフォルト設定でトレーニングすることを常に推奨します。これにより、パフォーマンスのベースラインを確立し、改善すべき点を見つけられます。
トレーニング結果について質問する場合は、有益な回答を得るために、できるだけ多くの情報を提示してください。損失のプロット(トレーニング損失、検証損失、P、R、mAP)、PR 曲線、混同行列、トレーニング時のモザイク、テスト結果、labels.png などのデータセット統計画像が含まれます。これらはすべて project/name ディレクトリにあり、通常は yolov5/runs/train/exp に保存されています。
以下のセクションでは、YOLOv5 のトレーニング結果に影響する主な要因を説明します。
データセット#
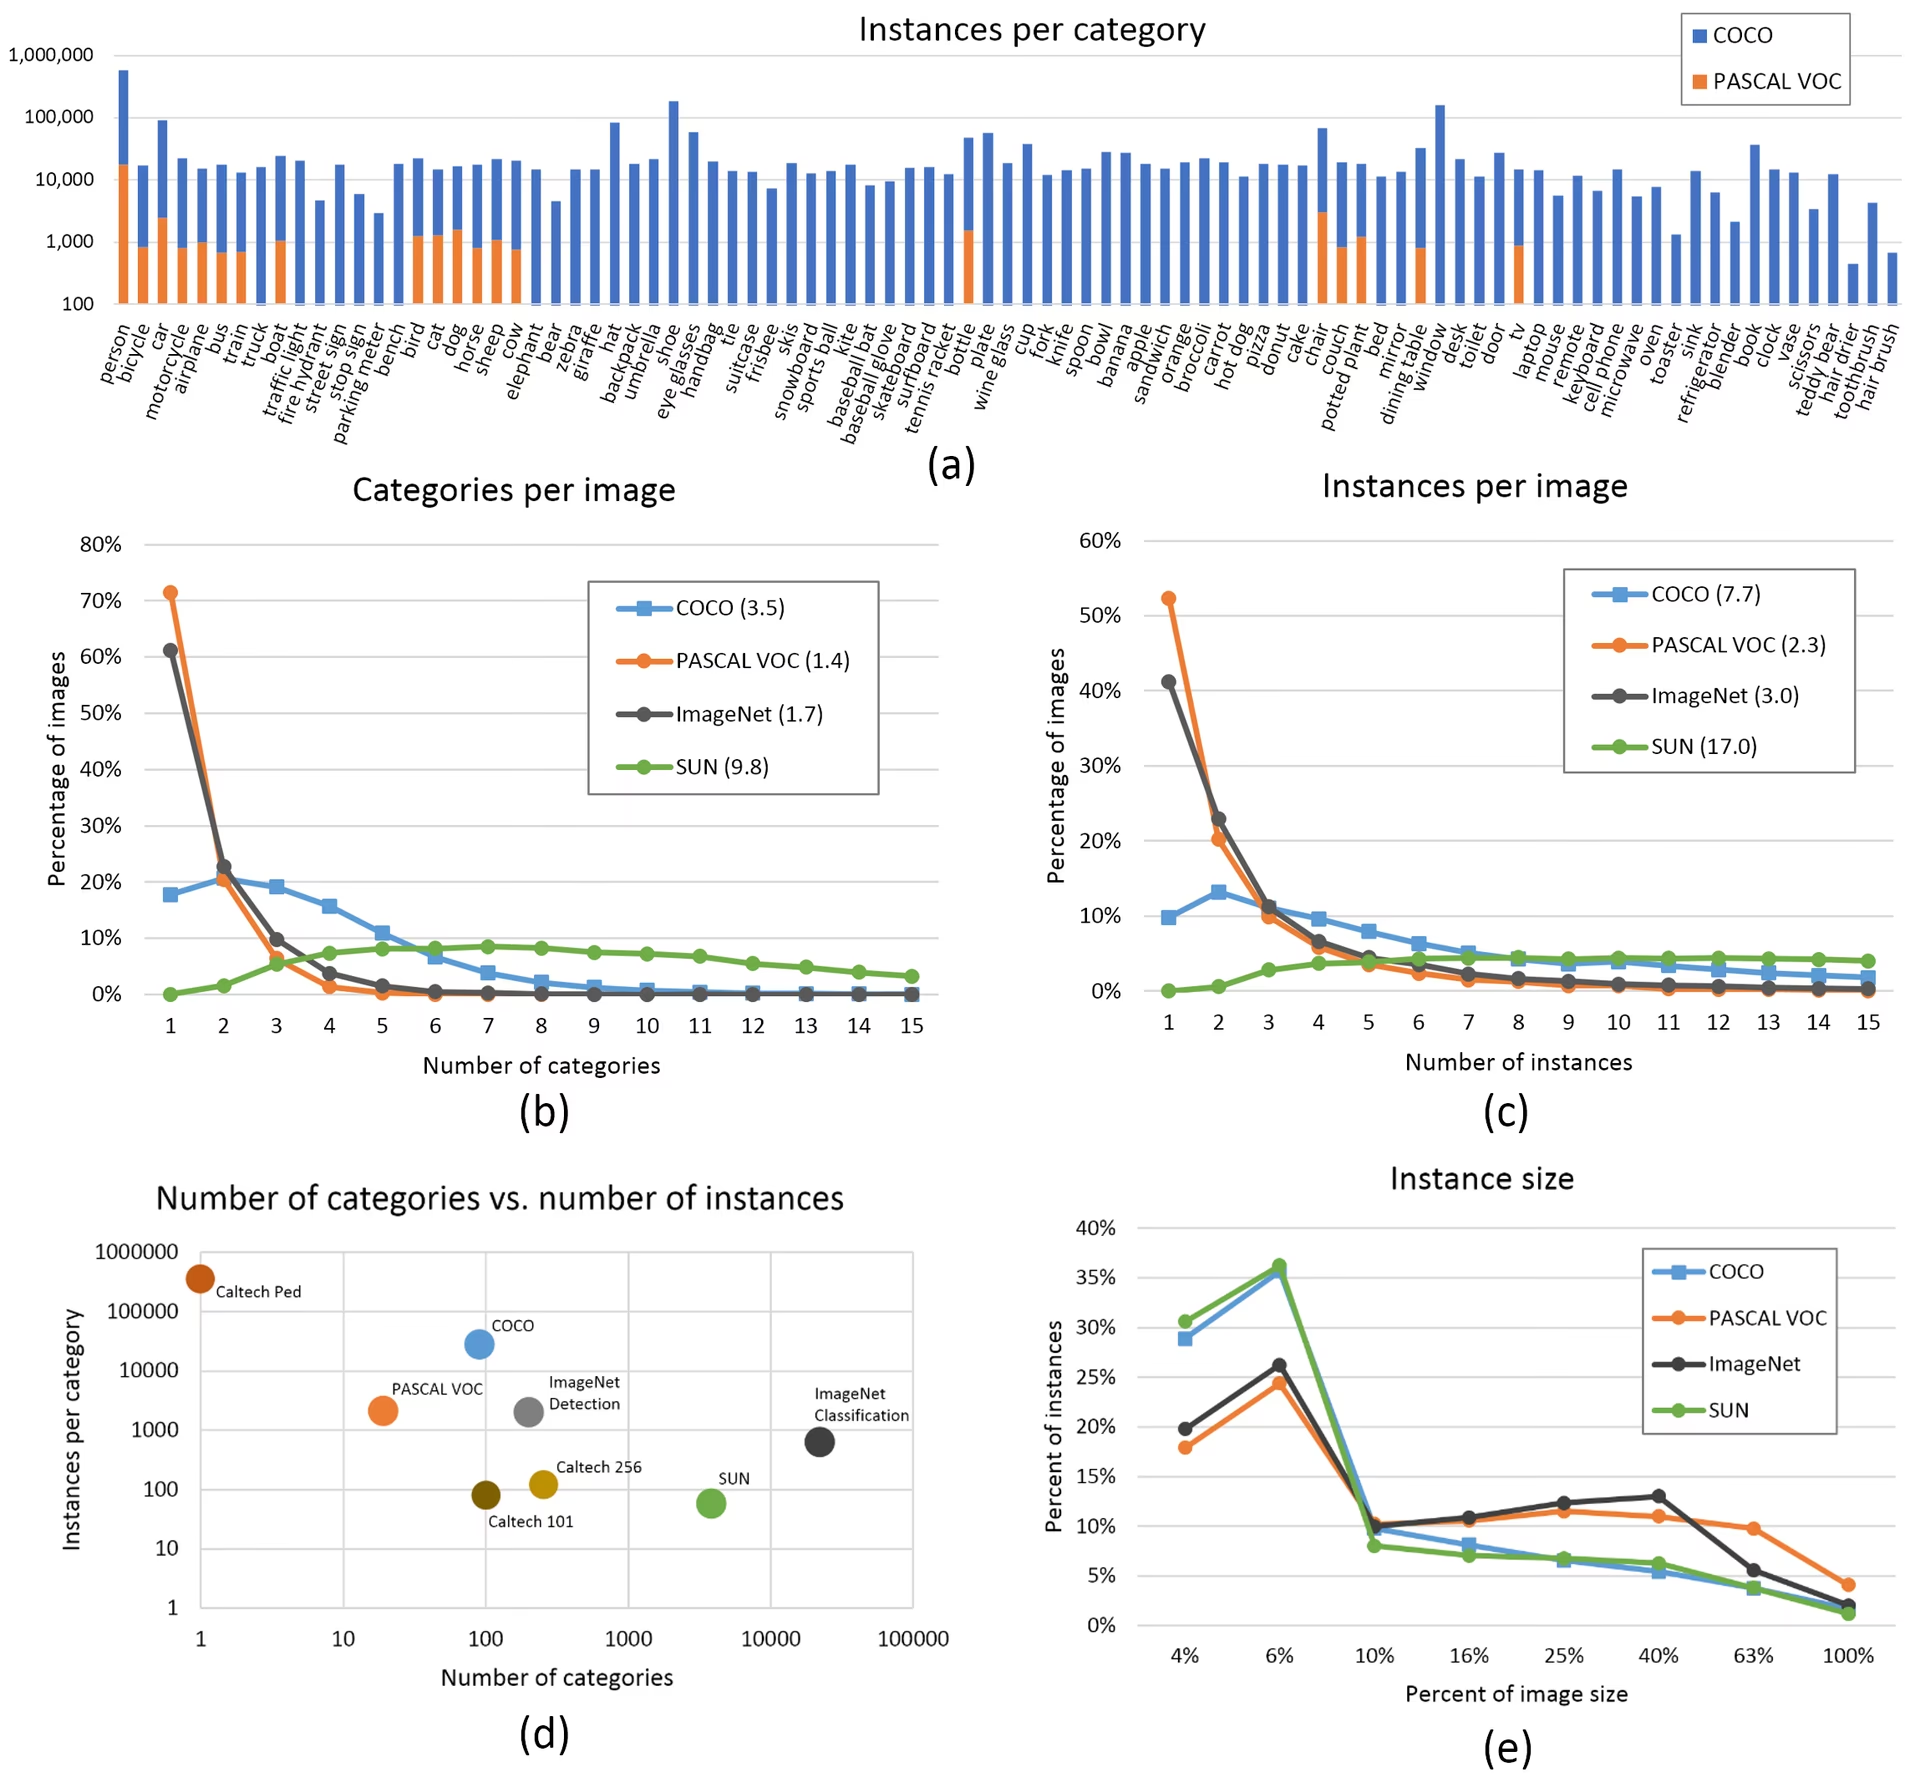
- クラスあたりの画像数。 クラスあたり1500枚以上を推奨します
- クラスあたりのインスタンス数。 クラスあたり10000個以上のインスタンス(ラベル付けされたオブジェクト)を推奨します
- 画像の多様性。 デプロイ先の環境を代表する画像を用意する必要があります。実環境での使用を想定する場合は、時間帯、季節、天候、照明、角度、入手元(オンラインから収集、ローカルで収集、異なるカメラ)などが異なる画像をおすすめします。
- ラベルの一貫性。 すべての画像内のすべてのクラスの全インスタンスにラベルを付ける必要があります。一部だけのラベル付けでは機能しません。
- ラベルの精度。 ラベルは各オブジェクトを正確に囲む必要があります。オブジェクトとそのバウンディングボックスの間に隙間があってはいけません。ラベルの付いていないオブジェクトがあってはいけません。
- train/val分割の徹底。 過度に楽観的な指標を避けるため、検証画像とテスト画像がトレーニングセットに含まれないようにします。分割間でクラスの分布を同程度に保ちます。
- ラベルの検証。 トレーニング開始時に
train_batch*.jpgのモザイクを表示し、ラベルが正しく見えることを確認します。 - 背景画像。 背景画像とは、False Positive(FP)を減らすためにデータセットに追加する、オブジェクトのない画像です。FPを減らすため、背景画像の割合は約0~10%を推奨します(参考として、COCOには背景画像が1000枚あり、全体の1%に相当します)。背景画像にラベルは必要ありません。
モデルの選択#
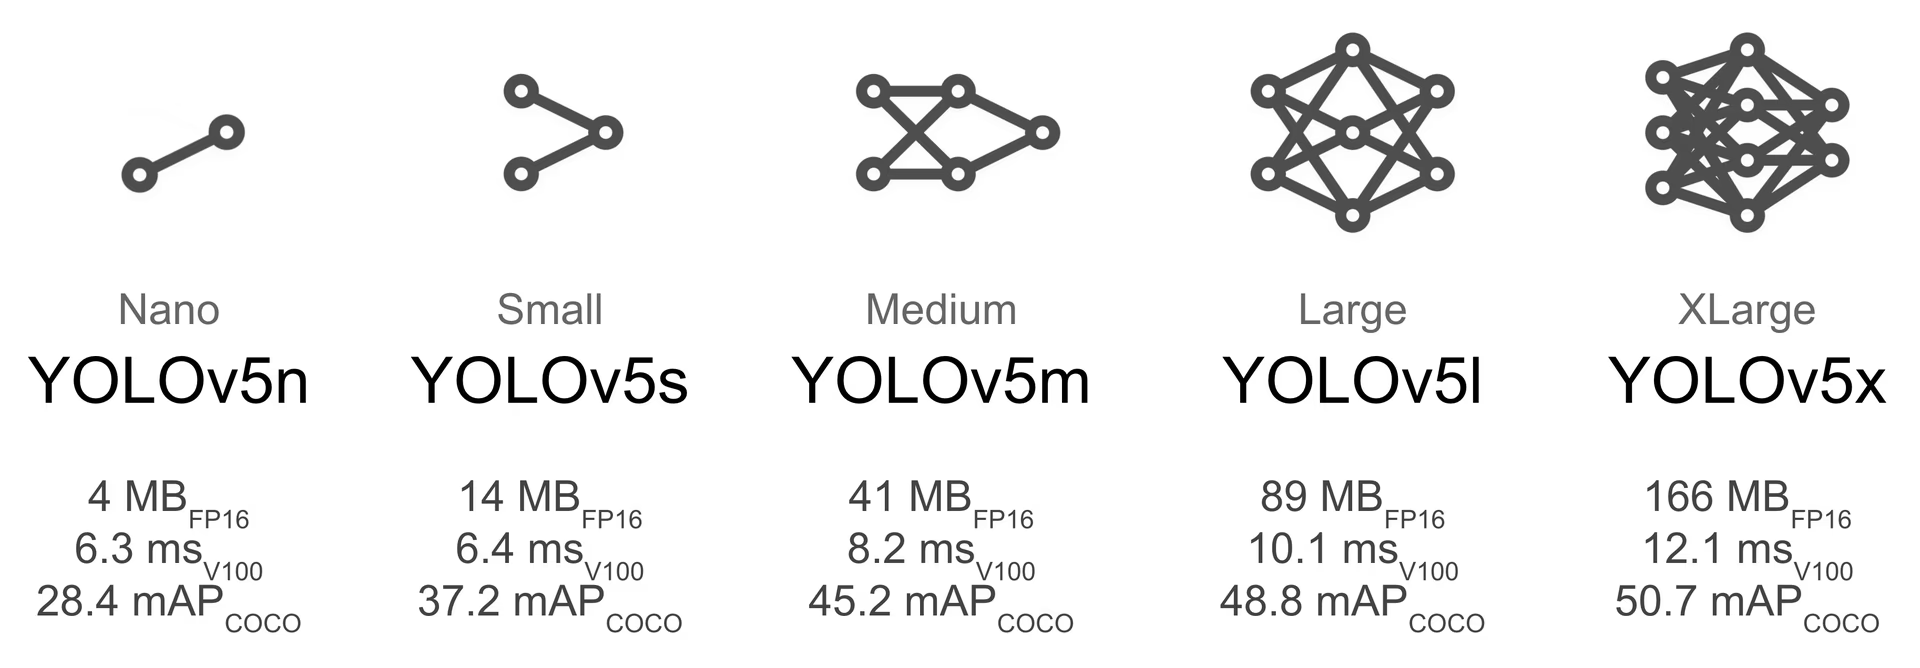
YOLOv5x や YOLOv5x6 などの大型モデルは、ほとんどの場合より良い結果を得られますが、パラメーター数が多く、トレーニングにはより多くの CUDA メモリーが必要で、実行速度も遅くなります。モバイルへのデプロイには YOLOv5s/m、クラウドへのデプロイには YOLOv5l/x を推奨します。
-
事前学習済みの重みから開始する。 VOC、VisDrone、GlobalWheat など、小規模から中規模のデータセットに推奨します。モデル名を
--weights引数に指定します。モデルは最新の YOLOv5 リリースから自動的にダウンロードされます。python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
スクラッチから開始する。 COCO、Objects365、OIv6 など、大規模なデータセットに推奨します。関心のあるモデルアーキテクチャの YAML と、空の
--weights ''引数を指定します。python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
トレーニング設定#
何かを変更する前に、まずデフォルト設定でトレーニングし、パフォーマンスのベースラインを確立してください。train.pyの設定一覧は、train.pyのargparserで確認できます。
- エポック数。 まずは 300 エポックで開始します。早い段階で過学習が発生した場合は、エポック数を減らします。300 エポック後も過学習しない場合は、600 または 1200 エポックなど、さらに長くトレーニングします。
- 画像サイズ。 COCO はネイティブ解像度の
--img 640でトレーニングしますが、データセットに小さな物体が多く含まれるため、--img 1280などの高解像度でトレーニングすると効果が得られる場合があります。小さな物体が多いカスタムデータセットでは、ネイティブ解像度以上でのトレーニングが有効です。推論結果を最良にするには、トレーニング時と同じ--imgを使用します。たとえば、--img 1280でトレーニングした場合は、--img 1280でもテストと検出を実行してください。 - バッチサイズ。 ハードウェアで処理できる最大の
--batch-sizeを使用します。小さなバッチサイズではバッチ正規化の統計が悪くなるため、避けてください。--batch-size -1を使用すると、GPUに最適なバッチサイズを自動的に選択できます。 - 学習率。 デフォルトの学習率スケジュールは、ほとんどのケースで適切に機能します。収束を速めるには、
--cos-lrフラグを使用してコサイン学習率スケジューリングを有効にできます。エポックの進行に合わせて、コサイン曲線に従い学習率を徐々に下げます。 - データ拡張。 YOLOv5には、複数のトレーニング画像を組み合わせるモザイクなど、さまざまな拡張手法が含まれています。
--hypファイルのmosaicハイパーパラメーターを調整して、トレーニングの安定性を高めます。 - ハイパーパラメーター。 デフォルトのハイパーパラメーターはhyp.scratch-low.yamlにあります。変更を検討する前に、まずデフォルトのハイパーパラメーターでトレーニングすることをおすすめします。一般に、拡張のハイパーパラメーターを大きくすると、過学習を抑えて遅らせることができ、トレーニング時間を延ばして最終的なmAPを高められます。
hyp['obj']など、損失項のゲインに関するハイパーパラメーターを小さくすると、該当する損失項での過学習を抑えられます。これらのハイパーパラメーターを自動で最適化する方法については、ハイパーパラメーター進化チュートリアルをご覧ください。 - 混合精度トレーニング。 YOLOv5は、対応するGPUを検出するとAutomatic Mixed Precision(AMP)を自動的に有効にします。モデルの精度を損なうことなく、トレーニングを高速化し、メモリ使用量を削減できます。
- マルチ GPU トレーニング。 複数の GPU がある場合は、
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3を使用してDistributedDataParallel トレーニングを開始すると、トレーニング時間を大幅に短縮できます。 - 早期停止。
--patience 50を使用すると、検証指標が50エポックにわたって改善しない場合にトレーニングを停止できるため、時間を節約し、過学習を防げます。
高度な最適化手法#
- 転移学習。 特化したデータセットの場合は、事前学習済み重みから開始し、必要に応じて
--freezeでレイヤーを凍結して、モデルを特定のタスクに適応させます。 - モデルのプルーニング。 トレーニング後は、精度をほとんど損なわずに冗長な重みをゼロにするため、モデルのプルーニングを検討してください。その後、スパース性に対応したランタイムにデプロイすると、高速化を実現できます。
- モデルアンサンブル。 重要なアプリケーションでは、異なる設定で複数のモデルをトレーニングし、予測をアンサンブルして精度を高めます。
- テスト時データ拡張。 推論時に
--augmentを使用して TTA を有効にすると、入力画像を反転・リサイズした画像からの予測を統合し、予測精度を高められます。
関連情報#
さらに詳しく知りたい場合は、まず Karpathy のニューラルネットワークをトレーニングするためのレシピをご覧ください。ここで紹介されているトレーニングのアイデアは、幅広い ML 分野に応用できます。
頑張ってください。他にご質問があればお知らせください。
よくある質問#
最適なバッチサイズはGPUメモリによって異なります。一般に、バッチサイズが大きいほどバッチ正規化の統計とトレーニングの安定性が向上します。メモリ不足にならずにハードウェアで処理できる最大のバッチサイズを使用してください。
--batch-size -1を使用すると、環境に最適なバッチサイズを自動的に判断できます。トレーニングを高速化するには、DDPで複数のGPUを使用する、
--cacheでデータセットをキャッシュする、バッチサイズを最適化する、といった方法をお試しください(対応GPUでは混合精度が自動的に有効になります)。絶対的な精度が重要でない場合は、YOLOv5sなど、より小さなモデルバリアントの使用も検討してください。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。