テスト時拡張(TTA)#
📚 このガイドでは、YOLOv5 🚀のテストおよび推論時にテスト時拡張(TTA)を使用して、mAPと再現率を向上させる方法を説明します。
開始する前に#
リポジトリをクローンし、Python>=3.8.0環境(PyTorch>=1.8を含む)でrequirements.txtをインストールします。モデルとデータセットは、最新のYOLOv5リリースから自動的にダウンロードされます。
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install通常のテスト#
TTAを試す前に、比較の基準となるパフォーマンスを確認します。このコマンドは、画像サイズ640ピクセルでCOCO val2017を使用してYOLOv5xをテストします。yolov5x.ptは、利用可能なモデルの中で最も大きく、最も高精度なモデルです。ほかの選択肢はyolov5n.pt、yolov5s.pt、yolov5m.pt、yolov5l.pt、またはカスタムデータセットでの学習によって得た独自のチェックポイント(runs/train/exp/weights/best.ptなど)です。利用可能なすべてのモデルの詳細については、YOLOv5ドキュメントをご覧ください。
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --half出力:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
Average Recall (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826TTAを使用したテスト#
既存のval.pyコマンドに--augmentを追加するとTTAが有効になり、画像サイズを約30%大きくすると結果が向上します。TTAを有効にした推論では、画像を左右反転し、3種類の解像度で処理した後、出力をNMSの前に統合するため、通常の推論の約2~3倍の時間がかかります。速度低下の一部は画像サイズが大きくなること(832対640)によるもので、残りはTTA処理そのものによるものです。そのため、--imgを増やす前に、GPUのメモリに十分な余裕があることを確認してください。
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --half出力:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
Average Recall (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833TTAを使用した推論#
detect.pyのTTA推論は、val.pyのTTAと同じように動作します。既存のdetect.pyコマンドに--augmentを追加するだけです。
python detect.py --weights yolov5s.pt --img 832 --source data/images --augment出力:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)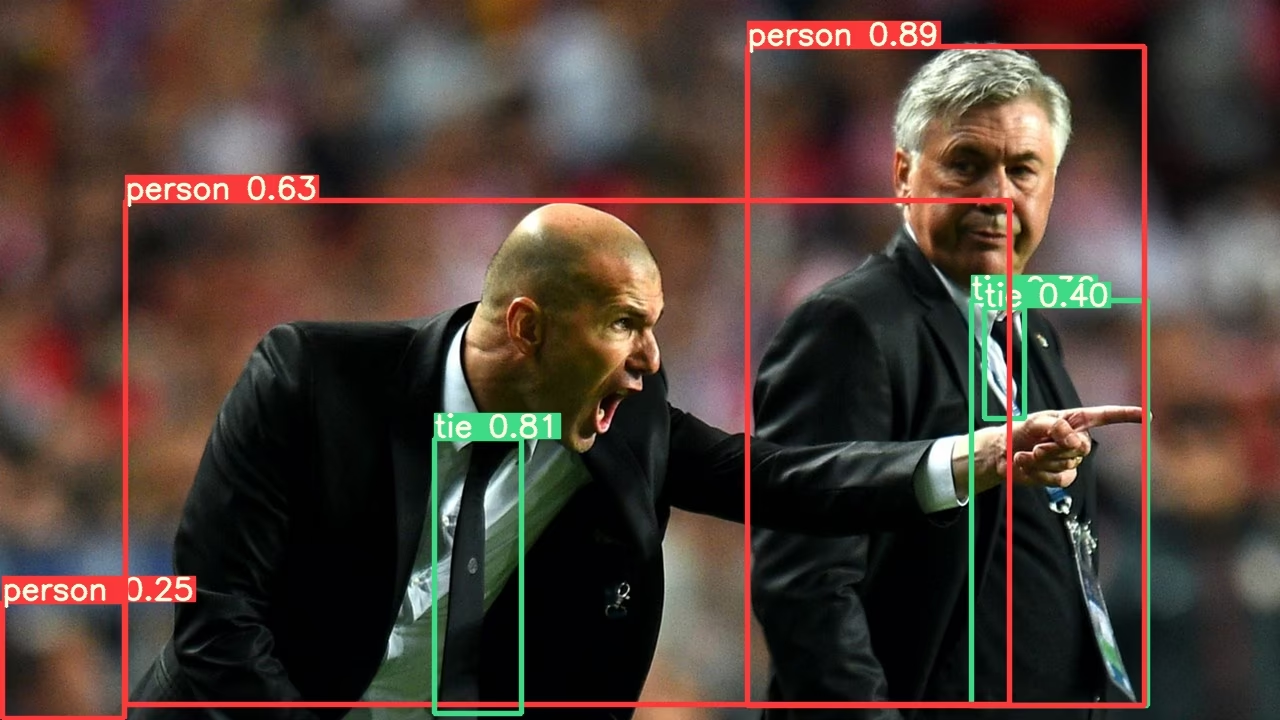
PyTorch HubのTTA#
TTAはすべてのYOLOv5 PyTorch Hubモデルに自動的に統合されており、推論時にaugment=Trueを渡すことで利用できます。
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # またはyolov5m、yolov5x、custom

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # またはfile、PIL、OpenCV、numpy、multiple

# Inference
results = model(img, augment=True)  # <--- TTA推論

# Results
results.print() # or .show(), .save(), .crop(), .pandas(), etc.カスタマイズ#
YOLOv5のforward_augment()メソッドで適用するTTA処理をカスタマイズできます。
テスト時拡張のメリット#
テスト時拡張には、物体検出タスクにおいて、次のような主な利点があります。
- 精度の向上:上記の結果が示すように、TTAによってmAPは0.504から0.516に、mARは0.681から0.696に向上します。
- 小さな物体の検出性能向上:TTAは特に小さな物体の検出を強化し、小面積のAPは0.351から0.361に向上します。
- 堅牢性の向上:各画像の複数のバリエーションをテストすることで、TTAは視点、照明、その他の環境要因の影響を軽減します。
- 簡単な実装:既存のコマンドに
--augmentフラグを追加するだけです。
推論時間が長くなるというトレードオフがあるため、TTAは速度よりも精度が重視される用途に適しています。
サポート対象の環境#
Ultralyticsでは、プロジェクトをすぐに開始できるよう、CUDA、CUDNN、Python、PyTorchなどの必須依存関係をあらかじめインストールした、すぐに使えるさまざまな環境を提供しています。
- 無料のGPUノートブック:


- Google Cloud: GCPクイックスタートガイド
- Amazon: AWSクイックスタートガイド
- Azure: AzureMLクイックスタートガイド
- Docker: Dockerクイックスタートガイド

プロジェクトのステータス#

このバッジは、すべてのYOLOv5 GitHub Actions継続的インテグレーション(CI)テストが正常に合格していることを示します。これらのCIテストでは、トレーニング、検証、推論、エクスポート、ベンチマークなど、さまざまな重要な側面におけるYOLOv5の機能とパフォーマンスを厳密に確認します。これにより、macOS、Windows、Ubuntuで一貫して信頼性の高い動作が保証されます。テストは24時間ごと、および新しいコミットごとに実施されます。
よくある質問#
各画像を3つのスケールと左右反転で処理し、NMSの前に予測結果を統合します。追加の視点により、特に小さな物体の再現率が向上しますが、計算量は増加します。
通常の推論時間の約2~3倍を見込んでください。処理時間が増える一因は
--imgのサイズが大きくなることです。サイズを大きくする前に、GPUのメモリに十分な余裕があることを確認してください。832など、640より約30%大きい解像度で実行すると、マルチスケール処理で利用できる詳細情報が増え、上記のベンチマークで最良の結果が得られました。
いいえ。拡張されたフォワードパスはPyTorchの
DetectionModel内にあるため、--augmentは.ptチェックポイントにのみ適用されます。エクスポート済みのONNX、TensorRT、その他の形式では無視されます。