YOLOv5のモデルプルーニングとスパース性
このガイドでは、性能を維持しながら、より効率的なネットワークを作成するためにYOLOv5モデルをプルーニングする方法を説明します。
モデルプルーニングとは?#
モデルプルーニングは、重要度の低いパラメーター(重みや接続)を削除してニューラルネットワークのサイズと複雑さを削減する手法です。この処理によって、より効率的なモデルが作成され、次のようなメリットが得られます。
- リソースが限られたデバイスへのデプロイを容易にするモデルサイズの縮小
- 精度への影響を最小限に抑えた推論速度の向上
- メモリ使用量とエネルギー消費の削減
- リアルタイムアプリケーションにおける全体的な効率の向上
プルーニングでは、モデル性能への寄与が小さいパラメーターを特定して削除することで、同程度の精度を保ちながら、より軽量なモデルを実現します。
開始する前に#
リポジトリをクローンし、Python>=3.8.0環境にrequirements.txtをインストールします。この環境にはPyTorch>=1.8も含めてください。モデルとデータセットは、最新のYOLOv5リリースから自動的にダウンロードされます。
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # installベースライン性能のテスト#
プルーニングを行う前に、比較用のベースライン性能を確認してください。このコマンドは、画像サイズ640ピクセルでCOCO val2017上のYOLOv5xをテストします。yolov5x.ptは、最も大きく精度の高いP5モデルです。ほかの選択肢には、より小さな事前学習済みチェックポイントのyolov5n.pt、yolov5s.pt、yolov5m.pt、yolov5l.pt、またはカスタムデータセットでのトレーニングによる独自のチェックポイント(例: runs/train/exp/weights/best.pt)があります。
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --half出力:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2YOLOv5xへのプルーニング適用(スパース性30%)#
utils/torch_utils.pyで定義されているprune()関数を使用して、モデルにプルーニングを適用できます。プルーニング済みモデルをテストするには、val.pyを更新して、YOLOv5xのスパース性を0.3(重みの30%をゼロに設定)にします:
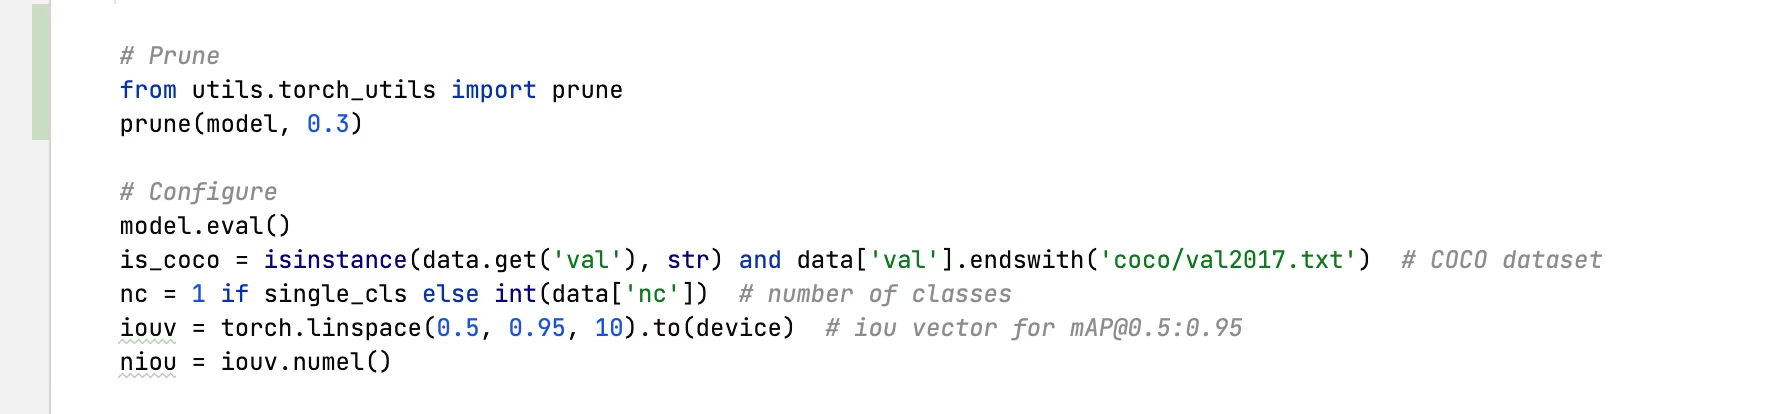
プルーニング率30%の出力:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3結果の分析#
結果から、次のことがわかります:
- スパース性30%を達成:
nn.Conv2dレイヤーにあるモデルの重みパラメーターの30%がゼロになりました - 推論時間は変化なし:プルーニング後も処理速度は実質的に同じです
- 性能への影響は最小限:mAPは0.507から0.489へわずかに低下しました(低下率はわずか3.6%です)
- モデルサイズは変化なし:ゼロにした重みも密な形式で保存されるため、ファイルサイズが小さくなるのはスパース対応形式または圧縮を使用した場合のみです
この結果は、精度への影響をわずかに抑えながら、畳み込み重みの30%を削除できることを示しています。このスパース性を推論の高速化やファイルサイズの削減につなげるには、スパース性に対応したランタイム、構造化プルーニング、または圧縮が必要です。
プルーニング済みモデルのファインチューニング#
最良の結果を得るには、精度を回復するため、プルーニング後にモデルをファインチューニングしてください。次の手順で実施できます:
- 目標のスパース性レベルでプルーニングを適用する
- プルーニングしたモデルを、より低い学習率で数エポックトレーニングします
- ファインチューニング済みのプルーニングモデルをベースラインと比較して評価する
このプロセスにより、残ったパラメーターが削除された接続を補うように適応し、多くの場合、元の精度の大部分、またはすべてを回復できます。
サポート対象の環境#
Ultralyticsでは、プロジェクトをすぐに開始できるよう、CUDA、cuDNN、Python、PyTorchなどの必須依存関係をあらかじめインストールした、すぐに使える各種環境を提供しています。
- 無料のGPUノートブック:


- Google Cloud: GCPクイックスタートガイド
- Amazon: AWSクイックスタートガイド
- Azure: AzureMLクイックスタートガイド
- Docker: Dockerクイックスタートガイド

プロジェクトのステータス#

このバッジは、すべてのYOLOv5 GitHub Actions継続的インテグレーション(CI)テストが正常に合格していることを示します。これらのCIテストでは、トレーニング、検証、推論、エクスポート、ベンチマークなど、さまざまな重要な側面におけるYOLOv5の機能とパフォーマンスを厳密に確認します。これにより、macOS、Windows、Ubuntuで一貫して信頼性の高い動作が保証されます。テストは24時間ごと、および新しいコミットごとに実施されます。
よくある質問#
非構造化プルーニングでは重みをゼロにしますが、テンソル形状は変わらないため、密なPyTorchカーネルの処理量は変わりません。高速化するには、DeepSparseのようなスパース対応ランタイム、またはチャネル全体を削除する構造化プルーニングが必要です。
検証またはエクスポートの前に、
utils/torch_utils.pyからヘルパーを呼び出します:from utils.torch_utils import prune prune(model, amount=0.3) # nn.Conv2dの重みに対するグローバルスパース性30%0.3から始めてmAPを測定してください。YOLOv5xは、ファインチューニングなしでスパース性30%の場合、mAPが約3.6%低下しました。より高いスパース性では通常、精度を回復するため、低い学習率で数エポック再トレーニングする必要があります。
はい。ゼロにした重みも他の重みと同様に保存されるため、
export.pyは変更せずに使用できます。ファイルサイズが小さくなるのは、ターゲット形式またはランタイムがスパーステンソルを圧縮する場合のみです。


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。