YOLOv5のハイパーパラメーター進化#
📚 このガイドでは、YOLOv5 🚀のハイパーパラメーター進化について説明します。ハイパーパラメーター進化は、最適化に遺伝的アルゴリズム(GA)を使用するハイパーパラメーター最適化の手法です。
機械学習におけるハイパーパラメーターは、トレーニングのさまざまな要素を制御します。最適な値を見つけることは、次の理由から困難な場合があります:
- 高次元の探索空間
- 各次元間の相関が不明
- 各点で適合度を評価するコストが高い
このため、遺伝的アルゴリズムはハイパーパラメーター探索に適しています。
開始する前に#
リポジトリをクローンし、Python>=3.8.0環境(PyTorch>=1.8を含む)でrequirements.txtをインストールします。モデルとデータセットは、最新のYOLOv5リリースから自動的にダウンロードされます。
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. ハイパーパラメーターの初期化#
YOLOv5には、さまざまなトレーニング設定に使用されるハイパーパラメーターが約30個あります。これらは/data/hypsディレクトリ内の*.yamlファイルで定義されています。初期値の推定が適切であるほど最終結果も良くなるため、進化を始める前にこれらの値を適切に初期化することが重要です。判断に迷う場合は、YOLOv5のCOCOスクラッチトレーニング向けに最適化されたデフォルト値を使用してください。
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. 適合度の定義#
適合度とは、最大化を目指す値です。YOLOv5では、メトリクスの加重和をデフォルトの適合度関数として定義しています。mAP@0.5の重みは10%、mAP@0.5:0.95の重みは残りの90%であり、適合率(P)と再現率(R)は含まれません。必要に応じて調整するか、utils/metrics.pyにあるデフォルトの適合度定義(推奨)を使用できます。この適合度によってhyp_evolve.yamlに保存される結果が決まります。遺伝的アルゴリズム自体はmAP@0.5のみで親個体とエリート個体を順位付けするため、これらの重みを変えても親個体の選択は変わりません。
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # [P、R、mAP@0.5、mAP@0.5:0.95]の重み
    return (x[:, :4] * w).sum(1)
3. 進化#
進化は、改善を目指すベースシナリオを基準に実行します。この例のベースシナリオは、事前学習済みYOLOv5sを使用してCOCO128を10 エポックにわたってファインチューニングすることです。ベースシナリオのトレーニングコマンドは次のとおりです:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cacheこのシナリオに固有のハイパーパラメーターを進化させるには、セクション1.で定義した初期値から開始し、セクション2.で定義した適合度を最大化するために、--evolveを追加します:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# doneデフォルトの進化設定では300世代を実行し、各世代で集団内の50個体それぞれについてベースシナリオを1回ずつトレーニングします。--evolve引数で世代数を変更できます。たとえば、python train.py --evolve 1000のように指定します。
主な遺伝的オペレーターは交叉と突然変異です。各世代では、すべての個体をトレーニングしてmAP@0.5でスコアを付け、トーナメント選択で親を選び、最も適合度の高いエリートを親集団に加えます。次に、進化の進行に応じて適応する率で交叉と突然変異を行い、次の集団を作成します。結果はruns/evolve/exp/evolve.csvに記録され、適合度が最も高い子孫は各世代でruns/evolve/exp/hyp_evolve.yamlとして保存されます:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)最良の結果を得るには、最低300世代の進化を推奨します。進化には一般に多大なコストと時間がかかります。ベースシナリオを数千回トレーニングするため、数百から数千GPU時間を要する可能性があります。
進化が完了したら、保存したファイルを指定してトレーニングを実行することで、見つかった設定を再利用できます。たとえば、python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.ptのように指定します。
4. 可視化する#
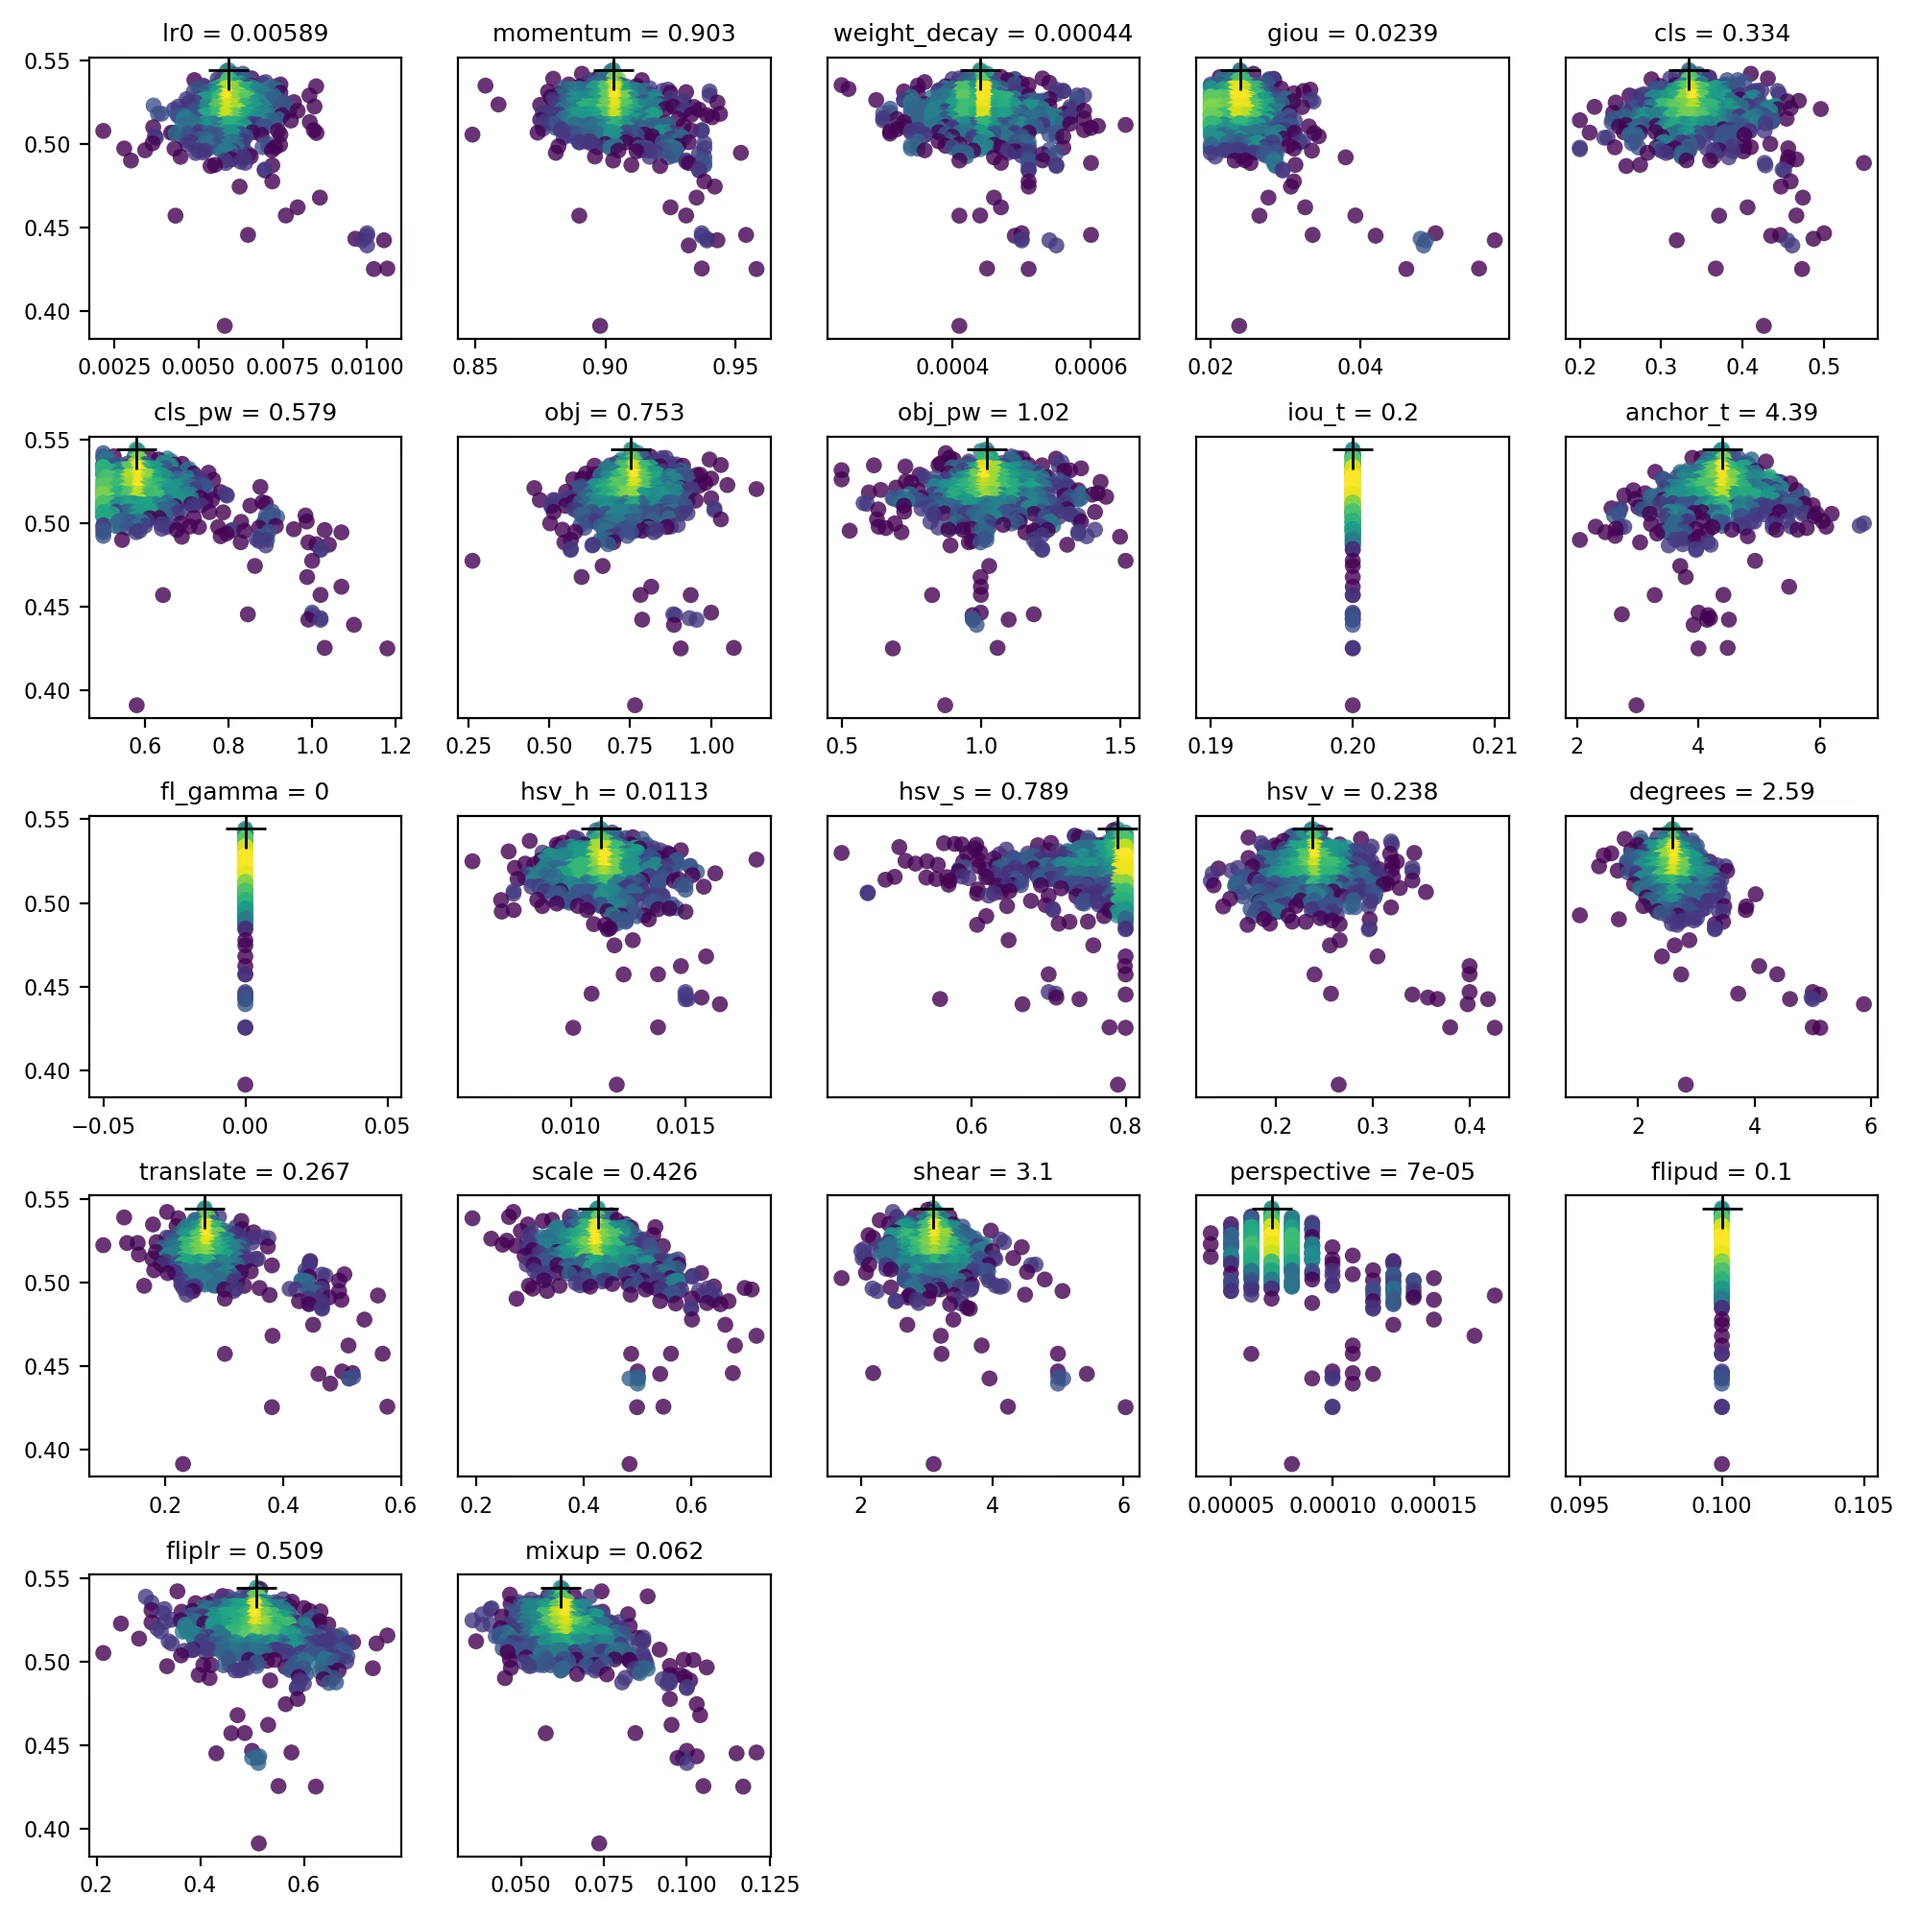
進化の完了後、evolve.csvはutils.plots.plot_evolve()によってevolve.pngとしてプロットされます。各ハイパーパラメーターのサブプロットには、適合度(y軸)とハイパーパラメーター値(x軸)が表示されます。黄色は濃度が高いことを示します。垂直方向の分布は、パラメーターが無効化され、変異しないことを示します。これはtrain.pyのmeta辞書でユーザーが選択でき、パラメーターを固定して進化しないようにする際に便利です。
サポート対象の環境#
Ultralyticsでは、プロジェクトをすぐに開始できるよう、CUDA、CUDNN、Python、PyTorchなどの必須依存関係をあらかじめインストールした、すぐに使えるさまざまな環境を提供しています。
- 無料のGPUノートブック:


- Google Cloud: GCPクイックスタートガイド
- Amazon: AWSクイックスタートガイド
- Azure: AzureMLクイックスタートガイド
- Docker: Dockerクイックスタートガイド

プロジェクトのステータス#

このバッジは、すべてのYOLOv5 GitHub Actions継続的インテグレーション(CI)テストが正常に合格していることを示します。これらのCIテストでは、トレーニング、検証、推論、エクスポート、ベンチマークなど、さまざまな重要な側面におけるYOLOv5の機能とパフォーマンスを厳密に確認します。これにより、macOS、Windows、Ubuntuで一貫して信頼性の高い動作が保証されます。テストは24時間ごと、および新しいコミットごとに実施されます。
よくある質問#
各世代では、50個体の集団内の各個体についてベースシナリオを1回ずつトレーニングします。そのため、COCO128を10エポック実行する場合、300世代では1回の実行コストのおよそ15,000倍になります。ベースシナリオは短く、代表的なものにしてください。上記のマルチGPUループは1つの探索を共有するのではなく、各GPUで独立した探索を開始するため、予算を固定している場合は、プロセスごとに
--evolveを小さくしてください。はい。
--evolveのデフォルトは300世代です。さらに実行するには、--evolve 1000のように数値を指定します。train.pyのmeta辞書で、対象エントリーの最初の値をFalseに設定します。除外されたパラメーターは初期値を維持し、evolve.pngでは垂直線として表示されます。保存したファイルを通常のトレーニング実行に渡します:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt。