ClearMLとの統合#

ClearMLについて#
ClearMLは、機械学習ワークフローの効率化とエンジニアリング時間の削減を目的に構築されたオープンソースのMLOpsプラットフォームです。
- 🔨 Experiment managerですべてのYOLOv5トレーニング実行を追跡します。
- 🔧 統合されたClearMLのデータバージョン管理ツールを使用して、カスタムトレーニングデータのバージョンを管理し、アクセスできます。
- 🔦 ClearML Agentを使用してYOLOv5の実行をリモートでトレーニングおよび監視します。
- 🔬 ClearMLのハイパーパラメーター最適化で最高のmAPを見つけます。
- 🔭 ClearML Servingを使用し、数個のコマンドでトレーニング済みのYOLOv5モデルをAPIに変換します。
必要に応じてこれらのツールを使用できます。Experiment managerだけから始めることも、すべてを連携させて完全なパイプラインを構築することもできます。
🦾 セットアップ#
ClearMLでExperimentとデータを追跡するには、サーバーとの通信が必要です。選択肢は2つあります:
- 無料のClearML Hosted Serviceに登録する、または
- 独自のClearMLサーバーをデプロイする — オープンソースのため、機密データにも引き続き利用できます。
次に、clearml Pythonパッケージをインストールし、SDKをサーバーに接続します:
pip install clearml設定 → Workspace → Create new credentials(ClearML UIの右上)で認証情報を生成し、次を実行します:
clearml-initプロンプトに従ってください。これでセットアップは完了です。
🚀 ClearMLを使用したYOLOv5のトレーニング#
Experimentの追跡を有効にするには、まだの場合はClearML pipパッケージをインストールします:
pip install clearmlこれにより、YOLOv5トレーニングスクリプトとの統合が有効になります。今後のすべてのトレーニング実行がClearMLのExperiment managerによって記録・保存されます。
プロジェクト名とタスク名をカスタマイズするには、train.pyに--projectと--nameを渡します。デフォルトはYOLOv5とTrainingです。ClearMLでは/をサブプロジェクトの区切り文字として使用するため、カスタムプロジェクト名では/を避けてください。
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheまたは、カスタム名を指定します:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cache各実行では次の情報が記録されます:
- ソースコードと未コミットの変更
- インストール済みパッケージ
- ハイパーパラメーター
- モデルのチェックポイント(
nエポックごとに保存するには--save-period nを使用します) - コンソール出力
- スカラー(mAP_0.5、mAP_0.5:0.95、precision、recall、losses、learning rates)
- マシンの詳細、実行時間、作成日
- ラベルのコレログラムや混同行列などの生成されたプロット
- エポックごとのバウンディングボックス付き画像
- エポックごとのモザイク可視化
- エポックごとの検証画像
すべての情報がClearML UIに表示されるため、トレーニングを1か所で監視できます。カスタム列(例: mAP_0.5)を追加して最も性能の高いモデルで並べ替えるか、複数のExperimentを選択して並べて比較できます。
ハイパーパラメーター最適化とリモート実行について、引き続きご覧ください。
🔗 データセットのバージョン管理#
データをコードとは別にバージョン管理すると、最新バージョンを簡単に取得でき、完全な再現性を確保できます。このリポジトリはデータセットのバージョンIDを受け取り、データが存在しない場合は自動的に取得して、IDをタスクパラメーターとして記録します。これにより、どのExperimentでどのデータが使用されたかを常に把握できます。
データセットの準備#
YOLOv5リポジトリは、YAML設定ファイルを介して多くのデータセットをサポートします。デフォルトでは、データセットはリポジトリのルートからの相対パスで../datasetsフォルダーにダウンロードされます。coco128をダウンロードすると、フォルダー構造は次のようになります:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
この構造を維持すれば、どのデータセットでも使用できます。
次に、データセットのYAMLファイルをデータセットのルートフォルダーにコピーします。ClearMLはこのファイルを読み取り、データセットを正しく使用します。サンプルのレイアウトに従って独自のYAMLを作成し、path、train、test、val、nc、namesを定義してください。
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
|_ README.txtデータセットのアップロード#
データセットをバージョン管理されたClearMLデータセットとして登録するには、そのルートフォルダーに移動して次を実行します:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data syncは次の一連の処理を簡略化したものです。明示的に実行することもできます:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data closeClearMLデータセットでのトレーニング#
データセットを登録したら、IDを指定してトレーニングに使用します:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 ハイパーパラメーター最適化#
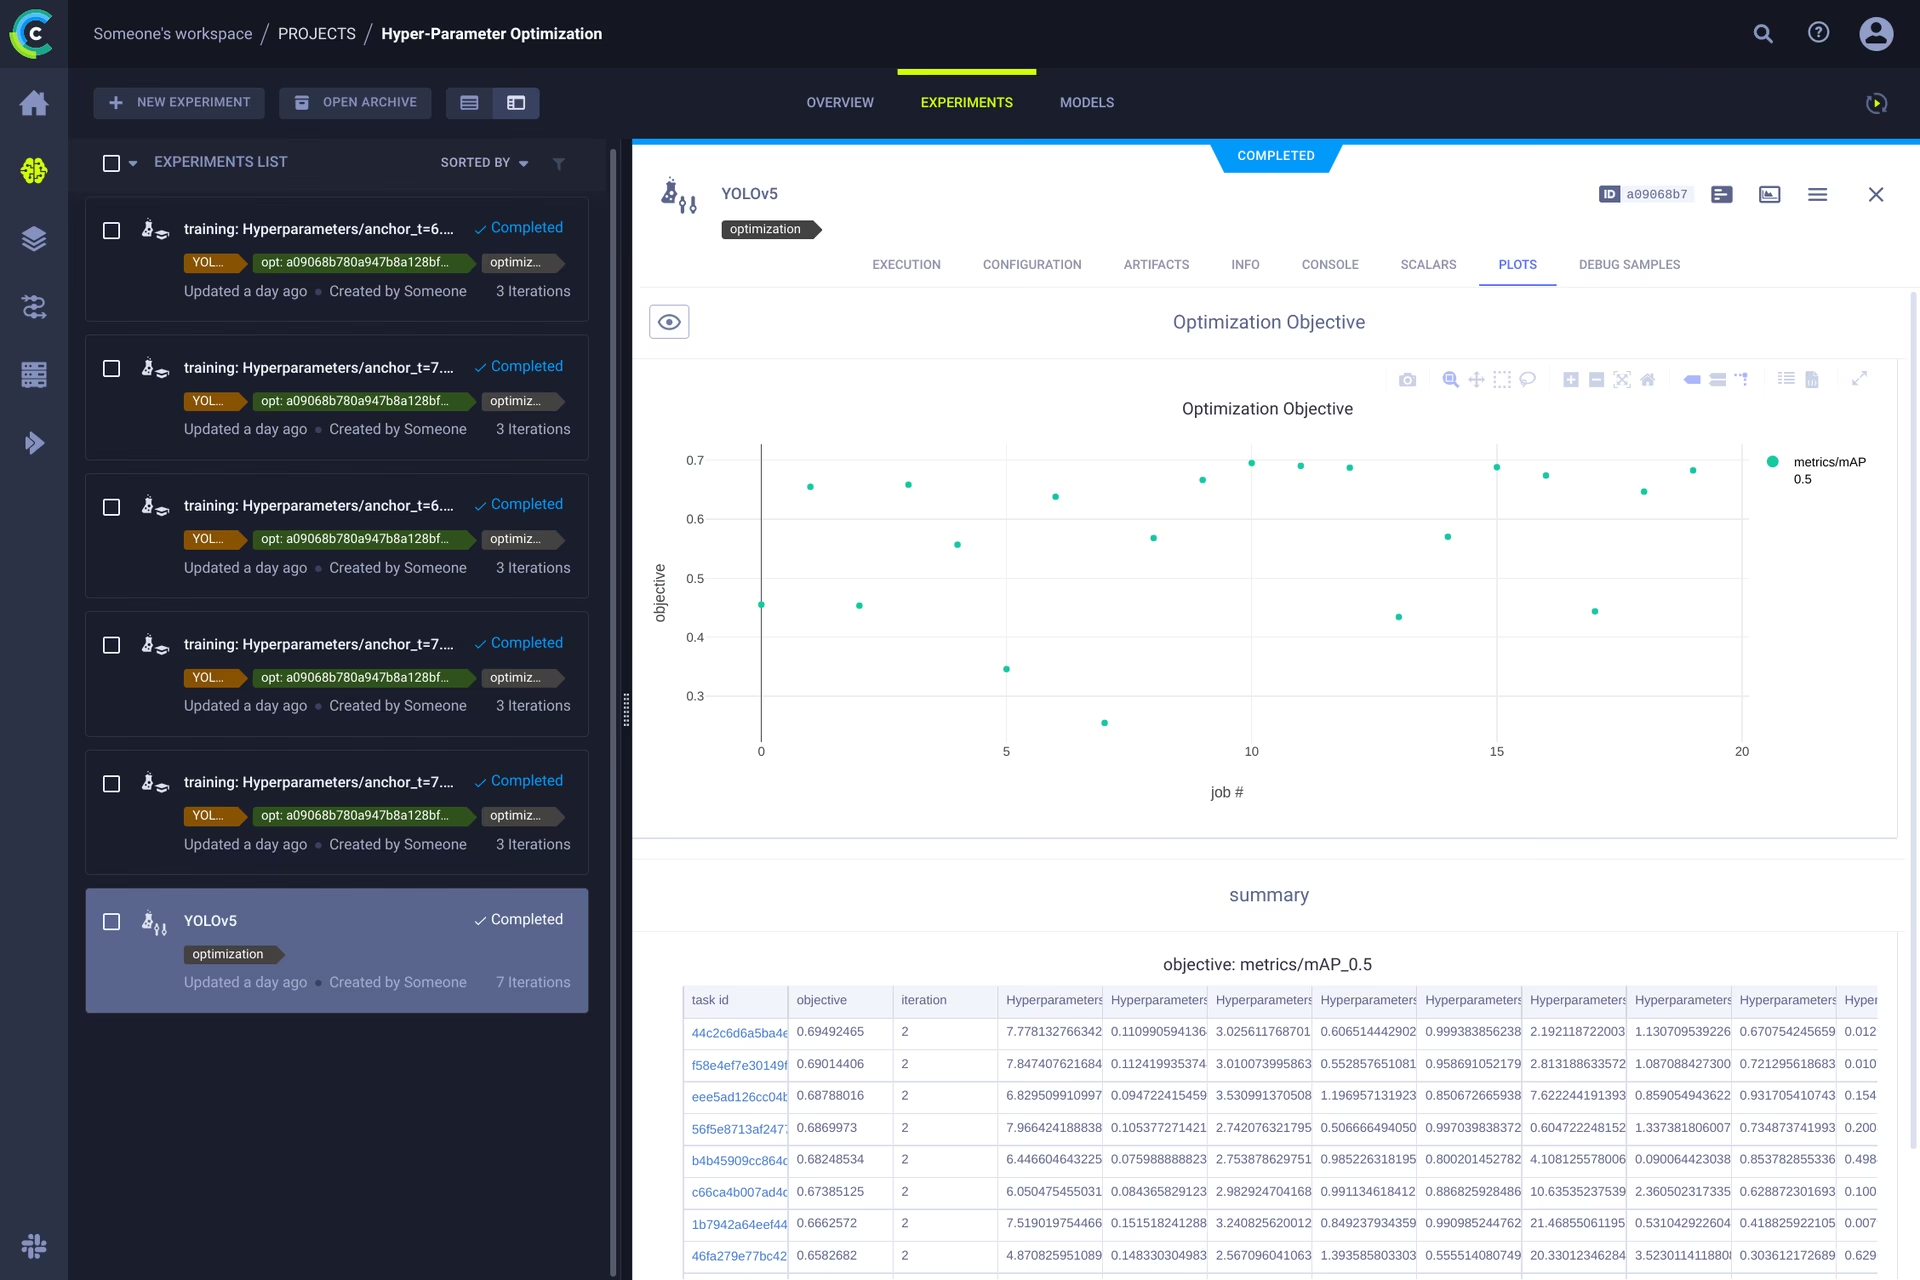
Experimentとデータをバージョン管理すれば、それらを基盤として活用できます。追跡対象の各Experimentには、コード、インストール済みパッケージ、設定など環境全体が記録されるため、実行を完全に再現できます。ClearMLではExperimentを複製してパラメーターを変更し、自動的に再実行できます。これがハイパーパラメーター最適化(HPO)の基盤です。
HPOをローカルで実行するには、付属のスクリプトを使用します。まず、Experiment managerにトレーニングタスクが存在することを確認してください。スクリプトはそのタスクを複製し、ハイパーパラメーターを変化させます。
utils/loggers/clearml/hpo.pyにテンプレートタスクIDを入力し、次を実行します:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py代わりにリモートAgentで試行を実行するには、optimizer.start_locally()をoptimizer.start()に置き換え、HyperParameterOptimizer呼び出しのexecution_queueに、Agentが待ち受けるキューを設定します。
🤯 リモート実行(上級者向け)#
HPOをローカルで実行するのは便利ですが、オンプレミスのGPUマシンやクラウドインスタンスなど、より高性能なハードウェアでExperimentを実行したい場合も多くあります。その役割を担うのがClearML Agentです:
追跡対象の各Experimentには、別のマシンで再現するために必要なすべての情報(インストール済みパッケージ、未コミットの変更、設定)が含まれています。ClearML Agentはキューを監視し、届いたタスクを取得して環境を再作成し、ジョブを実行して、スカラーとプロットをExperiment managerにストリーミングします。
次を使用すると、クラウドVM、ローカルのGPUマシン、ノートパソコンなど、あらゆるマシンをClearML Agentにできます:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]複製、編集、キューへの登録#
Agentを起動すると、UIから直接作業を割り当てられます:
- 🪄 Experimentを右クリックして複製します。
- 🎯 ハイパーパラメーターを編集します。
- ⏳ 複製したタスクを右クリックし、対象のキューに登録します。
タスクのリモート実行#
実行中のスクリプトにtask.execute_remotely()を追加すると、プログラムからリモート実行を指定することもできます。ClearMLロガーを初期化した後に追加してください。train.pyに強調表示された行を追加します:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ この行を追加
    # ...
    # カスタムデータセットArtifactリンクを処理
    data_dict = loggers.remote_dataset
# ...
この変更後、トレーニングスクリプトを実行すると、その行まで処理が進み、コードがパッケージ化されてキューに送られます。
ワーカーの自動スケーリング#
ClearMLにはオートスケーラーが付属しており、キューに保留中のExperimentがある場合はAWS、GCP、Azureでリモートマシンを起動してClearML Agentに変換し、作業の完了後に停止します。そのため、実際に稼働しているコンピューティングリソースの料金だけを支払えば済みます。
以下の入門動画をご覧ください:
詳細はこちら#
UltralyticsモデルとClearMLの統合について詳しくは、ClearML統合ガイドをご覧ください。また、他のExperiment追跡ツールを活用してMLOpsワークフローを強化する方法もご確認ください。
よくある質問#
いいえ。app.clear.mlで利用できる無料のホステッドサービスは、
clearml-initの後すぐに使用できます。セルフホスティングは任意であり、データをネットワーク外に持ち出せない場合に一般的に選択されます。YOLOv5は、
clearmlパッケージをインポートできる場合に常にインテグレーションを有効にするため、実行時のトラッキングを無効にするにはpip uninstall clearmlでアンインストールしてください。clearml-data syncでデータセットを登録し、データ引数としてそのIDを渡します:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt。IDはタスクに記録されるため、すべての実験で使用したデータを正確に把握できます。はい。各マシンで
clearml-agent daemonを起動し、UIから複製した実験をキューに追加するか、utils/loggers/clearml/hpo.pyを編集してexecution_queueを設定した状態でoptimizer.start()を呼び出し、オプティマイザーが試行をキューに送信するようにします。