컴퓨터 비전 모델 테스트 방법#
소개#
모델 테스트는 학습된 모델이 선별된 벤치마크가 아니라 움직이거나 조명이 좋지 않거나 부분적으로 가려진 객체와 같은, 이전에 본 적 없는 실제 데이터에서 어떻게 작동하는지 확인합니다. 모델 평가가 라벨이 지정된 데이터셋에서 메트릭을 측정하는 반면, 테스트는 배포 전에 모델이 학습한 동작이 애플리케이션의 목표에 부합하는지 검증합니다. 이 가이드에서는 테스트 데이터 준비, Ultralytics YOLO26 모델 테스트, 과적합, 과소적합 및 데이터 누수 감지 방법을 다룹니다.
Watch: How to Test Machine Learning Models | Avoid Data Leakage in Computer Vision 🚀
모델 테스트와 모델 평가 비교#
모델 테스트와 모델 평가는 컴퓨터 비전 프로젝트의 서로 다른 단계입니다. 평가는 라벨이 지정된 데이터셋에서 메트릭으로 성능을 측정하고, 테스트는 배포 환경과 유사한 조건에서 모델이 학습한 동작이 유지되는지 확인합니다.
고양이와 개를 인식하도록 컴퓨터 비전 모델을 학습했으며, 동물 모니터링을 위해 반려동물 매장에 이 모델을 배포한다고 가정해 보겠습니다. 모델 평가 단계에서는 라벨이 지정된 데이터셋을 사용해 정확도, 정밀도, 재현율과 같은 메트릭을 계산합니다. 예를 들어 특정 데이터셋에서 모델이 고양이와 개를 구분하는 정확도가 98%일 수 있습니다.
평가 후에는 반려동물 매장에서 촬영한 이미지를 사용해 더 다양하고 현실적인 조건에서 고양이와 개를 얼마나 잘 식별하는지 테스트합니다. 고양이와 개가 움직이거나 조명이 다르거나 장난감이나 가구 같은 물체에 일부 가려진 경우에도 올바르게 라벨링할 수 있는지 확인합니다. 모델 테스트는 통제된 평가 환경 밖에서도 모델이 예상대로 작동하는지 확인합니다.
모델 테스트 준비#
컴퓨터 비전 데이터셋은 일반적으로 실제 환경을 모사하기 위해 학습 세트와 테스트 세트로 나눕니다. 학습 데이터는 모델을 학습시키고, 테스트 데이터는 모델이 한 번도 보지 못한 예제에서 모델의 동작을 검증합니다. Ultralytics Platform은 데이터셋 구성과 어노테이션을 한곳에서 관리하므로 라벨이 지정된 테스트 세트를 구축할 때 유용합니다.
- 현실적인 대표성: 이전에 보지 못한 테스트 데이터는 배포 후 모델이 처리할 데이터와 유사해야 합니다. 이를 통해 모델의 성능을 현실적으로 파악할 수 있습니다.
- 충분한 규모: 테스트 데이터셋은 모델의 성능을 신뢰성 있게 파악할 수 있을 만큼 충분히 커야 합니다.
YOLO26 모델 테스트 방법#
학습된 YOLO26 모델 테스트에는 서로 보완적인 두 가지 워크플로가 사용됩니다. 정량적 메트릭을 얻기 위해 라벨이 지정된 테스트 분할에서 검증하고, 정성적으로 동작을 확인하기 위해 새로운 이미지에서 예측을 수행합니다.
라벨이 지정된 테스트 분할에서 검증#
검증 모드는 모델의 예측을 ground-truth 라벨과 비교하고, detection 모델에 대해 precision, recall, mAP50 및 mAP50-95를 보고합니다. 또한 혼동 행렬과 precision-recall 곡선 같은 시각적 자료를 저장하여 모델의 성능이 저조할 수 있는 구체적인 영역을 파악하는 데 도움을 줍니다.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Validate; add split="test" if your dataset YAML defines a test split
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
기본적으로 검증은 데이터셋의 val 분할에서 실행됩니다. 별도로 분리해 둔 테스트 세트에서 성능을 측정하려면 데이터셋 YAML에 test: 분할을 정의하고 split="test"를 전달합니다.
새로운 이미지에서 예측#
예측 모드는 라벨 없이 새롭고 이전에 보지 못한 데이터에서 모델을 실행합니다. 성능 메트릭은 생성하지 않지만, 어노테이션이 적용된 출력을 저장하면 실제 이미지에서 모델이 어떻게 작동하는지 검토할 수 있습니다. 예를 들어 테스트 이미지 전체 폴더를 한 번에 처리할 수 있습니다.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Run predictions on a folder of test images and save annotated results
results = model.predict(source="path/to/test_images", save=True)
커스텀 학습에 투자하기 전에 YOLO26이 애플리케이션에 적합한지 확인하려면, 사전 학습된 체크포인트를 사용해 자체 이미지에서 예측 모드를 실행합니다. 모델은 COCO와 같은 데이터셋으로 사전 학습되므로, 결과를 통해 특정 환경에서 모델이 얼마나 잘 작동할지 빠르게 파악할 수 있습니다.
검증 모드와 예측 모드 비교#
| 모드 | 목적 | 라벨 필요 여부 | 출력 |
|---|---|---|---|
| 검증 | ground truth를 기준으로 성능 정량화 | 예 | Precision, recall, mAP50, mAP50-95, 혼동 행렬, PR 곡선 |
| 예측 | 라벨이 없는 새로운 데이터에서 모델 동작 확인 | 아니요 | 어노테이션이 적용된 이미지와 예측 결과, 메트릭 없음 |
테스트 결과 분석 방법#
예측과 메트릭을 확보했다면 모델이 어디에서, 왜 실패하는지 자세히 분석합니다.
- 오분류 이미지: 모델이 잘못 분류한 이미지를 식별하고 검토하여 어떤 부분에서 오류가 발생하는지 파악합니다.
- 오류 분석: 철저한 오류 분석을 수행하여 오류 유형(예: false positive와 false negative)과 잠재적 원인을 파악합니다.
- 편향 및 공정성: 모델의 예측에 편향이 있는지 확인합니다. 특히 인종, 성별 또는 연령과 같은 민감한 속성이 포함된 경우 데이터의 여러 하위 집합에서 모델이 동일하게 우수한 성능을 내는지 확인합니다.
머신 러닝의 과적합과 과소적합#
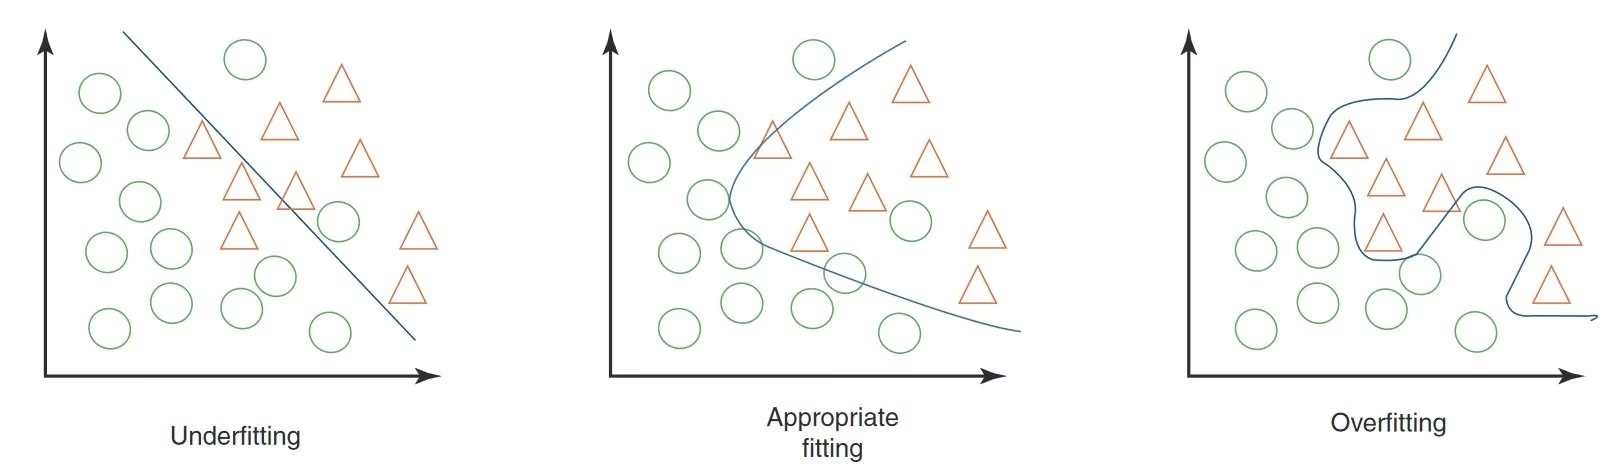
특히 컴퓨터 비전에서 머신 러닝 모델을 테스트할 때는 과적합과 과소적합에 주의해야 합니다. 이러한 문제는 모델이 새로운 데이터에서 얼마나 잘 작동하는지에 큰 영향을 줄 수 있습니다.
| 문제 | 일반적인 징후 | 해결 방법 |
|---|---|---|
| 과적합 | 학습 정확도는 높지만 검증 정확도는 낮음; 이미지의 사소한 변화나 관련 없는 세부 정보에 과도하게 민감함 | 드롭아웃과 같은 정규화를 적용하고, 학습 데이터셋의 크기를 늘리며, 모델 아키텍처를 단순화합니다. |
| 과소적합 | 학습 세트에서도 정확도가 낮음; 명확한 특징이나 객체를 지속적으로 인식하지 못함 | 더 복잡한 모델을 사용하고, 관련성이 높은 특징을 제공하며, 학습 에포크 수를 늘립니다. |
핵심은 학습 데이터셋과 검증 데이터셋 모두에서 모델이 우수한 성능을 내도록 균형을 찾는 것입니다. 테스트 중에 메트릭을 정기적으로 모니터링하고 예측을 시각적으로 검사하면 어느 한쪽 극단으로 치우치는 현상을 감지할 수 있습니다.
컴퓨터 비전의 데이터 누수와 방지 방법#
데이터 누수는 학습 데이터셋 외부의 정보가 실수로 모델 학습에 사용될 때 발생합니다. 데이터 누수가 발생하면 학습 중에는 모델이 매우 정확해 보일 수 있지만, 새롭고 이전에 보지 못한 데이터에서는 성능이 좋지 않습니다.
누수는 발견하기 어려울 수 있으며, 학습 데이터의 숨겨진 편향에서 비롯되는 경우가 많습니다.
| 편향 유형 | 나타나는 방식 |
|---|---|
| 카메라 편향 | 서로 다른 각도, 조명, 그림자 및 카메라 움직임이 원치 않는 패턴을 만듭니다. |
| 오버레이 편향 | 이미지의 로고, 타임스탬프 또는 기타 오버레이가 모델을 오도합니다. |
| 폰트 및 객체 편향 | 특정 클래스에 자주 나타나는 특정 폰트나 객체가 모델의 학습을 왜곡합니다. |
| 공간 편향 | 전경과 배경의 불균형, bounding box 분포 및 객체 위치가 학습에 영향을 줍니다. |
| 라벨 및 도메인 편향 | 잘못된 라벨이나 데이터 유형의 변화로 인해 누수가 발생합니다. |
데이터 누수 감지 및 방지 방법#
데이터 누수를 찾으려면 모델 결과가 지나치게 좋은지 확인하고, 한 특징이 다른 특징보다 훨씬 중요한지 살펴보며, 모델의 결정이 직관적으로 타당한지 다시 확인하고, 처리 전에 데이터가 올바르게 분할되었는지 검증합니다.
데이터 누수를 방지하려면 서로 다른 카메라와 환경에서 수집한 이미지 또는 동영상으로 구성된 다양한 데이터셋을 사용하고, 모든 positive 샘플이 특정 시간대에 수집된 경우와 같은 숨겨진 편향이 있는지 데이터를 주의 깊게 검토합니다. 데이터 누수를 방지하면 실제 상황에서 컴퓨터 비전 모델의 신뢰성이 향상됩니다.
모델 테스트 후 진행할 작업#
모델을 테스트한 후의 다음 단계는 결과에 따라 달라집니다. 모델의 성능이 좋다면 실제 환경에 배포할 수 있습니다. 결과가 만족스럽지 않다면 개선해야 합니다. 여기에는 오류 분석, 추가 데이터 수집, 데이터 품질 개선, 하이퍼파라미터 조정 및 모델 재학습이 포함될 수 있습니다.
결론#
엄격한 모델 테스트, 즉 별도로 분리해 둔 테스트 분할에서 검증하고 실제 이미지에서 예측하며 과적합과 데이터 누수를 확인하는 과정이 충분히 평가된 모델을 신뢰할 수 있는 모델로 전환합니다. 배포 전에 테스트에서 드러난 문제를 해결하면 프로덕션 환경에서 모델이 의도한 대로 작동할 가능성이 훨씬 높아집니다. 진행 중 질문이 있으면 Ultralytics GitHub 저장소 또는 Ultralytics Discord 서버의 커뮤니티에 문의하세요.
FAQ#
모델 평가는 라벨이 지정된 데이터셋에서 메트릭으로 성능을 측정하는 반면, 모델 테스트는 배포 조건과 유사한 새롭고 이전에 보지 못한 데이터에서 모델이 어떻게 작동하는지 확인합니다. 평가는 통제된 데이터셋에서 precision 및 mAP와 같은 수치를 생성하고, 테스트는 다양한 조명, 움직임 또는 가림이 있는 상황에서도 학습한 동작이 유지되는지 보여 줍니다. 실제 예시는 모델 테스트와 모델 평가 비교를 참조하세요.
예측 모드를 사용하고 폴더 경로를
source로 전달합니다. 그러면 YOLO26이 폴더의 모든 이미지에서 실행되며 검토를 위해 어노테이션이 적용된 결과를 저장할 수 있습니다. 예측 모드는 메트릭을 계산하지 않으므로 라벨이 지정된 세트에서 성능을 정량화하려면 대신 검증 모드를 사용합니다. 두 워크플로는 모두 YOLO26 모델 테스트 방법에 설명되어 있습니다.detection 모델의 경우 검증은 precision, recall, mAP50 및 mAP50-95를 보고하고 혼동 행렬과 precision-recall 곡선을 포함한 플롯을 저장합니다. 기본
val분할이 아닌 전용 테스트 분할에서 검증하려면 데이터셋 YAML에test:을 정의하고split="test"를 전달합니다. 각 메트릭의 해석 방법은 성능 메트릭 가이드를 참조하세요.과적합에는 드롭아웃과 같은 정규화 기법을 적용하고, 학습 데이터셋의 크기를 늘리거나 모델 아키텍처를 단순화합니다. 과소적합에는 더 복잡한 모델을 사용하고, 관련성이 높은 특징을 제공하거나, 더 많은 에포크 동안 학습합니다. 각 문제의 징후와 해당 해결 방법은 머신 러닝의 과적합과 과소적합에 요약되어 있습니다.
테스트 성능이 지나치게 좋거나, 단일 특징이 예측을 지배하거나, 모델의 결정이 직관적으로 타당하지 않다면 데이터 누수를 의심해야 합니다. 서로 다른 카메라와 환경에서 수집한 다양한 데이터셋을 사용하고, 숨겨진 편향이 있는지 데이터를 검토하며, 처리 전에 학습/테스트 분할이 이루어졌는지 확인하여 누수를 방지합니다. 일반적인 편향 유형은 컴퓨터 비전의 데이터 누수를 참조하세요.
결과가 프로젝트 목표를 충족하면 모델을 배포하고, 그렇지 않으면 배포 전에 개선합니다. 여기에는 오류 분석, 더 다양한 데이터 수집, 데이터 품질 개선, 하이퍼파라미터 튜닝 및 재학습이 포함될 수 있습니다. 변경할 때마다 테스트를 반복하여 수정 사항이 제대로 작동했는지 확인합니다.