머신러닝 모범 사례 및 모델 학습 팁
소개#
컴퓨터 비전 프로젝트를 진행할 때 가장 중요한 단계 중 하나는 모델 학습입니다. 이 단계에 앞서 목표를 정의하고 데이터를 수집하고 어노테이션을 작성해야 합니다. 데이터가 깔끔하고 일관적인지 확인하도록 데이터를 전처리한 다음 모델 학습을 시작할 수 있습니다.
모델 학습은 모델이 시각적 패턴을 인식하고 데이터에서 예측하도록 학습시키는 과정이며, 애플리케이션의 정확도에 직접적인 영향을 줍니다. 이 가이드에서는 컴퓨터 비전 모델을 효과적으로 학습할 수 있도록 모범 사례, 최적화 기법, 문제 해결 팁을 설명합니다.
시청: 모델 학습 팁 | 대규모 데이터셋 처리 방법 | 배치 크기, GPU 활용률 및 혼합 정밀도
머신러닝 모델 학습 방법#
컴퓨터 비전 모델은 오류를 최소화하도록 내부 파라미터를 조정해 학습합니다. 먼저 레이블이 지정된 이미지로 구성된 대규모 데이터셋을 모델에 입력합니다. 모델은 이미지에 무엇이 있는지 예측하고, 예측 결과를 실제 레이블 또는 이미지 내용과 비교해 오류를 계산합니다. 이 오류를 통해 모델의 예측이 실제 값에서 얼마나 벗어났는지 확인할 수 있습니다.
학습 중 모델은 반복해서 예측하고 오류를 계산하며 역전파라는 과정을 통해 파라미터를 업데이트합니다. 이 과정에서 모델은 오류를 줄이기 위해 내부 파라미터(가중치와 편향)를 조정합니다. 이 과정을 여러 번 반복하면 모델의 정확도가 점차 향상됩니다. 시간이 지나면서 형태, 색상, 질감과 같은 복잡한 패턴을 인식하게 됩니다.
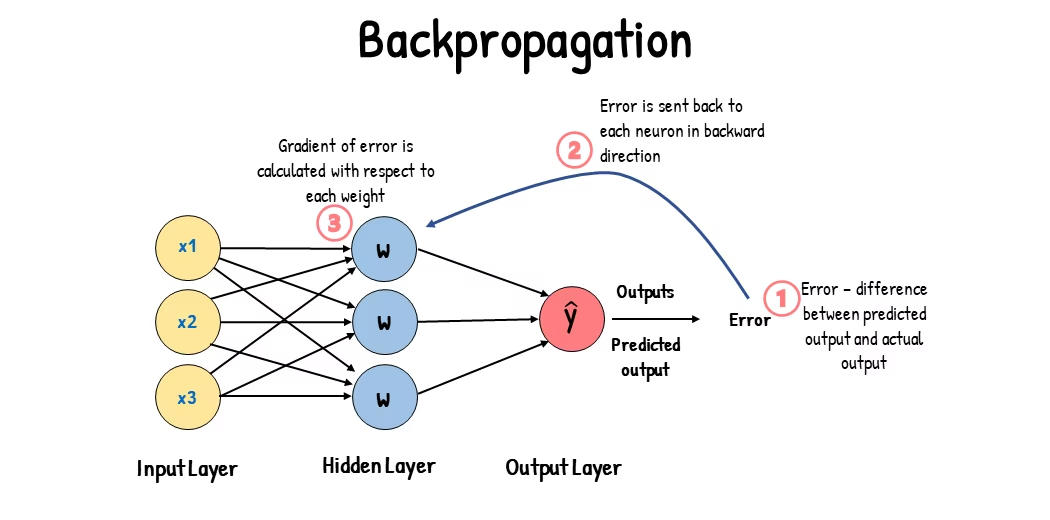
이 학습 과정을 통해 컴퓨터 비전 모델은 객체 탐지, 인스턴스 세그멘테이션, 시맨틱 세그멘테이션, 이미지 분류 등 다양한 작업을 수행할 수 있습니다. 최종 목표는 모델이 학습한 내용을 새로운 미관측 이미지에도 일반화하여 실제 애플리케이션에서 시각 데이터를 정확하게 이해하도록 하는 것입니다.
모델 학습 과정의 내부 동작을 살펴보았으니, 이제 모델을 학습할 때 고려할 사항을 알아보겠습니다.
대규모 데이터셋 학습#
대규모 데이터셋으로 모델을 학습할 계획이라면 몇 가지 측면을 고려해야 합니다. 예를 들어 배치 크기를 조정하고, GPU 사용률을 관리하고, 멀티스케일 학습을 선택할 수 있습니다. 각 옵션을 자세히 살펴보겠습니다.
배치 크기 및 GPU 사용률#
대규모 데이터셋으로 모델을 학습할 때는 GPU를 효율적으로 활용하는 것이 중요합니다. 배치 크기는 중요한 요소이며, 머신러닝 모델이 한 번의 학습 반복에서 처리하는 데이터 샘플의 수를 의미합니다. GPU가 지원하는 최대 배치 크기를 사용하면 GPU 성능을 최대한 활용하고 모델 학습 시간을 줄일 수 있습니다. 하지만 GPU 메모리 부족은 피해야 합니다. 메모리 오류가 발생하면 모델이 원활하게 학습될 때까지 배치 크기를 조금씩 줄이세요.
시청: 배치 처리를 통해 Ultralytics YOLO26 추론 속도를 2배 높이는 방법 | Python 및 GPU | MLOps 🚀
YOLO26의 경우, GPU 용량에 맞게 학습 모드 인수의 batch 매개변수를 설정할 수 있습니다. 단일 가속기에서는 batch=-1가 모델 프로파일링을 수행하고 메모리 사용률을 약 60%로 유지하는 배치 크기를 선택합니다. batch=0.70와 같은 비율을 지정하면 메모리 사용률 목표가 달라집니다. 멀티 GPU 실행에서는 장치 개수 이상인 전역 배치 크기를 명시적으로 지정해야 합니다. CPU 및 Apple 실리콘에서는 AutoBatch가 경고를 표시하고 batch=16로 대체합니다.
부분 데이터셋 학습#
부분집합 학습은 대규모 데이터셋을 대표하는 더 작은 데이터 집합으로 모델을 학습시키는 실용적인 전략입니다. 특히 초기 모델 개발 및 테스트 중에 시간과 리소스를 절약할 수 있습니다. 시간이 부족하거나 다양한 모델 구성을 실험하고 있다면 부분집합 학습을 활용하는 것이 좋습니다.
YOLO26에서는 fraction 매개변수를 사용해 부분집합 학습을 구현할 수 있습니다. 학습 데이터의 10%를 선택하려면 fraction=0.1과 같은 비율을, 학습 이미지 300개를 정확히 선택하려면 fraction=300와 같은 정수를, 각 분할의 크기를 제한하고 테스트 이미지를 건너뛰려면 fraction=[300, 100, 0]와 같은 [train, val, test] 목록을 사용할 수 있습니다. [300, 100]와 같은 두 항목 목록은 테스트 분할을 전체 크기로 유지합니다. NDJSON 데이터셋은 다운로드 전에 레코드를 균등한 간격으로 선택하므로, 반복 실행해도 정확히 동일한 부분집합을 사용합니다. 이미지 폴더 분류 데이터셋도 샘플을 균등한 간격으로 선택합니다. 그 외의 이미지 폴더 데이터셋에서는 fraction이 무작위 샘플이 아니라 정렬된 이미지 경로 순서에서 처음 N개의 이미지를 선택하므로, 정렬 순서에 따라 소스나 클래스가 제외될 수 있다면 부분집합을 수동으로 구성해야 합니다. train/val 분할을 준비할 때는 거의 중복되는 이미지 그룹이 하나의 분할 안에만 포함되도록 유지합니다.
멀티스케일 학습#
멀티스케일 학습은 다양한 크기의 이미지로 모델을 학습해 일반화 성능을 높이는 기법입니다. 모델은 서로 다른 크기와 거리에 있는 객체를 감지하는 방법을 학습해 더욱 견고해질 수 있습니다.
YOLO26을 학습할 때 scale 매개변수를 설정하면 스케일 증강을 활성화할 수 있습니다. 이 매개변수는 지정된 배율에 따라 학습 이미지의 크기를 조정하여 객체가 서로 다른 거리에 있는 것처럼 시뮬레이션합니다. 예를 들어 scale=0.5로 설정하면 학습 중에 학습 이미지가 0.5~1.5배 사이의 무작위 배율로 확대 또는 축소됩니다. 이 매개변수를 설정하면 모델이 다양한 이미지 스케일을 경험하여 여러 객체 크기와 시나리오에서 탐지 성능을 높일 수 있습니다.
Ultralytics는 multi_scale 파라미터를 통한 이미지 크기 멀티스케일 학습도 지원합니다. 이미지를 확대 또는 축소한 다음 imgsz에 맞춰 패딩하거나 자르는 scale과 달리, multi_scale은 매 배치마다 imgsz 자체를 변경합니다(모델 스트라이드에 맞춰 반올림). 예를 들어 imgsz=640 및 multi_scale=0.25을 사용하면 학습 크기는 스트라이드 단위로 480에서 800까지(예: 480, 512, 544, ..., 800) 샘플링되며, multi_scale=0.0은 고정 크기를 유지합니다.
캐싱#
캐싱은 머신러닝 모델의 학습 효율을 높이는 중요한 기법입니다. 전처리된 이미지를 메모리에 저장하면 디스크에서 데이터를 불러오는 동안 GPU가 대기하는 시간을 줄일 수 있습니다. 따라서 디스크 I/O 작업으로 인한 지연 없이 모델에 데이터를 계속 공급할 수 있습니다.
YOLO26 학습 시 cache 파라미터를 사용해 캐싱을 제어할 수 있습니다.
cache=True: 데이터셋 이미지를 RAM에 저장합니다. 가장 빠르게 접근할 수 있지만 메모리 사용량이 늘어납니다.cache='disk': 이미지를 디스크에 저장합니다. RAM보다 느리지만 매번 데이터를 새로 불러오는 것보다 빠릅니다.cache=False: 캐싱을 비활성화하고 디스크 I/O에만 의존합니다. 세 가지 옵션 중 가장 느립니다.
혼합 정밀도 학습#
혼합 정밀도 학습은 16비트(FP16)와 32비트(FP32) 부동소수점 유형을 함께 사용합니다. FP16은 계산 속도를 높이고 FP32는 필요한 정밀도를 유지합니다. 신경망 연산 대부분은 더 빠른 계산과 낮은 메모리 사용량을 위해 FP16으로 수행됩니다. 그러나 가중치 업데이트 단계에서 정확도를 보장하기 위해 모델 가중치의 마스터 사본은 FP32로 유지됩니다. 동일한 하드웨어 제약 내에서 더 큰 모델이나 더 큰 배치 크기를 처리할 수 있습니다.
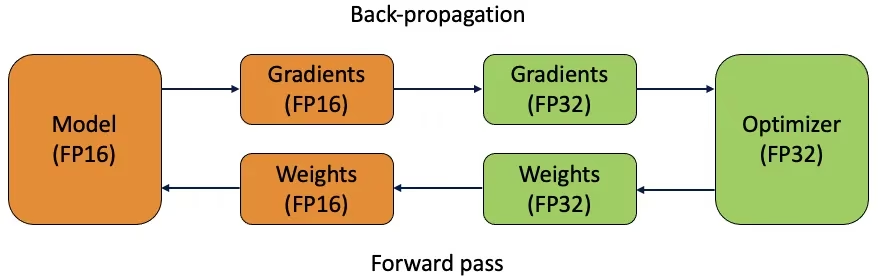
혼합 정밀도 학습을 구현하려면 학습 스크립트를 수정하고 GPU와 같은 하드웨어가 이를 지원하는지 확인해야 합니다. PyTorch, TensorFlow와 같은 최신 딥러닝 프레임워크는 대부분 혼합 정밀도를 기본적으로 지원합니다.
YOLO26에서는 혼합 정밀도 학습을 간편하게 사용할 수 있습니다. AMP는 기본적으로 활성화되어 있습니다(amp=True). CUDA GPU에서는 YOLO가 학습 시작 시 한 번 기능 검사를 수행하고, 검사에 실패하면 전체 FP32로 전환합니다. CPU와 Apple 실리콘에서는 AMP를 완전히 건너뜁니다. FP32를 강제하려면 amp=False을 설정하고, 지원되는 GPU에서 bfloat16으로 학습하려면 amp="bf16"를 설정하세요.
사전 학습 가중치#
사전 학습된 가중치를 사용하면 모델 학습 속도를 효과적으로 높일 수 있습니다. 사전 학습된 가중치는 대규모 데이터셋으로 이미 학습된 모델에서 가져오므로 모델이 유리한 출발점에서 시작합니다. 전이 학습은 사전 학습 모델을 새로운 관련 작업에 맞게 조정합니다. 사전 학습 모델을 파인튜닝할 때는 이러한 가중치로 시작한 다음 특정 데이터셋을 사용해 학습을 이어갑니다. 모델이 기본 특징을 충분히 이해한 상태에서 시작하므로 학습 시간이 단축되고 성능도 향상되는 경우가 많습니다.
사전 학습된 가중치는 model 인수에서 가져오므로 model=yolo26n.pt은 이미 COCO 가중치로 시작합니다. pretrained 파라미터는 해당 가중치를 유지할지(기본값인 True), 버릴지(False), 다른 체크포인트로 교체할지(pretrained=path/to/best.pt)를 제어합니다. *.yaml 모델에서 pretrained=True을 설정해도 가중치가 자동으로 다운로드되지는 않습니다. 전체 전이 학습 워크플로는 사용자 지정 데이터셋으로 YOLO 파인튜닝하는 방법을 참조하세요.
대규모 데이터셋 처리 시 고려할 기타 기법#
대규모 데이터셋을 처리할 때 고려할 만한 기법이 몇 가지 더 있습니다.
- 학습률 스케줄러: 학습률 스케줄러를 구현하면 학습 중 학습률을 동적으로 조정할 수 있습니다. 학습률을 적절히 조정하면 모델이 최솟값을 지나치게 벗어나는 일을 방지하고 안정성을 높일 수 있습니다. YOLO26 학습 시
lrf파라미터는 최종 학습률을 초기 학습률의 비율로 설정해 학습률 스케줄링을 관리합니다. 계층별 학습률이나 그래디언트 클리핑처럼 인수로 노출되지 않는 동작을 조정하려면 트레이너를 서브클래싱하세요. - 분산 학습: 대규모 데이터셋을 처리할 때 분산 학습은 작업을 여러 GPU 또는 머신에 분산하여 학습 시간을 줄입니다. 이 접근 방식은 상당한 컴퓨팅 리소스가 필요한 엔터프라이즈 규모 프로젝트에서 특히 유용합니다.
- 채널 우선 메모리 형식: CUDA 학습은 Windows를 제외하고 PyTorch 1.11 이상에서 더 빠른 NHWC 메모리 레이아웃을 자동으로 사용합니다. Windows에서는 NHWC가 더 느린 것으로 측정되었습니다. 이를 강제하려면
channels_last=True을 설정하고, NCHW를 유지하려면channels_last=False을 설정하세요. PyTorch 1.10 이하, CPU, MPS에서는 기본적으로 NCHW를 사용합니다.
학습 에포크 수#
모델 학습에서 에포크는 전체 학습 데이터셋을 한 번 모두 처리하는 것을 의미합니다. 에포크 동안 모델은 학습 세트의 각 샘플을 한 번씩 처리하고 학습 알고리즘에 따라 파라미터를 업데이트합니다. 모델이 학습하고 시간이 지나면서 파라미터를 개선하려면 일반적으로 여러 에포크가 필요합니다.
자주 나오는 질문 중 하나는 모델을 몇 에포크 동안 학습해야 하는지 결정하는 방법입니다. 300 에포크부터 시작하는 것이 좋습니다. 모델이 초기에 과적합하면 에포크 수를 줄일 수 있습니다. 300 에포크 이후에도 과적합이 발생하지 않으면 학습을 600, 1200 에포크 이상으로 늘릴 수 있습니다.
그러나 적절한 에포크 수는 데이터셋 크기와 프로젝트 목표에 따라 달라질 수 있습니다. 대규모 데이터셋은 모델이 효과적으로 학습하기 위해 더 많은 에포크가 필요할 수 있고, 소규모 데이터셋은 과적합 방지를 위해 더 적은 에포크가 필요할 수 있습니다. YOLO26의 경우 학습 스크립트에서 epochs 파라미터를 설정할 수 있습니다.
조기 중단#
조기 중단은 모델 학습을 최적화하는 데 유용한 기법입니다. 검증 성능을 모니터링하여 모델의 성능이 더 이상 향상되지 않을 때 학습을 중단할 수 있습니다. 이를 통해 컴퓨팅 리소스를 절약하고 과적합을 방지할 수 있습니다.
이 과정에서는 검증 지표가 개선될 때까지 학습을 지속할 에포크 수를 결정하는 인내도 파라미터를 설정합니다. 해당 에포크 동안 모델 성능이 향상되지 않으면 시간과 리소스 낭비를 방지하기 위해 학습을 중단합니다.
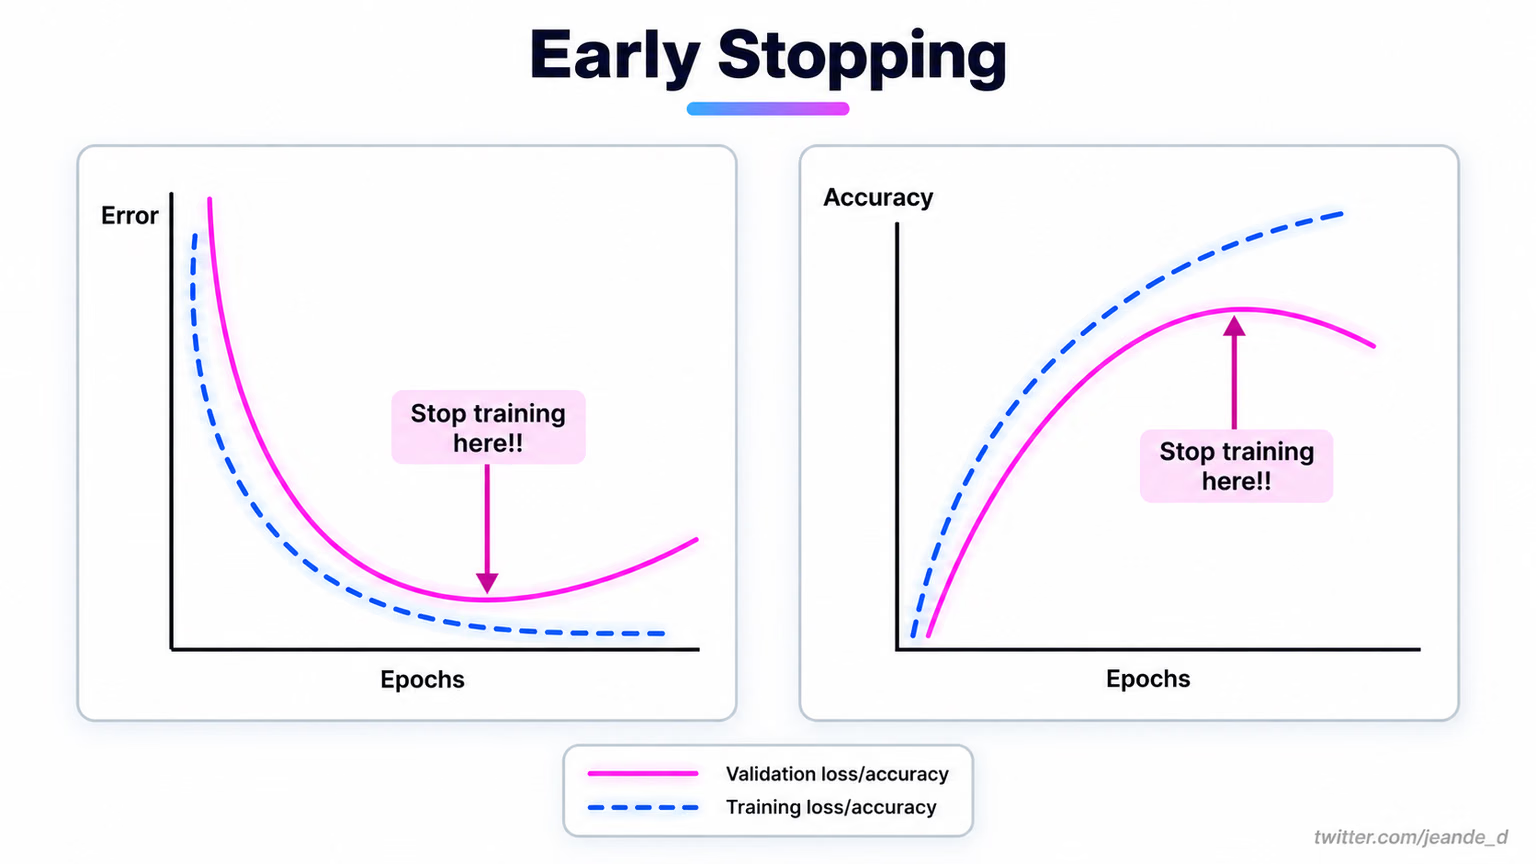
YOLO26에서는 학습 구성의 patience 매개변수를 설정하여 조기 종료를 활성화할 수 있습니다. 예를 들어 patience=5은 검증 지표가 5개 에포크 연속으로 개선되지 않으면 학습을 중단한다는 의미입니다. 이를 통해 학습 효율성을 유지하고 불필요한 계산을 방지할 수 있습니다.
클라우드 학습과 로컬 학습 중 선택하기#
모델 학습에는 클라우드 학습과 로컬 학습, 두 가지 옵션이 있습니다.
클라우드 학습은 확장성과 강력한 하드웨어를 제공하므로 대규모 데이터셋과 복잡한 모델을 처리하는 데 적합합니다. Google Cloud, AWS, Azure와 같은 플랫폼은 고성능 GPU와 TPU를 필요에 따라 사용할 수 있게 하여 학습 시간을 단축하고 더 큰 모델을 실험할 수 있도록 지원합니다. Ultralytics Platform도 YOLO 모델을 위한 관리형 클라우드 학습을 제공합니다. 그러나 클라우드 학습은 특히 장기간 사용할 경우 비용이 많이 들 수 있으며, 데이터 전송으로 인해 비용과 지연 시간이 증가할 수 있습니다.
로컬 학습은 더 높은 수준의 제어와 맞춤 설정을 제공하므로, 특정 요구 사항에 맞게 환경을 구성하고 지속적으로 발생하는 클라우드 비용을 피할 수 있습니다. 장기 프로젝트에서는 비용 효율성이 더 높을 수 있으며, 데이터가 온프레미스에 유지되므로 보안성도 향상됩니다. 그러나 로컬 하드웨어는 리소스에 한계가 있을 수 있고 유지 관리가 필요하며, 이로 인해 대규모 모델의 학습 시간이 길어질 수 있습니다.
옵티마이저 선택#
옵티마이저는 모델의 성능을 측정하는 손실 함수를 최소화하도록 신경망의 가중치를 조정하는 알고리즘입니다. 간단히 말해, 옵티마이저는 파라미터를 조정해 오류를 줄임으로써 모델의 학습을 돕습니다. 적합한 옵티마이저를 선택하면 모델의 학습 속도와 정확도에 직접적인 영향을 줍니다.
모델 성능을 높이기 위해 옵티마이저 파라미터를 미세 조정할 수도 있습니다. 학습률을 조정하면 파라미터 업데이트 시 이동하는 단계의 크기가 달라집니다. 안정성을 위해 적당한 학습률로 시작한 다음, 장기적인 학습 성능을 높이도록 점진적으로 낮출 수 있습니다. 또한 모멘텀을 설정하면 이전 업데이트가 현재 업데이트에 미치는 영향의 정도를 결정할 수 있습니다. 모멘텀은 보통 약 0.9로 설정하며, 대체로 균형 잡힌 성능을 제공합니다.
일반적인 옵티마이저#
옵티마이저마다 장단점이 다릅니다. 일반적으로 사용되는 옵티마이저 몇 가지를 소개합니다.
-
SGD (확률적 경사 하강법):
- 손실 함수의 파라미터에 대한 그래디언트를 사용해 모델 파라미터를 업데이트합니다.
- 간단하고 효율적이지만 수렴 속도가 느릴 수 있으며, 지역 최솟값에 빠질 가능성이 있습니다.
-
Adam(적응적 모멘트 추정):
- 모멘텀을 적용한 SGD와 RMSProp의 장점을 결합합니다.
- 그래디언트의 1차 및 2차 모멘트 추정값을 기반으로 각 파라미터의 학습률을 조정합니다.
- 노이즈가 있는 데이터와 희소 그래디언트에 적합합니다.
- 효율적이며 일반적으로 별도의 튜닝이 적게 필요합니다. YOLO26의
optimizer=auto은 짧은 학습 실행에서 Adam 자체보다 밀접한 관련이 있는 AdamW를 선택합니다.
-
RMSProp(제곱평균제곱근 전파):
- 최근 그래디언트 크기의 이동 평균으로 그래디언트를 나누어 각 파라미터의 학습률을 조정합니다.
- 그래디언트 소실 문제를 처리하는 데 도움이 되며 순환 신경망에 효과적입니다.
-
MuSGD (Muon + SGD 하이브리드):
- 대규모 학습의 안정성을 높이기 위해 SGD 방식의 업데이트와 Muon에서 영감을 얻은 동작을 결합합니다.
- SGD와 비슷한 일반화 성능을 원하면서 기본 SGD보다 부드러운 수렴이 필요한 경우 적합한 선택입니다.
- 특히 YOLO26 학습 레시피에 적합합니다. 확실하지 않다면
optimizer=auto로 시작하고 데이터셋에서 MuSGD와 비교해 보세요.
YOLO26에서는 optimizer 매개변수로 SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam, RMSProp 등 다양한 옵티마이저를 선택할 수 있습니다. 또는 auto로 설정하면 학습 반복 횟수에 따라 자동 선택됩니다(짧은 학습에는 AdamW, 10,000회 초과 반복에는 MuSGD).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGD커뮤니티와 소통하기#
컴퓨터 비전 분야에 관심 있는 커뮤니티에 참여하면 문제를 해결하고 더 빠르게 배울 수 있습니다. 다른 사람들과 소통하고, 도움을 받고, 아이디어를 공유하는 방법을 소개합니다.
커뮤니티 리소스#
- GitHub Issues: YOLO26 GitHub 리포지토리를 방문해 Issues 탭에서 질문하거나 버그를 신고하고 새로운 기능을 제안해 보세요. 커뮤니티 구성원과 메인테이너가 활발하게 활동하며 기꺼이 도움을 제공합니다.
- Ultralytics Discord 서버: Ultralytics Discord 서버에 참여해 다른 사용자 및 개발자와 대화하고, 지원을 받으며, 경험을 공유해 보세요.
이러한 리소스를 활용하면 컴퓨터 비전 커뮤니티의 최신 동향과 모범 사례를 파악하고 문제를 해결하는 데 도움이 됩니다.
핵심 요약#
컴퓨터 비전 모델 학습에는 모범 사례를 따르고, 전략을 최적화하며, 발생하는 문제를 해결하는 과정이 포함됩니다. 배치 크기 조정, 혼합 정밀도 학습, 사전 학습 가중치로 시작하기 등의 기법을 활용하면 모델 성능을 높이고 학습 속도를 향상할 수 있습니다. 부분집합 학습 및 조기 종료와 같은 방법은 시간과 리소스를 절약하는 데 도움이 됩니다. 커뮤니티와 지속적으로 교류하고 새로운 동향을 살펴보면 모델 학습 역량을 계속 향상할 수 있습니다.
자주 묻는 질문#
GPU 사용률을 높이려면
batch매개변수를 GPU가 지원하는 최대 크기로 설정합니다. 단일 가속기에서는batch=-1이 모델 프로파일링을 수행하고 메모리 사용률을 약 60%로 유지합니다. CPU 및 Apple 실리콘에서는batch=16로 대체되며, 멀티 GPU 실행에서는 장치 개수 이상인 전역 배치 크기를 명시적으로 지정해야 합니다. 자세한 내용은 학습 모드 인수를 참조하세요.혼합 정밀도 학습은 16비트(FP16)와 32비트(FP32) 부동소수점 유형을 함께 사용하여 컴퓨팅 속도와 정밀도의 균형을 맞춥니다. YOLO26에서는
amp=True을 통해 기본적으로 활성화됩니다. FP32를 강제하려면amp=False을 설정하세요. CPU와 Apple silicon에서는 AMP가 건너뜁니다.멀티 스케일 학습은 다양한 크기의 이미지를 학습에 사용해 모델이 서로 다른 스케일과 거리에서도 더 잘 일반화하도록 함으로써 성능을 향상합니다. YOLO26은 이 기능을 위한 별도의 파라미터 두 가지를 제공합니다.
scale=0.5은 0.5에서 1.5 사이의 줌 배율을 샘플링한 다음, 고정된imgsz크기에 맞게 패딩하거나 크롭합니다. 반면multi_scale=0.25는 스트라이드 단위로 매 배치마다imgsz자체를 변경합니다. 설정과 자세한 내용은 Train 모드 문서를 확인하세요.기본 시각적 특징을 이미 학습한 모델을 활용하는 사전 학습 가중치는 학습 속도를 크게 높이고 모델 정확도를 향상할 수 있습니다.
model인수를 통해 로드할 수 있으며, 예시는model=yolo26n.pt과 같습니다. 그러면pretrained가 해당 가중치를 유지할지(기본값인True), 폐기할지(False), 다른 체크포인트로 대체할지(pretrained=path/to/best.pt;model=*.yaml빌드로 가중치를 전이하는 방법)를 결정합니다. 자세한 내용은 Train 모드 문서를 참조하세요.에포크 수는 모델 학습 중 학습 데이터셋 전체를 반복 처리하는 횟수를 의미합니다. 일반적으로 300 에포크에서 시작합니다. 모델이 일찍 과적합되면 에포크 수를 줄일 수 있습니다. 반대로 과적합이 관찰되지 않으면 학습을 600, 1200 또는 그 이상으로 늘릴 수 있습니다. YOLO26에서 설정하려면 학습 스크립트의
epochs파라미터를 사용하세요. 적절한 에포크 수를 결정하는 방법에 관한 추가 조언은 에포크 수 섹션을 참조하세요.


댓글12
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(수정됨)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.