YOLO12: detecção de objetos centrada em atenção
Visão geral#
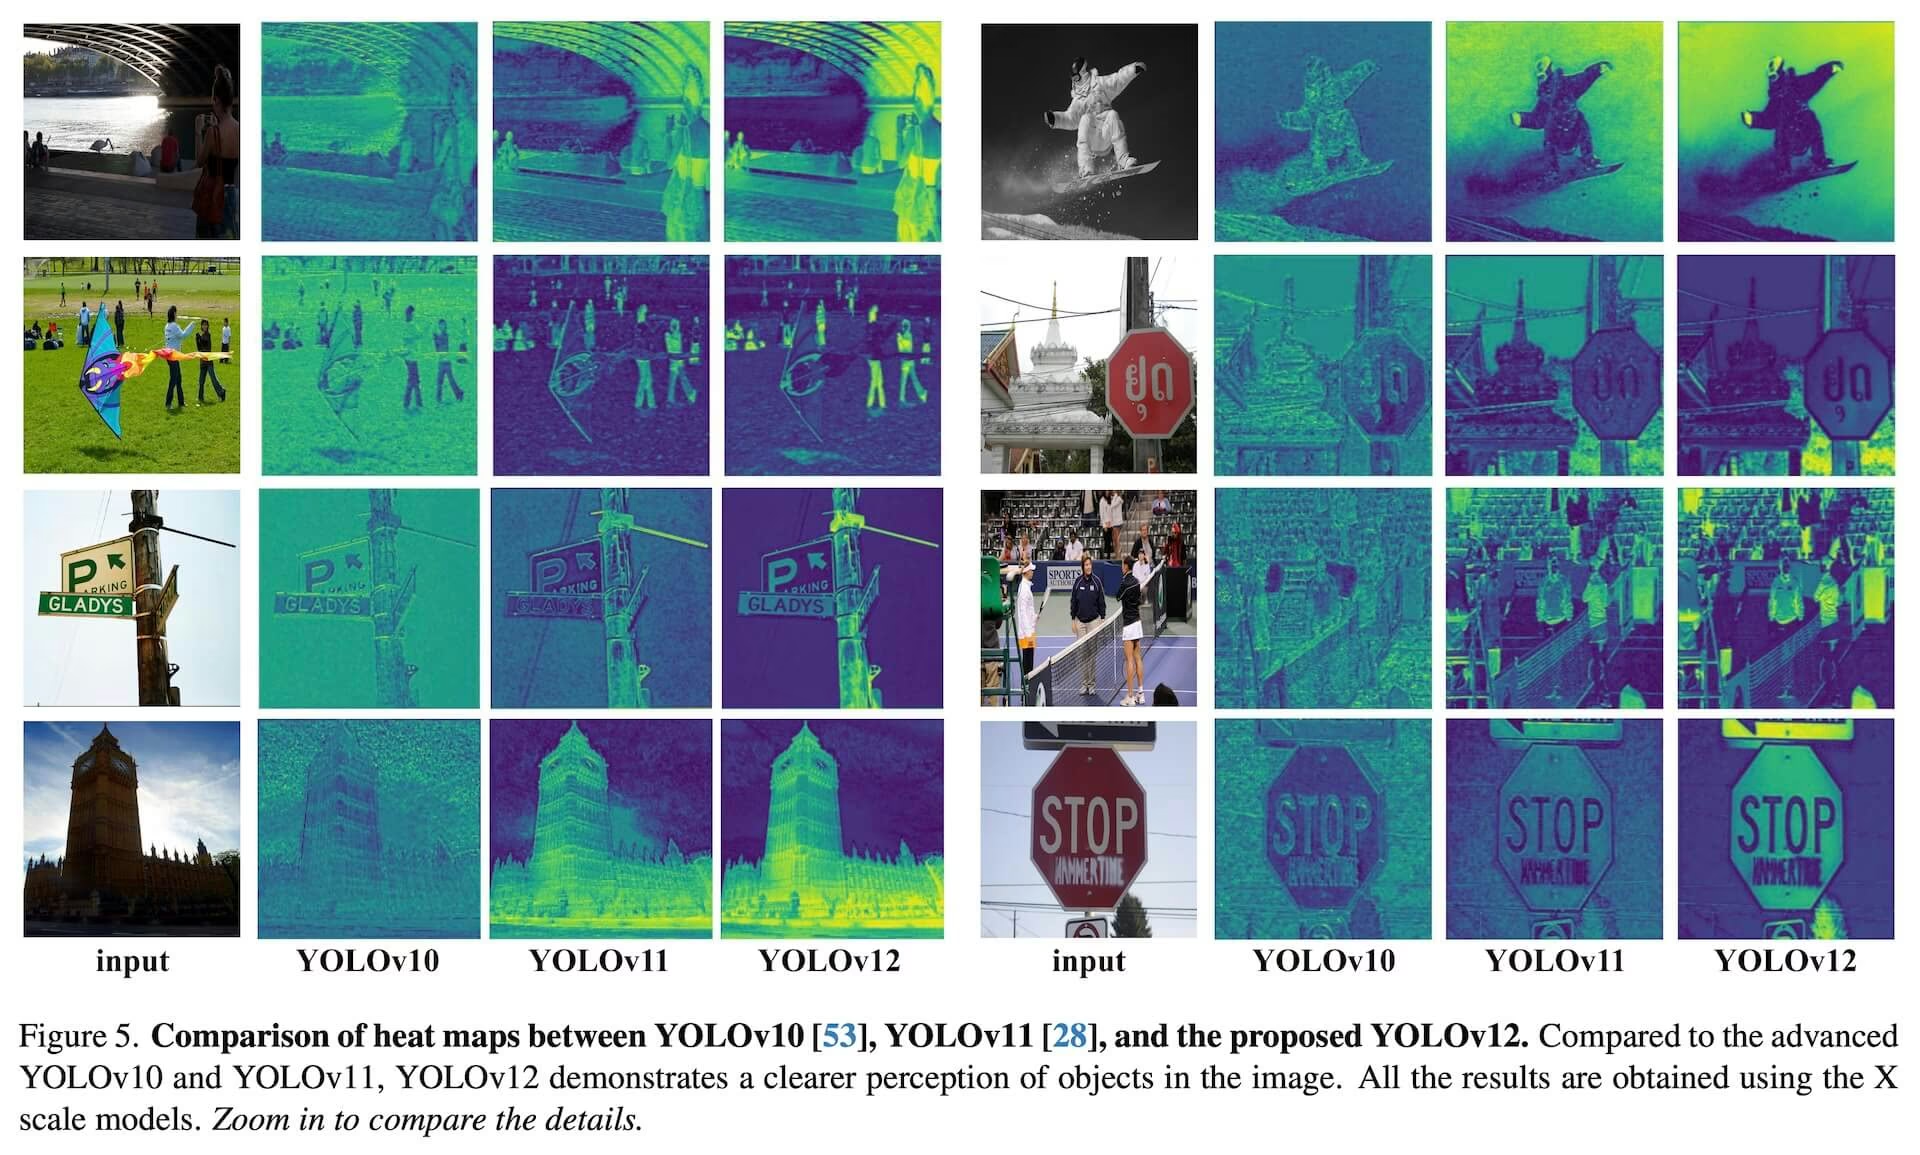
Lançado no início de 2025, o YOLO12 introduz uma arquitetura centrada em atenção que se afasta das abordagens tradicionais baseadas em CNN usadas em modelos YOLO anteriores, mas mantém a velocidade de inferência em tempo real essencial para muitas aplicações. Alcança elevada precisão na deteção de objetos graças a alterações nos mecanismos de atenção e na arquitetura geral da rede. Apesar destas vantagens, o YOLO12 continua a ser uma versão impulsionada pela comunidade e pode apresentar instabilidade no treino, maior consumo de memória e menor débito na CPU devido aos seus blocos de atenção pesados. Por isso, a Ultralytics recomenda o YOLO11 ou o YOLO26 para a maioria das cargas de trabalho de produção.
O YOLO12 é mantido principalmente para benchmarking e investigação. Se precisas de treino estável, utilização previsível da memória e inferência otimizada na CPU, escolhe YOLO11 ou YOLO26 para a implementação.
Vê: Como usar YOLO12 para deteção de objetos com o pacote Ultralytics | O YOLO12 é rápido ou lento?
Principais funcionalidades#
- Mecanismo de atenção por áreas: uma nova abordagem de autoatenção que processa campos recetivos grandes com eficiência. Divide os mapas de características em l regiões de igual tamanho (4 por predefinição), na horizontal ou na vertical, evitando operações complexas e mantendo um campo recetivo efetivo amplo. Isto reduz significativamente o custo computacional em comparação com a autoatenção padrão.
- Redes de agregação de camadas eficientes residuais (R-ELAN): um módulo de agregação de características aprimorado, baseado em ELAN e projetado para lidar com desafios de otimização, especialmente em modelos maiores centrados em atenção. R-ELAN introduz:
- Conexões residuais no nível de bloco com escalonamento (semelhantes ao escalonamento de camadas).
- Um método reformulado de agregação de características que cria uma estrutura semelhante a um gargalo.
- Arquitetura de atenção otimizada: YOLO12 simplifica o mecanismo de atenção padrão para aumentar a eficiência e a compatibilidade com a estrutura YOLO. Isso inclui:
- Utiliza FlashAttention para minimizar a sobrecarga de acesso à memória.
- Remoção da codificação posicional para criar um modelo mais simples e rápido.
- Ajuste da proporção do MLP (de 4, o valor típico, para 1.2 ou 2) para equilibrar melhor a computação entre as camadas de atenção e de propagação direta.
- Redução da profundidade dos blocos empilhados para melhorar a otimização.
- Utiliza operações de convolução (quando apropriado) pela sua eficiência computacional.
- Adição de uma convolução separável 7x7 (o "perceptor de posição") ao mecanismo de atenção para codificar informações posicionais implicitamente.
- Suporte abrangente a tarefas: YOLO12 oferece suporte a várias tarefas essenciais de visão computacional: detecção de objetos, segmentação de instâncias, classificação de imagens, estimativa de pose e detecção de objetos orientados (OBB).
- Eficiência aprimorada: alcança maior precisão com menos parâmetros do que muitos modelos anteriores, demonstrando um equilíbrio melhor entre velocidade e precisão.
- Implantação flexível: projetado para implantação em diversas plataformas, de dispositivos de borda à infraestrutura em nuvem.
Tarefas e modos compatíveis#
O YOLO12 suporta várias tarefas de visão por computador. A tabela abaixo mostra o suporte a tarefas e os modos operacionais (treino, validação, inferência e exportação) disponíveis para cada uma:
Somente pesos de detecção (yolo12n.pt, yolo12s.pt, yolo12m.pt, yolo12l.pt, yolo12x.pt) são publicados em ultralytics/assets. As arquiteturas de segmentação, classificação, pose e OBB são definidas em ultralytics/cfg/models/12/. Portanto, essas variantes permitem treinamento do zero usando a configuração .yaml, mas, no momento, não há arquivos .pt pré-treinados disponíveis para elas. Para obter pontos de verificação pré-treinados de segmentação, pose, classificação ou OBB, Ultralytics recomenda YOLO11 ou YOLO26.
| Tipo de modelo | Tarefa | Pesos pré-treinados | Treinamento | Validação | Inferência | Exportar |
|---|---|---|---|---|---|---|
| YOLO12 | Detecção | ✅ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-seg | Segmentação | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-cls | Classificação | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-pose | Pose | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-obb | OBB | ❌ | ✅ | ✅ | ✅ | ✅ |
Todas as arquiteturas YOLO12 oferecem suporte a todos os modos quando há um ponto de verificação treinado disponível. A coluna Pretrained Weights indica apenas se Ultralytics publica um .pt pré-treinado oficial em ultralytics/assets: para segmentação, pose, classificação e OBB, você precisa treinar seu próprio ponto de verificação a partir do .yaml correspondente antes de executar inferência, validação ou exportação.
Métricas de desempenho#
O YOLO12 melhora a precisão em todas as escalas do modelo, com algumas concessões de velocidade em comparação com os modelos YOLO anteriores mais rápidos. Seguem-se os resultados quantitativos de deteção de objetos no conjunto de validação COCO:
Desempenho de detecção (COCO val2017)#
| Modelo | tamanho (pixels) | mAPval50-95 | Velocidade CPU ONNX (ms) | Velocidade T4 TensorRT (ms) | parâmetros (M) | FLOPs (B) | Comparação (mAP/velocidade) |
|---|---|---|---|---|---|---|---|
| YOLO12n | 640 | 40.6 | - | 1.64 | 2.6 | 7.5 | +2.1%/-9% (em comparação com YOLOv10n) |
| YOLO12s | 640 | 48.0 | - | 2.61 | 9.3 | 23.3 | +0.1%/+42% (em comparação com RT-DETRv2) |
| YOLO12m | 640 | 52.5 | - | 4.86 | 20.2 | 70.7 | +1.0%/-3% (em comparação com YOLO11m) |
| YOLO12l | 640 | 53.7 | - | 6.77 | 26.4 | 95.4 | +0.4%/-8% (em comparação com YOLO11l) |
| YOLO12x | 640 | 55.2 | - | 11.79 | 59.1 | 208.9 | +0.6%/-4% (em comparação com YOLO11x) |
- Velocidade de inferência medida numa GPU NVIDIA T4 com precisão FP16 no TensorRT.
- As comparações mostram a melhoria relativa em mAP e a variação percentual na velocidade (valor positivo indica maior velocidade; valor negativo indica menor velocidade). As comparações são feitas com base nos resultados publicados para YOLOv10, YOLO11 e RT-DETR, quando disponíveis.
Exemplos de uso#
Esta secção apresenta exemplos de treino e inferência com YOLO12.
Os exemplos abaixo se concentram nos modelos YOLO12 Detect (para detecção de objetos). Para outras tarefas compatíveis (segmentação, classificação, estimativa de pose e detecção de objetos orientados), consulte a documentação específica de cada tarefa: Segment, Classify, Pose e OBB.
Modelos *.pt pré-treinados (usando PyTorch) e arquivos de configuração *.yaml podem ser passados para a classe YOLO() para criar uma instância do modelo em Python:
from ultralytics import YOLO

# Carregar um modelo YOLO12n pré-treinado no COCO
model = YOLO("yolo12n.pt")

# Treina o modelo no conjunto de dados de exemplo COCO8 durante 100 épocas
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Executar inferência com o modelo YOLO12n na imagem 'bus.jpg'
results = model("path/to/bus.jpg")
Principais melhorias#
-
Extração de características aprimorada:
- Atenção por áreas: processa campos recetivos grandes com eficiência, reduzindo o custo computacional.
- Equilíbrio otimizado: melhora o equilíbrio entre os cálculos de atenção e da rede de propagação direta.
- R-ELAN: aprimora a agregação de características usando a arquitetura R-ELAN.
-
Inovações de otimização:
- Conexões residuais: introduz conexões residuais com escalonamento para estabilizar o treinamento, especialmente em modelos maiores.
- Integração refinada de características: implementa um método aprimorado de integração de características em R-ELAN.
- FlashAttention: incorpora FlashAttention para reduzir a sobrecarga de acesso à memória.
-
Eficiência da arquitetura:
- Menos parâmetros: alcança uma quantidade menor de parâmetros, mantendo ou melhorando a precisão em comparação com muitos modelos anteriores.
- Atenção simplificada: usa uma implementação de atenção simplificada, sem codificação posicional.
- Proporções de MLP otimizadas: ajusta as proporções de MLP para distribuir os recursos computacionais de forma mais eficaz.
Requisitos#
Por padrão, a implementação Ultralytics YOLO12 não exige FlashAttention. No entanto, é possível compilar FlashAttention e usá-lo opcionalmente com YOLO12. Para compilar FlashAttention, você precisa de uma das seguintes GPUs NVIDIA:
- GPUs Turing (por exemplo, T4, série Quadro RTX)
- GPUs Ampere (por exemplo, série RTX30, A30/40/100)
- GPUs Ada Lovelace (por exemplo, série RTX40)
- GPUs Hopper (ex.: H100/H200)
Citações e agradecimentos#
Se usares YOLO12 na tua pesquisa, cita o trabalho original da University at Buffalo e da University of Chinese Academy of Sciences:
@inproceedings{tian2025yolov12,
  title={YOLOv12: Attention-Centric Real-Time Object Detectors},
  author={Tian, Yunjie and Ye, Qixiang and Doermann, David},
  booktitle={Advances in Neural Information Processing Systems},
  volume={38},
  pages={78433--78457},
  year={2025},
  url={https://proceedings.neurips.cc/paper_files/paper/2025/file/7103444259031cc58051f8c9a4868533-Paper-Conference.pdf}
}

@software{yolo12,
  author = {Tian, Yunjie and Ye, Qixiang and Doermann, David},
  title = {YOLO12: Attention-Centric Real-Time Object Detectors},
  year = {2025},
  url = {https://github.com/sunsmarterjie/yolov12},
  license = {AGPL-3.0}
}
O artigo sobre YOLO12 foi publicado nos anais do NeurIPS 2025, com uma pré-publicação no arXiv.
Perguntas frequentes#
O YOLO12 incorpora várias inovações importantes para equilibrar velocidade e precisão. O mecanismo de atenção por áreas processa campos recetivos grandes com eficiência, reduzindo o custo computacional em comparação com a autoatenção padrão. As redes de agregação de camadas eficientes residuais (R-ELAN) melhoram a agregação de características e resolvem desafios de otimização em modelos maiores centrados em atenção. A arquitetura de atenção otimizada, que inclui a utilização de FlashAttention e a remoção da codificação posicional, aumenta ainda mais a eficiência. Estas características permitem ao YOLO12 alcançar elevada precisão, mantendo a velocidade de inferência em tempo real de que muitas aplicações precisam.
O YOLO12 suporta uma ampla variedade de tarefas essenciais de visão por computador: deteção de objetos, segmentação de instâncias, classificação de imagens, estimativa de pose e deteção de objetos orientados (OBB). Isto torna o YOLO12 aplicável a diversas áreas, desde a robótica e a condução autónoma até à imagiologia médica e à inspeção industrial. Nota que os pesos
.ptpré-treinados são atualmente publicados apenas para deteção; as arquiteturas de segmentação, pose, classificação e OBB são fornecidas como configurações.yamlpara treino a partir do zero.O YOLO12 melhora a precisão em todas as escalas de modelo em comparação com os modelos YOLO anteriores, como YOLOv10 e YOLO11, com algumas concessões em velocidade em relação aos modelos anteriores mais rápidos. Por exemplo, o YOLO12n alcança uma melhoria de +2,1% em mAP em relação ao YOLOv10n e de +1,2% em relação ao YOLO11n no conjunto de dados COCO val2017. Em comparação com modelos como RT-DETR, o YOLO12s oferece uma melhoria de +1,5% em mAP e um aumento de velocidade de +42%. Estas métricas destacam o excelente equilíbrio entre precisão e eficiência do YOLO12.
Por predefinição, a implementação Ultralytics do YOLO12 não requer FlashAttention. No entanto, podes compilar e usar FlashAttention opcionalmente com YOLO12 para minimizar a sobrecarga de acesso à memória. Para compilar FlashAttention, precisas de uma das seguintes GPUs NVIDIA: GPUs Turing (por exemplo, T4, série Quadro RTX), GPUs Ampere (por exemplo, série RTX30, A30/40/100), GPUs Ada Lovelace (por exemplo, série RTX40) ou GPUs Hopper (por exemplo, H100/H200). Assim, os utilizadores podem beneficiar de FlashAttention quando o hardware o suporta.
Esta página apresenta exemplos básicos de utilização para treino e inferência. O YOLO12 utiliza as mesmas interfaces de modos Train, Val, Predict e Export e as mesmas interfaces de tarefas Segment, Classify, Pose e OBB que os outros modelos Ultralytics.


Comentários69
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
Zixuan-He
I try use the YOLO12-seg, but with update to lastest version (> pip install -U ultralytics) it is still showing (No such file or directory: 'YOLO12n-seg.pt) with code (yolo segment train data=data.yaml model=YOLO12n-seg.pt epochs=200 batch=16 imgsz=640 patience=25 ). theYOLO12n.pt for obj is good. Is the code changed or need other input?
1 Glenn JocherUltralytics
@Zixuan-He Answer:
The YOLO12-seg model requires using its specific configuration file. Trymodel=yolo12-seg.yamlinstead of the.ptfile to initialize training. The segmentation weights are not yet released as pretrained.ptfiles, but you can train from scratch using the YAML configuration. For details, see the YOLO12-seg documentation.2LucasGenoud
Hello, thank you for your answer ! Do you have any date estimation of when the pretrained segmentation models for YOLO12 will be available ? Thanks
- Glenn JocherUltralytics
We don't have an official release date for YOLO12-seg pretrained weights yet, but you can train segmentation models from scratch using the YOLO12-seg.yaml configuration. For updates, please monitor the YOLO12 documentation.
Thank you for your response. Great work :)
- Glenn JocherUltralytics
Thank you for your kind words! We don't have a specific release date for YOLO12-seg pretrained weights yet, but you can monitor the YOLO12 documentation for updates. The team typically announces new model releases there first. For now, training from scratch using the YOLO12-seg.yaml configuration remains the recommended approach.
dolokbutarbutar24
Here are some sample images for the healthy class. I also attached some "results" images, hopefully can give more information so you guys can help me with the project.
Pada Sen, 30 Mar 2026 pukul 15.58 Glenn Jocher @.***> menulis:
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune weight_decay, momentum, warmup_epochs, lrf, translate, shear, perspective, fliplr, and close_mosaic using the hyperparameter tuning guide https://docs.ultralytics.com/guides/hyperparameter-tuning/ and performance metrics guide https://docs.ultralytics.com/guides/yolo-performance-metrics/. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 https://docs.ultralytics.com/models/yolo26/ since YOLO12 is mainly maintained as a community research model.
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/19360?email_source=notifications&email_token=A23CVICPPIXOD6F3LMBB52T4TIZKDA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRTG44DGNRZUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16378369, or unsubscribe https://github.com/notifications/unsubscribe-auth/A23CVIG2PM2BD5335IFZQXT4TIZKDAVCNFSM6AAAAABXS26SR6VHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMMZXHAZTMOI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
Thanks, that helps; from those samples I’d next verify that the
healthylabels are fully consistent and that the class counts are not skewed, then please attach a few matching image/label.txtpairs plusresults.csvandconfusion_matrix_normalized.pngso we can check whether this is a data issue rather than a YOLO12 training issue, and if you recently fixed labels please delete anylabels/*.cachefiles before retraining.
I am currently working on a project to detect cassava leaf diseases using YOLOv12. The focus of this research is to perform hyperparameter tuning and also determine the most suitable augmentation configuration to improve model performance. So far, the trained model is still hovering around the 0.5 range for the mAP@50-95 evaluation metric. Here are the hyperparameters I have used for tuning so far: epochs=100, patience=20, imgsz=1024, batch=8, optimizer='auto', lr0=0.00511, box=6.32971, cls=2.87957, dfl=2.12658, mosaic=0.25, scale=0.15, mixup=0.0, copy_paste=0.0, degrees=10.0, hsv_h=0.015, hsv_s=0.7, hsv_v=0.4.
What other strategies can I do to improve my model's performance, especially on the mAP@50-95 evaluation metric? Do you have any suggestions for other hyperparameters that need to be added to this project for tuning? I'm sure your experience and skills can answer that and help me hahaha.
- Glenn JocherUltralytics
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune
weight_decay,momentum,warmup_epochs,lrf,translate,shear,perspective,fliplr, andclose_mosaicusing the hyperparameter tuning guide and performance metrics guide. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 since YOLO12 is mainly maintained as a community research model.
 Clousy
在5090 32G上使用yolo12l训练模型的时候,数据量大概7万左右,batch_size=24 内存占用在24G左右,为啥速度只有2-3it/s 是哪里设置有问题?下面是训练参数: rain_args = dict( data="data.yaml", epochs=500, imgsz=640, batch=24, device=device, workers=16,
cache=False, amp=True, # --- 减少 CPU 负担 --- mosaic=0.0, # 暂时关掉 Mosaic 看看速度是否飙升 mixup=0.0, # 同上 )- Glenn JocherUltralytics
yolo12l本身是重注意力结构,吞吐会比同尺度的 CNN 系列低不少,所以你看到的2–3 it/s在batch=24下未必异常(折算大约是48–72 img/s);如果你目标是更高训练/CPU 端速度,建议直接换到更稳更快的 Ultralytics YOLO26(YOLO12 更偏研究/基准用途,见 YOLO12 文档)。想确认是不是环境/数据读取瓶颈的话,请把yolo checks输出和完整文本训练日志(含第一轮的进度条行、CUDA:/显卡名、DataLoader相关信息)贴在这里;另外你现在cache=False可能会被磁盘 IO 卡住、workers=16在部分系统上也会造成额外调度开销,建议先用下面这组参数做一次对照测试(同一数据/同一imgsz),看it/s是否明显变化:yolo checks yolo train model=yolo12l.pt data=data.yaml epochs=2 imgsz=640 batch=24 device=0 workers=8 cache=True mosaic=0.0 mixup=0.0
is there any video (tutorial) about how to classify plant disease? i'm confused about how to do it because i need guidance to do classify task
- Glenn JocherUltralytics(editado)
Yes—plant disease is just a standard image classification workflow; please follow the Ultralytics YOLO classification guide (and drop any follow-up questions here in this discussion so the Ultralytics team can see them), then try:
from ultralytics import YOLO

# ImageNet-pretrained classifier backbone (recommended starting point)
model = YOLO("yolo26n-cls.pt")

# Your dataset folder should contain train/ and val/ with one subfolder per class
model.train(data="path/to/plant_disease_dataset", epochs=50, imgsz=224)
If you share your dataset folder layout (just the directory tree) and what’s confusing you, I can point you to the exact next step.
asad121101
Hello , this new yolo12 is using what architecture in neck ? pan or fpn ? or some thing else ?
Sourabh0052
while working on classification model using YOLO12-cls and i do not make any .yaml file, just simply provide the data source path then will it work same or not
radadiavasu
I faced a problem that recently I put my model on training with yolo12x but at 98/100 epoch it stopped due to units are over on colab pro but when I start again and expect to start from 98 but it start from 1/100 instead of 98 even in results.csv I couldn't get anything. Why this problem occurs?
deldanr
When resuming a training session started with Yolov12, after the AMP check, the training session downloads a Yolov11 model to continue, which I assume is an error.
Attached is part of the log: YOLOv12l summary: 488 layers, 26,389,875 parameters, 26,389,859 gradients, 89.4 GFLOPs
Transferred 1245/1245 items from pretrained weights Freezing layer 'model.21.dfl.conv.weight' AMP: Running Automatic Mixed Precision (AMP) checks... Downloading https://github.com/ultralytics/assets/releases/download/v8.3.0/yolo11n.pt to 'yolo11n.pt'... <-- Here's the error
pvurda
Has anyone found a low-cost, low-latency way to generate a short semantic scene caption (e.g., “two people loading a van”) on top of YOLO12 detections in real time?