Датасет MNIST#
Датасет MNIST (Модифицированный Национальный институт стандартов и технологий) — это эталонный набор для классификации изображений, включающий 70 000 чёрно-белых изображений рукописных цифр размером 28x28 из 10 классов — от 0 до 9. В нём предусмотрено разделение на 60 000 обучающих и 10 000 тестовых изображений; долгое время он служил стандартным эталоном для оценки алгоритмов машинного обучения и компьютерного зрения. Для более сложного аналога с изображениями одежды см. связанный датасет Fashion-MNIST, а для цветных изображений — CIFAR-10.
Открой MNIST на платформе Ultralytics, чтобы просмотреть примеры, изучить статистику датасета и клонировать его для обучения.
Основные особенности#
- MNIST содержит 60 000 обучающих и 10 000 тестовых изображений рукописных цифр — всего 70 000.
- Каждое изображение — это чёрно-белая картинка размером 28x28 с одной цифрой, нормализованной по размеру и сглаженной до рамки 20x20, а затем расположенной по центру кадра 28x28.
- 10 классов охватывают цифры от 0 до 9; количество изображений в каждом классе примерно одинаково.
- Датасет поставляется с заранее заданным разделением на обучающую и тестовую выборки, поэтому вручную или автоматически разделять данные не нужно.
- MNIST — стандартный эталон для исследований в области классификации изображений и глубокого обучения.
Структура набора данных#
MNIST поставляется с официальным заранее заданным разделением, поэтому автоматически или вручную распределять данные не нужно:
- Классы: 10 (рукописные цифры от 0 до 9)
- Всего изображений: 70 000 (черно-белые, 28x28)
- Обучающая выборка: 60 000 изображений
- Тестовая выборка: 10 000 изображений
В MNIST нет отдельной папки для валидации, поэтому по умолчанию Ultralytics использует тестовую выборку из 10 000 изображений для валидации во время обучения.
Каждое изображение помечено соответствующей цифрой (от 0 до 9), поэтому MNIST — размеченный датасет, подходящий для задач классификации.
Применение#
MNIST широко используют для обучения и оценки моделей классификации изображений — от классических свёрточных нейронных сетей (CNNs) и методов опорных векторов (SVMs) до современных глубоких архитектур. Небольшие чёрно-белые изображения и 10 классов цифр делают его быстрым и воспроизводимым эталоном для сравнения алгоритмов и экспериментов в области компьютерного зрения.
Вот несколько распространённых примеров применения:
- Сравнительное тестирование новых алгоритмов классификации
- Обучение для изучения концепций машинного обучения
- Прототипирование систем распознавания изображений
- Тестирование методов оптимизации моделей
Использование#
Обучи классификационную модель YOLO на MNIST в течение 100 эпох с размером изображения 28. При первом использовании датасет автоматически скачивается и кэшируется; если тебе нужен полный контроль над предобработкой, исходные архивы gzip также доступны в базе данных MNIST. Полный список доступных аргументов см. на странице обучения и в руководстве по задаче классификации изображений.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-cls.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="mnist", epochs=100, imgsz=28)В Ultralytics также доступен data="mnist160" — подвыборка из 160 изображений, включающая первые восемь изображений каждой цифры (от 0 до 9) из обучающей и тестовой выборок. Она повторяет структуру папок MNIST, поэтому можно заменить датасет, не меняя остальные аргументы. Это удобно для конвейеров CI или предварительных проверок перед использованием полного датасета из 70 000 изображений.
yolo classify train data=mnist160 model=yolo26n-cls.pt epochs=5 imgsz=28Примеры изображений и аннотаций#
Примеры изображений из датасета MNIST:
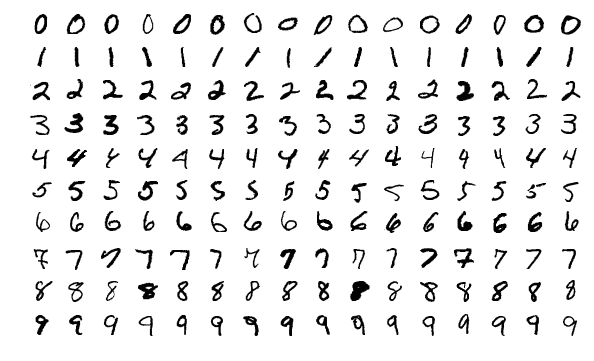
Примеры показывают разнообразие почерков, представленных в 10 классах цифр.
Цитирование и благодарности#
Если ты используешь датасет MNIST в исследованиях или разработке, укажи в цитировании следующую статью:
@article{lecun2010mnist,
         title={MNIST handwritten digit database},
         author={LeCun, Yann and Cortes, Corinna and Burges, CJ},
         journal={ATT Labs [Online]},
         volume={2},
         year={2010}
}
Мы выражаем благодарность Yann LeCun, Corinna Cortes и Christopher J.C. Burges за создание и поддержку датасета MNIST, ценного ресурса для сообщества исследователей в области машинного обучения и компьютерного зрения. Подробнее о датасете MNIST и его создателях можно узнать на сайте датасета MNIST.
Часто задаваемые вопросы#
Датасет MNIST — это эталонный набор из 70 000 чёрно-белых изображений рукописных цифр размером 28x28, разделённых на 60 000 обучающих и 10 000 тестовых изображений из 10 классов от 0 до 9. Это стандартный ориентир для оценки алгоритмов классификации изображений: единый небольшой формат позволяет исследователям и инженерам сравнивать методы и отслеживать прогресс с минимальной подготовкой, поэтому MNIST остаётся популярным первым эталонным набором в машинном обучении.
В MNIST 10 классов — рукописные цифры от 0 до 9 — и всего 70 000 чёрно-белых изображений размером 28x28 пикселей. Датасет поставляется с заранее заданным разделением на 60 000 обучающих и 10 000 тестовых изображений; количество примеров каждой цифры примерно одинаково.
Чтобы обучить модель Ultralytics YOLO на MNIST, используй приведённые ниже фрагменты кода. При первом использовании датасет скачивается автоматически. Подробный список доступных аргументов обучения см. на странице обучения.
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n-cls.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="mnist", epochs=100, imgsz=28)MNIST поставляется с заранее заданным разделением: 60 000 обучающих и 10 000 тестовых изображений. В отличие от классификационных датасетов, организованных по папкам и автоматически разделяемых Ultralytics, официальное разделение MNIST используется без изменений, а тестовая выборка по умолчанию служит валидационной во время обучения.
Датасет MNIST содержит только рукописные цифры, а расширенный MNIST (EMNIST) включает цифры, а также прописные и строчные буквы. EMNIST разработан как преемник MNIST и использует тот же формат изображений размером 28x28 пикселей, поэтому он совместим с инструментами и моделями, созданными для исходного датасета MNIST. Благодаря более широкому набору символов EMNIST подходит для большего числа задач машинного обучения.
Да. Платформа Ultralytics позволяет загружать датасеты, обучать модели классификации изображений и развёртывать их без большого объёма кода. Это удобный способ проводить эксперименты с MNIST в облаке — другие подходящие варианты см. в обзоре датасетов для классификации.
MNIST проще многих современных датасетов, таких как CIFAR-10 или ImageNet, поэтому он идеально подходит для новичков и быстрых экспериментов. Более сложные датасеты представляют больше трудностей из-за цветных изображений и разнообразия категорий объектов, но MNIST по-прежнему ценен благодаря простоте, небольшому размеру файлов и исторической роли в развитии алгоритмов машинного обучения. В качестве более сложной прямой замены с такой же структурой см. Fashion-MNIST, который содержит изображения одежды вместо цифр.