Датасет Dog-Pose
Введение#
Набор данных Ultralytics Dog-Pose предназначен для оценки позы и составлен для определения ключевых точек собак. Он содержит 6,773 обучающих и 1,703 валидационных изображения.
Смотри: Как обучить модель Ultralytics YOLO на датасете оценки позы собак Stanford | Пошаговое руководство
На каждом размеченном изображении указаны 24 ключевые точки, для каждой из которых заданы 3 значения (x, y, visibility); набор данных подходит для исследований и приложений, связанных с оценкой позы собак.
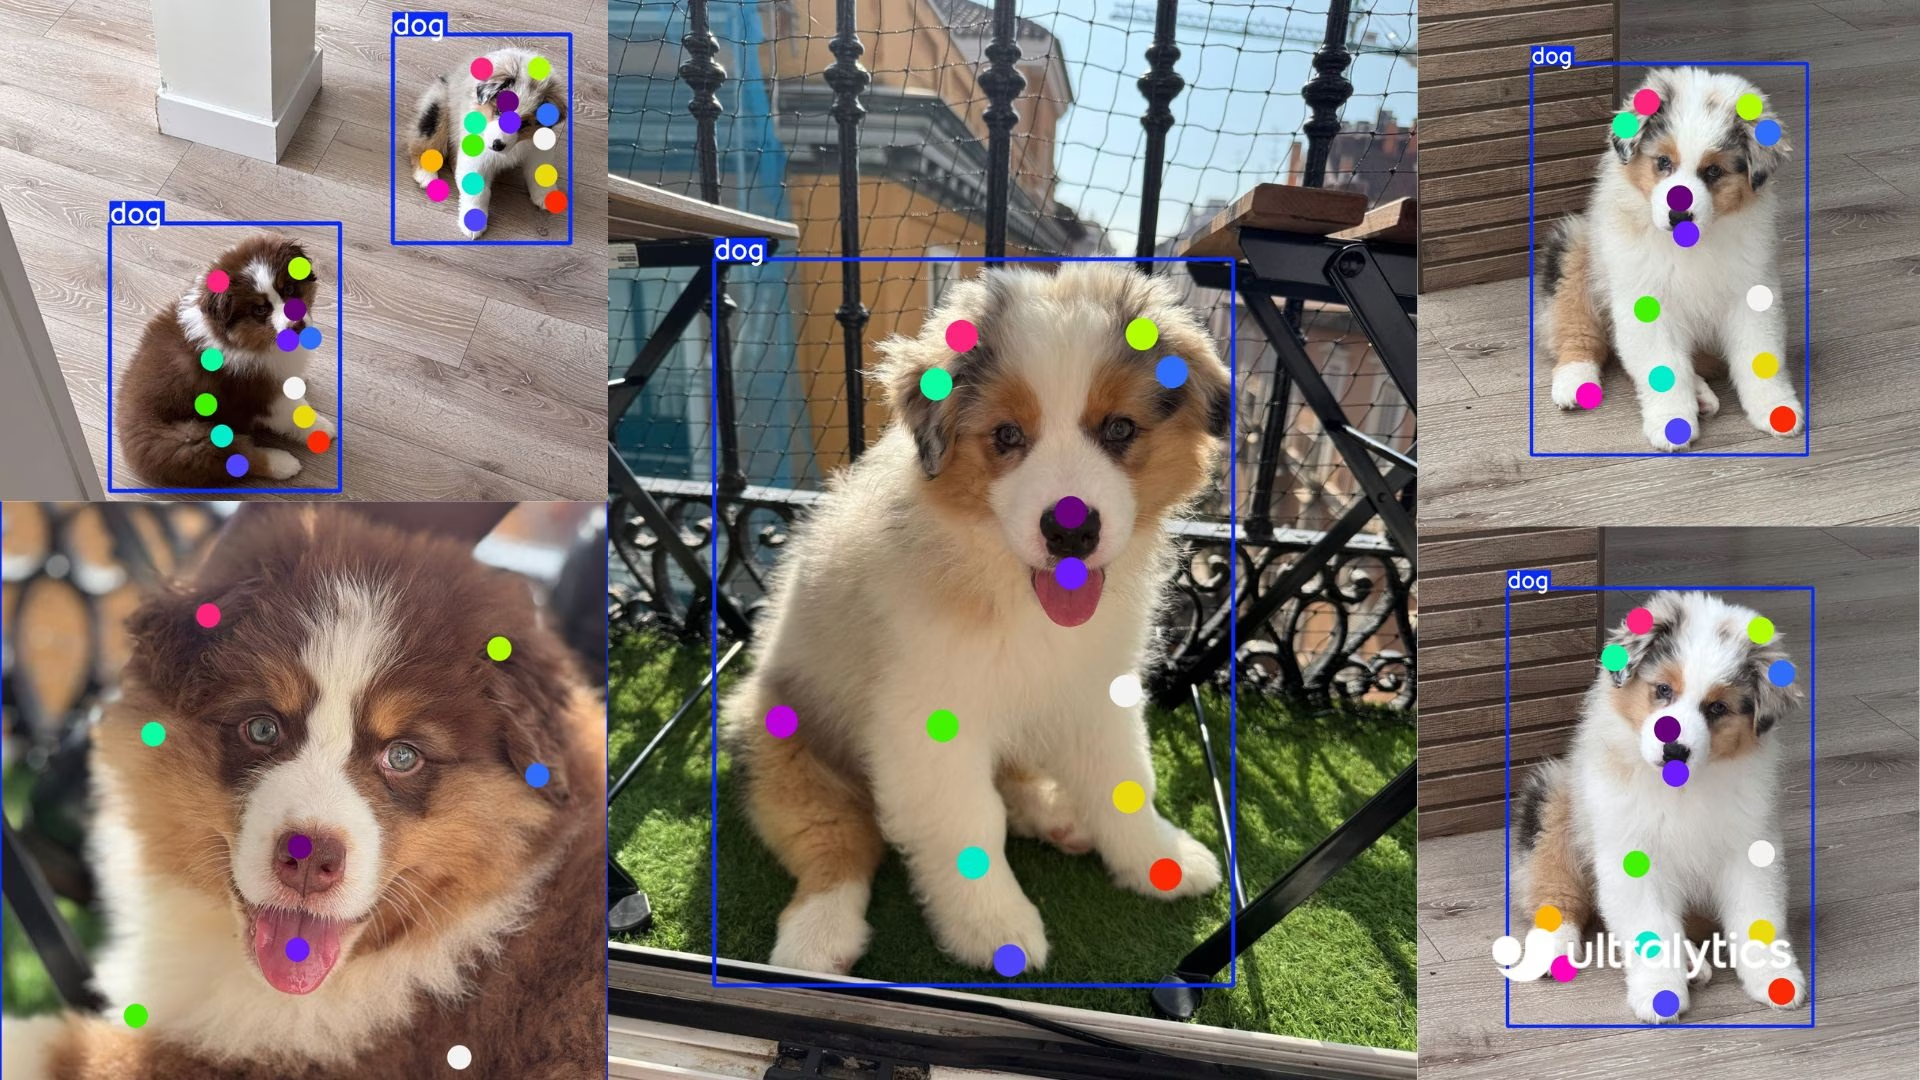
Если тебе нужна конкретная порода или совсем другое животное, платформа Ultralytics позволяет загружать данные, размечать их и обучать собственную модель ключевых точек без необходимости управлять инфраструктурой.
Структура набора данных#
-
Всего изображений: 8 476 (6 773 train / 1 703 val) с соответствующими файлами разметки в формате YOLO.
-
Ключевые точки: 24 на собаку, представленные триплетами
(x, y, visibility). -
Размер загрузки: ~337 МБ.
-
Структура:
datasets/dog-pose/
├── images/{train,val}
└── labels/{train,val}
Файл YAML набора данных#
Для описания конфигурации датасета используется YAML-файл. В нём указаны пути, сведения о ключевых точках и другая необходимая информация. Для датасета Dog-Pose файл dog-pose.yaml доступен по адресу https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Dogs dataset http://vision.stanford.edu/aditya86/ImageNetDogs/ by Stanford
# Documentation: https://docs.ultralytics.com/datasets/pose/dog-pose
# Example usage: yolo train data=dog-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dog-pose ← downloads here (337 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dog-pose # dataset root dir
train: images/train # train images (relative to 'path') 6773 images
val: images/val # val images (relative to 'path') 1703 images

# Keypoints
kpt_shape: [24, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)

# Classes
names:
  0: dog

# Keypoint names per class
kpt_names:
  0:
    - front_left_paw
    - front_left_knee
    - front_left_elbow
    - rear_left_paw
    - rear_left_knee
    - rear_left_elbow
    - front_right_paw
    - front_right_knee
    - front_right_elbow
    - rear_right_paw
    - rear_right_knee
    - rear_right_elbow
    - tail_start
    - tail_end
    - left_ear_base
    - right_ear_base
    - nose
    - chin
    - left_ear_tip
    - right_ear_tip
    - left_eye
    - right_eye
    - withers
    - throat

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dog-pose.zipИспользование#
Чтобы обучить модель YOLO26n-pose на наборе данных Dog-Pose в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-pose.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="dog-pose.yaml", epochs=100, imgsz=640)
Примеры изображений и аннотаций#
Ниже приведены примеры изображений из датасета Dog-Pose с соответствующими аннотациями:
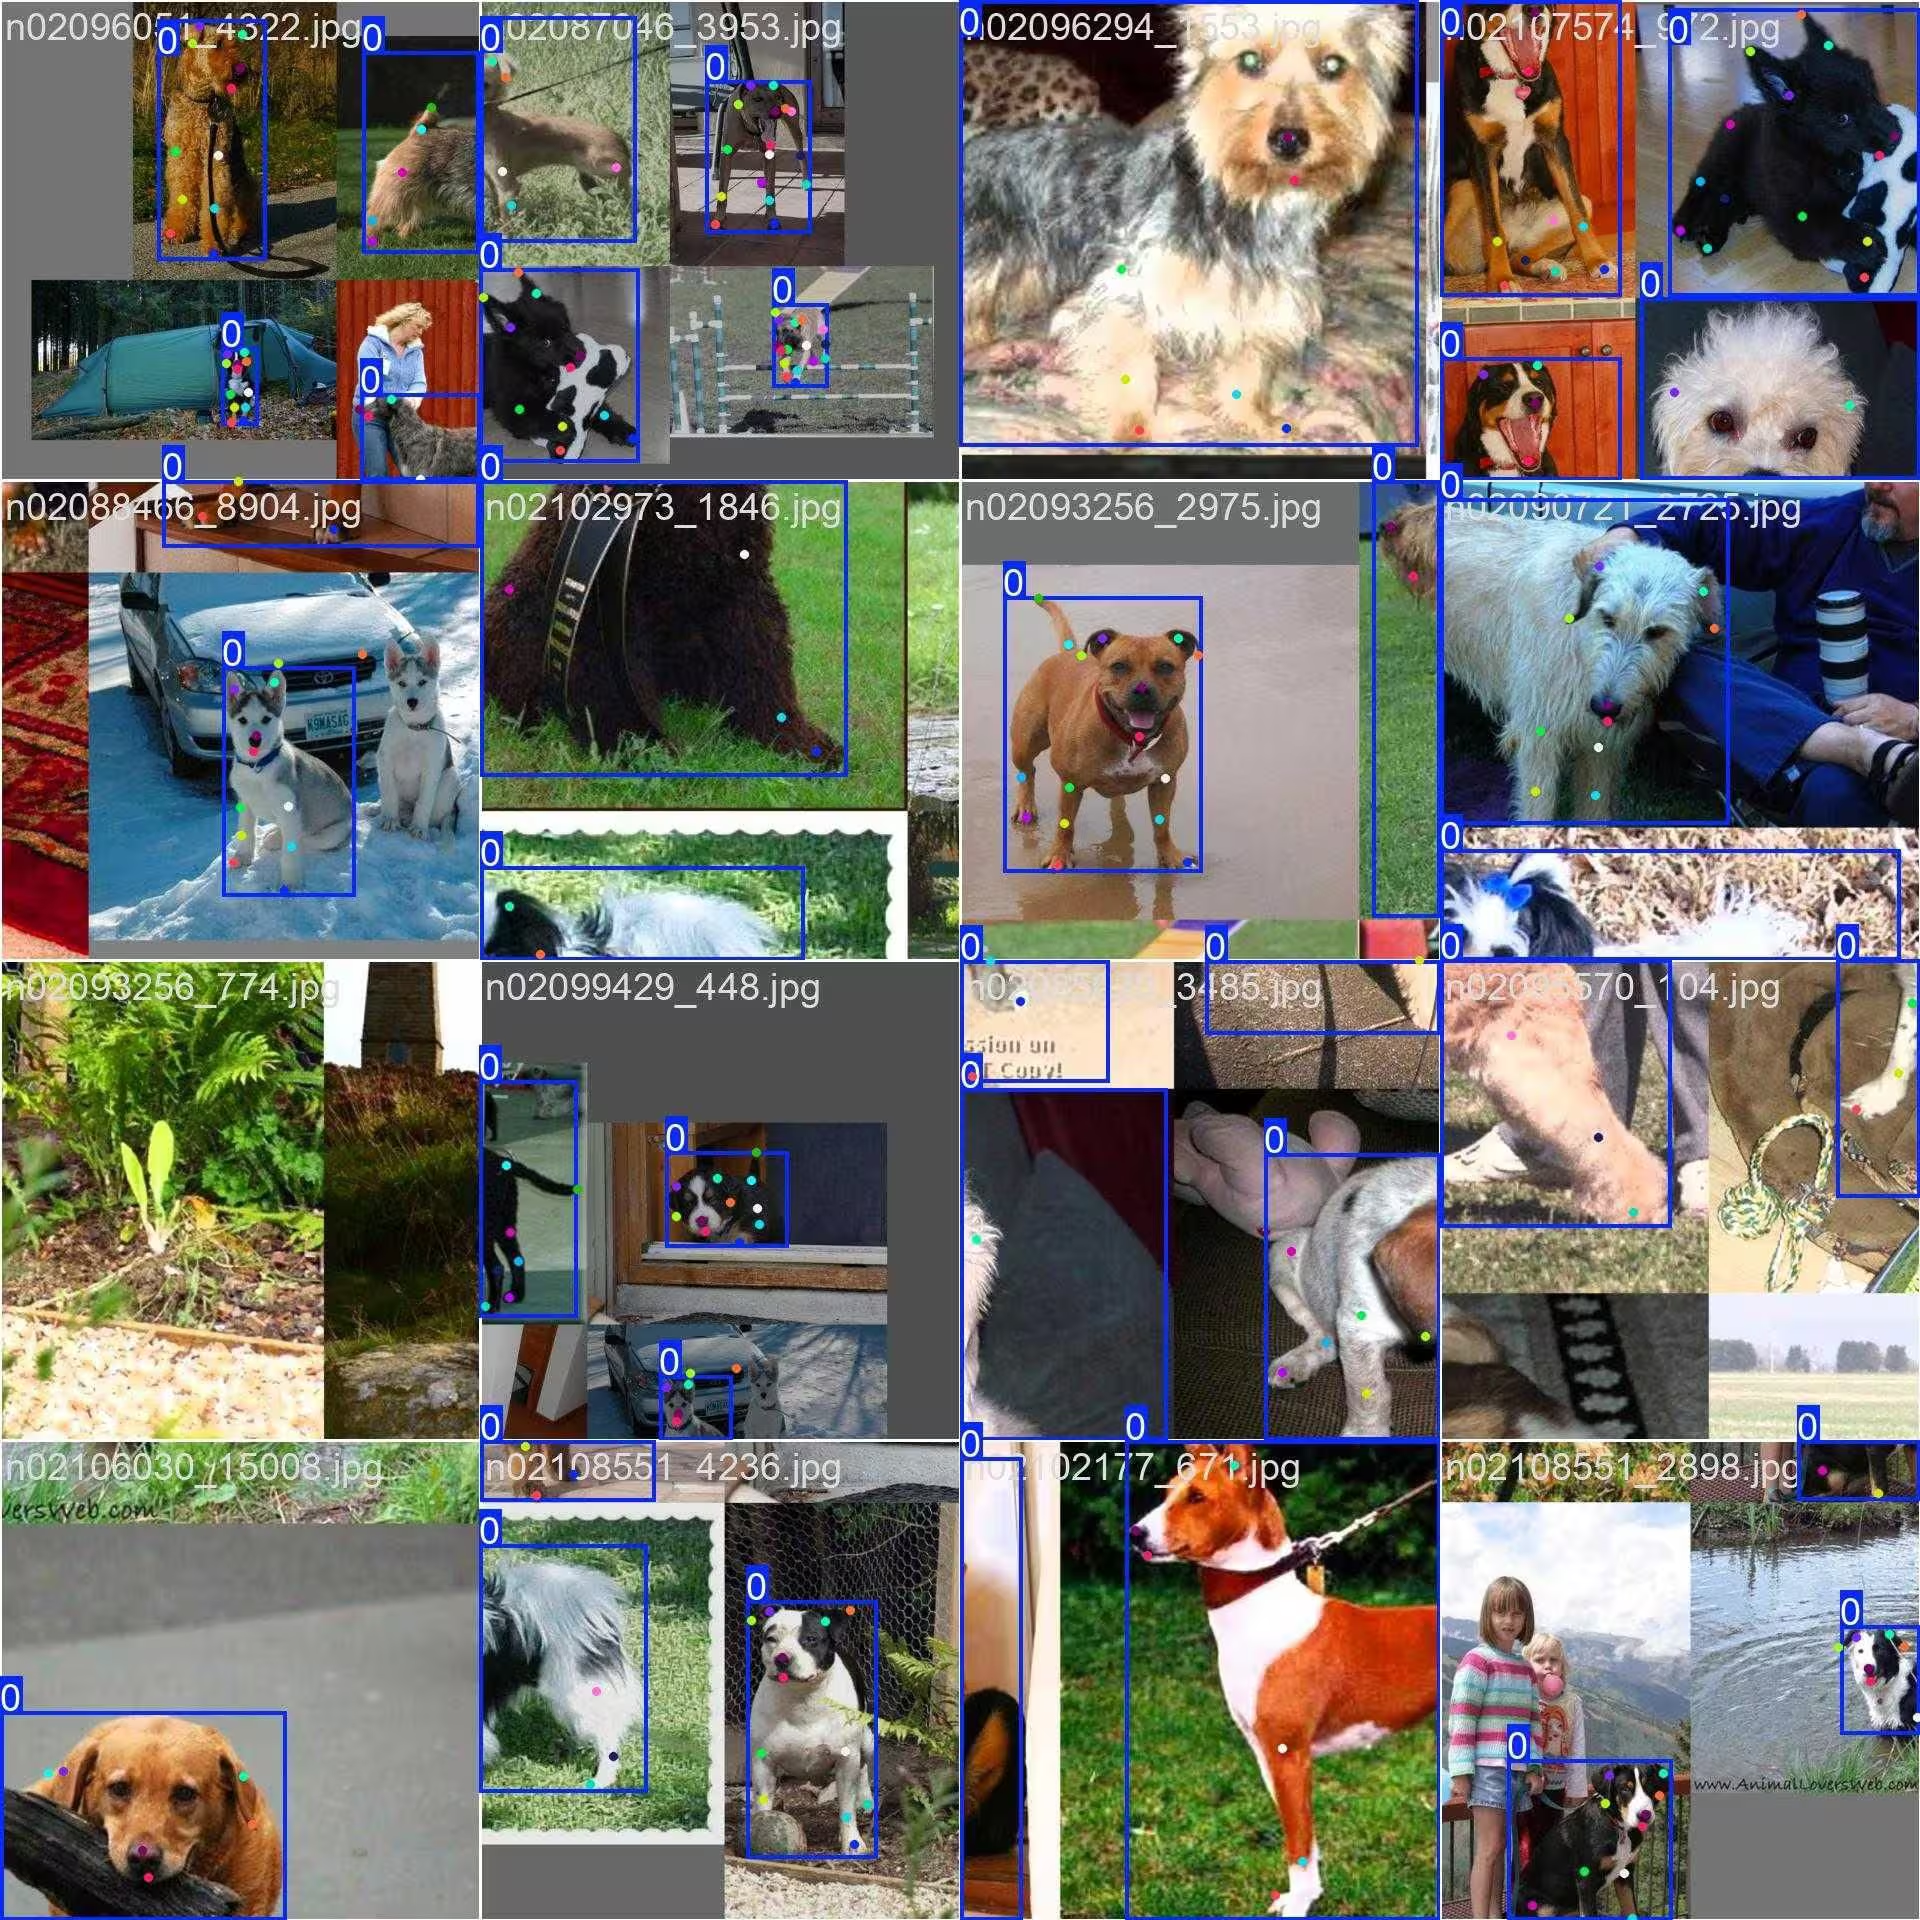
- Мозаичное изображение: на изображении показан обучающий батч, составленный из мозаично объединённых изображений датасета. Мозаичное объединение — это метод, применяемый во время обучения: несколько изображений объединяются в одно, чтобы увеличить разнообразие объектов и сцен в каждом обучающем батче. Это помогает модели лучше обобщать данные для объектов разных размеров, с разными соотношениями сторон и в разных контекстах.
Этот пример демонстрирует разнообразие и сложность изображений в датасете Dog-Pose, а также преимущества использования мозаичной аугментации при обучении.
Цитирование и благодарности#
Если ты используешь датасет Dog-Pose в исследованиях или разработке, процитируй следующую работу:
@inproceedings{khosla2011fgvc,
  title={Novel dataset for Fine-Grained Image Categorization},
  author={Aditya Khosla and Nityananda Jayadevaprakash and Bangpeng Yao and Li Fei-Fei},
  booktitle={First Workshop on Fine-Grained Visual Categorization (FGVC), IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
  year={2011}
}
@inproceedings{deng2009imagenet,
  title={ImageNet: A Large-Scale Hierarchical Image Database},
  author={Jia Deng and Wei Dong and Richard Socher and Li-Jia Li and Kai Li and Li Fei-Fei},
  booktitle={IEEE Computer Vision and Pattern Recognition (CVPR)},
  year={2009}
}
Мы хотели бы поблагодарить команду Стэнфорда за создание и поддержку этого ценного ресурса для сообщества компьютерного зрения. Подробнее о датасете Dog-Pose и его создателях можно узнать на сайте датасета Stanford Dogs.
Часто задаваемые вопросы#
Набор данных Dog-Pose содержит 6,773 обучающих и 1,703 валидационных изображения, размеченных 24 ключевыми точками для оценки позы собак. Он предназначен для обучения и валидации моделей с помощью Ultralytics YOLO26 и подходит для анализа поведения животных, наблюдения за питомцами и ветеринарных исследований. Подробная разметка делает его подходящим для разработки точных моделей оценки позы собак.
Загрузи
yolo26n-pose.ptи вызовиmodel.train(data="dog-pose.yaml", epochs=100, imgsz=640)— полный код на Python и примеры команд CLI смотри выше в разделе Пример обучения, а полный список аргументов — на странице модели Обучение.Набор данных Dog-Pose содержит 8 476 изображений (6 773 для обучения и 1 703 для валидации), охватывающих множество пород собак и поз, а каждая аннотация включает 24 ключевые точки в 3 измерениях (x, y, видимость). Благодаря этому модели получают охват реальных сценариев, необходимый для таких задач, как наблюдение за питомцами и анализ поведения.
Мозаичная аугментация объединяет несколько изображений Dog-Pose в одно обучающее изображение, увеличивая разнообразие поз собак, их размеров и фонов, которые модель видит на каждом шаге. Это улучшает обобщающую способность на новых контекстах и масштабах и снижает переобучение. Примеры изображений смотри в разделе Примеры изображений и аннотаций.
YAML-файл датасета Dog-Pose находится по адресу https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. В нём задаётся конфигурация датасета, включая пути, классы, сведения о ключевых точках и другую необходимую информацию. YAML-файл описывает 24 ключевые точки с тремя координатами для каждой, что делает датасет подходящим для подробной оценки позы.
Чтобы использовать этот файл в скриптах обучения YOLO26, укажи его в команде обучения, как показано в разделе Использование. При первом использовании набор данных загрузится автоматически, что упростит настройку.
Подробнее о моделях ключевых точек смотри в документации по задаче Оценка позы.


Комментарии12
Задай вопрос, поделись результатами или помоги кому-нибудь.
legend-zhen
Hello, although YOLOv11-pose can perform both object detection and pose estimation tasks simultaneously, there seems to be little correlation between the performance of pose estimation and object detection. What could be the reason for this? As I understand, YOLOv11-pose was specifically designed for human pose estimation, so can it also be perfectly adapted for animal pose estimation, as it is for humans? Are any special settings required when performing animal pose estimation?
 Glenn JocherUltralytics(изменено)
@legend-zhen YOLO26 and YOLO11 pose models are indeed versatile and can be adapted for animal pose estimation, such as with the Dog-Pose dataset. While the architecture is optimized for human pose estimation, adapting it to animals typically requires a dataset with accurate annotations (e.g., 24 keypoints for dogs in Dog-Pose). No special settings are mandatory beyond ensuring the dataset YAML file is properly configured. For details on Dog-Pose, check here.
Peakednesss
I can just find 20 points, 4 for ears, 1 for nose, 1 for mouth, 2 for tail, and 12 for legs, where are the other four points?
- Glenn JocherUltralytics(изменено)
@Peakednesss the Dog-Pose dataset has 24 keypoints. Beyond the 20 you found (ears, nose, chin, tail and legs), the other four are the left eye, right eye, withers and throat. The full list is in
kpt_namesin the dataset YAML: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. thank you very much
goodbetterbest1
do you know where are the other 4 points’ definitions? I can’t find any useful information in the yaml document. thx
chengziNaomi
When we annotate the key point data set in a picture, if the two boxes have overlapping parts, how to annotate the key points in the overlapping boxes?
- Glenn JocherUltralytics
@chengziNaomi when annotating overlapping bounding boxes in a keypoint dataset, ensure that each object's keypoints are labeled independently, even if they share overlapping regions. Annotate each keypoint based on its respective object, maintaining clear separation to avoid ambiguity during model training. For guidelines on keypoint annotation, refer to Dog-Pose Dataset Documentation.
If I have multiple objects in a picture, should I frame all the objects at once and then label the key points together, or should I frame an object, label the key points of that object, then frame an object, and then label the key points of that object?
- Glenn JocherUltralytics
@chengziNaomi when annotating a single image with multiple objects, you should annotate each object separately. Frame one object, label its keypoints completely, then move to the next object. This ensures clarity and avoids confusion during model training. Refer to Dog-Pose Dataset Documentation for more annotation insights.
Thank you very much! and how can I draw heatmap for key point detection?
- Glenn JocherUltralytics
You're welcome! To draw a heatmap for keypoint detection, you can preprocess the keypoints into Gaussian blobs on a blank image using libraries like OpenCV or NumPy, then overlay them on the original image. For detailed implementation, check external heatmap solutions or visualization tools as it currently falls outside YOLO's built-in features. Let me know if you have further questions!