Стратегии сбора и аннотирования данных для компьютерного зрения
Сбор данных и разметка — два основополагающих этапа любого проекта компьютерного зрения: сначала собирают репрезентативные изображения или видео, затем размечают их, чтобы модель могла на них обучаться. Качество данных напрямую определяет производительность модели, поэтому до начала обучения важно определить классы, собирать данные без смещения и выполнять разметку единообразно.
Смотри: Как разрабатывать эффективные стратегии сбора и аннотирования данных для компьютерного зрения 🚀
В этом руководстве рассматриваются настройка классов и сбор данных, понятие аннотирования данных, типы аннотаций и доступные форматы, а также эффективные стратегии разметки — каждое решение согласуется с целями твоего проекта.
Настройка классов и сбор данных#
Сбор изображений и видео для проекта по компьютерному зрению сводится к трём решениям: сколько классов определить, где брать данные и как не допустить смещения в наборе данных.
Как выбрать подходящие классы для проекта#
Один из первых вопросов при начале проекта по компьютерному зрению — сколько классов включить. Нужно определить состав классов, то есть категории или метки, которые модель должна распознавать и различать. Количество классов зависит от конкретных целей проекта.
Например, если ты хочешь отслеживать дорожное движение, в классы можно включить «автомобиль», «грузовик», «автобус», «мотоцикл» и «велосипед». А для отслеживания товаров в магазине можно использовать классы «фрукты», «овощи», «напитки» и «закуски». Определение классов с учётом целей проекта помогает сделать набор данных релевантным и сфокусированным.
Определяя классы, также важно решить, насколько подробно их нужно делить. Под «количеством» понимается число отдельных классов, которые тебе нужны. Это решение влияет на детализацию данных и сложность модели. Вот что следует учитывать в каждом случае:
- Небольшое количество классов: широкие категории, например «транспортное средство» и «не транспортное средство». Они упрощают аннотирование и требуют меньше вычислительных ресурсов, но дают менее подробную информацию, что может снизить эффективность модели в сложных сценариях.
- Большое количество классов: больше категорий с тонкими различиями, например «седан», «внедорожник», «пикап» и «мотоцикл». Такие классы позволяют собирать более подробные данные и повышать точность и производительность модели. Однако на их аннотирование уходит больше времени и труда, а также требуется больше вычислительных ресурсов.
Начать с более конкретных классов может быть очень полезно, особенно в сложных проектах, где важны детали. Более конкретные классы позволяют собирать более подробные данные, получать более глубокие выводы и чётче разграничивать категории. Это не только повышает точность модели, но и упрощает её последующую корректировку, экономя время и ресурсы.
Источники данных#
Можно использовать общедоступные наборы данных или собрать собственные. Общедоступные наборы, например на Kaggle и в поисковике наборов данных Google, содержат хорошо размеченные и стандартизированные данные, поэтому отлично подходят для начала обучения и валидации моделей.
Сбор собственных данных позволяет адаптировать набор данных к конкретным потребностям. Ты можешь снимать изображения и видео на камеры или дроны, собирать изображения из интернета или использовать имеющиеся внутренние данные организации. Собственные данные дают больше контроля над их качеством и релевантностью. Сочетание общедоступных и собственных источников помогает создать разнообразный и полный набор данных.
Как избежать смещения при сборе данных#
Смещение возникает, когда одни группы или сценарии представлены в наборе данных недостаточно, а другие — чрезмерно. В результате модель хорошо работает на одних данных и плохо — на других. Важно избегать смещения в ИИ, чтобы модель компьютерного зрения хорошо работала в самых разных сценариях.
Вот как избежать смещения при сборе данных:
- Разнообразие источников: собирай данные из множества источников, чтобы учесть разные точки зрения и сценарии.
- Сбалансированное представление: обеспечь сбалансированное представление всех релевантных групп. Например, учитывай разные возрастные группы, гендеры и этнические группы.
- Постоянный мониторинг: регулярно проверяй и обновляй набор данных, чтобы выявлять и устранять возникающее смещение.
- Методы снижения смещения: используй такие методы, как увеличение выборки недостаточно представленных классов, аугментация данных и алгоритмы, учитывающие справедливость.
Соблюдение этих рекомендаций помогает создать более надёжную и справедливую модель, способную хорошо обобщать данные в реальных приложениях.
Что такое аннотирование данных?#
Аннотирование данных — это процесс разметки данных, чтобы их можно было использовать для обучения моделей машинного обучения. В компьютерном зрении это означает разметку изображений или видео информацией, на которой модель должна обучаться. Без правильно размеченных данных модели не смогут точно усвоить взаимосвязи между входными и выходными данными.
Типы аннотирования данных#
В зависимости от требований конкретной задачи компьютерного зрения используются разные типы аннотирования данных. Вот несколько примеров:
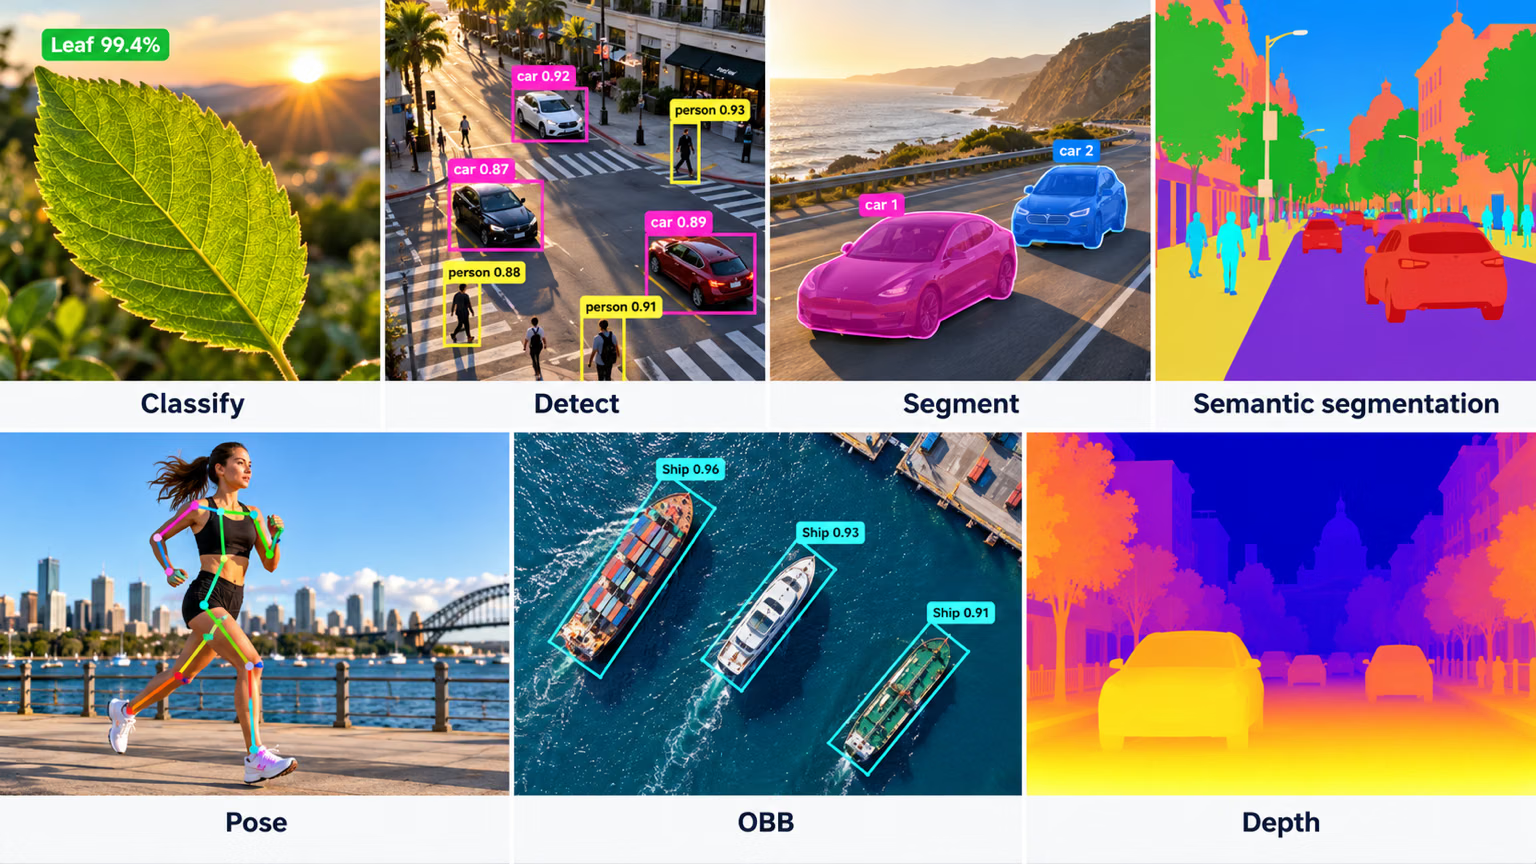
- Ограничивающие рамки: прямоугольники, нарисованные вокруг объектов на изображении и используемые главным образом для задач детекции объектов. Рамки задаются координатами верхнего левого и нижнего правого углов.
- Полигоны: подробные контуры объектов, обеспечивающие более точную разметку, чем ограничивающие рамки. Полигоны используются в таких задачах, как сегментация экземпляров, где важна форма объекта.
- Маски: бинарные маски, в которых каждый пиксель относится либо к объекту, либо к фону. Маски используются в задачах семантической сегментации, чтобы задавать разметку на уровне пикселей.
- Ключевые точки: определённые точки на изображении, отмечающие интересующие области. Ключевые точки используются в таких задачах, как оценка позы и обнаружение ориентиров лица.
- Поворотные ограничивающие рамки: прямоугольники с углом поворота, используемые в задачах OBB, где объекты могут располагаться под произвольным углом, например на аэрофотоснимках.
Распространённые форматы аннотаций#
Выбрав тип аннотации, важно определить подходящий формат для хранения аннотаций и обмена ими. Самые распространённые форматы:
| Формат | Структура файла | Типичные задачи |
|---|---|---|
| COCO | Один файл JSON | Детекция объектов, сегментация экземпляров, детекция ключевых точек, сегментация фона и паноптическая сегментация, создание подписей к изображениям |
| Pascal VOC | Один файл XML на изображение | Детекция объектов |
| YOLO | Один файл .txt на изображение | Детекция объектов, сегментация, оценка позы и поворотные рамки |
В формате YOLO для каждого объекта предусмотрена отдельная строка с индексом класса, отсчет которого начинается с 0. Для обнаружения объектов строка имеет вид class x_center y_center width height с нормализованными координатами от 0 до 1. В строке сегментации рамка заменяется нормализованными координатами точек полигона объекта, а строка позы сохраняет рамку и дополняет ее координатами ключевых точек; для каждой ключевой точки указывается флаг видимости, если набор данных содержит kpt_shape: [n, 3]. В строке OBB хранятся class x1 y1 x2 y2 x3 y3 x4 y4 с нормализованными координатами углов.
Если инструмент аннотирования экспортирует данные в формате COCO JSON, ты можешь преобразовать их в метки YOLO .txt или напрямую обучаться на JSON, используя собственный класс набора данных.
Составление правил аннотирования#
Выбрав тип и формат аннотации, следующим шагом нужно установить чёткие и объективные правила разметки. Эти правила задают основу для единообразия и точности на всех этапах аннотирования. Ключевые аспекты правил:
- Ясность и подробность: убедись, что инструкции понятны. Используй примеры и иллюстрации, чтобы показать, что именно требуется.
- Единообразие: придерживайся единообразия в аннотациях. Установи стандартные критерии для аннотирования разных типов данных, чтобы все аннотации соответствовали одним правилам.
- Снижение смещения: сохраняй нейтральность. Приучай себя к объективности и своди личные предубеждения к минимуму, чтобы обеспечить справедливость аннотаций.
- Эффективность: используй инструменты и рабочие процессы, которые автоматизируют повторяющиеся задачи, ускоряя и упрощая разметку.
Регулярно проверяй и обновляй правила разметки, чтобы аннотации оставались точными, единообразными и соответствовали целям проекта.
Инструменты аннотирования#
Хороший инструмент аннотирования позволяет размечать все типы данных, необходимые для задачи, обеспечивает соблюдение единых правил и экспортирует метки в формате, готовом для обучения. Ultralytics Platform включает встроенный редактор аннотаций для детекции, сегментации экземпляров, семантической сегментации, классификации, оценки позы и OBB, а также интеллектуальную аннотацию на основе SAM, которая одним щелчком создаёт маску для задач детекции, сегментации экземпляров, семантической сегментации и OBB. Поскольку аннотации сохраняются в формате, предусмотренном для каждой задачи, — в строках YOLO .txt для пространственных задач и папках классов для классификации, — размеченный набор данных можно сразу использовать для обучения, не выполняя преобразование.
Качество аннотаций: точность, прецизионность и выбросы#
Перед массовой разметкой полезно разобраться в точности, прецизионности, выбросах и контроле качества, чтобы не размечать данные контрпродуктивным образом.
Разбираемся в точности и прецизионности#
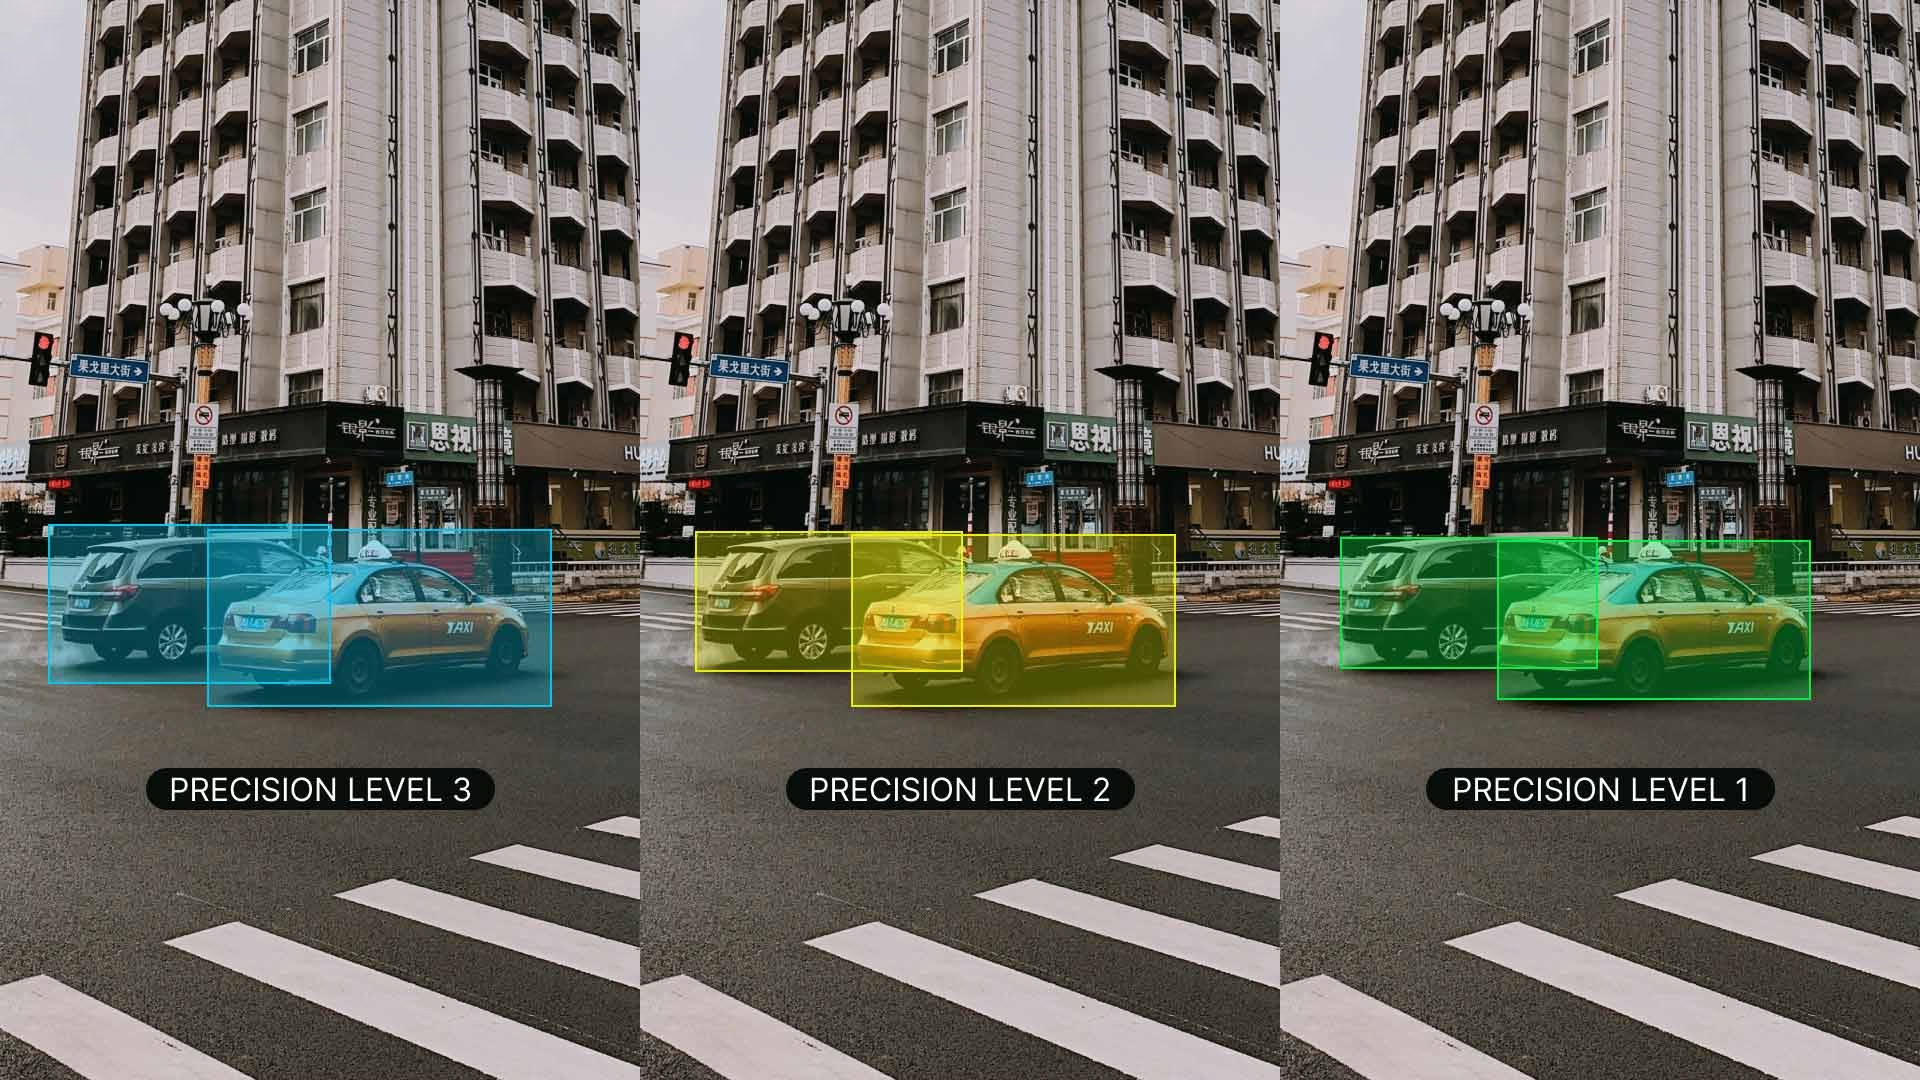
Важно понимать разницу между точностью и прецизионностью и то, как эти понятия связаны с аннотированием. Точность показывает, насколько размеченные данные соответствуют истинным значениям. Она помогает оценить, насколько метки отражают реальные сценарии. Прецизионность характеризует единообразие аннотаций. Она показывает, присваиваешь ли ты одному и тому же объекту или признаку одинаковую метку во всём наборе данных. Высокие точность и прецизионность позволяют лучше обучать модели, снижая уровень шума и повышая способность модели обобщать обучающие данные.
Выявление выбросов#
Выбросы — это точки данных, заметно отклоняющиеся от остальных наблюдений в наборе данных. В контексте аннотаций выбросом может быть неправильно размеченное изображение или аннотация, не согласующаяся с остальной частью набора данных. Выбросы опасны, поскольку могут искажать процесс обучения модели, приводя к неточным предсказаниям и плохому обобщению.
Для выявления и исправления выбросов можно использовать разные методы:
- Статистические методы: для выявления выбросов в числовых признаках, таких как значения пикселей, координаты ограничивающих рамок или размеры объектов, можно использовать диаграммы размаха, гистограммы или z-оценки.
- Визуальные методы: чтобы выявить аномалии в категориальных признаках, таких как классы объектов, цвета или формы, используй визуализацию изображений, меток или тепловых карт.
- Алгоритмические методы: используй такие инструменты, как кластеризация (например, кластеризация методом K-средних, DBSCAN) и алгоритмы обнаружения аномалий, чтобы выявлять выбросы на основе закономерностей распределения данных.
Контроль качества размеченных данных#
Как и в других технических проектах, контроль качества размеченных данных необходим. Рекомендуется регулярно проверять аннотации, чтобы убедиться в их точности и единообразии. Это можно делать несколькими способами:
- Проверка выборок размеченных данных
- Использование автоматизированных инструментов для выявления типичных ошибок
- Повторная проверка аннотаций другим человеком
Если ты работаешь с несколькими людьми, важно, чтобы разные разметчики действовали согласованно. Хорошее согласие между разметчиками означает, что инструкции понятны и все следуют им одинаково. Это помогает всем работать согласованно и поддерживать единообразие разметки.
Если во время проверки ты находишь ошибки, исправь их и обнови правила, чтобы предотвратить подобные проблемы в будущем. Давай аннотаторам обратную связь и регулярно проводи обучение, чтобы сократить количество ошибок. Надёжный процесс обработки ошибок помогает поддерживать точность и достоверность набора данных.
Эффективные стратегии разметки данных#
Чтобы упростить и повысить эффективность разметки данных, воспользуйся следующими стратегиями:
- Чёткие инструкции по разметке: Предоставь подробные инструкции с примерами, чтобы все аннотаторы одинаково понимали задачи. Например, при разметке птиц укажи, нужно ли размечать птицу целиком или только отдельные её части.
- Регулярная проверка качества: Установи контрольные показатели и используй конкретные метрики для проверки результатов, поддерживая высокие стандарты благодаря постоянной обратной связи.
- Используй инструменты предварительной разметки: Многие современные платформы для аннотирования предлагают функции предварительной разметки с помощью ИИ. Они могут значительно ускорить процесс, автоматически создавая начальные аннотации, которые затем дорабатывают люди.
- Внедри активное обучение: этот подход ставит в приоритет разметку наиболее информативных примеров, что позволяет сократить общее число необходимых аннотаций, сохранив качество модели.
- Пакетная обработка: Группируй похожие изображения для разметки, чтобы обеспечить единообразие и повысить эффективность.
Эти стратегии помогают поддерживать высокое качество аннотаций и сокращать время и ресурсы, необходимые для разметки.
Заключение#
Сбор разнообразных и непредвзятых данных и их единообразная разметка с помощью подходящих инструментов — основа надёжной модели компьютерного зрения. Когда датасет собран и размечен, перейди к руководству по этапам проекта компьютерного зрения, чтобы приступить к обучению и оценке. Если по ходу работы возникнут вопросы, обратись к сообществу в репозитории Ultralytics на GitHub или на сервере Ultralytics в Discord.
Часто задаваемые вопросы#
Чтобы свести предвзятость к минимуму, собирай данные из разных источников, обеспечивай сбалансированное представительство всех значимых групп (например, людей разного возраста, пола и этнической принадлежности), регулярно проверяй и обновляй датасет, чтобы выявлять новые виды предвзятости, и применяй методы её уменьшения, такие как увеличение числа примеров недостаточно представленных классов, аугментация данных и алгоритмы с учётом справедливости. Такой подход помогает модели компьютерного зрения хорошо работать в различных реальных сценариях и повышает её способность к обобщению.
Составь чёткие и объективные инструкции по разметке с подробными указаниями, примерами и иллюстрациями, а затем применяй их единообразно ко всем типам данных, чтобы каждая аннотация соответствовала одним и тем же правилам. Научи аннотаторов сохранять нейтральность, чтобы уменьшить влияние личной предвзятости, регулярно пересматривай и обновляй инструкции, а также используй автоматические проверки согласованности и обратную связь между аннотаторами, чтобы поддерживать высокую точность и соответствие целям проекта.
Для начала экспериментов с переносом обучения хватит нескольких сотен размеченных объектов каждого класса, но для надёжной работы в реальных условиях Ultralytics рекомендует не менее 1 500 изображений и 10 000 размеченных экземпляров каждого класса. Используй достаточно большой датасет и разумный график обучения — около 300 эпох обычно подходят для начала; сократи их количество, если модель рано переобучается. Тщательно размечай данные с учётом конкретных целей проекта. Изучи подробные стратегии обучения в руководстве по обучению YOLO26.
Да. Платформа Ultralytics включает встроенный редактор разметки, который позволяет работать с ограничивающими рамками, полигонами, ключевыми точками, ориентированными рамками и метками классов в едином рабочем пространстве. Интеллектуальная разметка на базе SAM ускоряет разметку для задач детекции, сегментации экземпляров, семантической сегментации и OBB, создавая маски по одному щелчку мыши; для разметки датасетов поз можно использовать модели YOLO для поз, а классификацию размечают вручную. Аннотации сохраняются в формате, ожидаемом для каждой задачи: строках YOLO
.txtдля пространственных задач и папках классов для классификации. После этого они готовы к обучению.Выбирай тип аннотации в соответствии с задачей, для которой собираешься обучать модель. Ограничивающие рамки быстрее всего рисовать, и для детекции объектов их достаточно. Полигоны и маски требуют заметно больше времени на каждый объект, но необходимы для сегментации экземпляров, когда важна точная форма объекта. Ключевые точки подходят для оценки позы и детекции ориентиров, а ориентированные рамки — для задач OBB, например обработки аэрофотоснимков, где прямоугольник с горизонтальными и вертикальными сторонами захватил бы слишком много фона. Размечай данные для самой точной из действительно необходимых тебе задач — так объём работы будет соответствовать результату.


Комментарии16
Задай вопрос, поделись результатами или помоги кому-нибудь.
 Letícia Rama
Hello,
Has anyone worked with oriented object detection using a multisource dataset that combines satellite and UAV imagery?
I am currently developing a scientific project focused on oriented detection of fishing vessels. As part of this work, I conducted two systematic reviews: one covering existing oriented detection models and another covering publicly available datasets. So far, I have identified multisource datasets that combine imagery from multiple satellite platforms; however, I have not found datasets that explicitly integrate both satellite and UAV images.
I understand the importance of source diversity to mitigate dataset bias and improve model generalization. That said, I would appreciate insights from the community on whether combining UAV and satellite imagery might introduce excessive domain variability (e.g., differences in spatial resolution, viewing angles, and sensor characteristics), potentially hindering model training and convergence.
Any experiences, references, or best practices related to this type of multisource setup would be highly appreciated.
 Glenn JocherUltralytics
Great question—mixing UAV + satellite can increase domain shift (GSD/resolution, look-angle, sensor PSF), but it’s usually manageable if you control the dataset and evaluation: keep one unified, very explicit labeling policy (same object extent/rotation rules) and balanced sampling as described in our Data Collection and Annotation guide, then train with per-source “slice” validation (sat-only/UAV-only) and consider staged training (pretrain on the larger domain, then fine-tune on the smaller) rather than a single fully-mixed run; if you’re using Ultralytics YOLO for oriented detection, the OBB task docs cover the expected label format and training flow—feel free to share your planned split strategy and a couple example tiles (UAV + satellite) here and the team/community can sanity-check the setup.
1- Letícia Rama
Hi Glenn,
To be more specific,
I am using a pretrained yolo26 m obb to perform detection of a single class: ships of a particular type (fishing boats).
I have a dataset with satellite optical images collected from google earth pro counting 331 pairs of images/labels. The total number of instances is 5974. Images size are fixed at 4823 height x 8192 width. The bounding boxes have 0.075 height x 0.04 width (according to yolo train results). Resolution varies from very-low to very-high. The images were captured with an altitude between 200-400 meters.
I also have 21 very-high resolution images collected from UAV. Images size are fixed at 3072 height x 4096 width. The images were captured with an altitude of 120 meters.
I would like to test if incorporating UAV images in training data would improved the models hability to detect the objects.
From what you proposed, please confirm if I understood correctly:
- Should the train set be mixed (sat+UAV) and the validation set be separate (sat-only/UAV-only)?
- If so, is this separation configured the staged training you are refering? That is, pretrain with sat+UAV as the train set and sat-only as validation subset, and further fine-tune with the same train subset (sat+UAV) but now using the uav-only as the validation set?
Thanks
- Letícia Rama
OBS.: sorry, sometimes I wrote 'train subset', and 'validation subset' but all of them was supposed to be written as 'train set', and 'validation set'.
- Glenn JocherUltralytics
Your first interpretation is correct: compare a satellite-only baseline against mixed satellite+UAV training while keeping fixed, disjoint satellite-only and UAV-only evaluation sets. This is not staged training—changing only the validation set does not fine-tune the model. Staged training would first train on satellite data, then continue from that checkpoint using only the UAV training split with a lower learning rate, evaluating both domains afterward. With only 21 UAV images, split by original scene before tiling to prevent leakage, and consider grouped k-fold validation because a single UAV split will be unstable.
1 - Letícia Rama
Understood, thanks.
Sudharsanam-1
hello ! For detecting 31 Chinese symbols (16 true and 15 fake), how many classes should be used in the model? Is it more efficient to detect the true symbols using only true class , or should we also include the fake symbols as separate classes?
Team-Q-Botix
I’m working on Robocon 2026 (Kung Fu Quest) and using YOLO-seg for detecting KFS symbols — ancient Chinese oracle bone characters. There are 15 true symbols, 15 fake ones (random patterns mimicking the real ones), plus 1 “other” class → total 31 classes.
Do you think instance segmentation (YOLOv8-seg / YOLOv11-seg) is the right approach for these detailed 2D symbols, or would box detection + contour refinement be better? Also, any advice on which model to start with and how large a dataset (per class) you’d recommend for good mask performance on Jetson Orin?
robert-hardman
Hello In object recognition with YOLO11 If we label images by drawing polygons: When training, does YOLO11 convert polygon coordinates to boxes? How does Inference handle polygon coordinates?
- Glenn JocherUltralytics
@robert-hardman yOLO11 does not inherently convert polygon annotations to bounding boxes during training. Polygons are used directly for tasks like instance segmentation, while bounding boxes are utilized for object detection. During inference, polygon annotations are retained for segmentation tasks, ensuring accurate object shape representation. For more on annotation types, refer to Data Annotation Guide.
1
ghost
Hello, thanks for the info ! I would like to know how to perform active learning, specifically what are the metrics to choose the most informative images when the task is multi-instance multi-class object detection ?
 Paula DerrengerUltralytics(изменено)
@cawilchesp hello! Great question on active learning for multi-instance multi-class object detection. Active learning can significantly enhance your model by iteratively selecting the most informative samples for annotation. Here are some key metrics and strategies to consider:
Metrics for Selecting Informative Images:
-
Uncertainty Sampling: Choose images where the model is least confident. This can be measured using:
- Entropy: High entropy indicates uncertainty in predictions.
- Margin Sampling: Select samples where the difference between the top two class probabilities is smallest.
- Least Confidence: Select samples with the lowest maximum class probability.
-
Diversity Sampling: Ensure a diverse set of samples to avoid redundancy.
- Core-Set Selection: Use clustering techniques to select a diverse subset of data points.
- Representative Sampling: Choose samples that represent the overall data distribution.
-
Error-Based Sampling: Focus on samples where the model previously made errors.
- Misclassified Samples: Select images where the model's predictions were incorrect.
- High Loss Samples: Choose samples with high loss values during training.
Implementing Active Learning:
Here's a basic example using least-confidence uncertainty sampling for detection, based on each image's mean box confidence (
result.probsis only available for classification models):import numpy as np from ultralytics import YOLO # Load your model model = YOLO('yolo26n.pt') # Predict on a batch of images results = model(['image1.jpg', 'image2.jpg', 'image3.jpg']) # Mean box confidence per image (0 if nothing was detected) scores = [r.boxes.conf.mean().item() if len(r.boxes) else 0.0 for r in results] # Select the image with the lowest confidence most_informative_image = results[int(np.argmin(scores))]Additional Resources:
For more detailed strategies and examples, you can refer to our Data Collection and Annotation Strategies.
Feel free to experiment with these methods and see which works best for your specific use case. If you have any further questions or need more examples, don't hesitate to ask! 😊
-
MoAbbasid
Hello, Im looking for an open source annotation tool similar to labelme that exports directly to YOLOv8 format, something other than labelme?
- Glenn JocherUltralytics
@MoAbbasid hello! For an open-source annotation tool that exports directly to YOLOv8 format, you might want to try CVAT. It's quite versatile and supports exporting annotations directly into YOLO format among others. Another good option could be Label Studio, which offers flexibility in configuring export formats, including YOLO. Both tools provide robust features for efficient data labeling and are well-suited for various annotation tasks. Happy annotating! 😊
1 @glenn-jocher do they offer polygon annotations for instance segmentation?
- Glenn JocherUltralytics(изменено)
Hello @MoAbbasid,
Yes, Ultralytics YOLO does support polygon annotations for instance segmentation. This allows for more precise labeling of objects compared to traditional bounding boxes, which can be particularly useful for complex shapes and detailed segmentation tasks.
To create polygon annotations, you can use tools like Roboflow Annotate or CVAT. Both of these tools support polygon annotations and can export the data in a format compatible with Ultralytics YOLO.
Here's a brief overview of how you can use Roboflow for this purpose:
- Create a Project: Start by creating a new project in Roboflow.
- Upload Images: Upload your images to the project.
- Annotate Images: Use the polygon tool to draw detailed outlines around objects. Roboflow also offers a SAM-based label assistant to speed up the annotation process.
- Export Annotations: Once your annotations are complete, you can export the dataset in YOLO format.
For more detailed steps on using Roboflow for data annotation and management, you can refer to the Roboflow documentation.
Here's a quick example of how to load and use a dataset with polygon annotations:
from ultralytics import YOLO

# Load a YOLO26 segmentation model
model = YOLO('yolo26n-seg.pt')

# Train the model on your custom dataset
model.train(data='path/to/your/dataset.yaml', epochs=100, imgsz=640)

# Validate the model
metrics = model.val()

# Make predictions
results = model.predict(source='path/to/your/images')

# Visualize results
results[0].show()
Feel free to reach out if you have any more questions or need further assistance. Happy annotating! 😊
1