Дистилляция знаний#
Быстрый старт#
Обучи компактную модель-ученик под руководством более крупной модели-учителя, добавив аргумент distill_model:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
Что такое дистилляция знаний?#
Дистилляция знаний переносит знания от большой и точной модели-учителя к меньшей модели-ученику. Ученик учится имитировать внутренние представления признаков учителя и часто достигает большей точности, чем при обучении с нуля.
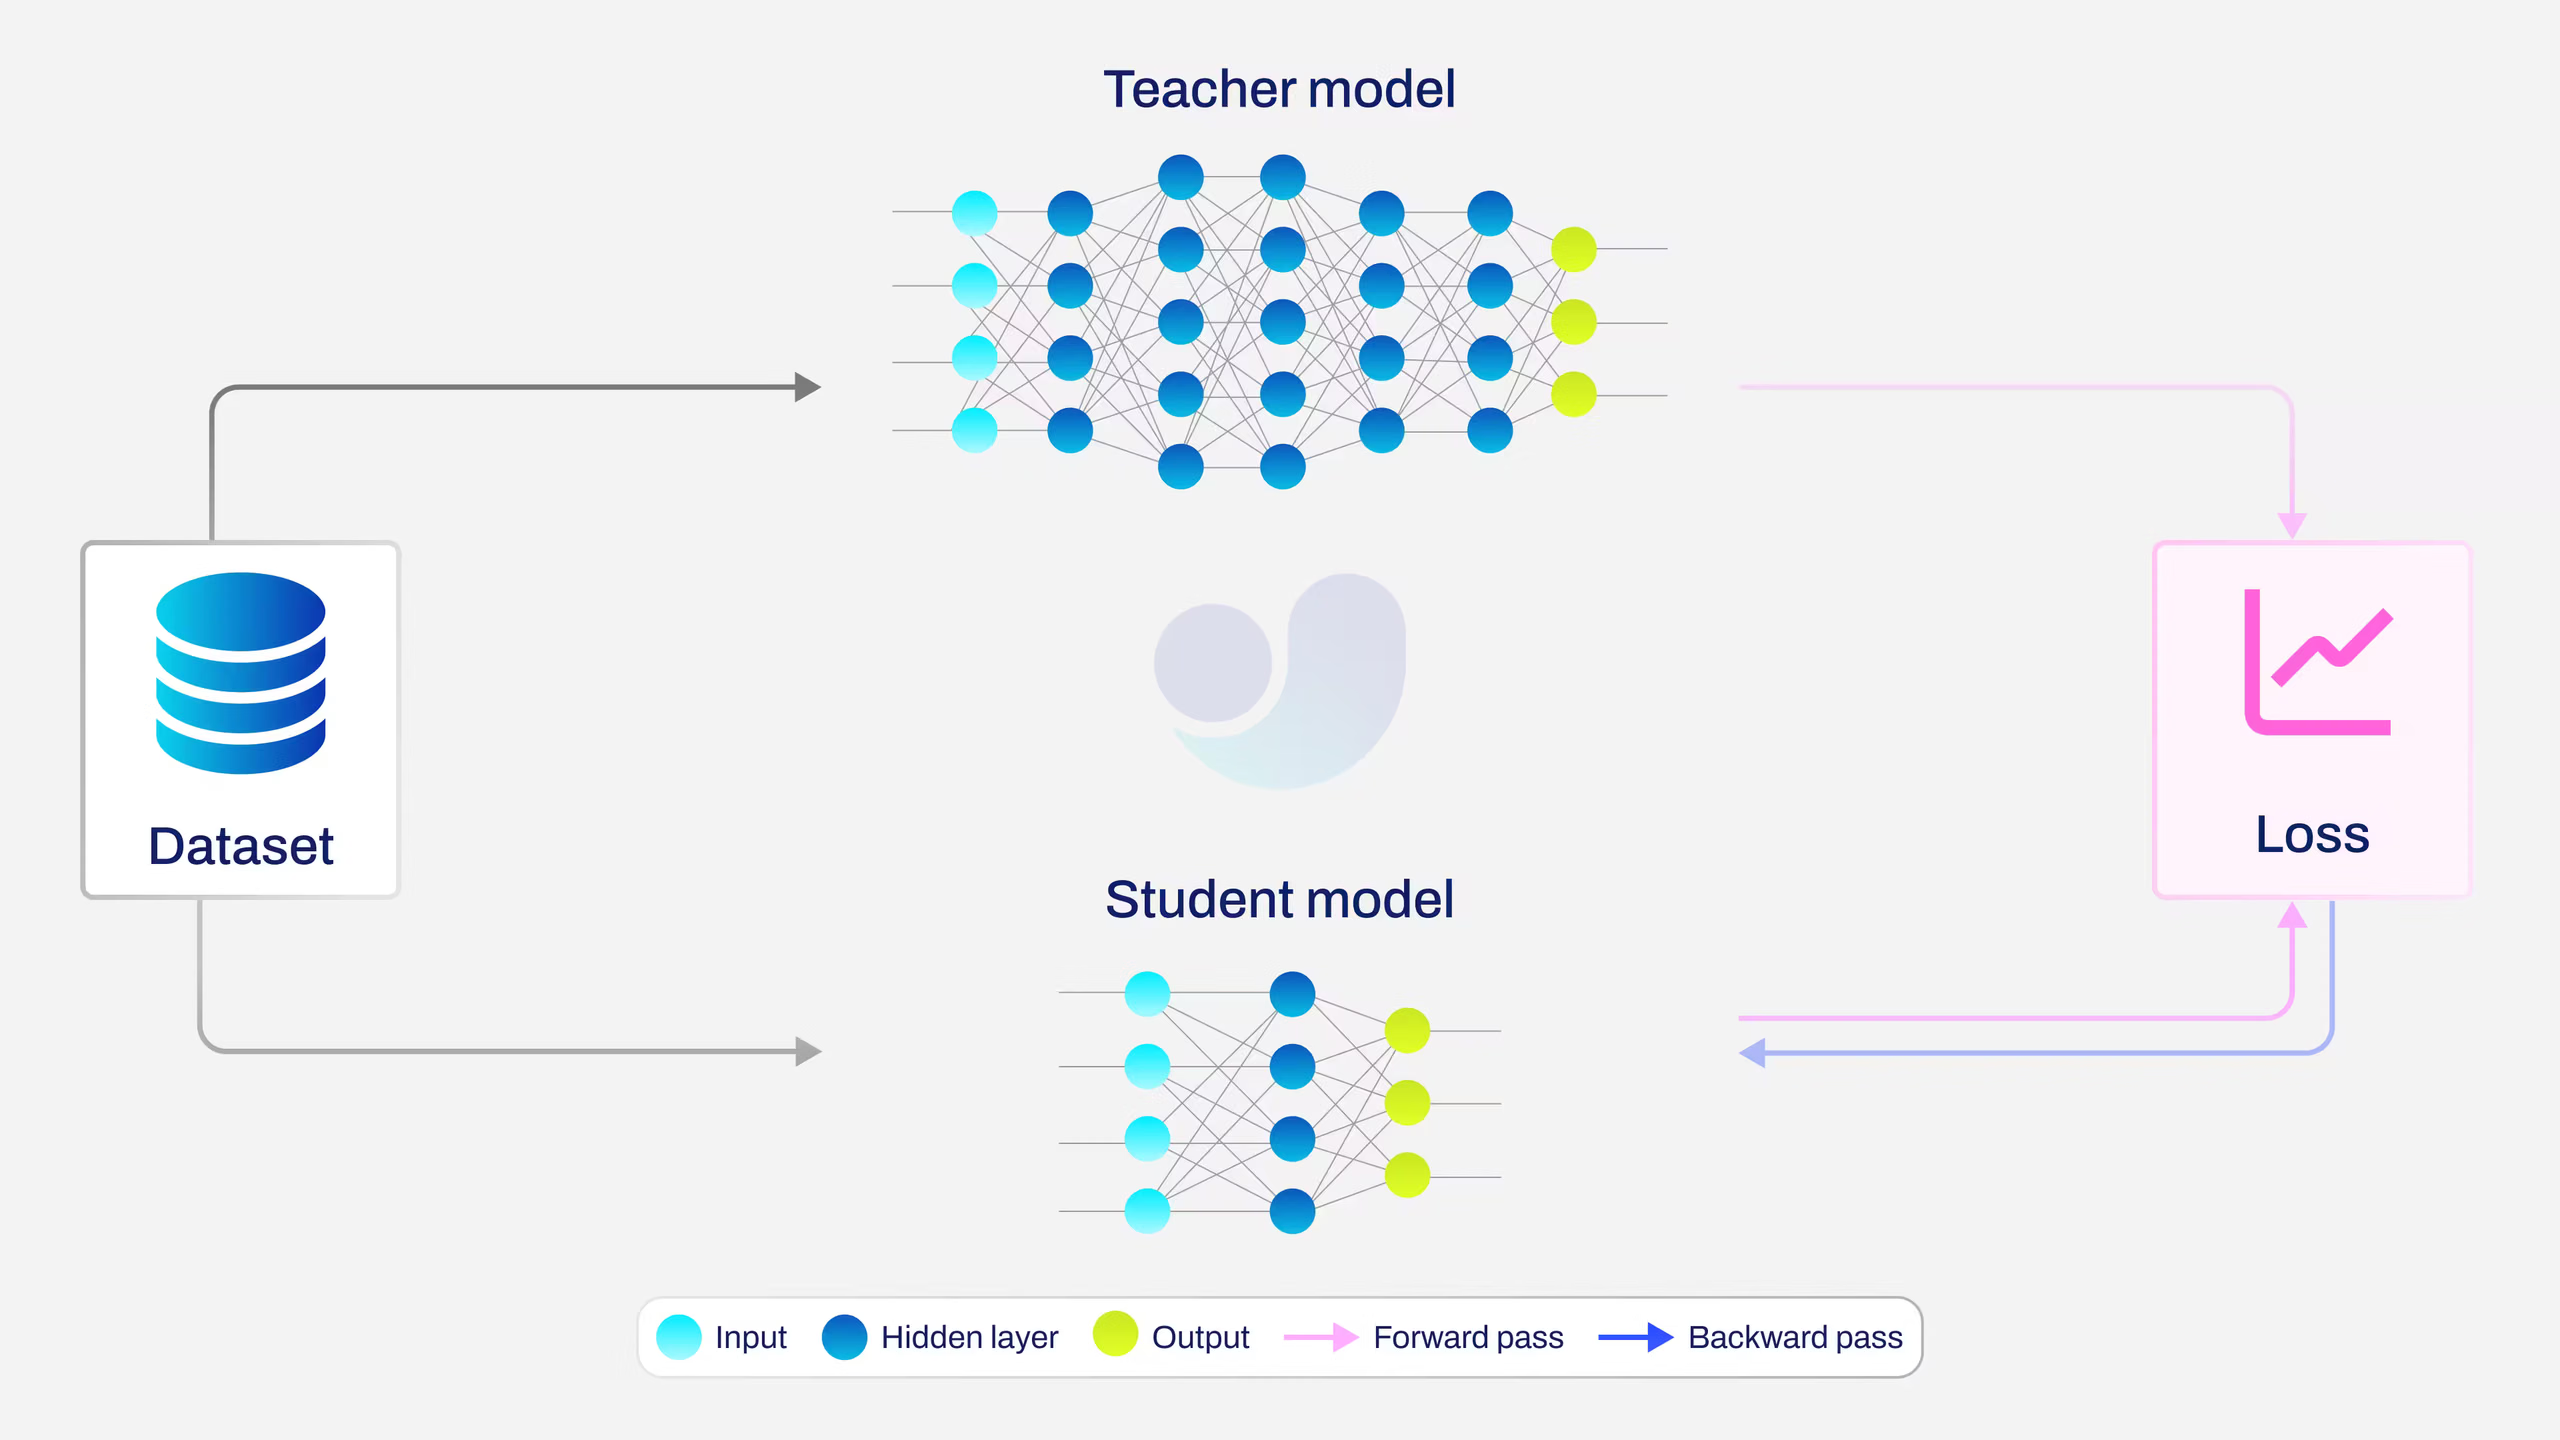
Используй дистилляцию, если:
- Тебе нужна компактная и быстрая модель для развёртывания
- У тебя есть точная модель-учитель, обученная на тех же данных
- Ты хочешь добиться большей точности, чем при стандартном обучении
Дистилляция знаний реализована для задач detect, segment, pose и obb. На данный момент экспериментально проверено повышение точности только для задачи detect.
Производительность#
Дистилляция знаний повышает mAP моделей всего семейства YOLO26 на COCO, не увеличивая время инференса. В таблице ниже сравниваются стандартные модели YOLO26 (базовые) с теми же моделями, обученными с дистилляцией от рекомендованных для них учителей.
| Модель | размер (пиксели) | mAPвалидации 50-95 базовая модель | mAPвалидации 50-95 после дистилляции | mAPвалидации 50-95 (e2e) базовая модель | mAPвалидации 50-95 (e2e) после дистилляции |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- Значения mAPval приведены для одной модели и одного масштаба на наборе данных COCO val2017.
Чтобы воспроизвести строку с дистилляцией, используйyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0; для столбца e2e добавьnms=False. - Для значений e2e используется путь инференса без NMS (
nms=False); для остальных значений используется стандартная постобработка NMS (nms=None). Подробнее см. в разделе «Сквозное обнаружение объектов».
Предварительные требования#
Перед началом убедись, что выполнены следующие требования:
- Обученная модель-учитель: контрольная точка
.ptиз того же семейства YOLO, что и модель-ученик. - Совпадение задач: используй модель-учителя для той же задачи, что и модель-ученик, и обучи её на подходящих данных.
- Ресурсы GPU: памяти должно хватать для обеих моделей; учитель выполняет только прямой проход, без градиентов и состояния оптимизатора.
Рекомендуемые пары моделей#
| Ученик | Рекомендуемый учитель |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
Дистилляция между разными семействами (например, YOLO11 в роли учителя и YOLO26 в роли ученика) не поддерживается.
Основные параметры#
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
distill_model | str | None | Путь к файлу модели-учителя (например, yolo26x.pt). Этот параметр включает дистилляцию знаний. |
dis | float | 6.0 | Вес функции потерь дистилляции. Определяет вклад этой функции потерь в общую функцию потерь обучения. |
Как это работает#
- Модель-учитель остаётся замороженной в режиме
evalи выполняет инференс на каждом батче - Модель-ученик обучается со стандартными функциями потерь для задачи и подсказками дистилляции
- Признаки извлекаются из обеих моделей на трёх слоях neck, подающих данные на голову семейства Detect
- Проектор из двух свёрточных слоёв 1×1 с ReLU приводит карты признаков ученика к числу каналов учителя
- Функция потерь L2 с весами по оценкам сравнивает проецированные признаки ученика с признаками учителя, взвешивая их по уверенности классификации учителя
- Функция потерь дистилляции объединяется со стандартными функциями потерь с весом
dis
flowchart TD
    A[Input Image Batch]:::start --> T[Teacher Model<br/>frozen, eval mode]:::extern
    A --> S[Student Model<br/>trainable]:::proc

    T --> |Detect head inputs| TF[Teacher Features]:::extern
    S --> |Detect head inputs| SF[Student Features]:::proc

    SF --> P[1×1 Conv Projector<br/>with ReLU]:::decide
    P --> AF[Aligned Student Features]:::proc

    TF --> SW[Score-weighted L2 Loss]:::proc
    AF --> SW

    S --> D[Detection Head]:::proc
    D --> DL[box_loss + cls_loss + l1_loss]:::proc

    SW --> |× dis| DIS[distillation loss]:::proc
    DL --> TOTAL[Total Loss]:::out
    DIS --> TOTAL

    TOTAL --> BP[Backpropagate<br/>Student + Projector only]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
    classDef out fill:#9C27B0,color:#fff
    classDef extern fill:#607D8B,color:#fff
Поддержка задач#
Реализация дистилляции извлекает признаки из трёх слоёв neck, подающих данные на голову модели семейства Detect. Поскольку головы segment, pose и obb наследуют ту же архитектуру Detect, дистилляция технически совместима и с этими задачами.
Классификация, семантическая сегментация, оценка глубины и RT-DETR не используют совместимую голову семейства Detect и не поддерживаются.
Экспериментально протестирована и проверена только задача detect. Дистилляцию можно запускать для segment, pose или obb, но повышение точности для этих задач пока не подтверждено.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")Обучение#
Базовое обучение#
Обучение с дистилляцией ничем не отличается от стандартного обучения. Чтобы включить дистилляцию, укажи путь distill_model:
from ultralytics import YOLO

# Загрузи модель-ученика
student = YOLO("yolo26m.pt")

# Обучи модель с дистилляцией знаний от более крупной модели-учителя
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Настройка веса функции потерь дистилляции#
Параметр dis (по умолчанию: 6.0) задаёт вклад функции потерь дистилляции:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Возобновление обучения с дистилляцией#
Обучение с дистилляцией можно возобновить из контрольных точек. Модель-учитель автоматически создаётся заново по пути distill_model, сохранённому в контрольной точке:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
Результаты обучения#
При включённой дистилляции в журналы обучения добавляется столбец dis_loss:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
Экспортированная модель содержит только веса ученика — размер файла и скорость инференса такие же, как у стандартно обученной модели-ученика.
Часто задаваемые вопросы#
- Убедись, что учитель и ученик относятся к одному поколению YOLO
- Проверь, что путь
distill_modelуказан правильно и файл загружается - Если значение функции потерь очень мало, попробуй увеличить
dis - Убедись, что модель-учитель обучена на том же наборе данных
Добавь параметр
distill_model— всё остальное работает так же. Во время обучения вычисляется дополнительная функция потерь дистилляции, но сохранённая модель остаётся стандартной моделью YOLO без дополнительных затрат.Да. Учитель выполняет прямой проход для каждого батча, поэтому затраты времени и памяти зависят от пары учитель/ученик. Учитель работает в режиме
eval, без градиентов и состояния оптимизатора.Дистилляция знаний поддерживается для задач detect, segment, pose и obb, поскольку при ней дистиллируются признаки из трёх слоёв neck, подающих данные на голову семейства Detect. Задачи classify, semantic, depth и RT-DETR не поддерживаются.
Экспериментально подтверждено повышение точности только для задачи detect. Задачи segment, pose и obb технически совместимы, но пока не проходили тестирование.
Учитель и ученик должны принадлежать к одному семейству YOLO (например, YOLOv8, YOLO11 или YOLO26). Дистилляция между разными семействами (например, учитель YOLO11 и ученик YOLO26) не поддерживается.