Задачи компьютерного зрения, поддерживаемые Ultralytics YOLO26
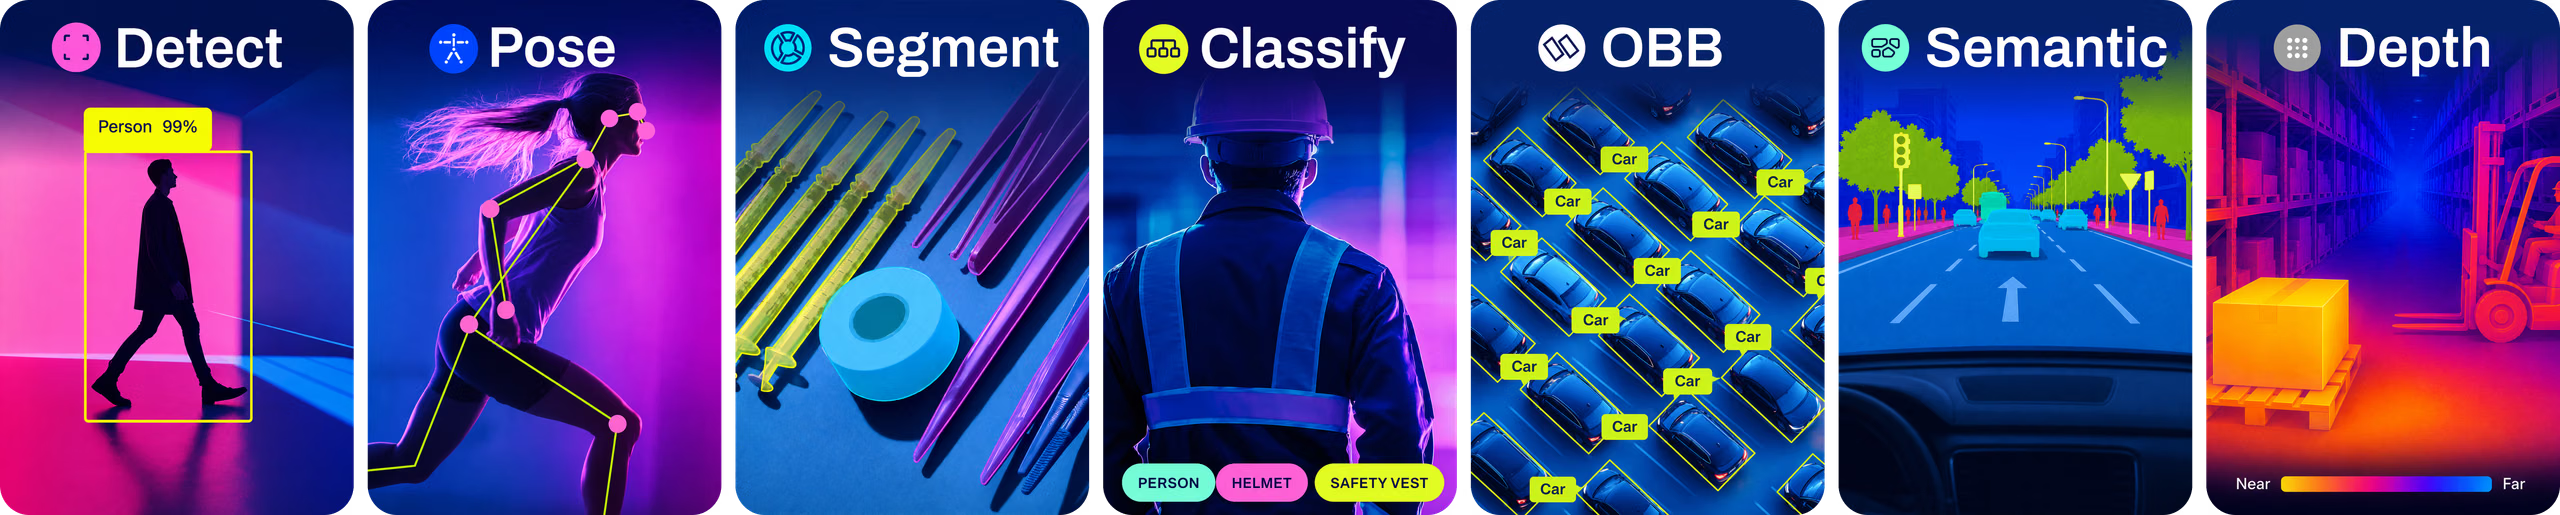
Ultralytics YOLO26 поддерживает несколько задач в области компьютерного зрения: детекцию, сегментацию, семантическую сегментацию, оценку глубины, классификацию, оценку позы и OBB. У каждой задачи своя цель и область применения, поэтому с помощью одного фреймворка ты можешь решать широкий спектр задач компьютерного зрения.
Информацию о планируемой поддержке YOLO27 см. в предварительном обзоре YOLO27. YOLO27 скоро выйдет, но пока недоступна; в этом руководстве используются выпущенные модели YOLO26.
Смотри: Изучи задачи Ultralytics YOLO26: детекция объектов, сегментация экземпляров, семантическая сегментация, оценка глубины, классификация, оценка позы и OBB.
Обнаружение#
Детекция объектов — основная задача, поддерживаемая YOLO26. Она заключается в поиске объектов на изображении или видеокадре и выделении их ограничивающими рамками. Обнаруженные объекты распределяются по категориям на основе их признаков. YOLO26 достаточно быстро обнаруживает несколько объектов на одном изображении или видеокадре для работы в реальном времени, например в системах видеонаблюдения и автономных транспортных средствах.
Сегментация экземпляров#
Сегментация экземпляров развивает возможности детекции объектов, создавая маски на уровне пикселей для каждого объекта. Такая точность полезна в медицинской визуализации, анализе сельскохозяйственных данных и контроле качества на производстве.
Семантическая сегментация#
Семантическая сегментация присваивает метку класса каждому пикселю изображения, создавая плотную карту классов всей сцены. В отличие от сегментации экземпляров, она не различает отдельные объекты одного класса. Поэтому она хорошо подходит для автономного вождения, анализа сцен и картирования земного покрова, где важнее понимать полную пространственную структуру, чем распознавать отдельные объекты.
Примеры семантической сегментации
Оценка глубины#
Монокулярная оценка глубины предсказывает карту глубины в метрах для каждого пикселя по одному RGB-изображению. На выходе получается плотная карта чисел с плавающей точкой, выровненная относительно входного изображения. Она подходит для реконструкции 3D-сцен, навигации роботов и приложений AR/VR, в которых нужно восстановить пространственную структуру по изображению с одной камеры.
Классификация#
Классификация изображений заключается в присвоении категории всему изображению на основе его содержимого. Эта задача полезна для классификации товаров в электронной коммерции, модерации контента и мониторинга дикой природы.
Оценка позы#
Оценка позы обнаруживает на изображениях или видеокадрах определенные ключевые точки, чтобы отслеживать движения или оценивать позы. Эти точки могут соответствовать суставам человека, чертам лица и другим важным ориентирам. Модели YOLO26 для оценки позы находят ключевые точки в реальном времени, поэтому они полезны для фитнес-приложений, спортивной аналитики и взаимодействия человека с компьютером.
OBB#
Детекция ориентированных ограничивающих рамок (OBB) расширяет возможности традиционной детекции объектов: угол поворота позволяет точнее локализовать повернутые объекты. Эта возможность особенно важна для анализа аэрофотоснимков, обработки документов и промышленных приложений, где объекты могут располагаться под разными углами. Модели YOLO26 OBB предварительно обучены на наборе аэрофотоснимков DOTAv1.
Что дальше#
Выбрал задачу? Подготовь данные в нужном формате с помощью руководства по датасетам, а затем обучи модель на собственных изображениях.
Часто задаваемые вопросы#
Ultralytics YOLO26 поддерживает следующие задачи компьютерного зрения:
- Обнаружение объектов: Определение объектов на изображениях или видеокадрах и их локализация с помощью ограничивающих рамок.
- Сегментация экземпляров: Создание пиксельной маски для каждого обнаруженного объекта; это полезно, например, в медицинской визуализации.
- Семантическая сегментация: Присвоение метки класса каждому пикселю изображения для детального понимания сцены.
- Оценка глубины: Предсказание карты глубины в метрах для каждого пикселя по одному RGB-изображению.
- Классификация: Отнесение целых изображений к категориям на основе их содержимого.
- Оценка позы: Обнаружение ключевых точек на изображении или видеокадре для отслеживания движений или поз.
- Обнаружение ориентированных объектов (OBB): Обнаружение повёрнутых объектов с учётом дополнительного угла ориентации для повышения точности.
Чтобы использовать Ultralytics YOLO26 для обнаружения объектов, выполни следующие шаги:
- Подготовь датасет в подходящем формате.
- Обучи модель YOLO26 для задачи обнаружения объектов.
- Передай модели новые изображения или видеокадры, чтобы получить предсказания.
Примерfrom ultralytics import YOLO # Загрузи предварительно обученную модель YOLO (при необходимости выбери другой тип модели) model = YOLO("yolo26n.pt") # Доступны версии n, s, m, l, x # Выполнить обнаружение объектов на изображении results = model.predict(source="image.jpg") # Можно также использовать видео, каталог, URL и т. д. # Отобрази результаты results[0].show() # Покажи результаты для первого изображенияПодробные инструкции см. в примерах обнаружения объектов.
Использование YOLO26 для сегментации даёт несколько преимуществ:
- Высокая точность: Задача сегментации позволяет создавать точные маски на уровне пикселей.
- Скорость: YOLO26 оптимизирована для приложений реального времени и быстро обрабатывает даже изображения высокого разрешения.
- Широкий спектр применения: Модель подходит для медицинской визуализации, автономного вождения и других задач, требующих детальной сегментации изображений.
Узнай больше о преимуществах и вариантах использования YOLO26 для сегментации в разделе сегментации изображений.
Да. Модели YOLO26 для оценки позы обнаруживают на изображениях и видеокадрах ключевые точки, например суставы человека, и соединяют их в позы. Это полезно для отслеживания движений в спортивной аналитике, здравоохранении и приложениях для взаимодействия человека с компьютером.
Подробности и советы по реализации см. в примерах оценки позы.
Детекция ориентированных объектов (OBB) с YOLO26 предсказывает дополнительный параметр угла для каждой рамки, поэтому повернутые объекты локализуются точнее, чем с помощью выровненных по осям рамок. Это полезно в приложениях, где нужна точная локализация повернутых объектов, например при анализе аэрофотоснимков и автоматизации складов.
- Более точные рамки: повернутые рамки захватывают меньше фона, что помогает отделять плотно расположенные или наклоненные объекты.
- Широкий спектр применения: Подходит для геопространственного анализа, робототехники и других задач.
Подробнее и примеры см. в разделе обнаружения ориентированных объектов.


Комментарии15
Задай вопрос, поделись результатами или помоги кому-нибудь.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(изменено)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(изменено)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(изменено)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1