Как тестировать модели компьютерного зрения#
Введение#
Тестирование модели проверяет, как обученная модель работает на ранее не встречавшихся реальных данных — с движущимися объектами, плохим освещением или частично скрытыми объектами, а не на подготовленном эталонном наборе. Если оценка модели измеряет метрики на размеченном наборе данных, то тестирование проверяет, соответствует ли выученное моделью поведение целям твоего приложения перед развертыванием. В этом руководстве рассматриваются подготовка тестовых данных, тестирование моделей Ultralytics YOLO26, а также выявление переобучения, недообучения и утечки данных.
Watch: How to Test Machine Learning Models | Avoid Data Leakage in Computer Vision 🚀
Тестирование модели и оценка модели#
Тестирование модели и оценка модели — это два разных этапа проекта по компьютерному зрению. Оценка измеряет производительность с помощью метрик на размеченном наборе данных, а тестирование проверяет, сохраняется ли выученное моделью поведение в условиях, похожих на условия развертывания.
Представь, что ты обучил модель компьютерного зрения для распознавания кошек и собак и хочешь развернуть ее в зоомагазине для наблюдения за животными. На этапе оценки модели ты используешь размеченный набор данных, чтобы вычислить такие метрики, как точность, precision и полнота. Например, точность модели при различении кошек и собак в определенном наборе данных может составлять 98%.
После оценки протестируй модель на изображениях из зоомагазина, чтобы проверить, насколько хорошо она распознает кошек и собак в более разнообразных и реалистичных условиях. Проверь, может ли она правильно размечать кошек и собак, когда они движутся, находятся при разном освещении или частично закрыты такими объектами, как игрушки или мебель. Тестирование модели проверяет, ведет ли она себя ожидаемым образом за пределами контролируемой среды оценки.
Подготовка к тестированию модели#
Наборы данных для компьютерного зрения обычно разделяют на обучающую и тестовую выборки, чтобы имитировать реальные условия: обучающие данные обучают модель, а тестовые данные проверяют ее поведение на ранее не встречавшихся примерах. Ultralytics Platform хранит организацию набора данных и аннотации в одном месте, что помогает при создании размеченной тестовой выборки.
- Реалистичное представление: Ранее не встречавшиеся тестовые данные должны быть похожи на данные, с которыми модель будет работать после развертывания. Это дает реалистичное представление о возможностях модели.
- Достаточный размер: Тестовый набор данных должен быть достаточно большим, чтобы надежно оценить качество работы модели.
Как тестировать модель YOLO26#
Тестирование обученной модели YOLO26 включает два взаимодополняющих процесса: валидацию на размеченной тестовой выборке для получения количественных метрик и выполнение предсказаний на новых изображениях для качественной проверки поведения модели.
Валидация на размеченной тестовой выборке#
Режим валидации сравнивает предсказания модели с эталонными разметками и сообщает precision, recall, mAP50 и mAP50-95 для моделей детекции. Он также сохраняет визуальные материалы, например матрицу ошибок и кривую precision-recall, которые помогают находить конкретные области, где модель может работать недостаточно хорошо.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Validate; add split="test" if your dataset YAML defines a test split
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
По умолчанию валидация выполняется на выборке val набора данных. Чтобы измерить производительность на отложенной тестовой выборке, определи выборку test: в YAML-файле набора данных и передай split="test".
Предсказания на новых изображениях#
Режим предсказаний запускает модель на новых, ранее не встречавшихся данных без необходимости в разметке. Он не вычисляет метрики производительности, но сохранение аннотированных результатов позволяет проверить, как модель ведет себя на реальных изображениях — например, обработать целую папку тестовых изображений за один запуск.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Run predictions on a folder of test images and save annotated results
results = model.predict(source="path/to/test_images", save=True)Чтобы проверить, подходит ли YOLO26 для твоего приложения до вложений в дообучение на собственных данных, запусти режим предсказаний с предобученным чекпоинтом на своих изображениях. Модели предварительно обучены на таких наборах данных, как COCO, поэтому результаты дают быстрое представление о том, насколько хорошо модель может работать в твоем конкретном контексте.
Режим валидации и режим предсказаний#
| Режим | Назначение | Требуются разметки | Результат |
|---|---|---|---|
| Валидация | Количественная оценка производительности относительно эталонных данных | Да | Precision, recall, mAP50, mAP50-95, матрица ошибок, PR-кривые |
| Предсказание | Проверка поведения модели на новых неразмеченных данных | Нет | Аннотированные изображения и результаты предсказаний, без метрик |
Как анализировать результаты тестирования#
Получив предсказания и метрики, разберись, где и почему модель ошибается:
- Ошибочно классифицированные изображения: Найди и просмотри изображения, которые модель классифицировала неправильно, чтобы понять, где именно она ошибается.
- Анализ ошибок: Проведи тщательный анализ ошибок, чтобы понять их типы (например, ложноположительные и ложноотрицательные результаты) и возможные причины.
- Смещение и справедливость: Проверь, нет ли смещений в предсказаниях модели. Убедись, что модель одинаково хорошо работает на разных подмножествах данных, особенно если данные содержат такие чувствительные атрибуты, как раса, пол или возраст.
Переобучение и недообучение в машинном обучении#
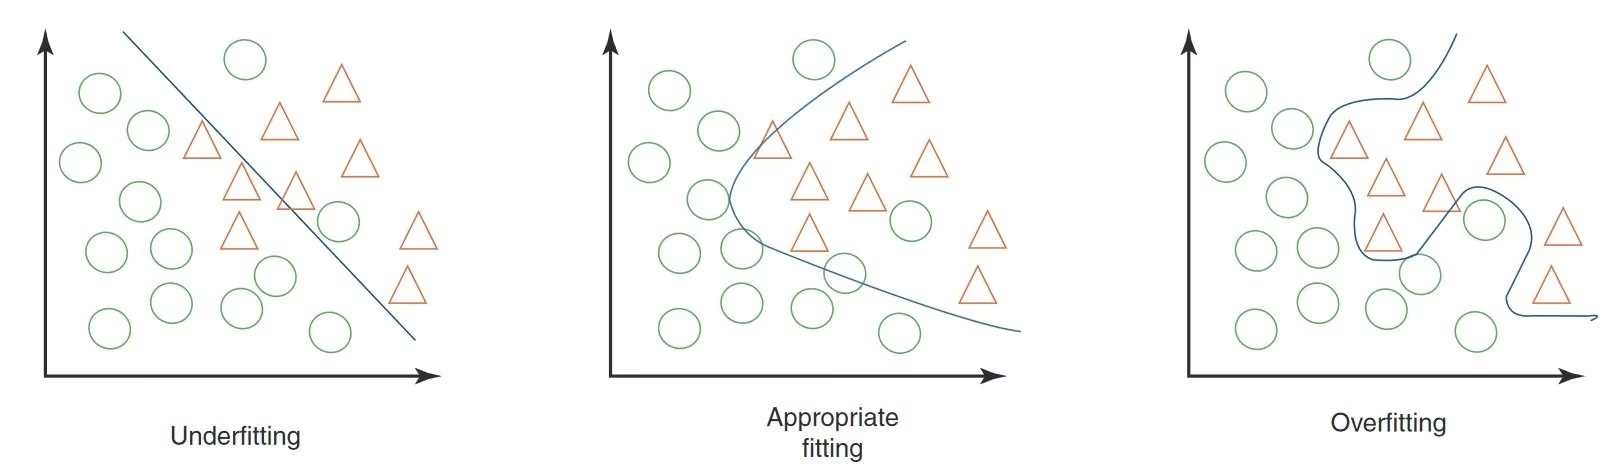
При тестировании модели машинного обучения, особенно в задачах компьютерного зрения, важно следить за переобучением и недообучением. Эти проблемы могут существенно повлиять на то, насколько хорошо твоя модель работает с новыми данными.
| Проблема | Распространенные признаки | Как устранить |
|---|---|---|
| Переобучение | Высокая точность на обучении, но низкая точность на валидации; чрезмерная чувствительность к небольшим изменениям или несущественным деталям на изображениях | Примени регуляризацию, например dropout, увеличь размер обучающего набора данных, упрости архитектуру модели |
| Недообучение | Низкая точность даже на обучающей выборке; постоянная неспособность распознавать очевидные признаки или объекты | Используй более сложную модель, добавь более релевантные признаки, увеличь число обучающих эпох |
Важно найти баланс, чтобы модель хорошо работала и на обучающем, и на валидационном наборах данных. Регулярный мониторинг метрик и визуальная проверка предсказаний во время тестирования помогают вовремя заметить смещение к любой из крайностей.
Утечка данных в компьютерном зрении и способы ее предотвращения#
Утечка данных происходит, когда информация извне обучающего набора данных случайно используется для обучения модели. Во время обучения модель может казаться очень точной, но при утечке данных она плохо работает на новых, ранее не встречавшихся данных.
Утечку бывает трудно заметить; часто она возникает из-за скрытых смещений в обучающих данных:
| Тип смещения | Как проявляется |
|---|---|
| Смещение камеры | Разные ракурсы, освещение, тени и движения камеры создают нежелательные закономерности |
| Смещение из-за наложений | Логотипы, временные метки и другие наложения на изображениях вводят модель в заблуждение |
| Смещение шрифта и объектов | Определенные шрифты или объекты, часто встречающиеся в конкретных классах, искажают процесс обучения модели |
| Пространственное смещение | Дисбаланс между передним и задним планом, распределением ограничивающих рамок и расположением объектов влияет на обучение |
| Смещение разметки и предметной области | Некорректные разметки или изменения типов данных приводят к утечке |
Как обнаружить утечку данных и предотвратить ее#
Чтобы обнаружить утечку данных, проверь, не являются ли результаты модели неожиданно хорошими, не важнее ли один признак остальных, имеют ли решения модели интуитивный смысл, а также правильно ли были разделены данные до начала любой обработки.
Чтобы предотвратить утечку, используй разнообразный набор данных с изображениями или видео с разных камер и из разных сред и внимательно проверь данные на скрытые смещения — например, на случай, когда все положительные образцы были сняты в определенное время суток. Предотвращение утечки данных делает модели компьютерного зрения надежнее в реальных условиях.
Что делать после тестирования модели#
После тестирования модели дальнейшие шаги зависят от результатов. Если модель работает хорошо, ты можешь развернуть ее в реальной среде. Если результаты неудовлетворительны, модель нужно улучшить. Это может включать анализ ошибок, сбор дополнительных данных, повышение качества данных, настройку гиперпараметров и повторное обучение модели.
Заключение#
Тщательное тестирование модели — валидация на отложенной тестовой выборке, выполнение предсказаний на реальных изображениях, а также проверка на переобучение и утечку данных — превращает хорошо оцененную модель в надежную. Устрани проблемы, выявленные при тестировании, до развертывания, и тогда модель с гораздо большей вероятностью будет работать в соответствии с замыслом в рабочей среде. Если по ходу работы возникнут вопросы, обратись к сообществу в репозитории Ultralytics на GitHub или на сервере Ultralytics в Discord.
Часто задаваемые вопросы#
Оценка модели измеряет производительность с помощью метрик на размеченном наборе данных, а тестирование модели проверяет ее поведение на новых, ранее не встречавшихся данных, похожих на условия развертывания. Оценка выдает такие значения, как precision и mAP, на основе контролируемого набора данных; тестирование показывает, сохраняется ли выученное поведение при разном освещении, движении или перекрытии объектов. Практический пример см. в разделе Тестирование модели и оценка модели.
Используй режим предсказаний и передай путь к папке в качестве
source— YOLO26 запустится на каждом изображении в папке и сможет сохранить аннотированные результаты для проверки. Режим предсказаний не вычисляет метрики; чтобы количественно оценить производительность на размеченном наборе, используй вместо него режим валидации. Оба процесса показаны в разделе Как тестировать модель YOLO26.Для моделей детекции валидация сообщает precision, recall, mAP50 и mAP50-95, а также сохраняет графики, включая матрицу ошибок и кривую precision-recall. Чтобы выполнить валидацию на отдельной тестовой выборке, а не на выборке
valпо умолчанию, определиtest:в YAML-файле набора данных и передайsplit="test". О том, как интерпретировать каждую метрику, см. в руководстве по метрикам производительности.При переобучении примени методы регуляризации, например dropout, увеличь размер обучающего набора данных или упрости архитектуру модели. При недообучении используй более сложную модель, добавь более релевантные признаки или обучай модель большее число эпох. Признаки каждой проблемы и соответствующие способы исправления приведены в разделе Переобучение и недообучение в машинном обучении.
Заподозри утечку данных, если результаты на тесте неожиданно хороши, один признак доминирует в предсказаниях или решения модели не имеют интуитивного смысла. Предотврати ее, используя разнообразные наборы данных с разных камер и из разных сред, проверяя данные на скрытые смещения и убеждаясь, что разделение на обучающую и тестовую выборки выполнено до любой обработки. Подробнее о распространенных типах смещений см. в разделе Утечка данных в компьютерном зрении.
Если результаты соответствуют целям проекта, разверни модель; если нет, улучши ее до развертывания. Это может означать анализ ошибок, сбор более разнообразных данных, повышение качества данных, настройку гиперпараметров и повторное обучение. Повторяй тестирование после каждого цикла изменений, чтобы убедиться, что исправления сработали.