Основные этапы проекта компьютерного зрения
Работа над проектом компьютерного зрения включает последовательность этапов: постановку целей, сбор и аннотирование данных, обучение и оценку модели, а также её развёртывание и поддержку в рабочей среде. В этом руководстве каждый этап рассматривается по порядку и объясняется его важность, чтобы ты мог уверенно планировать и вести собственный проект.
Компьютерное зрение — это область искусственного интеллекта (AI), которая помогает компьютерам видеть и понимать мир подобно человеку. Оно обрабатывает и анализирует изображения или видео, чтобы извлекать информацию, распознавать закономерности и принимать решения на основе этих данных.
Смотри: Как реализовать проекты компьютерного зрения | Пошаговое руководство
Методы компьютерного зрения, такие как обнаружение объектов, классификация изображений и сегментация экземпляров, применяются в разных отраслях — от автономного вождения до медицинской визуализации — и помогают получать ценную информацию.
Обзор проекта компьютерного зрения#
Прежде чем подробно разбирать каждый этап проекта компьютерного зрения, рассмотрим общий процесс. Если бы ты начал такой проект сегодня, то выполнил бы следующие шаги:
- В первую очередь нужно понять требования проекта.
- Затем собрать изображения и точно разметить их, чтобы использовать для обучения модели.
- Далее нужно очистить и расширить данные, чтобы подготовить их к обучению модели.
- После обучения тщательно оцени и протестируй модель, чтобы убедиться, что она стабильно работает в разных условиях.
- Наконец, разверни модель в реальных условиях и отслеживай её работу и поддерживай её с учётом новых данных и отзывов.
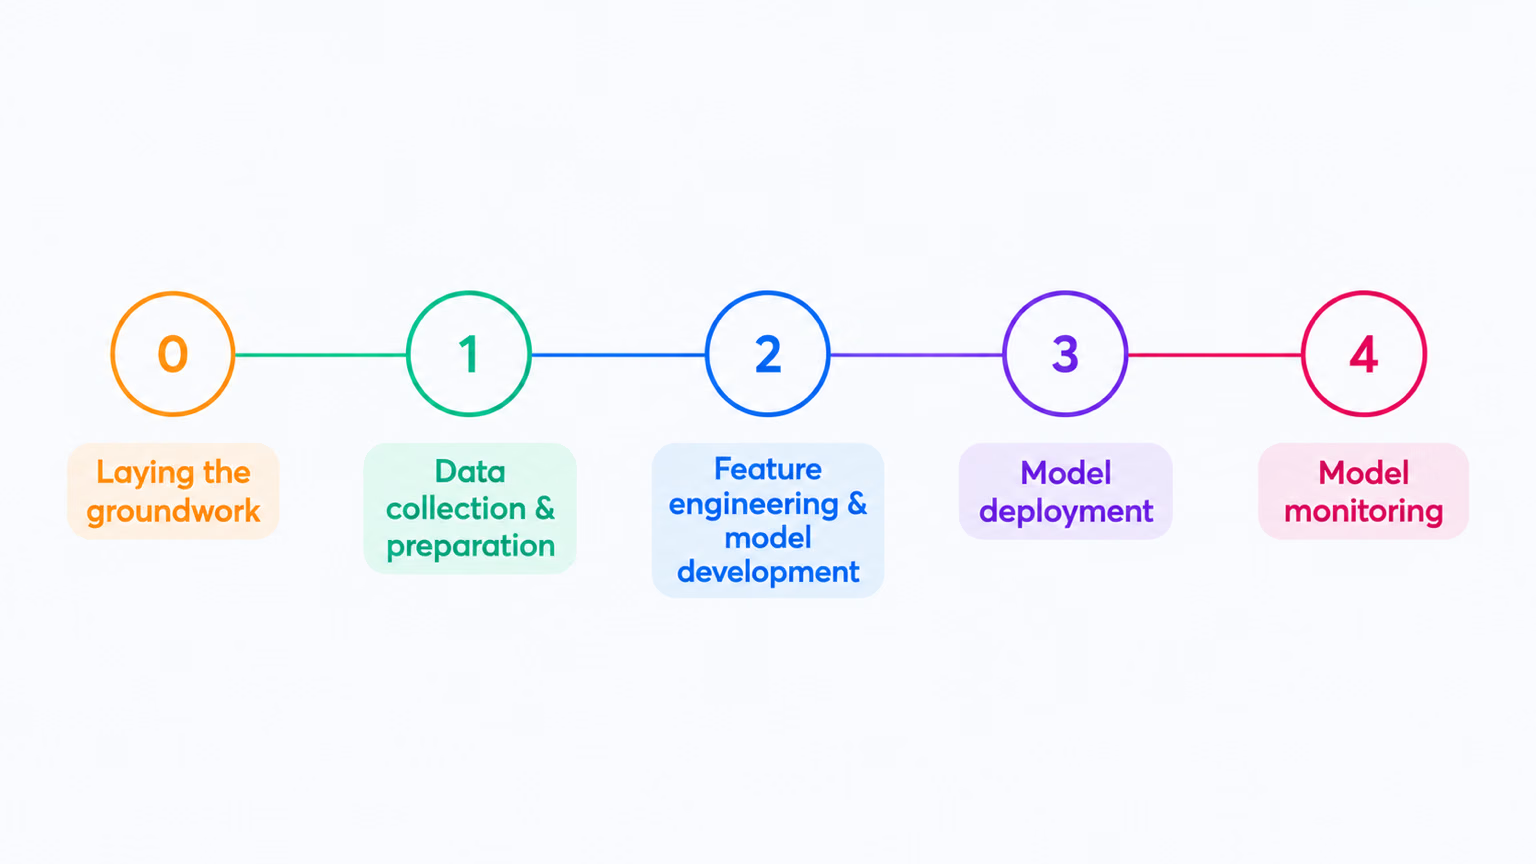
Теперь, когда ты знаешь, чего ожидать, в разделах ниже подробно описан каждый этап.
Шаг 1: Определение целей проекта#
Первый этап любого проекта компьютерного зрения — четко определить задачу, которую нужно решить. Понимание конечной цели поможет приступить к созданию решения. Это особенно важно для компьютерного зрения, поскольку цель проекта напрямую определяет, на какой задаче компьютерного зрения нужно сосредоточиться.
Вот примеры целей проекта и задач компьютерного зрения, которые помогут их достичь:
-
Цель: разработать систему для мониторинга и управления потоком автомобилей разных типов на шоссе, чтобы улучшить организацию дорожного движения и повысить безопасность.
- Задача компьютерного зрения: обнаружение объектов идеально подходит для мониторинга дорожного движения, поскольку позволяет быстро находить и распознавать несколько автомобилей. Оно требует меньше вычислительных ресурсов, чем сегментация изображений, которая для этой задачи даёт избыточные детали, и обеспечивает более быстрый анализ в реальном времени.
-
Цель: разработать инструмент, который помогает рентгенологам точно очерчивать опухоли на уровне пикселей на медицинских снимках.
- Задача компьютерного зрения: сегментация изображений подходит для медицинской визуализации, поскольку позволяет точно и подробно определить границы опухолей, что крайне важно для оценки их размера и формы, а также планирования лечения.
-
Цель: создать цифровую систему для классификации различных документов (например, счетов, чеков и юридических документов), чтобы повысить эффективность организации и упростить поиск документов.
- Задача компьютерного зрения: классификация изображений идеально подходит для этого случая, поскольку обрабатывает по одному документу за раз и не учитывает положение документа на изображении. Такой подход упрощает и ускоряет сортировку.
Выбор подходящей модели и стратегии обучения#
После того как ты определил цель проекта и подходящие задачи компьютерного зрения, важной частью постановки цели становится выбор подходящей модели и стратегии обучения.
В зависимости от цели ты можешь выбрать модель до или после того, как на шаге 2 выяснишь, какие данные удастся собрать. Например, предположим, что твой проект сильно зависит от доступности определенных типов данных. В таком случае может быть практичнее сначала собрать и проанализировать данные, а уже потом выбирать модель. С другой стороны, если требования к модели тебе уже ясны, ты можешь сначала выбрать модель, а затем собрать данные, соответствующие этим требованиям.
Выбор между обучением с нуля и использованием переноса обучения влияет на подготовку данных. Для обучения с нуля нужен разнообразный набор данных, чтобы модель формировала представления с самого начала. Перенос обучения, в свою очередь, позволяет взять предварительно обученную модель и адаптировать ее с помощью более компактного и специализированного набора данных. Кроме того, выбор конкретной модели для обучения определяет, как нужно подготовить данные с учетом ее требований, например изменить размер изображений или добавить аннотации.
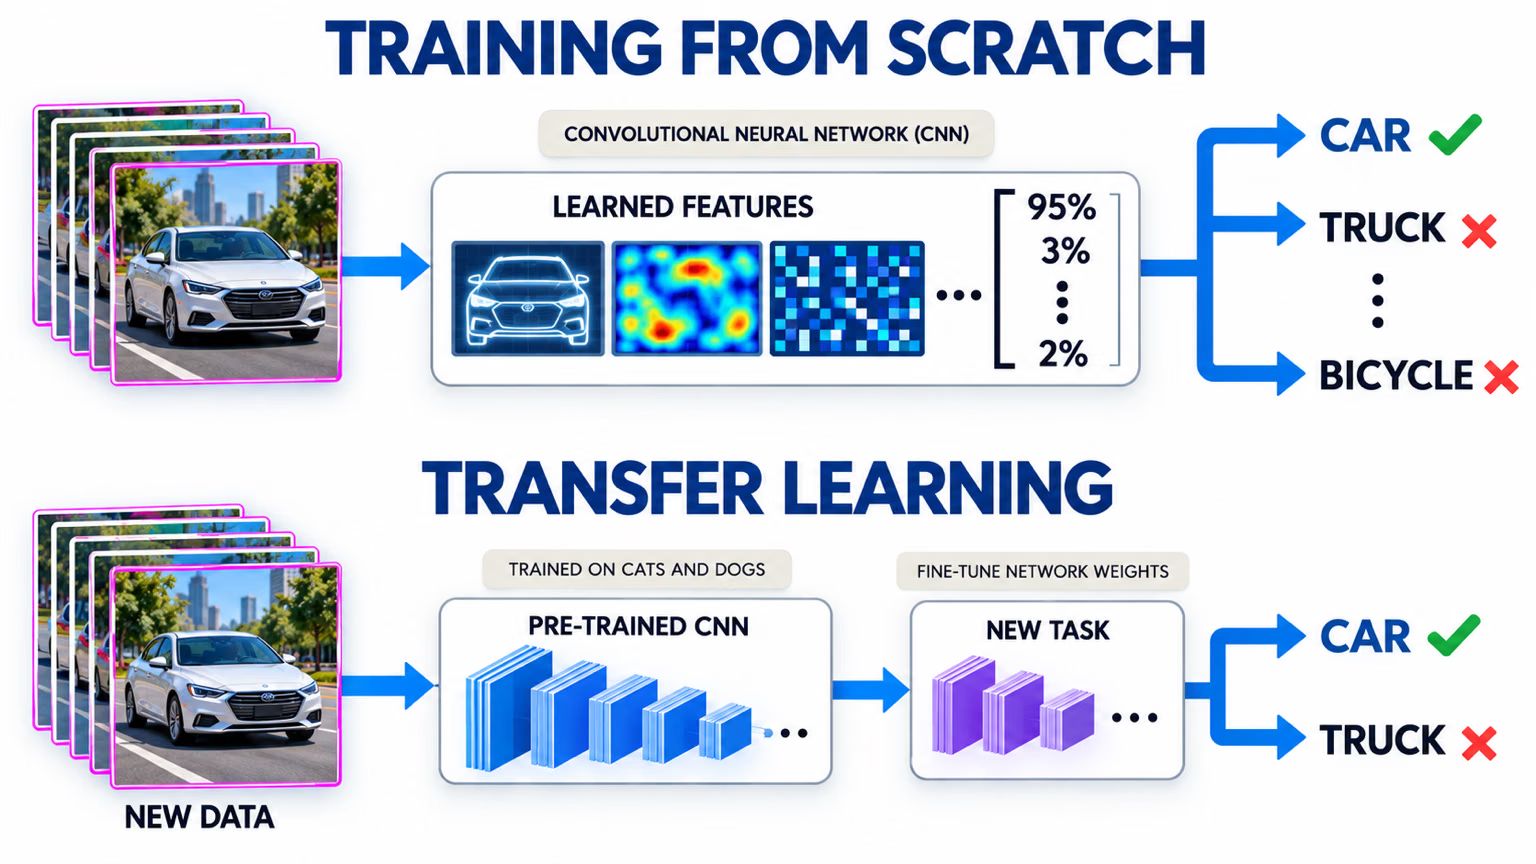
Учитывай целевую платформу развертывания, чтобы обеспечить совместимость и производительность модели. Например, легковесные модели идеально подходят для периферийных вычислений, поскольку эффективно работают на устройствах с ограниченными ресурсами.
Подробнее читай в нашем руководстве о том, как определить цели проекта и выбрать подходящую модель.
Прежде чем перейти к практической работе над проектом компьютерного зрения, важно разобраться во всех этих деталях. Перед переходом к шагу 2 проверь, что учел следующее:
- Четко определи задачу, которую нужно решить.
- Определи конечную цель проекта.
- Определи, какая именно задача компьютерного зрения нужна (например, обнаружение объектов, классификация изображений или сегментация изображений).
- Реши, обучать модель с нуля или использовать перенос обучения.
- Выбери подходящую модель с учетом задачи и требований к развертыванию.
Шаг 2: сбор данных и аннотирование данных#
Качество моделей компьютерного зрения зависит от качества набора данных. Можно собрать изображения в интернете, сделать собственные снимки или использовать готовые наборы данных. Среди полезных источников общедоступных данных — Google Dataset Search Engine, репозиторий машинного обучения Калифорнийского университета в Ирвайне и наборы данных Kaggle.
Некоторые библиотеки, например Ultralytics, предоставляют встроенную поддержку различных наборов данных, что упрощает начало работы с качественными данными. Такие библиотеки часто содержат утилиты для загрузки популярных наборов данных, которые могут сэкономить много времени и усилий на начальных этапах проекта.
Однако если ты решишь собрать изображения или сделать фотографии самостоятельно, данные нужно будет аннотировать. Аннотирование данных — это процесс разметки данных, который помогает передать знания модели. Тип аннотирования зависит от выбранного метода компьютерного зрения. Вот несколько примеров:
- Классификация изображений: ты присваиваешь всему изображению метку одного класса.
- Обнаружение объектов: ты обводишь каждый объект на изображении ограничивающей рамкой и присваиваешь метку каждой рамке.
- Сегментация изображений: ты присваиваешь каждому пикселю изображения метку объекта, которому он принадлежит, создавая подробные границы объектов.
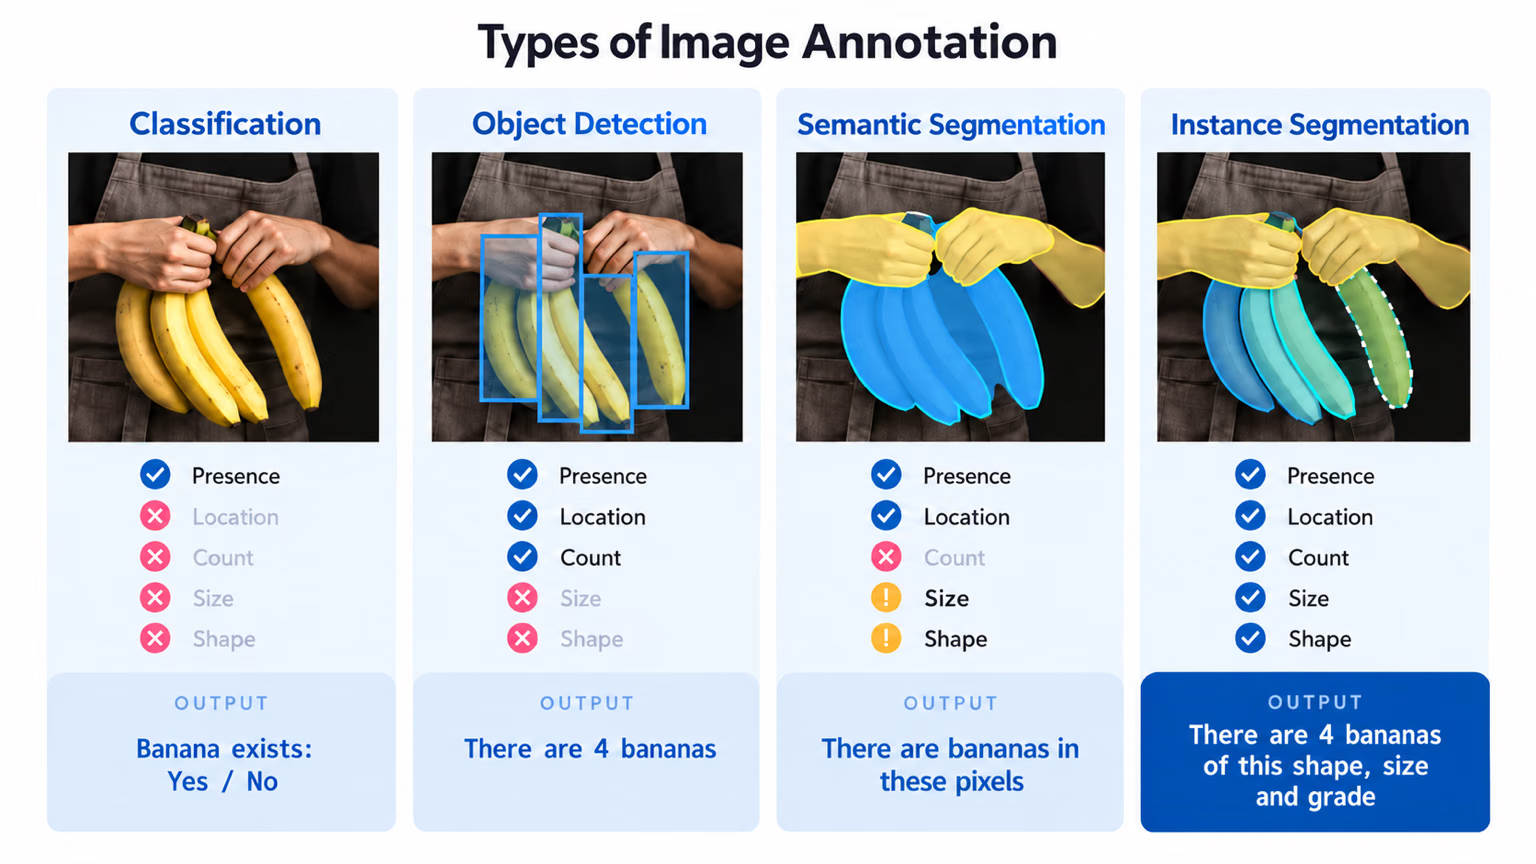
Сбор и аннотирование данных могут требовать много времени и ручной работы. Специальный инструмент для аннотирования ускоряет этот процесс: Ultralytics Platform включает встроенный редактор аннотаций с интеллектуальным аннотированием на базе SAM для данных обнаружения, сегментации и OBB и сохраняет метки непосредственно в формате YOLO.
Шаг 3: аугментация данных и разделение набора данных#
После сбора и аннотирования изображений важно сначала разделить набор данных на обучающую, валидационную и тестовую выборки, а затем выполнять аугментацию данных. Разделение до аугментации необходимо, чтобы тестировать и проверять модель на исходных, неизмененных данных. Это помогает точно оценить, насколько хорошо модель обобщает знания на новые, ранее не встречавшиеся данные.
Вот как разделить данные:
- Обучающая выборка: самая большая часть данных, обычно 70–80% от общего объема, используется для обучения модели.
- Валидационная выборка: обычно составляет около 10–15% данных; она используется для настройки гиперпараметров и проверки модели во время обучения, помогая предотвратить переобучение.
- Тестовая выборка: оставшиеся 10–15% данных откладываются для тестирования. Она используется для оценки производительности модели на незнакомых данных после завершения обучения.
После разделения данных можно выполнить аугментацию, применяя такие преобразования, как поворот, масштабирование и отражение изображений, чтобы искусственно увеличить размер набора данных. Аугментация делает модель устойчивее к различным вариациям и улучшает ее работу на незнакомых изображениях.
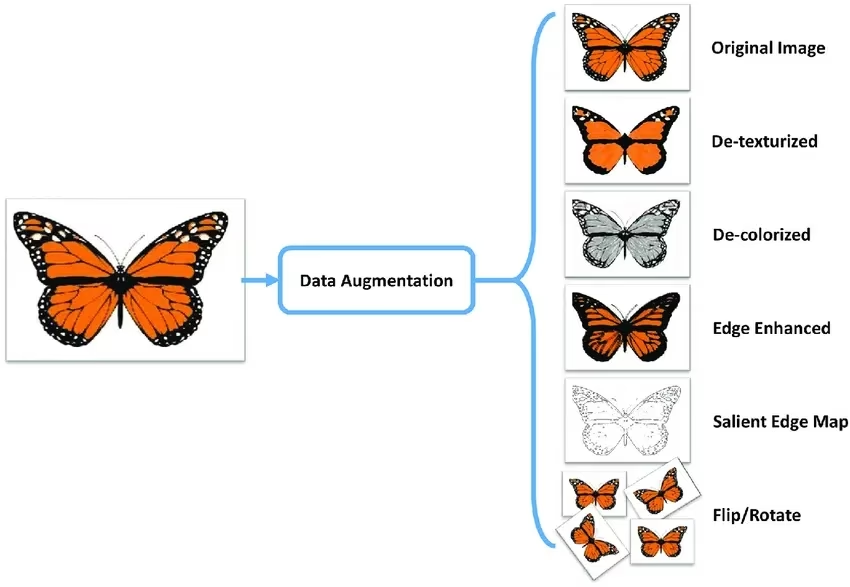
В таких библиотеках, как OpenCV, Albumentations и TensorFlow, есть гибкие функции аугментации. Кроме того, некоторые библиотеки, например Ultralytics, имеют встроенные настройки аугментации непосредственно в функции обучения модели, что упрощает процесс.
Чтобы лучше разобраться в данных, используй такие инструменты, как Matplotlib или Seaborn, для визуализации изображений и анализа их распределения и характеристик. Визуализация помогает выявлять закономерности и аномалии, а также оценивать эффективность методов аугментации. Вкладка Charts платформы Ultralytics позволяет без кода получать множество таких сведений: для каждого загруженного набора данных автоматически строятся графики распределения по разбиениям, количества классов, гистограммы размеров изображений и тепловые карты расположения аннотаций.
Правильно изучив, разделив и дополнив данные, ты сможешь создать хорошо обученную, проверенную и протестированную модель, которая будет эффективно работать в реальных условиях.
Шаг 4: обучение модели#
Когда набор данных будет готов к обучению, можно заняться настройкой необходимой среды, управлением наборами данных и обучением модели.
Сначала убедись, что среда правильно настроена. Обычно для этого нужно:
- Установить необходимые библиотеки и фреймворки, например TensorFlow, PyTorch или Ultralytics.
- Если ты используешь GPU, установи такие библиотеки, как CUDA и cuDNN, чтобы включить ускорение на GPU и ускорить обучение.
Затем загрузи обучающий и валидационный наборы данных в среду. Нормализуй и предварительно обработай данные, изменив размер изображений, преобразовав формат или выполнив аугментацию. Выбрав модель, настрой ее слои и укажи гиперпараметры. Скомпилируй модель, задав функцию потерь, оптимизатор и метрики производительности.
Библиотеки, такие как Ultralytics, упрощают обучение. Ты можешь начать обучение, передав данные модели с помощью минимального количества кода. Эти библиотеки автоматически выполняют настройку весов, обратное распространение ошибки и валидацию. В них также есть инструменты для отслеживания прогресса и простой настройки гиперпараметров. После обучения сохрани модель и ее веса с помощью нескольких команд.
Важно помнить, что для эффективного обучения необходимо правильно управлять наборами данных. Используй контроль версий данных, чтобы отслеживать изменения и обеспечивать воспроизводимость. Такие инструменты, как DVC (контроль версий данных), помогают управлять большими наборами данных.
Шаг 5: оценка и тонкая настройка модели#
Важно оценить производительность модели с помощью различных метрик и доработать ее, чтобы повысить точность. Оценка помогает определить, в чем модель хорошо справляется, а что нужно улучшить. Тонкая настройка помогает добиться максимально возможной производительности модели.
- Метрики производительности: используй такие метрики, как точность, прецизионность, полнота и F1-мера, чтобы оценить производительность модели. Эти метрики показывают, насколько хорошо модель выполняет предсказания.
- Настройка гиперпараметров: настраивай гиперпараметры, чтобы оптимизировать производительность модели. Найти оптимальные значения помогут такие методы, как поиск по сетке или случайный поиск.
- Тонкая настройка: внеси небольшие изменения в архитектуру модели или процесс обучения, чтобы улучшить производительность. Например, можно настроить скорость обучения, размер пакета или другие параметры модели.
Чтобы глубже разобраться в методах оценки и тонкой настройки моделей, ознакомься с нашим руководством по оценке моделей.
Шаг 6: тестирование модели#
Тестирование модели подтверждает, что она хорошо работает на совершенно незнакомых данных, и позволяет убедиться в ее готовности к развертыванию. Тестирование модели отличается от ее оценки тем, что проверяет производительность готовой модели, а не используется для ее итеративного улучшения.
Важно тщательно протестировать модель и устранить типичные проблемы, которые могут возникнуть. Проверь ее на отдельном тестовом наборе данных, который не использовался при обучении или валидации. Этот набор должен отражать реальные сценарии, чтобы убедиться в стабильности и надежности модели.
Также устраняй распространённые проблемы, такие как переобучение, недообучение и утечка данных. Используй такие методы, как перекрёстная проверка, чтобы выявлять эти проблемы. Подробные стратегии тестирования смотри в нашем руководстве по тестированию моделей.
Шаг 7: развертывание модели#
После тщательного тестирования модели наступает время её развёртывания. Развёртывание модели — это предоставление модели для использования в производственной среде. Вот этапы развёртывания модели компьютерного зрения:
- Настройка среды: настрой необходимую инфраструктуру для выбранного варианта развертывания — в облаке (AWS, Google Cloud, Azure) или на периферийных устройствах (локальные устройства, IoT).
- Экспорт модели: экспортируй модель в подходящий формат (например, ONNX, TensorRT или CoreML для YOLO26), чтобы обеспечить совместимость с платформой развертывания.
- Развертывание модели: разверни модель, настроив API или конечные точки и интегрировав ее в приложение.
- Обеспечение масштабируемости: внедри балансировщики нагрузки, группы автоматического масштабирования и инструменты мониторинга, чтобы управлять ресурсами и обрабатывать растущий объем данных и запросов пользователей.
Ultralytics Platform также предоставляет управляемые эндпоинты развёртывания в 42 регионах мира с масштабированием до нуля по умолчанию и автоматически настраивает инфраструктуру.
Шаг 8: мониторинг, обслуживание и документация#
После развертывания модели важно постоянно отслеживать ее производительность, обслуживать ее для устранения возможных проблем и документировать весь процесс, чтобы использовать эти сведения в будущем и вносить улучшения.
Инструменты мониторинга помогают отслеживать ключевые показатели эффективности (KPI) и обнаруживать аномалии или снижение точности. Мониторинг модели позволяет заметить ее дрейф — снижение производительности со временем из-за изменений входных данных. Периодически переобучай модель на обновленных данных, чтобы сохранять ее точность и актуальность.
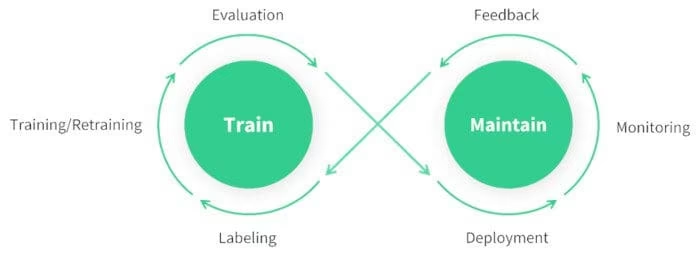
Помимо мониторинга и обслуживания, важную роль играет документация. Подробно документируй весь процесс, включая архитектуру модели, процедуры обучения, гиперпараметры, этапы предварительной обработки данных, а также любые изменения, внесенные при развертывании и обслуживании. Качественная документация обеспечивает воспроизводимость и упрощает дальнейшие обновления и устранение неполадок. Эффективно отслеживая состояние модели, обслуживая и документируя ее, ты сможешь поддерживать ее точность, надежность и простоту управления на протяжении всего жизненного цикла.
Участие в сообществе#
Общение с сообществом энтузиастов компьютерного зрения поможет тебе уверенно решать любые проблемы, возникающие при работе над проектом. Вот несколько способов учиться, устранять неполадки и налаживать полезные контакты.
Ресурсы сообщества#
- Проблемы на GitHub: загляни в репозиторий YOLO26 на GitHub и используй вкладку Issues, чтобы задавать вопросы, сообщать об ошибках и предлагать новые функции. Активное сообщество и сопровождающие репозитория помогут разобраться с конкретными проблемами.
- Сервер Ultralytics в Discord: присоединяйся к серверу Ultralytics в Discord, чтобы общаться с другими пользователями и разработчиками, получать поддержку и делиться знаниями.
Эти ресурсы помогут тебе преодолеть трудности и быть в курсе последних тенденций и передовых практик в сообществе компьютерного зрения.
Следующие шаги#
Теперь у тебя есть план действий для каждого этапа проекта компьютерного зрения — от постановки целей до мониторинга развернутой модели. Примени его на практике, обучив свою первую модель YOLO, или подробнее изучи любой отдельный этап в руководствах выше. Чтобы запустить весь процесс без написания кода, попробуй Ultralytics Platform.
Часто задаваемые вопросы#
Выбор подходящей задачи компьютерного зрения зависит от цели проекта. Например, для мониторинга дорожного движения подойдёт обнаружение объектов, позволяющее находить и распознавать разные типы транспортных средств в реальном времени. Для анализа медицинских изображений идеально подходит сегментация изображений: она точно определяет границы опухолей и помогает в диагностике и планировании лечения.
Аннотирование данных необходимо, чтобы научить модель распознавать закономерности. Тип аннотации зависит от задачи:
- Классификация изображений: всему изображению присваивается метка одного класса.
- Обнаружение объектов: вокруг объектов рисуются ограничивающие рамки.
- Сегментация изображений: каждому пикселю присваивается метка объекта, которому он принадлежит.
Встроенный редактор аннотаций Ultralytics Platform поможет тебе в этом процессе.
Разделение набора данных до аугментации помогает проверить производительность модели на исходных, неизмененных данных. Выполни следующие шаги:
- Обучающая выборка: 70–80% данных.
- Валидационная выборка: 10–15% данных для настройки гиперпараметров.
- Тестовая выборка: оставшиеся 10–15% данных для итоговой оценки.
После разделения примени методы аугментации, например поворот, масштабирование и отражение, чтобы разнообразить набор данных. В этом помогут такие библиотеки, как Albumentations и OpenCV. Для удобства в Ultralytics также доступны встроенные настройки аугментации.
Экспортируй обученную модель с помощью метода
export, выбрав формат, соответствующий целевой платформе развертывания. Ultralytics поддерживает несколько форматов, включая ONNX, TensorRT и CoreML. Чтобы экспортировать модель YOLO26, выполни следующие действия:- Используй метод
export, указав нужный параметр формата. - Убедись, что экспортированная модель соответствует требованиям среды развертывания (например, периферийных устройств или облака).
Подробнее читай в нашем руководстве по экспорту моделей.
- Используй метод
Непрерывный мониторинг и обслуживание необходимы для долгосрочного успеха модели. Используй инструменты для отслеживания ключевых показателей эффективности (KPIs) и выявления аномалий. Регулярно переобучай модель на обновленных данных, чтобы противодействовать дрейфу модели. Документируй весь процесс, включая архитектуру модели, гиперпараметры и внесенные изменения, чтобы обеспечить воспроизводимость и упростить будущие обновления. Подробнее читай в нашем руководстве по мониторингу и обслуживанию.


Комментарии2
Задай вопрос, поделись результатами или помоги кому-нибудь.
VeeranjaneyuluToka
what is the best way of verifying if the chosen model is right fit for the given dataset or problem statement. Is it just based on evaluation metrics or can we use kind of approach to verify based on the feature maps or heat map visualization if the model is really learning the features that it needs to be learnt.
 Glenn JocherUltralytics
Great question! You're absolutely right that evaluation metrics alone don't tell the whole story. Here are several approaches to verify if your model is truly learning the right features:
Beyond Evaluation Metrics:
- Feature visualization and heat maps (like Grad-CAM, LIME) help you see what regions the model focuses on during predictions
- Activation maps show which features activate at different layers, revealing what the model has learned
- Confusion matrices reveal specific class prediction patterns and potential biases
Practical Verification Approaches:
- Test on edge cases and adversarial examples to understand model robustness
- Cross-validation across different data splits to ensure consistent performance
- Error analysis by examining misclassified samples to identify systematic issues
- Domain adaptation testing on slightly different datasets to check generalization
For YOLO11 specifically:
- Use validation visualizations during training to see bounding box predictions
- Monitor training curves for signs of overfitting or underfitting
- Test inference on diverse real-world scenarios beyond your test set
The key is combining quantitative metrics with qualitative analysis - if your model achieves high accuracy but the heat maps show it's focusing on irrelevant background features instead of the actual objects, that's a red flag even with good metrics.
Would you like specific guidance on implementing any of these visualization techniques with your current project?