Развертывание YOLOv5 на виртуальной машине Google Cloud Platform (GCP) Deep Learning
Google Cloud Platform (GCP) — это платформа облачных вычислений, виртуальная машина Deep Learning которой предварительно настроена для задач анализа данных и машинного обучения (ML). В этом руководстве показано, как настроить Ultralytics YOLOv5 на виртуальной машине GCP Deep Learning. Оно поможет начать обучение и запуск моделей обнаружения объектов с YOLOv5 как тем, кто только знакомится с ML, так и опытным специалистам.
Новые пользователи GCP также могут получить бесплатный кредит на $300, чтобы начать работу.
Другие варианты быстрого старта с YOLOv5: наш блокнот Google Colab  для работы в браузере или масштабируемая платформа Amazon AWS. Также можно использовать наш официальный Docker-образ на Docker Hub

Шаг 1. Создание и настройка виртуальной машины Deep Learning#
Для начала создай виртуальную машину, оптимизированную для глубокого обучения:
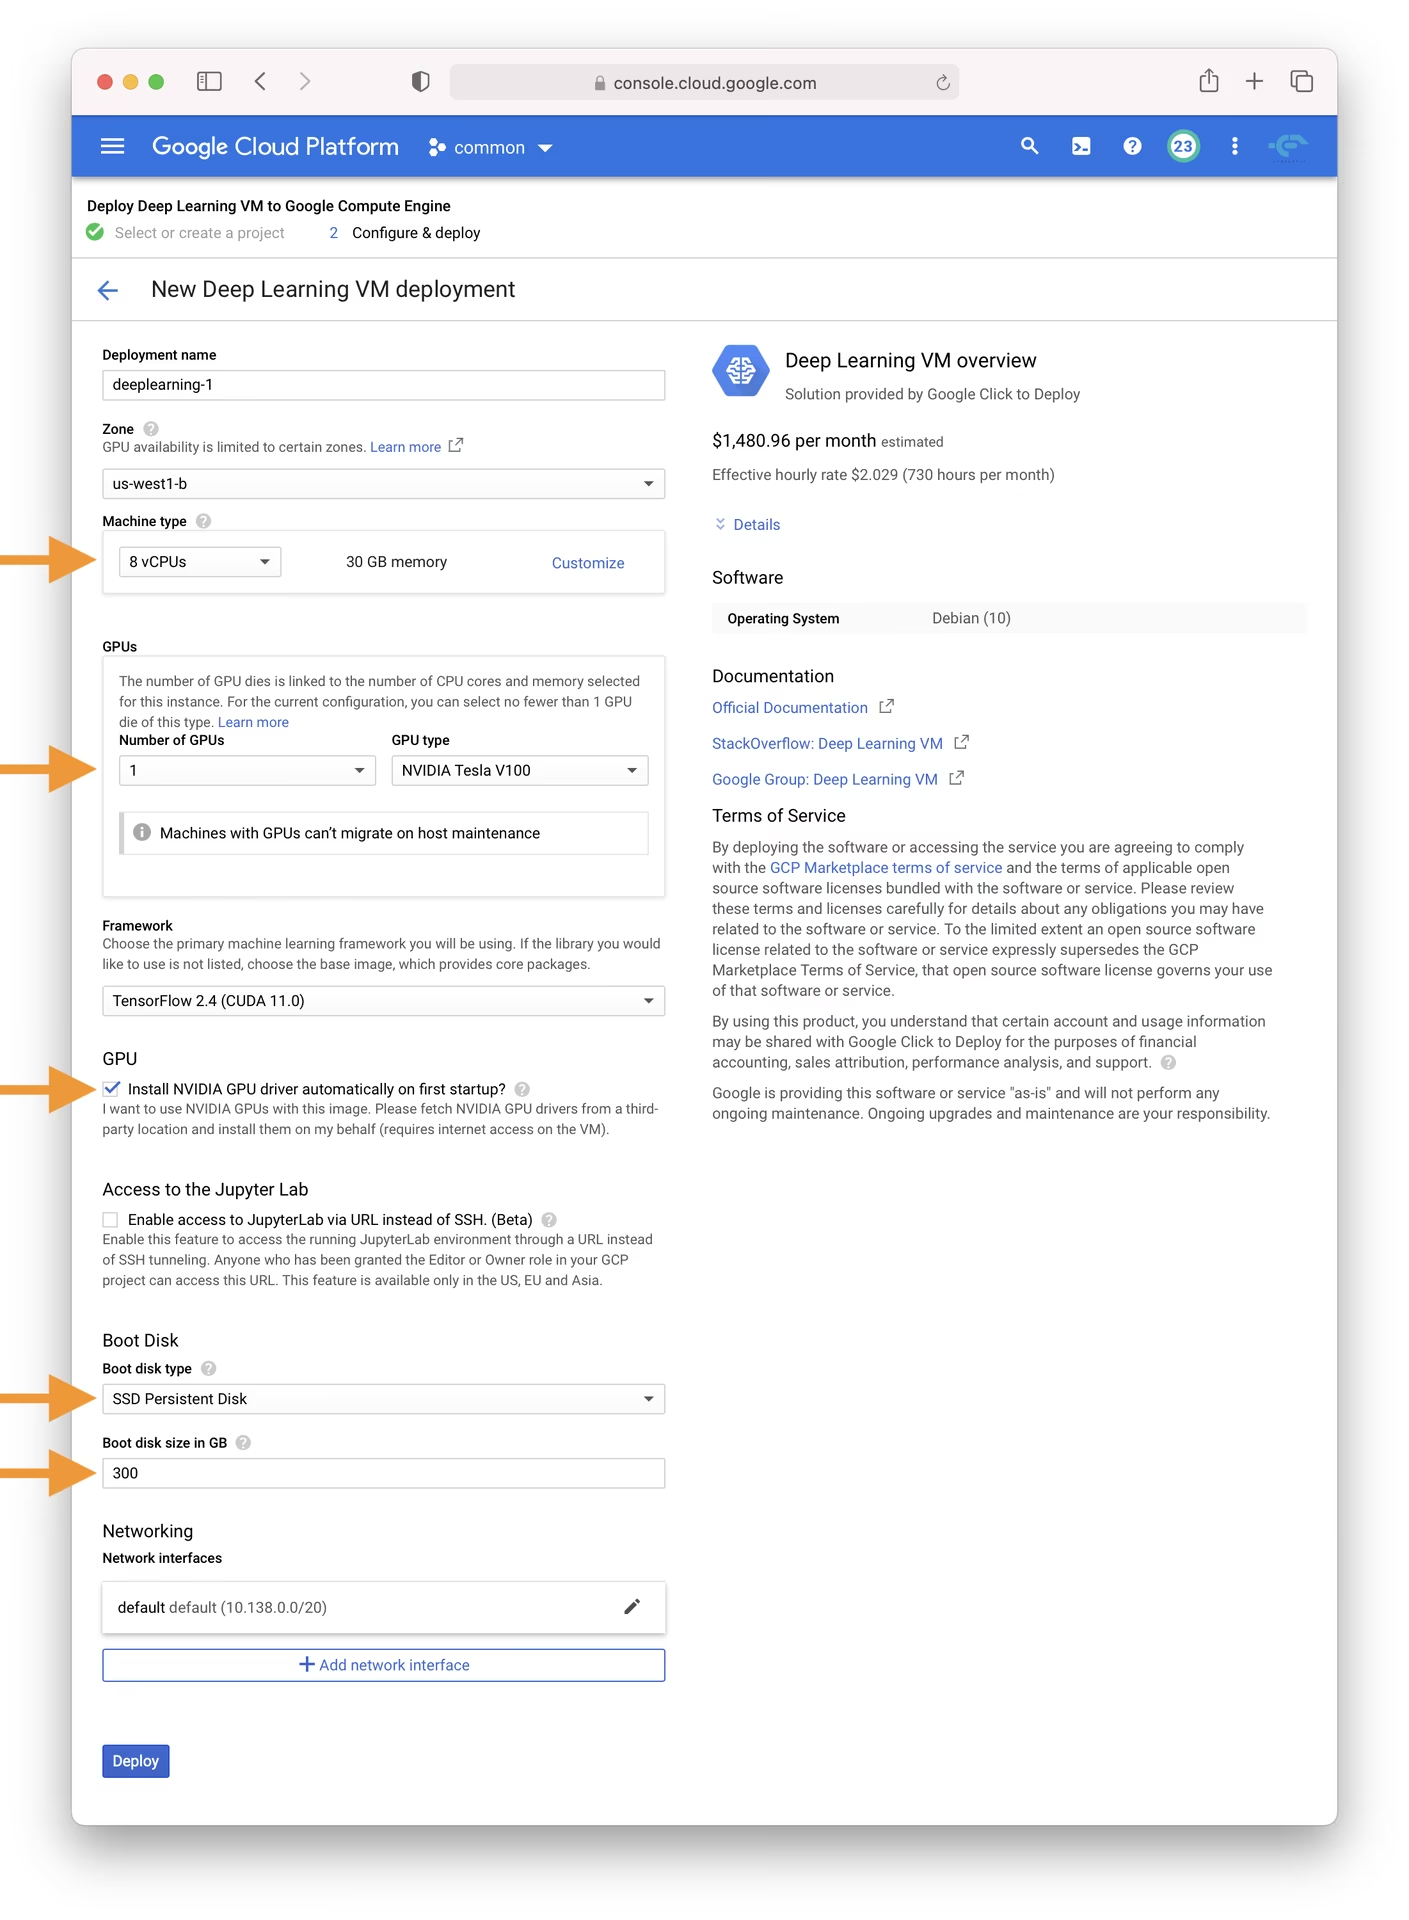
- Перейди в магазин GCP и выбери Deep Learning VM.
- Выбери инстанс n1-standard-8: он предлагает сбалансированную конфигурацию из 8 виртуальных CPU и 30 ГБ памяти, подходящую для многих задач ML.
- Выбери GPU. Выбор зависит от твоей рабочей нагрузки; даже базовый GPU T4 значительно ускорит обучение модели.
- Установи флажок «Установить драйвер NVIDIA GPU автоматически при первом запуске?».
- Выдели 300 ГБ на SSD Persistent Disk, чтобы избежать узких мест при вводе-выводе.
- Нажми «Deploy» и дождись, пока GCP подготовит виртуальную машину Deep Learning.
На этой виртуальной машине уже установлены необходимые инструменты и фреймворки, включая дистрибутив Python Anaconda, который содержит многие нужные YOLOv5 зависимости.
Шаг 2. Подготовка виртуальной машины для YOLOv5#
Затем установи YOLOv5 и его зависимости:
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install dependencies
pip install -r requirements.txt
Для YOLOv5 требуется Python 3.8.0 или новее и PyTorch 1.8 или новее. Скрипты автоматически скачивают модели и наборы данных из последнего релиза YOLOv5, упрощая начало обучения модели.
Шаг 3. Обучение и развертывание моделей YOLOv5#
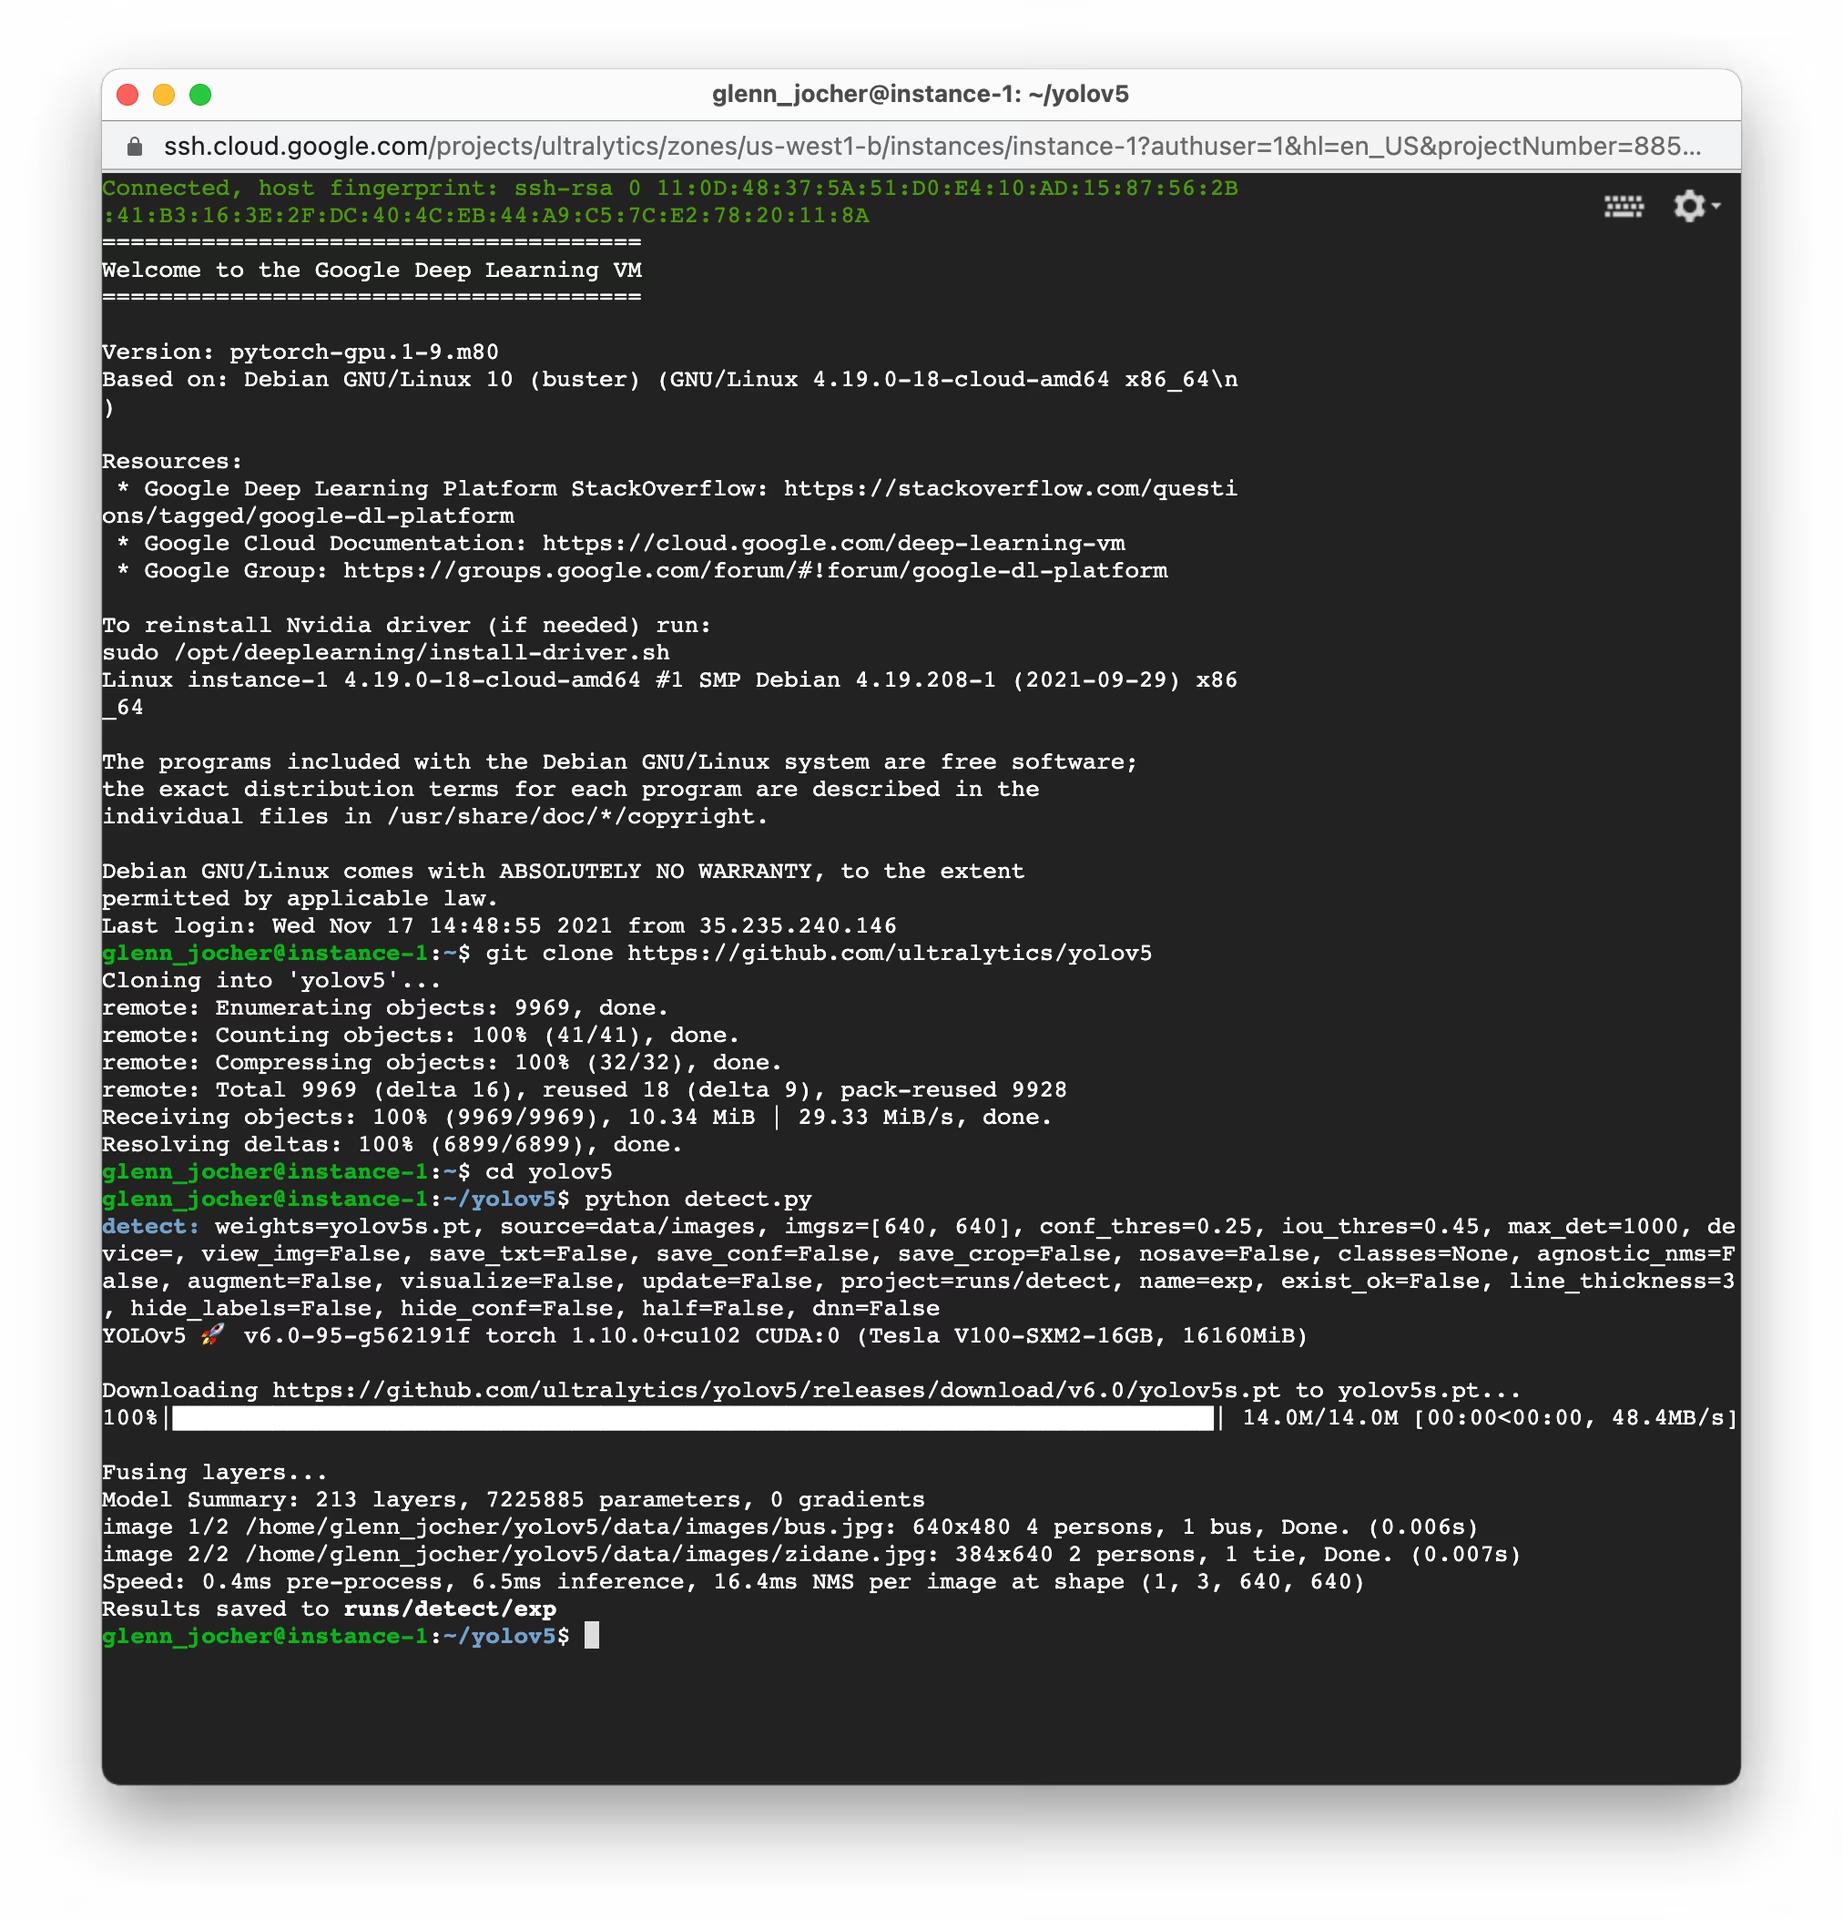
Настройка завершена — теперь можно обучать, валидировать, выполнять предсказания и экспортировать модели YOLOv5 на виртуальной машине GCP:
# Train a YOLOv5 model on your dataset (e.g., yolov5s)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the trained model to check Precision, Recall, and mAP
python val.py --weights yolov5s.pt --data coco128.yaml

# Run inference using the trained model on images or videos
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite
С помощью нескольких команд ты можешь обучить собственные модели обнаружения объектов, настроенные под твои задачи, или быстро получить результат, начав с предобученных весов.
Выделение пространства подкачки (необязательно)#
Если ты работаешь с особенно большими наборами данных, которые могут превысить объем RAM виртуальной машины, добавь пространство подкачки, чтобы избежать ошибок нехватки памяти:
# Allocate a 64GB swap file
sudo fallocate -l 64G /swapfile

# Set the correct permissions for the swap file
sudo chmod 600 /swapfile

# Set up the Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap space allocation (should show increased swap memory)
free -h
Обучение на пользовательских наборах данных#
Чтобы обучить YOLOv5 на собственном наборе данных в GCP, выполни следующие основные шаги:
-
Подготовь набор данных в формате YOLOv5 (изображения и соответствующие файлы меток). Рекомендации см. в нашем обзоре наборов данных.
-
Загрузи набор данных на виртуальную машину GCP с помощью
gcloud compute scpили SSH-функции веб-консоли. -
Создай файл конфигурации набора данных в формате YAML (
custom_dataset.yaml), указав пути к обучающим и валидационным данным, количество классов и их названия. -
Запусти процесс обучения, указав YAML-файл своего набора данных и, при необходимости, начав с предварительно обученных весов:
# Example: Train YOLOv5s on a custom dataset for 100 epochs
python train.py --img 640 --batch 16 --epochs 100 --data custom_dataset.yaml --weights yolov5s.pt
Подробные инструкции по подготовке данных и обучению на пользовательских наборах данных см. в руководстве Обучение на пользовательских данных.
Использование облачного хранилища#
Для эффективного управления данными, особенно большими наборами данных или множеством экспериментов, интегрируй рабочий процесс YOLOv5 с Google Cloud Storage:
# Ensure Google Cloud SDK is installed and initialized
# If not installed: curl https://sdk.cloud.google.com/ | bash
# Then initialize: gcloud init

# Example: Copy your dataset from a GCS bucket to your VM
gsutil cp -r gs://your-data-bucket/my_dataset ./datasets/

# Example: Copy trained model weights from your VM to a GCS bucket
gsutil cp -r ./runs/train/exp/weights gs://your-models-bucket/yolov5_custom_weights/
Так ты сможешь безопасно и экономично хранить в облаке большие наборы данных и обученные модели, сократив требования к дисковому пространству виртуальной машины.
Заключение#
Теперь Ultralytics YOLOv5 запущена на виртуальной машине Google Cloud Platform Deep Learning и готова к проектам по обнаружению объектов — от личных экспериментов и академических исследований до промышленных решений.
Для обучения и управления моделями без кода рассмотри платформу Ultralytics.
Чтобы задать вопросы и поучаствовать в совместной работе, присоединяйся к обсуждениям на GitHub.
Часто задаваемые вопросы#
Для большинства задач обучения и инференса YOLOv5 хватит машины
n1-standard-8с одним GPU T4. Для больших наборов данных или моделей перейди на L4 или A100 и обязательно отметь опцию автоматической установки драйвера NVIDIA при первом запуске.Останови виртуальную машину на странице Compute Engine, когда она простаивает. Плата за подключённый диск продолжит начисляться, поэтому после завершения проекта удали виртуальную машину и диск, предварительно надёжно скопировав веса в Cloud Storage.
Для небольших наборов данных используй
gcloud compute scp. Всё, что больше, загрузи в сегмент Cloud Storage и скачай с помощьюgsutil cp -r gs://your-bucket/dataset ./datasets/— во внутренней сети Google это гораздо быстрее.Да. На виртуальной машине Deep Learning уже установлен PyTorch, поэтому
pip install ultralyticsдобавляет обучение и экспорт моделей YOLO26 с помощью CLIyolo.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.