Архитектура Ultralytics YOLOv5#
YOLOv5 (v6.0/6.1) — алгоритм обнаружения объектов, разработанный Ultralytics. В этой статье рассматриваются архитектура YOLOv5, стратегии аугментации данных, методики обучения и способы вычисления функции потерь. Понимание этих аспектов поможет применять обнаружение объектов в таких областях, как видеонаблюдение, автономные транспортные средства и распознавание изображений.
1. Структура модели#
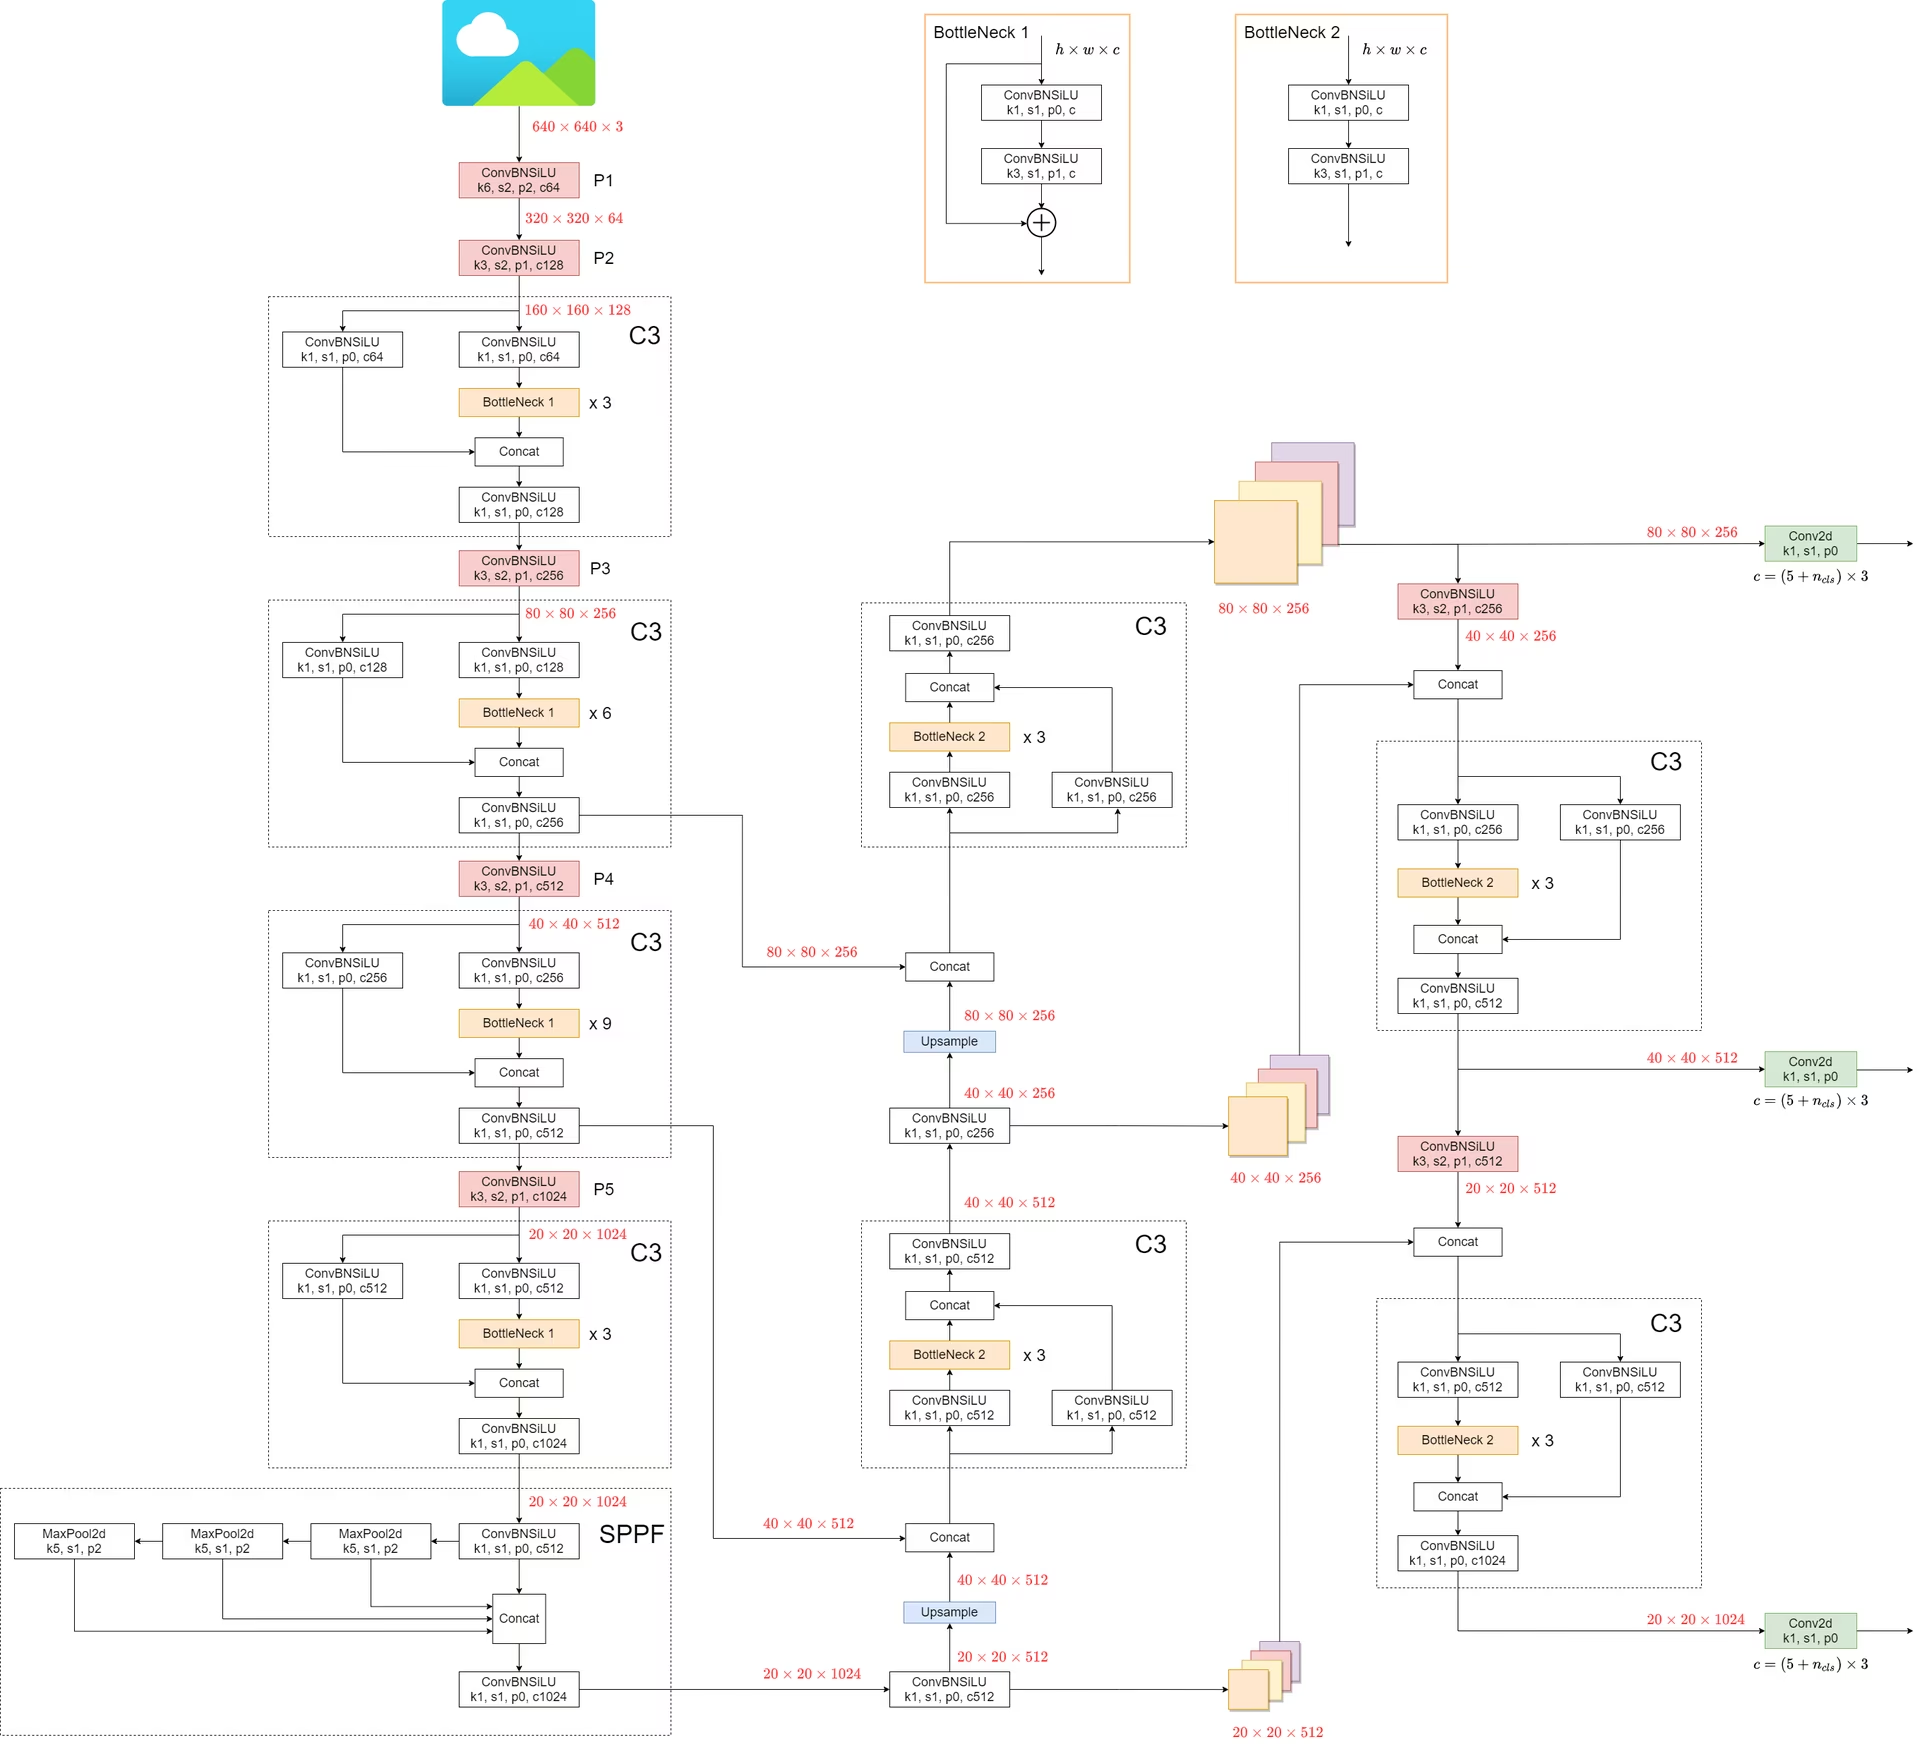
Архитектура YOLOv5 состоит из трёх основных частей:
- Backbone: основная часть сети. В YOLOv5 backbone построен на структуре
CSPDarknet53, модификации архитектуры Darknet, использовавшейся в предыдущих версиях. - Шея: эта часть соединяет базовую сеть и голову. В YOLOv5 используются структуры
SPPF(быстрый пространственный пирамидальный пуллинг) иPANet(сеть агрегации путей). - Head: эта часть отвечает за формирование итогового результата. Для этого в YOLOv5 используется
YOLOv3 Head.
Структура модели показана на изображении ниже. Подробное описание структуры модели приведено в models/yolov5l.yaml.
В YOLOv5 появились заметные улучшения по сравнению с предыдущими версиями:
- Структура
Focus, использовавшаяся в предыдущих версиях, заменена структурой6x6 Conv2d. Это изменение повышает эффективность #4825. - Структура
SPPзаменена наSPPF. Это изменение более чем вдвое увеличивает скорость обработки при сохранении того же результата.
Для проверки скорости SPP и SPPF можно использовать следующий код:
Пример профилирования скорости SPP и SPPF (нажми, чтобы открыть)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
Результат:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Методы аугментации данных#
В YOLOv5 применяются различные методы аугментации данных, чтобы улучшить способность модели к обобщению и уменьшить переобучение. К ним относятся:
-
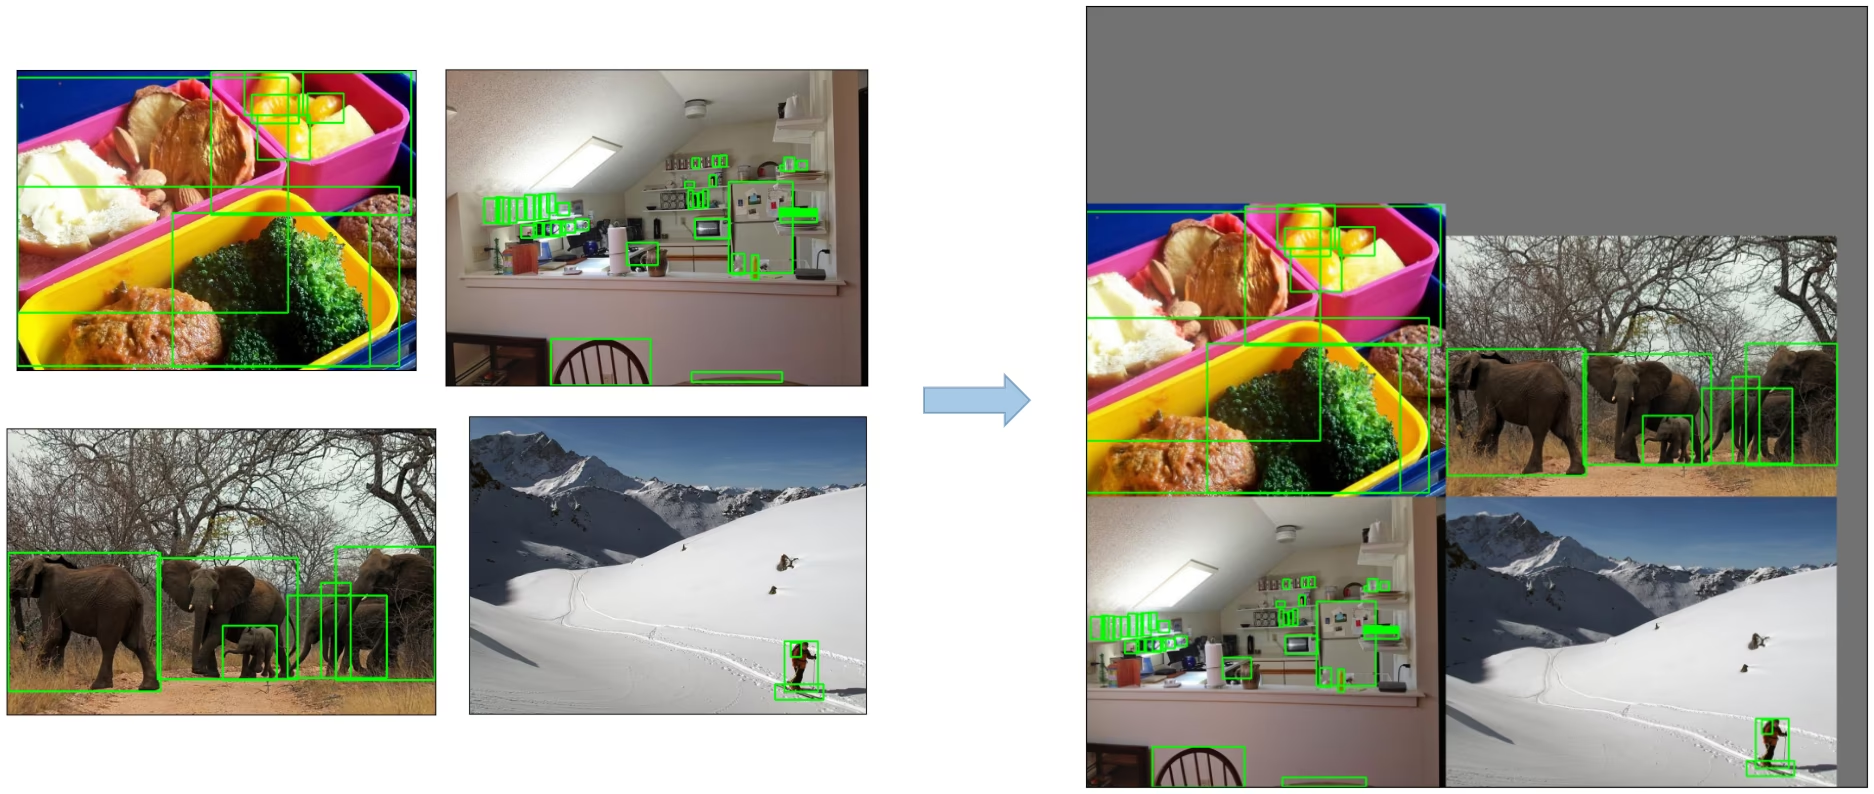
Аугментация Mosaic: метод обработки изображений, который объединяет четыре обучающих изображения в одно, помогая моделям обнаружения объектов лучше работать с объектами разных масштабов и их смещениями.
-
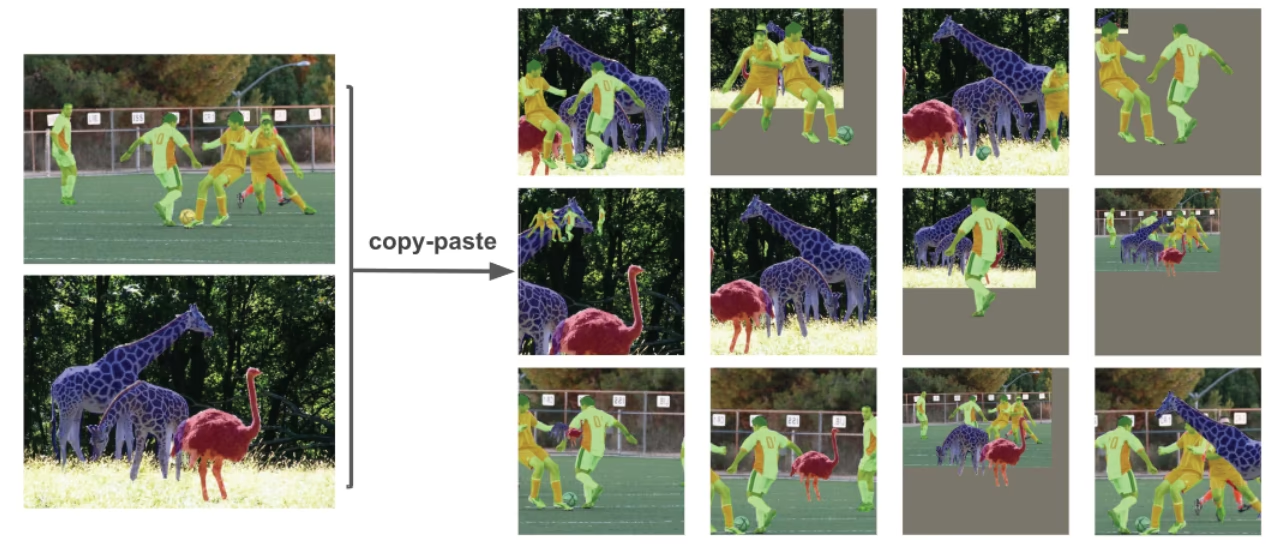
Аугментация Copy-Paste: метод аугментации данных, при котором экземпляры объектов копируются с использованием их масок сегментации и вставляются на обучающие изображения для создания новых обучающих примеров.
-
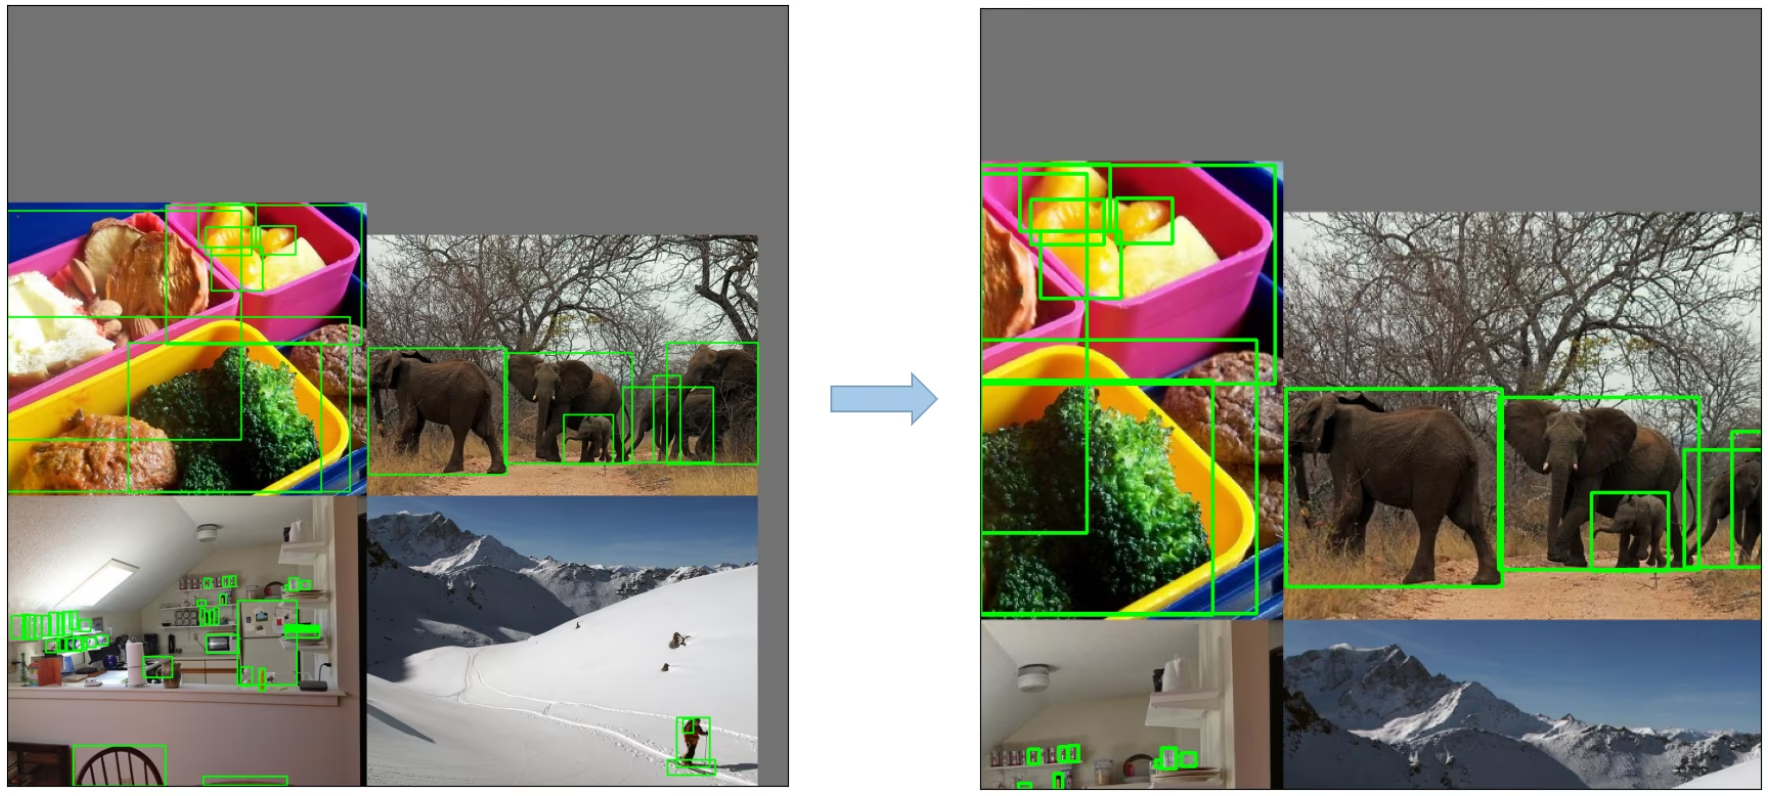
Случайные аффинные преобразования: случайные повороты, масштабирование, перемещение и сдвиг изображений.
-
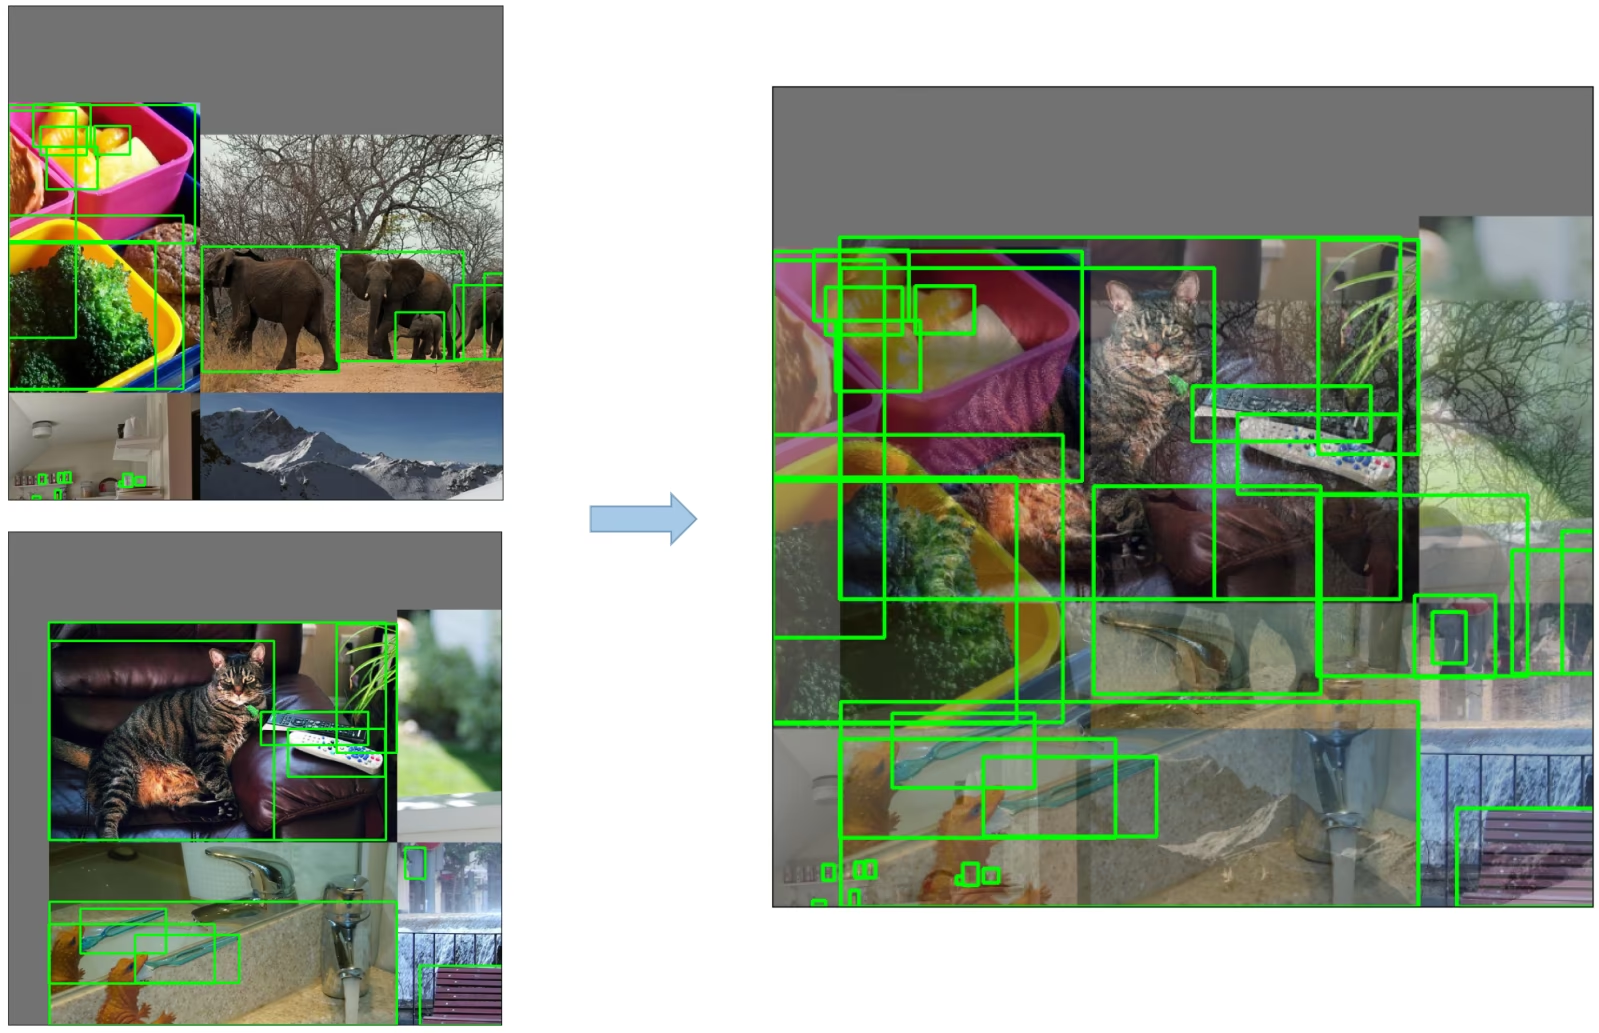
Аугментация MixUp: метод создания составных изображений путём линейного комбинирования двух изображений и соответствующих им меток.
-
Albumentations: библиотека аугментации изображений, поддерживающая широкий спектр методов аугментации.
-
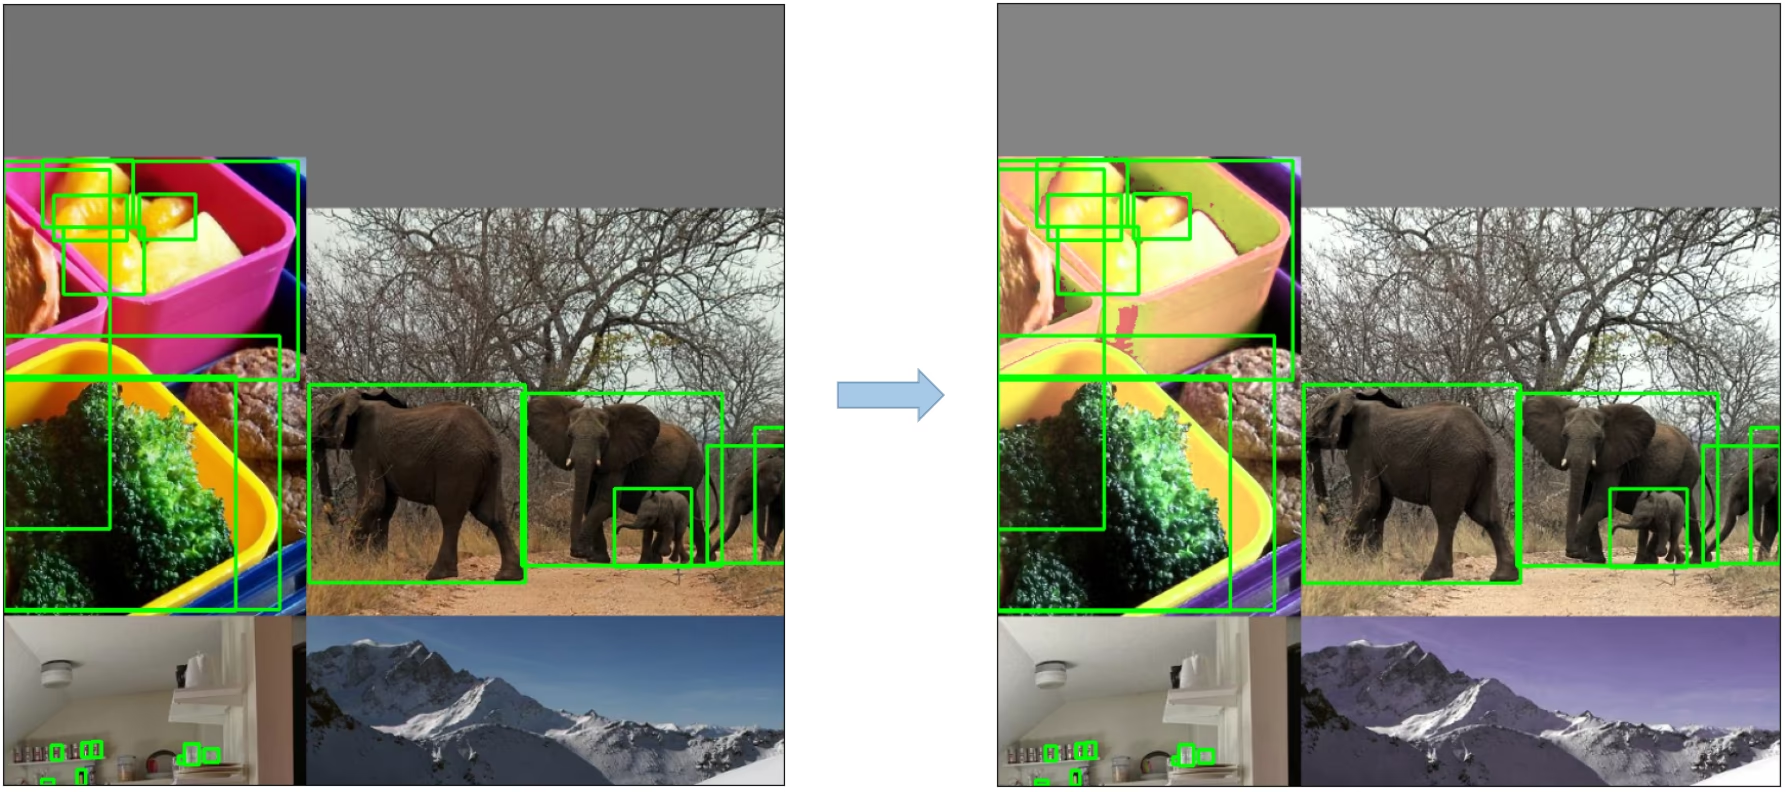
Аугментация HSV: случайное изменение оттенка, насыщенности и значения яркости изображений.
-
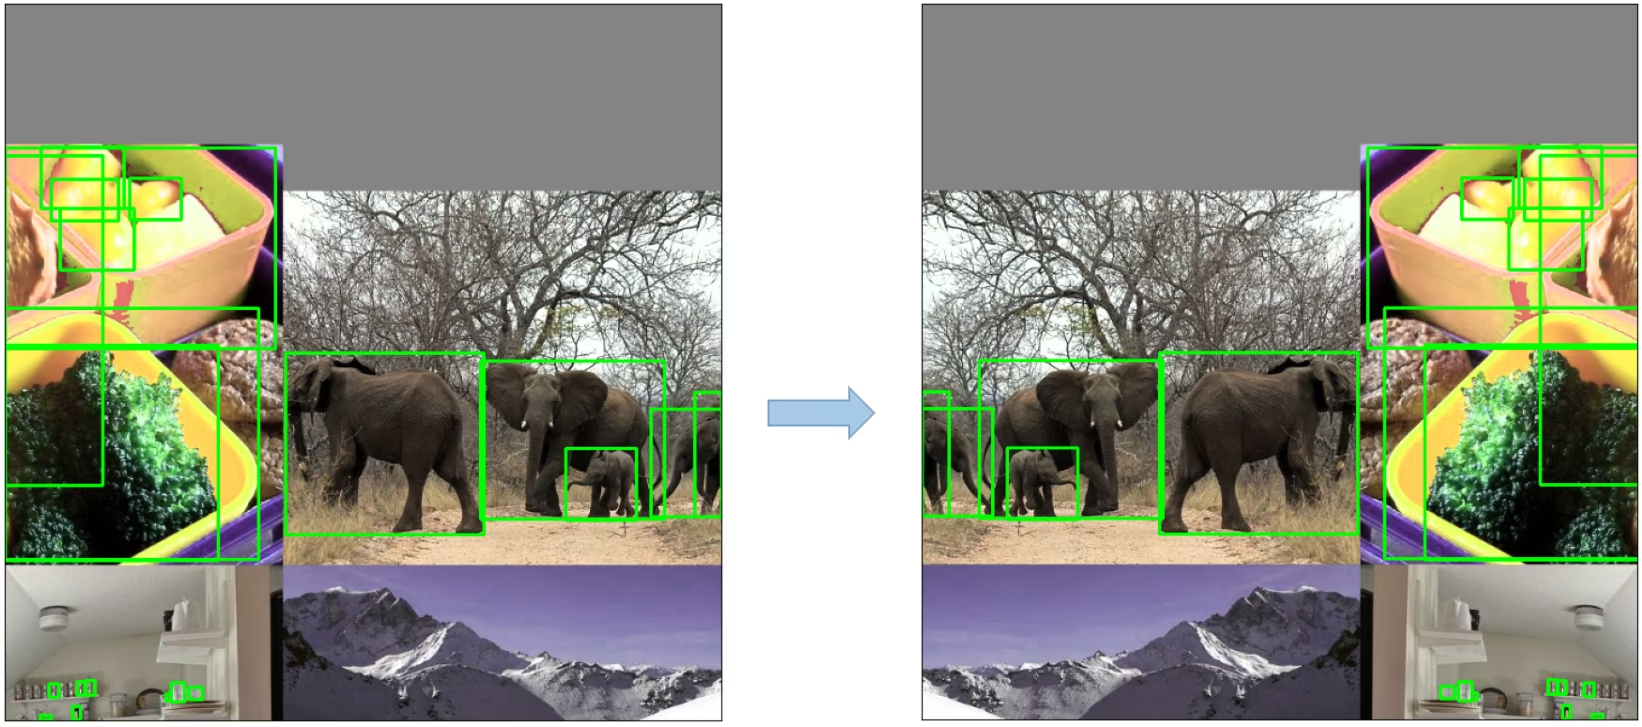
Случайное горизонтальное отражение: метод аугментации, при котором изображения случайным образом отражаются по горизонтали.
3. Стратегии обучения#
YOLOv5 применяет несколько стратегий обучения для повышения качества модели. К ним относятся:
- Многошкальное обучение: во время обучения входные изображения случайным образом масштабируются в диапазоне от 0,5 до 1,5 от исходного размера.
- AutoAnchor: эта стратегия оптимизирует исходные якорные блоки, чтобы они соответствовали статистическим характеристикам эталонных рамок в твоих пользовательских данных.
- Планировщик Warmup и косинусного изменения LR: Метод изменения скорости обучения для повышения производительности модели.
- Экспоненциальное скользящее среднее (EMA): Стратегия, использующая усреднённые значения параметров за предыдущие шаги для стабилизации процесса обучения и снижения ошибки обобщения.
- Обучение с пониженной точностью: метод выполнения операций в формате половинной точности, который снижает потребление памяти и повышает скорость вычислений.
- Эволюция гиперпараметров: Стратегия автоматической настройки гиперпараметров для достижения оптимальной производительности. Подробнее см. в руководстве «Эволюция гиперпараметров».
4. Дополнительные возможности#
4.1 Вычисление функции потерь#
Функция потерь в YOLOv5 вычисляется как комбинация трёх отдельных компонентов:
- Потери классификации (BCE Loss): потери на основе бинарной кросс-энтропии, измеряющие ошибку задачи классификации.
- Потери объектности (BCE Loss): ещё один вариант потерь на основе бинарной кросс-энтропии, который вычисляет ошибку определения наличия объекта в конкретной ячейке сетки.
- Функция потерь локализации (CIoU Loss): полная функция потерь IoU, измеряющая ошибку локализации объекта внутри ячейки сетки.
Общая функция потерь представлена формулой:
4.2 Балансировка функции потерь#
Потери объектности на трёх слоях предсказаний (P3, P4, P5) имеют разные веса. Весовые коэффициенты равны [4.0, 1.0, 0.4] соответственно. Такой подход позволяет учитывать предсказания на разных масштабах пропорционально их вкладу в общую функцию потерь.
4.3 Устранение чувствительности к сетке#
Архитектура YOLOv5 вносит несколько важных изменений в стратегию предсказания рамок по сравнению с более ранними версиями YOLO. В YOLOv2 и YOLOv3 координаты рамок предсказывались напрямую с помощью функции активации последнего слоя.

Однако в YOLOv5 формулу предсказания координат рамки изменили, чтобы снизить чувствительность к сетке и не допустить предсказания моделью неограниченных размеров рамок.
Обновлённые формулы расчёта предсказанной ограничивающей рамки:
Сравни смещение центральной точки до и после масштабирования. Диапазон смещения центральной точки изменяется с (0, 1) на (-0.5, 1.5). Благодаря этому смещение легче может достигать 0 или 1.

Сравни коэффициент масштабирования высоты и ширины (относительно якоря) до и после корректировки. В исходных уравнениях рамок YOLO/Darknet есть серьёзный недостаток. Ширина и высота ничем не ограничены, поскольку вычисляются просто как out=exp(in). Это опасно: могут возникнуть неограниченный рост градиентов, нестабильность, потери NaN и, в конечном итоге, полный срыв обучения.

4.4 Формирование целевых значений#
Формирование целевых значений в YOLOv5 крайне важно для эффективности обучения и точности модели. Этот процесс включает назначение рамок истинной разметки соответствующим ячейкам сетки на выходной карте и сопоставление рамок с подходящими анкерными рамками.
Этот процесс состоит из следующих шагов:
- Вычисли отношение размеров рамки истинной разметки к размерам каждого шаблона анкера.

- Если вычисленное отношение не превышает пороговое значение, сопоставь рамку истинной разметки с соответствующим анкером.

- Назначь сопоставленный анкер подходящим ячейкам. Учти, что из-за изменения смещения центральной точки рамку истинной разметки можно назначить более чем одному анкеру: диапазон смещения центральной точки меняется с (0, 1) на (-0.5, 1.5), что позволяет сопоставлять больше вариантов.

Таким образом, процесс формирования целевых значений гарантирует, что каждый объект истинной разметки правильно назначается и сопоставляется во время обучения, помогая YOLOv5 эффективнее обучаться обнаружению объектов.
Заключение#
YOLOv5 — важный этап в развитии обнаружения объектов в реальном времени. Архитектурные решения, стратегии обучения и инженерные усовершенствования обеспечивают высокую производительность и эффективность по сравнению с более ранними версиями YOLO.
Основные улучшения YOLOv5 включают доработки архитектуры, такие как stem 6x6 Conv2d и SPPF, широкий набор методов аугментации данных, стратегии обучения, например AutoAnchor и EMA, а также изменения в вычислении функции потерь и построении целевых значений. В совокупности они повышают точность и эффективность обнаружения объектов, сохраняя скорость, которой известны модели YOLO.
Часто задаваемые вопросы#
Базовая сеть CSPDarknet53 извлекает признаки, блок SPPF и шея PANet объединяют их на разных масштабах, а голова в стиле YOLOv3 предсказывает рамки, объектность и классы с шагами 8, 16 и 32. Полный список слоёв приведён в
models/yolov5l.yaml.SPPF последовательно выполняет три операции максимальной субдискретизации с окном 5x5, а не запускает параллельно операции с окнами 5x5, 9x9 и 13x13. Результат математически идентичен, но вычисления выполняются более чем в два раза быстрее, как показывает приведённый выше фрагмент кода профилирования.
Исходное смещение YOLO не могло принимать значения ровно 0 или 1, поэтому было трудно предсказывать объекты, расположенные на границах сетки. Масштабирование сигмоиды до диапазона (-0.5, 1.5) устраняет эту чувствительность к сетке, а возведение
2σв квадрат для ширины и высоты ограничивает предсказания четырьмя размерами анкера и предотвращает неконтролируемый рост градиентов, возникавший при использовании неограниченной экспоненты.Сопоставляются все анкеры, у которых отношения ширины и высоты к рамке не превышают
anchor_t(по умолчанию 4.0). Расширенный диапазон смещения также позволяет назначить рамку двум соседним ячейкам сетки. Таким образом, один объект может создавать несколько положительных целевых значений, что ускоряет сходимость.
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.