YOLO için OpenVINO Çıkarım Optimizasyonu#
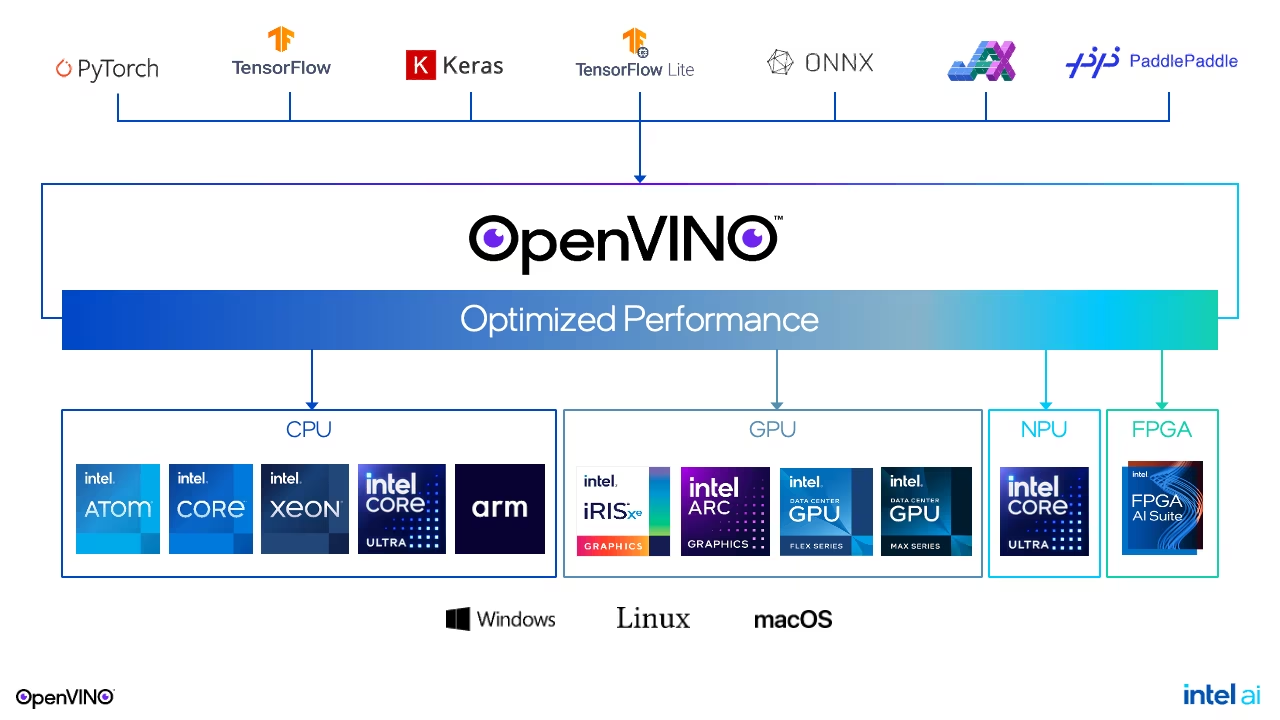
Giriş#
Derin öğrenme modellerini, özellikle Ultralytics YOLO modelleri gibi nesne algılama modellerini dağıtırken en iyi performansı elde etmek kritik önem taşır. Bu kılavuzda, gecikme ve iş hacmine odaklanarak çıkarımı optimize etmek için Intel'in OpenVINO araç setinden nasıl yararlanabileceğin ayrıntılı olarak ele alınıyor. İster tüketici sınıfı uygulamalar ister büyük ölçekli dağıtımlar üzerinde çalışıyor ol, bu optimizasyon stratejilerini anlamak ve uygulamak modellerinin çeşitli cihazlarda verimli çalışmasını sağlar.
Gecikme için Optimizasyon#
Gecikme optimizasyonu, tek bir girdiye karşılık tek bir modelden anında yanıt alınmasını gerektiren ve tüketici uygulamalarında sıkça görülen senaryolar için hayati önem taşır. Amaç, girdi ile çıkarım sonucu arasındaki gecikmeyi en aza indirmektir. Ancak özellikle eşzamanlı çıkarımlar çalıştırırken veya birden fazla modeli yönetirken düşük gecikme elde etmek için dikkatli değerlendirme gerekir.
Gecikme Optimizasyonu için Temel Stratejiler#
- Cihaz Başına Tek Çıkarım: Düşük gecikme elde etmenin en kolay yolu, her cihazda aynı anda yalnızca tek bir çıkarım yapılmasını sağlamaktır. Eşzamanlılığı artırmak çoğunlukla gecikmeyi artırır.
- Alt Cihazlardan Yararlanma: Çok soketli CPU'lar veya çok döşemeli GPU'lar gibi cihazlar, dahili alt cihazlarını kullanarak gecikmeyi çok az artırırken birden fazla isteği yürütebilir.
- OpenVINO Performans İpuçları: Model derleme sırasında
ov::LATENCYözelliğiniov::performance_modeözelliği için kullanmak, performans ayarlarını kolaylaştırır ve cihazdan bağımsız, geleceğe dönük bir yaklaşım sunar.
İlk Çıkarım Gecikmesini Yönetme#
- Model Önbelleğe Alma: Model yükleme ve derleme sürelerinin gecikmeyi etkilemesini önlemek için mümkün olduğunda model önbelleğe almayı kullan. Önbelleğe almanın mümkün olmadığı senaryolarda CPU'lar genellikle modelleri en hızlı yükleyen seçenektir.
- Model Eşleme ve Okuma: Yükleme sürelerini azaltmak için OpenVINO, model okumayı eşlemeyle değiştirdi. Ancak model çıkarılabilir bir sürücüde veya ağ sürücüsündeyse, okumaya geri dönmek için
ov::enable_mmap(false)kullanmayı düşün. - AUTO Cihaz Seçimi: Bu mod çıkarımı CPU'da başlatır, ardından hazır olduğunda bir hızlandırıcıya geçerek ilk çıkarım gecikmesini sorunsuz biçimde azaltır.
İş Hacmi için Optimizasyon#
İş hacmi optimizasyonu, çok sayıda çıkarım isteğinin aynı anda karşılandığı senaryolarda, tek tek isteklerin performansından önemli ölçüde ödün vermeden kaynak kullanımını en üst düzeye çıkarmak için kritik önem taşır.
İş Hacmi Optimizasyonu Yaklaşımları#
-
OpenVINO Performans İpuçları: Performans ipuçlarını kullanarak cihazlar arasında iş hacmini artırmaya yönelik üst düzey ve geleceğe dönük bir yöntem.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Açık Toplu İşleme ve Akışlar: Gelişmiş performans ayarı için açık toplu işlemeyi ve akış kullanımını içeren, daha ayrıntılı bir yaklaşım.
İş Hacmi Odaklı Uygulamalar Tasarlama#
İş hacmini en üst düzeye çıkarmak için uygulamalar şunları yapmalıdır:
- Cihazın kapasitesinden tam olarak yararlanarak girdileri paralel işlemek.
- Veri akışını, paralel yürütülmek üzere zamanlanan eşzamanlı çıkarım isteklerine bölmek.
- Verimliliği korumak ve cihazın atıl kalmasını önlemek için geri çağırımlarla Async API'yi kullanmak.
Çoklu Cihaz Yürütmesi#
OpenVINO'nun çoklu cihaz modu, uygulama düzeyinde cihaz yönetimi gerektirmeden çıkarım isteklerini cihazlar arasında otomatik olarak dengeleyerek iş hacmini ölçeklendirmeyi kolaylaştırır.
Gerçek Dünya Performans Kazanımları#
OpenVINO optimizasyonlarını Ultralytics YOLO modelleriyle uygulamak önemli performans artışları sağlayabilir. Karşılaştırmalı testlerde gösterildiği gibi kullanıcılar Intel CPU'larda 3 kata kadar daha hızlı çıkarım elde edebilir; tümleşik GPU'lar, özel GPU'lar ve NPU'lar da dahil olmak üzere Intel donanımlarında daha yüksek hızlanmalar da mümkündür.
Örneğin, Intel Xeon CPU'larda YOLO26 modelleri çalıştırıldığında OpenVINO için optimize edilmiş sürümler, doğruluktan ödün vermeden görüntü başına çıkarım süresi bakımından PyTorch sürümlerinden sürekli olarak daha iyi performans gösterir.
Uygulamaya Geçirme#
Ultralytics YOLO modelini OpenVINO için dışa aktarıp optimize etmek üzere dışa aktarma işlevini kullanabilirsin:
from ultralytics import YOLO

# Bir model yükle
model = YOLO("yolo26n.pt")

# Modeli OpenVINO biçimine aktar
model.export(format="openvino", quantize=16)  # FP16 hassasiyetiyle dışa aktar
Dışa aktarma işleminden sonra optimize edilmiş modelle çıkarım çalıştırabilirsin:
# OpenVINO modelini yükle
ov_model = YOLO("yolo26n_openvino_model/")

# Çıkarımı çalıştır (Ultralytics, OpenVINO modellerini LATENCY performans ipucuyla derler)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)Sonuç#
Ultralytics YOLO modellerini OpenVINO ile gecikme ve iş hacmi için optimize etmek, uygulamanın performansını önemli ölçüde artırabilir. Bu kılavuzda açıklanan stratejileri dikkatle uygulayarak modellerinin verimli çalışmasını ve çeşitli dağıtım senaryolarının gereksinimlerini karşılamasını sağlayabilirsin. Gecikme veya iş hacmi için optimizasyon arasında seçim yaparken uygulamanın özel gereksinimlerini ve dağıtım ortamının özelliklerini göz önünde bulundur.
Daha ayrıntılı teknik bilgiler ve en son güncellemeler için OpenVINO belgelerine ve Ultralytics YOLO deposuna başvur. Bu kaynaklarda, derin öğrenme modellerinden en iyi şekilde yararlanman için kapsamlı kılavuzlar, eğitimler ve topluluk desteği bulunur.
Modellerinin en iyi performansa ulaşmasını sağlamak yalnızca yapılandırmaları ayarlamakla ilgili değildir; uygulamanın gereksinimlerini anlamak ve bilinçli kararlar vermek gerekir. İster gerçek zamanlı yanıtları optimize ediyor ister büyük ölçekli işleme için iş hacmini en üst düzeye çıkarıyor ol, Ultralytics YOLO modelleri ile OpenVINO'nun birleşimi, geliştiricilere yüksek performanslı yapay zekâ çözümleri dağıtmak için güçlü bir araç seti sunar.
Sık Sorulan Sorular#
Ultralytics YOLO modellerini düşük gecikme için optimize etmek birkaç temel strateji içerir:
- Cihaz Başına Tek Çıkarım: Gecikmeleri en aza indirmek için her cihazda aynı anda yalnızca tek bir çıkarım yapılmasını sağla.
- Alt Cihazlardan Yararlanma: Gecikmeyi çok az artırarak birden fazla isteği işleyebilen çok soketli CPU'lar veya çok döşemeli GPU'lar gibi cihazlardan yararlan.
- OpenVINO Performans İpuçları: Kolay ve cihazdan bağımsız ayar için model derleme sırasında OpenVINO'nun
ov::LATENCYözelliğini kullan.
Gecikmeyi optimize etmeye yönelik pratik ipuçları için kılavuzumuzun Gecikme Optimizasyonu bölümüne göz at.
OpenVINO, performanstan ödün vermeden cihaz kaynaklarının kullanımını en üst düzeye çıkararak Ultralytics YOLO modellerinin iş hacmini artırır. Başlıca avantajları şunlardır:
- Performans İpuçları: Cihazlar arasında basit, üst düzey performans ayarı.
- Açık Toplu İşleme ve Akışlar: Gelişmiş performans için ince ayar.
- Çoklu Cihaz Yürütmesi: Otomatik çıkarım yükü dengeleme sayesinde uygulama düzeyindeki yönetimi kolaylaştırır.
Örnek yapılandırma:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Ayrıntılı kılavuzumuzdaki İş Hacmi Optimizasyonu bölümünden iş hacmi optimizasyonu hakkında daha fazla bilgi edin.
İlk çıkarım gecikmesini azaltmak için şu uygulamaları göz önünde bulundur:
- Model Önbelleğe Alma: Yükleme ve derleme sürelerini azaltmak için model önbelleğe almayı kullan.
- Model Eşleme ve Okuma: Varsayılan olarak eşlemeyi (
ov::enable_mmap(true)) kullan; ancak model çıkarılabilir bir sürücüde veya ağ sürücüsündeyse okumaya (ov::enable_mmap(false)) geç. - AUTO Cihaz Seçimi: Çıkarımı CPU'da başlatmak ve sorunsuz biçimde bir hızlandırıcıya geçmek için AUTO modundan yararlan.
İlk çıkarım gecikmesini yönetmeye yönelik ayrıntılı stratejiler için İlk Çıkarım Gecikmesini Yönetme bölümüne başvur.
Gecikme ve iş hacmi optimizasyonlarını dengelemek için uygulamanın gereksinimlerini anlaman gerekir:
- Gecikme Optimizasyonu: Anında yanıt gerektiren gerçek zamanlı uygulamalar (ör. tüketici sınıfı uygulamalar) için idealdir.
- İş Hacmi Optimizasyonu: Kaynak kullanımını en üst düzeye çıkaran, çok sayıda eşzamanlı çıkarımın yapıldığı senaryolar (ör. büyük ölçekli dağıtımlar) için en uygunudur.
OpenVINO'nun üst düzey performans ipuçlarını ve çoklu cihaz modlarını kullanmak doğru dengeyi kurmana yardımcı olabilir. Özel gereksinimlerine göre uygun OpenVINO performans ipuçlarını seç.
Evet, Ultralytics YOLO modelleri son derece çok yönlüdür ve çeşitli yapay zekâ çerçeveleriyle tümleştirilebilir. Seçenekler şunlardır:
- TensorRT: NVIDIA GPU optimizasyonu için TensorRT entegrasyon kılavuzunu izle.
- CoreML: Apple cihazları için CoreML dışa aktarma talimatlarımıza başvur.
- LiteRT.js: Web ve Node.js uygulamaları için LiteRT entegrasyon kılavuzuna ve LiteRT.js web çalışma zamanına göz at.
Ultralytics Entegrasyonları sayfasında diğer entegrasyonları keşfet.