Bilgisayarlı Görü Projesinin Temel Adımlarını Anlama
Bilgisayarlı görü projesi oluşturmak, hedeflerini tanımlama, veri toplama ve etiketleme, model eğitip değerlendirme ve modeli üretime alıp bakımını yapma gibi net bir aşamalar dizisini izlemek demektir. Bu kılavuz her adımı sırayla ele alıp neden önemli olduğunu açıklar; böylece kendi projenin planlamasını ve yürütmesini güvenle yapabilirsin.
Bilgisayarlı görü, bilgisayarların dünyayı insanlar gibi görmesine ve anlamasına yardımcı olan bir yapay zekâ (AI) alt alanıdır. Bilgileri çıkarmak, örüntüleri tanımak ve bu verilere dayanarak kararlar vermek için görüntüleri veya videoları işler ve analiz eder.
İzle: Bilgisayarlı Görü Projeleri Nasıl Yapılır | Adım Adım Kılavuz
Nesne algılama, görüntü sınıflandırma ve örnek segmentasyonu gibi bilgisayarlı görü teknikleri, değerli bilgiler edinmek için otonom sürüşten tıbbi görüntülemeye kadar çeşitli sektörlerde kullanılabilir.
Bilgisayarlı Görü Projesine Genel Bakış#
Bilgisayarlı görü projesindeki her adımın ayrıntılarına geçmeden önce genel sürece bakalım. Bugün bir bilgisayarlı görü projesine başlasaydın şu adımları izlerdin:
- İlk önceliğin, projenin gereksinimlerini anlamak olmalı.
- Ardından modelini eğitmeye yardımcı olacak görüntüleri toplar ve doğru biçimde etiketlersin.
- Sonra model eğitimine hazırlamak için verilerini temizler ve artırırsın.
- Eğitimin ardından modelinin farklı koşullarda tutarlı performans gösterdiğinden emin olmak için onu kapsamlı biçimde değerlendirir ve test edersin.
- Son olarak modelini gerçek dünyada dağıtıma alır ve yeni bulgularla geri bildirimlere göre izler ve bakımını yaparsın.
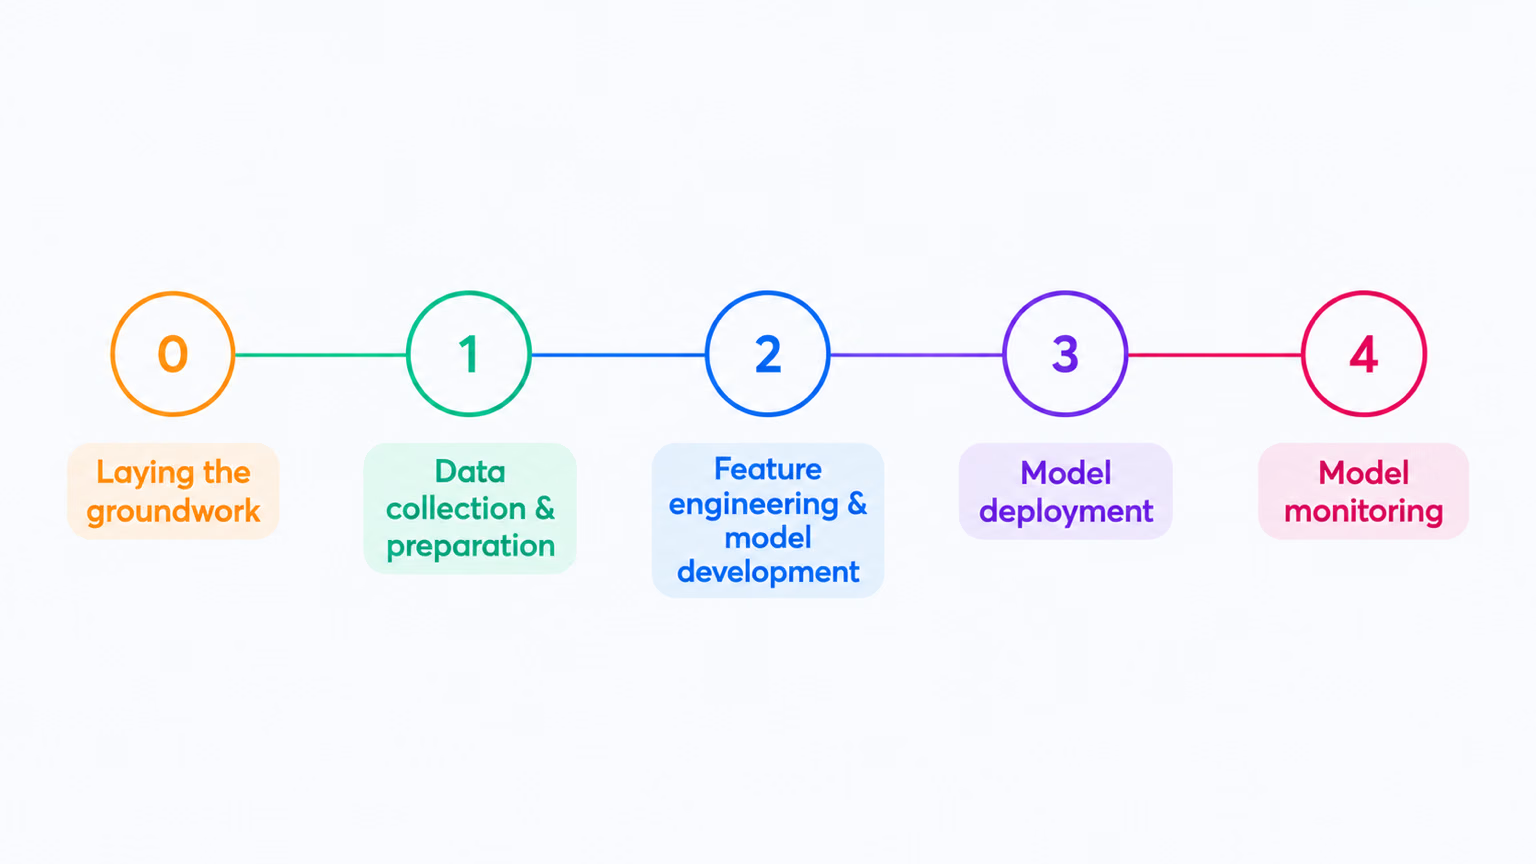
Artık seni nelerin beklediğini bildiğine göre, aşağıdaki bölümlerde her adım ayrıntılı olarak ele alınıyor.
Adım 1: Projenin Hedeflerini Belirleme#
Her bilgisayarlı görü projesinin ilk adımı, çözmeye çalıştığın problemi açıkça tanımlamaktır. Nihai hedefi bilmek, çözüm oluşturmaya başlamana yardımcı olur. Bu, bilgisayarlı görü projelerinde özellikle önemlidir; çünkü projenin amacı, hangi bilgisayarlı görü görevine odaklanman gerektiğini doğrudan etkiler.
Aşağıda proje hedefleri ve bu hedeflere ulaşmak için kullanılabilecek bilgisayarlı görü görevlerine ilişkin bazı örnekler yer alıyor:
-
Hedef: Otoyollardaki farklı araç türlerinin akışını izleyip yöneterek trafik yönetimini ve güvenliğini iyileştirebilecek bir sistem geliştirmek.
- Bilgisayarlı Görü Görevi: Nesne algılama, birden fazla aracı verimli biçimde konumlandırıp tanımladığı için trafik izleme açısından idealdir. Bu görev için gereksiz ayrıntılar sunan görüntü segmentasyonundan daha az hesaplama gücü gerektirir; böylece daha hızlı ve gerçek zamanlı analiz sağlar.
-
Hedef: Radyologlara tıbbi görüntüleme taramalarındaki tümörlerin piksel düzeyinde hassas sınırlarını sunarak yardımcı olan bir araç geliştirmek.
- Bilgisayarlı Görü Görevi: Görüntü segmentasyonu, tümörlerin boyutunu ve şeklini değerlendirmek ve tedaviyi planlamak açısından kritik olan doğru ve ayrıntılı sınırlar sağladığı için tıbbi görüntüleme alanında uygundur.
-
Amaç: Kurumsal verimliliği ve belge erişimini iyileştirmek için çeşitli belgeleri (ör. faturalar, fişler, yasal evraklar) kategorilere ayıran dijital bir sistem oluşturmak.
- Bilgisayarlı Görü Görevi: Görüntü sınıflandırma, görüntüdeki belgenin konumunu dikkate almaya gerek kalmadan her seferinde tek bir belgeyi işlediği için bu kullanım için idealdir. Bu yaklaşım, sıralama sürecini basitleştirir ve hızlandırır.
Doğru Modeli ve Eğitim Yaklaşımını Seçme#
Proje amacını ve uygun bilgisayarlı görü görevlerini anladıktan sonra, proje hedefini belirlemenin önemli bir parçası doğru modeli ve eğitim yaklaşımını seçmektir.
Amaca bağlı olarak, modeli önce seçebilir veya 2. Adım'da hangi verileri toplayabileceğini gördükten sonra seçebilirsin. Örneğin, projenin belirli veri türlerinin bulunmasına büyük ölçüde bağlı olduğunu varsayalım. Bu durumda, model seçmeden önce verileri toplamak ve analiz etmek daha pratik olabilir. Öte yandan, model gereksinimlerini açıkça biliyorsan önce modeli seçebilir, ardından bu özelliklere uyan verileri toplayabilirsin.
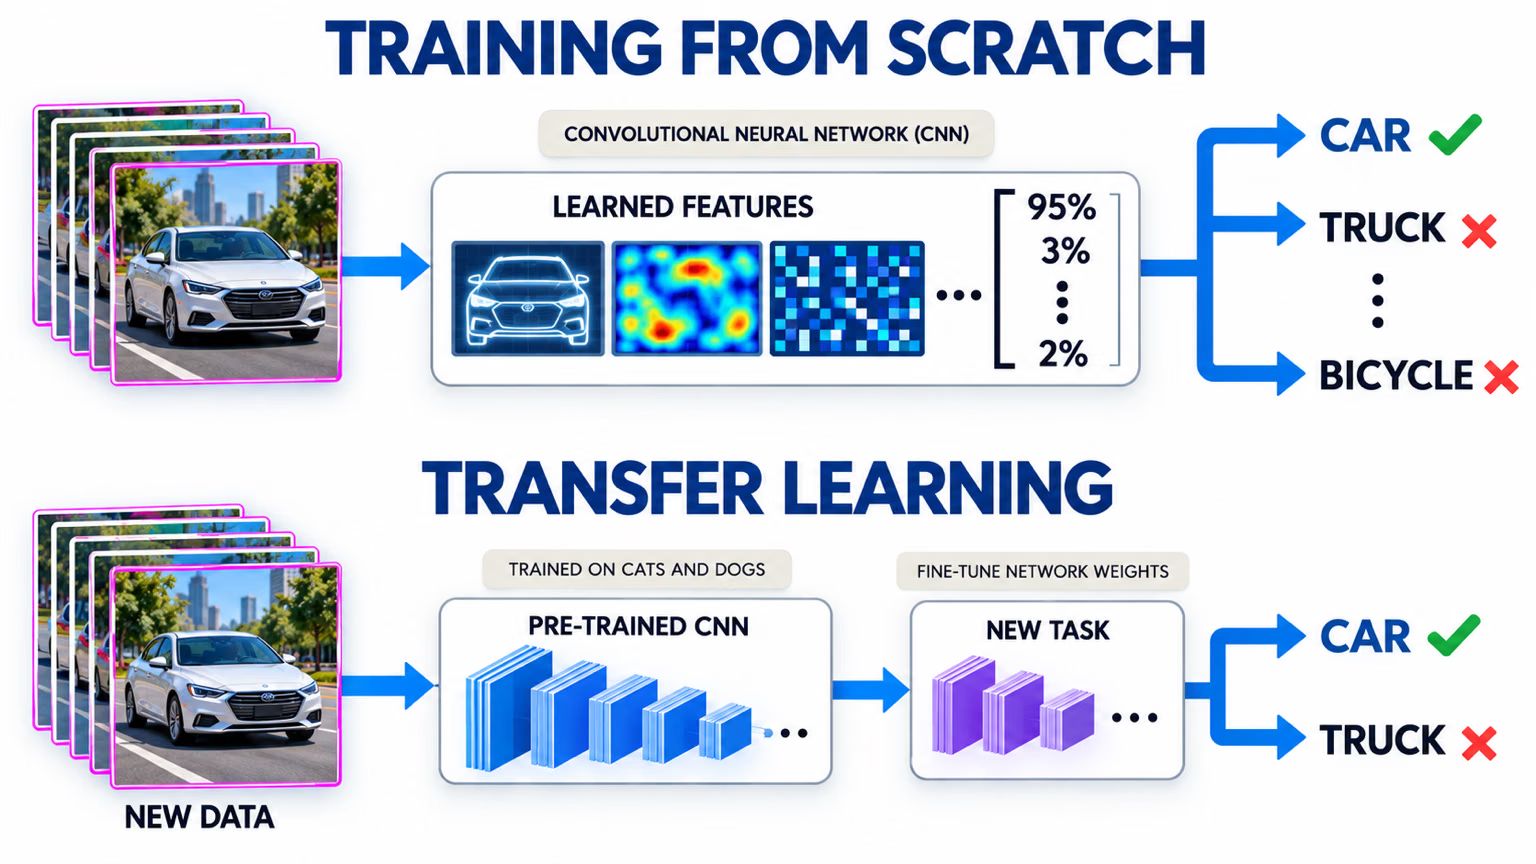
Sıfırdan eğitim ile transfer öğrenimi kullanımı arasında seçim yapmak, verilerini nasıl hazırlayacağını etkiler. Sıfırdan eğitim, modelin anlayışını temelden oluşturmak için çeşitli bir veri kümesi gerektirir. Öte yandan transfer öğrenimi, önceden eğitilmiş bir modeli kullanmana ve daha küçük, daha özel bir veri kümesiyle uyarlamana olanak tanır. Ayrıca, eğitmek için belirli bir model seçmen, modelin özel gereksinimlerine göre görüntüleri yeniden boyutlandırmak veya açıklama eklemek gibi veri hazırlama adımlarını belirler.
Uyumluluk ve performansı güvence altına almak için modelin dağıtım hedefini göz önünde bulundur. Örneğin, hafif modeller, kaynakları kısıtlı cihazlardaki verimlilikleri sayesinde uç bilişim için idealdir.
Daha fazla bilgi edinmek için projenin hedeflerini belirleme ve doğru modeli seçme kılavuzumuzu oku.
Bilgisayarlı görü projesinin uygulamalı çalışmalarına başlamadan önce, bu ayrıntıları net bir şekilde anlaman önemlidir. 2. Adım'a geçmeden önce aşağıdakileri gözden geçirdiğinden emin ol:
- Çözmeye çalıştığın problemi açıkça tanımla.
- Projenin nihai hedefini belirle.
- Gereken belirli bilgisayarlı görü görevini belirle (ör. nesne algılama, görüntü sınıflandırma, görüntü segmentasyonu).
- Bir modeli sıfırdan mı eğiteceğine yoksa transfer öğrenimi mi kullanacağına karar ver.
- Görevine ve dağıtım gereksinimlerine uygun modeli seç.
Adım 2: Veri Toplama ve Veri Etiketleme#
Bilgisayarlı görü modellerinin kalitesi, veri kümenin kalitesine bağlıdır. İnternetten görüntüler toplayabilir, kendi fotoğraflarını çekebilir veya mevcut veri kümelerini kullanabilirsin. Kullanışlı herkese açık veri kümesi kaynakları arasında Google Dataset Search Engine, UC Irvine Machine Learning Repository ve Kaggle Datasets bulunur.
Ultralytics gibi bazı kitaplıklar, başlamayı kaliteli verilerle kolaylaştıran çeşitli veri kümeleri için yerleşik destek sunar. Bu kitaplıklar genellikle popüler veri kümelerini indirme ve yükleme araçları içerir; böylece projenin ilk aşamalarında zamandan ve emekten tasarruf edebilirsin.
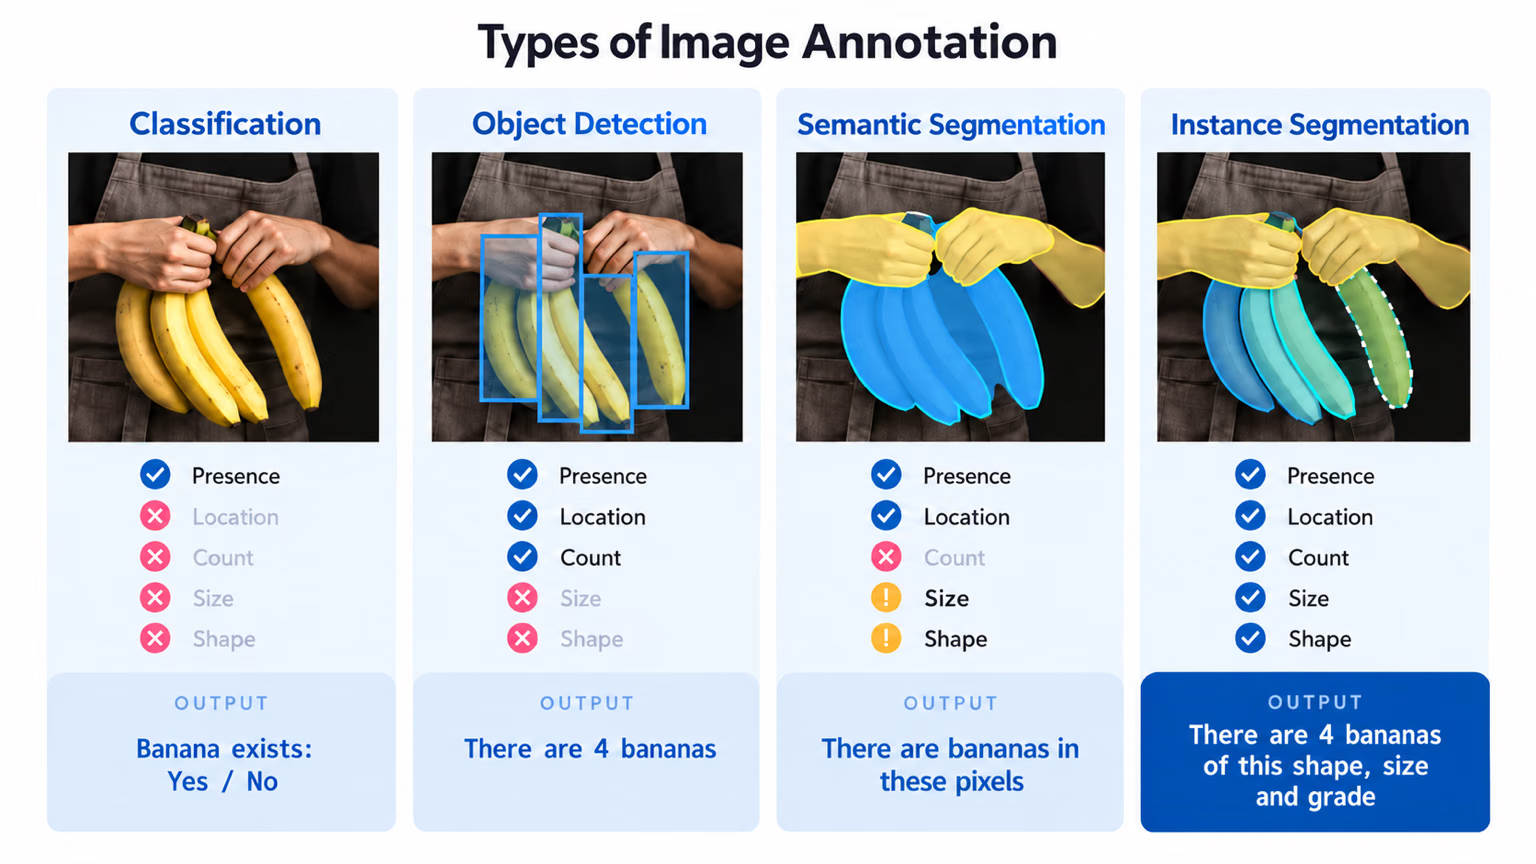
Ancak görüntüleri toplamayı veya kendi fotoğraflarını çekmeyi seçersen verilerine açıklama eklemen gerekir. Veri açıklama, modeline bilgi kazandırmak için verileri etiketleme sürecidir. Kullanacağın veri açıklama türü, özel bilgisayarlı görü tekniğine bağlıdır. İşte bazı örnekler:
- Görüntü Sınıflandırma: Görüntünün tamamını tek bir sınıf olarak etiketlersin.
- Nesne Algılama: Görüntüdeki her nesnenin çevresine sınırlayıcı kutular çizer ve her kutuyu etiketlersin.
- Görüntü Segmentasyonu: Ayrıntılı nesne sınırları oluşturmak için görüntüdeki her pikseli ait olduğu nesneye göre etiketlersin.
Veri toplama ve açıklama ekleme zaman alıcı, manuel bir iş olabilir. Amaca özel bir açıklama aracı süreci hızlandırır: Ultralytics Platform, algılama, segmentasyon ve OBB verileri için yerleşik bir açıklama düzenleyici ile SAM destekli akıllı açıklama sunar ve etiketleri doğrudan YOLO biçiminde kaydeder.
Adım 3: Veri Artırma ve Veri Kümesini Bölme#
Görüntü verilerini topladıktan ve açıklamalar ekledikten sonra, veri artırma işlemini gerçekleştirmeden önce veri kümeni eğitim, doğrulama ve test kümelerine ayırman önemlidir. Veri kümeni artırma işleminden önce bölmek, modelini özgün ve değiştirilmemiş veriler üzerinde test etmek ve doğrulamak açısından kritik öneme sahiptir. Bu, modelin yeni ve daha önce görülmemiş verilere ne kadar iyi genelleme yaptığını doğru şekilde değerlendirmene yardımcı olur.
Verilerini şu şekilde bölebilirsin:
- Eğitim Kümesi: Verilerinin genellikle toplamın %70-80'ini oluşturan en büyük bölümüdür ve modelini eğitmek için kullanılır.
- Doğrulama Kümesi: Genellikle verilerinin yaklaşık %10-15'ini oluşturur; hiperparametreleri ayarlamak ve eğitim sırasında modeli doğrulamak için kullanılır, böylece aşırı öğrenmenin önlenmesine yardımcı olur.
- Test Kümesi: Verilerinin kalan %10-15'lik bölümü test kümesi olarak ayrılır. Eğitim tamamlandıktan sonra, modelin görülmemiş verilerdeki performansını değerlendirmek için kullanılır.
Verilerini böldükten sonra, veri kümeni yapay olarak büyütmek için görüntüleri döndürme, ölçeklendirme ve çevirme gibi dönüşümler uygulayarak veri artırma yapabilirsin. Veri artırma, modelinin farklılıklara karşı daha dayanıklı olmasını sağlar ve görülmemiş görüntülerdeki performansını iyileştirir.
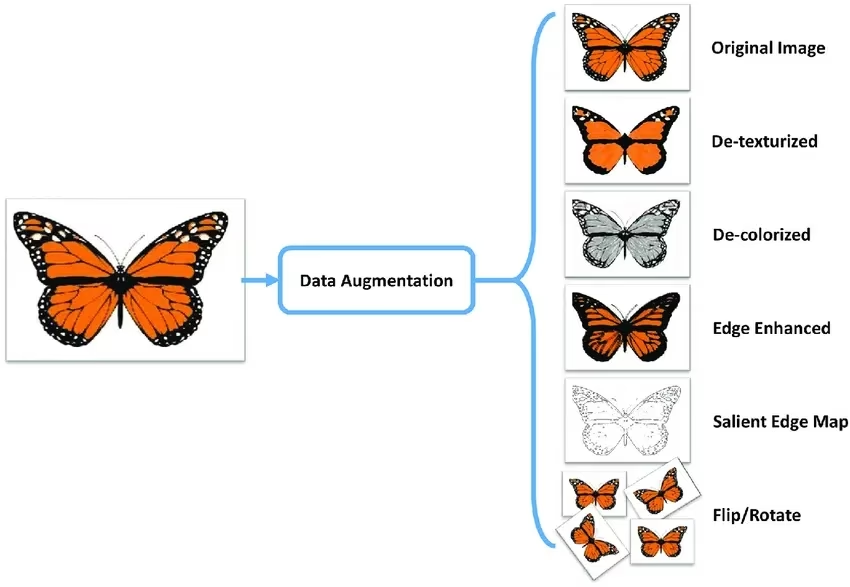
OpenCV, Albumentations ve TensorFlow gibi kitaplıklar kullanabileceğin esnek artırma işlevleri sunar. Ayrıca Ultralytics gibi bazı kitaplıklar, süreci kolaylaştırmak için model eğitim işlevlerinin içinde doğrudan yerleşik artırma ayarları barındırır.
Verilerini daha iyi anlamak için görüntüleri görselleştirmek, dağılımlarını ve özelliklerini analiz etmek amacıyla Matplotlib veya Seaborn gibi araçları kullanabilirsin. Verileri görselleştirmek; örüntüleri, anormallikleri ve artırma tekniklerinin etkililiğini belirlemene yardımcı olur. Ultralytics Platform'daki Charts sekmesi, yüklenen her veri kümesi için bölme dağılımını, sınıf sayılarını, görüntü boyutu histogramlarını ve açıklama konumu ısı haritalarını otomatik olarak oluşturarak bu bilgilerin çoğunu kod yazmadan sunabilir.
Verilerini doğru şekilde anlayıp bölerek ve artırarak, gerçek dünya uygulamalarında iyi performans gösteren, iyi eğitilmiş, doğrulanmış ve test edilmiş bir model geliştirebilirsin.
Adım 4: Model Eğitimi#
Veri kümen eğitime hazır olduğunda gerekli ortamı kurmaya, veri kümelerini yönetmeye ve modelini eğitmeye odaklanabilirsin.
Öncelikle ortamının doğru yapılandırıldığından emin olmalısın. Bu yapılandırma genellikle şunları içerir:
- TensorFlow, PyTorch veya Ultralytics gibi temel kütüphaneleri ve çerçeveleri yüklemek.
- GPU kullanıyorsan CUDA ve cuDNN gibi kütüphaneleri yüklemek, GPU hızlandırmasını etkinleştirerek eğitim sürecini hızlandırmaya yardımcı olur.
Ardından eğitim ve doğrulama veri kümelerini ortamına yükleyebilirsin. Verileri yeniden boyutlandırma, biçim dönüştürme veya artırma yoluyla normalleştir ve ön işlemeden geçir. Modelini seçtikten sonra katmanları yapılandır ve hiperparametreleri belirt. Kayıp işlevini, iyileştiriciyi ve performans metriklerini ayarlayarak modeli derle.
Ultralytics gibi kütüphaneler eğitim sürecini basitleştirir. Verileri modele aktararak çok az kodla eğitime başlayabilirsin. Bu kütüphaneler ağırlık ayarlamalarını, geri yayılımı ve doğrulamayı otomatik olarak gerçekleştirir. Ayrıca ilerlemeyi izlemek ve hiperparametreleri kolayca ayarlamak için araçlar sunarlar. Eğitimden sonra birkaç komutla modeli ve ağırlıklarını kaydedebilirsin.
Verimli eğitim için uygun veri kümesi yönetiminin hayati önem taşıdığını unutmamalısın. Değişiklikleri izlemek ve tekrarlanabilirliği sağlamak için veri kümelerinde sürüm denetimi kullan. DVC (Veri Sürüm Denetimi) gibi araçlar büyük veri kümelerini yönetmene yardımcı olabilir.
Adım 5: Model Değerlendirme ve İnce Ayar#
Doğruluğu iyileştirmek için çeşitli metrikler kullanarak modelinin performansını değerlendirmek ve modeli geliştirmek önemlidir. Değerlendirme, modelin hangi alanlarda başarılı olduğunu ve nerelerde iyileştirilmesi gerekebileceğini belirlemeye yardımcı olur. İnce ayar, modelin mümkün olan en iyi performans için optimize edilmesini sağlar.
- Performans Ölçütleri: Modelinin performansını değerlendirmek için doğruluk, kesinlik, duyarlılık ve F1 puanı gibi ölçütleri kullan. Bu ölçütler, modelinin ne kadar iyi tahmin yaptığını anlamanı sağlar.
- Hiperparametre Ayarı: Model performansını optimize etmek için hiperparametreleri ayarla. Izgara araması veya rastgele arama gibi teknikler, en iyi hiperparametre değerlerini bulmaya yardımcı olabilir.
- İnce Ayar: Performansı artırmak için model mimarisinde veya eğitim sürecinde küçük değişiklikler yap. Bu, öğrenme oranlarını, yığın boyutlarını veya diğer model parametrelerini ayarlamayı içerebilir.
Model değerlendirme ve ince ayar tekniklerini daha iyi anlamak için model değerlendirme içgörüleri kılavuzumuza göz at.
Adım 6: Model Testi#
Model testi, modelinin tamamen görülmemiş verilerde iyi performans gösterdiğini doğrulayarak dağıtıma hazır olduğunu teyit eder. Model testi ile model değerlendirme arasındaki fark, testin modeli yinelemeli olarak iyileştirmek yerine son modelin performansını doğrulamaya odaklanmasıdır.
Ortaya çıkabilecek yaygın sorunları kapsamlı şekilde test etmek ve hata ayıklamak önemlidir. Modelini, eğitim veya doğrulama sırasında kullanılmamış ayrı bir test veri kümesi üzerinde test et. Model performansının tutarlı ve güvenilir olmasını sağlamak için bu veri kümesi gerçek dünya senaryolarını temsil etmelidir.
Ayrıca aşırı öğrenme, yetersiz öğrenme ve veri sızıntısı gibi yaygın sorunları ele al. Bu sorunları belirlemek için çapraz doğrulama gibi tekniklerden yararlan. Kapsamlı test stratejileri için model test kılavuzumuza bak.
Adım 7: Model Dağıtımı#
Modelini kapsamlı biçimde test ettikten sonra modeli dağıtma zamanı gelir. Model dağıtımı, modelini bir üretim ortamında kullanılabilir hâle getirmeyi içerir. İşte bilgisayarlı görü modelini dağıtma adımları:
- Ortamı Kurma: Bulut tabanlı (AWS, Google Cloud, Azure) veya uç tabanlı (yerel cihazlar, IoT) olsun, seçtiğin dağıtım seçeneği için gerekli altyapıyı yapılandır.
- Modeli Dışa Aktarma: Dağıtım platformunla uyumluluğu sağlamak için modelini uygun biçime (ör. YOLO26 için ONNX, TensorRT, CoreML) aktar.
- Modeli Dağıtma: API'ler veya uç noktalar kurup bunları uygulamana entegre ederek modeli dağıt.
- Ölçeklenebilirliği Sağlama: Kaynakları yönetmek ve artan veri ve kullanıcı isteklerini karşılamak için yük dengeleyiciler, otomatik ölçeklendirme grupları ve izleme araçları uygula.
Ultralytics Platform ayrıca 42 küresel bölgede, varsayılan olarak sıfıra ölçekleme özelliği sunan yönetilen dağıtım uç noktaları sağlar ve altyapı kurulumunu otomatik olarak gerçekleştirir.
Adım 8: İzleme, Bakım ve Dokümantasyon#
Modelin dağıtıldıktan sonra performansını sürekli izlemek, sorunları gidermek için bakımını yapmak ve gelecekte başvurmak ve iyileştirmeler yapmak üzere tüm süreci belgelemek önemlidir.
İzleme araçları, temel performans göstergelerini (KPI'lar) takip etmene ve anormallikleri ya da doğruluk düşüşlerini saptamana yardımcı olabilir. Modeli izleyerek, girdi verilerindeki değişiklikler nedeniyle performansının zamanla azalması anlamına gelen model kaymasını fark edebilirsin. Doğruluğu ve güncelliği korumak için modeli güncellenmiş verilerle düzenli olarak yeniden eğit.
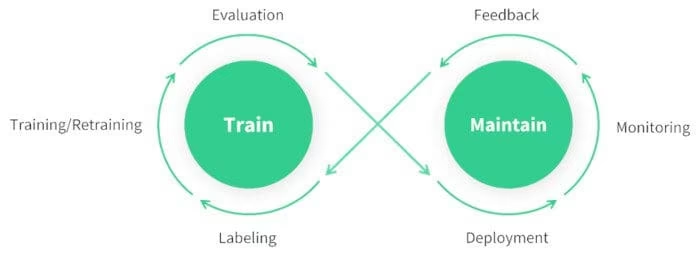
İzleme ve bakımın yanı sıra dokümantasyon da önemlidir. Model mimarisi, eğitim prosedürleri, hiperparametreler, veri ön işleme adımları ve dağıtım ve bakım sırasında yapılan değişiklikler dahil tüm süreci eksiksiz şekilde belgele. İyi dokümantasyon tekrarlanabilirliği güvence altına alır ve gelecekteki güncellemeleri veya sorun gidermeyi kolaylaştırır. Modelini etkili biçimde izleyerek, bakımını yaparak ve belgeleyerek modelinin kullanım ömrü boyunca doğru, güvenilir ve yönetimi kolay kalmasını sağlayabilirsin.
Toplulukla Etkileşim#
Bilgisayarlı görü meraklılarından oluşan bir toplulukla bağlantı kurmak, bilgisayarlı görü projen üzerinde çalışırken karşılaştığın sorunları güvenle aşmana yardımcı olabilir. Öğrenmek, sorunları gidermek ve etkili bir ağ kurmak için bazı yollar şunlardır.
Topluluk Kaynakları#
- GitHub Sorunları: YOLO26 GitHub deposuna göz at ve soru sormak, hataları bildirmek ve yeni özellikler önermek için Issues sekmesini kullan. Aktif topluluk ve bakımcılar, belirli sorunlarda yardımcı olmak için oradadır.
- Ultralytics Discord Sunucusu: Diğer kullanıcılar ve geliştiricilerle etkileşime geçmek, destek almak ve içgörülerini paylaşmak için Ultralytics Discord sunucusuna katıl.
Bu kaynakları kullanmak, zorlukların üstesinden gelmene ve bilgisayarlı görü topluluğundaki en son trendlerden ve en iyi uygulamalardan haberdar olmana yardımcı olur.
Sonraki Adımlar#
Hedefleri belirlemekten dağıtılmış bir modeli izlemeye kadar, bilgisayarlı görü projesinin her aşaması için artık bir yol haritan var. İlk YOLO modelini eğiterek bu yol haritasını uygulamaya koyabilir veya yukarıda bağlantısı verilen kılavuzlarla tek bir aşamayı daha derinlemesine inceleyebilirsin. Tüm işlem hattını kod yazmadan çalıştırmak için Ultralytics Platform ürününü keşfet.
Sık Sorulan Sorular#
Doğru bilgisayarlı görü görevini seçmek, projenin nihai hedefine bağlıdır. Örneğin, trafiği izlemek istiyorsan birden fazla araç türünü gerçek zamanlı olarak bulup tanımlayabildiğinden nesne tespiti uygundur. Tıbbi görüntüleme içinse tümörlerin ayrıntılı sınırlarını sunarak tanı ve tedavi planlamasına yardımcı olan görüntü segmentasyonu idealdir.
Veri açıklama, modeline örüntüleri tanımayı öğretmek için hayati önem taşır. Açıklama türü göreve göre değişir:
- Görüntü Sınıflandırma: Görüntünün tamamı tek bir sınıf olarak etiketlenir.
- Nesne Algılama: Nesnelerin çevresine sınırlayıcı kutular çizilir.
- Görüntü Segmentasyonu: Her piksel, ait olduğu nesneye göre etiketlenir.
Ultralytics Platform'daki yerleşik anotasyon düzenleyicisi bu süreçte yardımcı olabilir.
Veri kümeni artırmadan önce bölmek, model performansını özgün ve değiştirilmemiş veriler üzerinde doğrulamaya yardımcı olur. Şu adımları izle:
- Eğitim Kümesi: Verilerinin %70-80'i.
- Doğrulama Kümesi: Hiperparametre ayarı için %10-15.
- Test Kümesi: Son değerlendirme için kalan %10-15.
Böldükten sonra veri kümesi çeşitliliğini artırmak için döndürme, ölçeklendirme ve çevirme gibi veri artırma tekniklerini uygula. Albumentations ve OpenCV gibi kütüphaneler yardımcı olabilir. Ultralytics ayrıca kolaylık sağlaması için yerleşik artırma ayarları sunar.
Eğittiğin modeli
exportyöntemiyle dışa aktar ve dağıtım hedefine uygun bir biçim seç. Ultralytics, ONNX, TensorRT ve CoreML dahil olmak üzere birden fazla biçimi destekler. YOLO26 modelini dışa aktarmak için şu adımları izle:- İstediğin biçim parametresiyle
exportyöntemini kullan. - Dışa aktarılan modelin dağıtım ortamının özelliklerine (ör. uç cihazlar, bulut) uyduğundan emin ol.
Daha fazla bilgi için model dışa aktarma kılavuzumuza göz at.
- İstediğin biçim parametresiyle
Sürekli izleme ve bakım, modelin uzun vadeli başarısı için gereklidir. Temel Performans Göstergelerini (KPI'lar) izlemek ve anormallikleri tespit etmek için araçlar uygula. Model kaymasını önlemek için modeli güncel verilerle düzenli olarak yeniden eğit. Tekrarlanabilirliği ve gelecekteki güncellemelerin kolaylığını güvence altına almak için model mimarisi, hiperparametreler ve değişiklikler dahil tüm süreci belgele. Daha fazla bilgi için izleme ve bakım kılavuzumuza göz at.


Yorumlar2
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
VeeranjaneyuluToka
what is the best way of verifying if the chosen model is right fit for the given dataset or problem statement. Is it just based on evaluation metrics or can we use kind of approach to verify based on the feature maps or heat map visualization if the model is really learning the features that it needs to be learnt.
 Glenn JocherUltralytics
Great question! You're absolutely right that evaluation metrics alone don't tell the whole story. Here are several approaches to verify if your model is truly learning the right features:
Beyond Evaluation Metrics:
- Feature visualization and heat maps (like Grad-CAM, LIME) help you see what regions the model focuses on during predictions
- Activation maps show which features activate at different layers, revealing what the model has learned
- Confusion matrices reveal specific class prediction patterns and potential biases
Practical Verification Approaches:
- Test on edge cases and adversarial examples to understand model robustness
- Cross-validation across different data splits to ensure consistent performance
- Error analysis by examining misclassified samples to identify systematic issues
- Domain adaptation testing on slightly different datasets to check generalization
For YOLO11 specifically:
- Use validation visualizations during training to see bounding box predictions
- Monitor training curves for signs of overfitting or underfitting
- Test inference on diverse real-world scenarios beyond your test set
The key is combining quantitative metrics with qualitative analysis - if your model achieves high accuracy but the heat maps show it's focusing on irrelevant background features instead of the actual objects, that's a red flag even with good metrics.
Would you like specific guidance on implementing any of these visualization techniques with your current project?