SAM 3: Her Şeyi Kavramlarla Bölütle
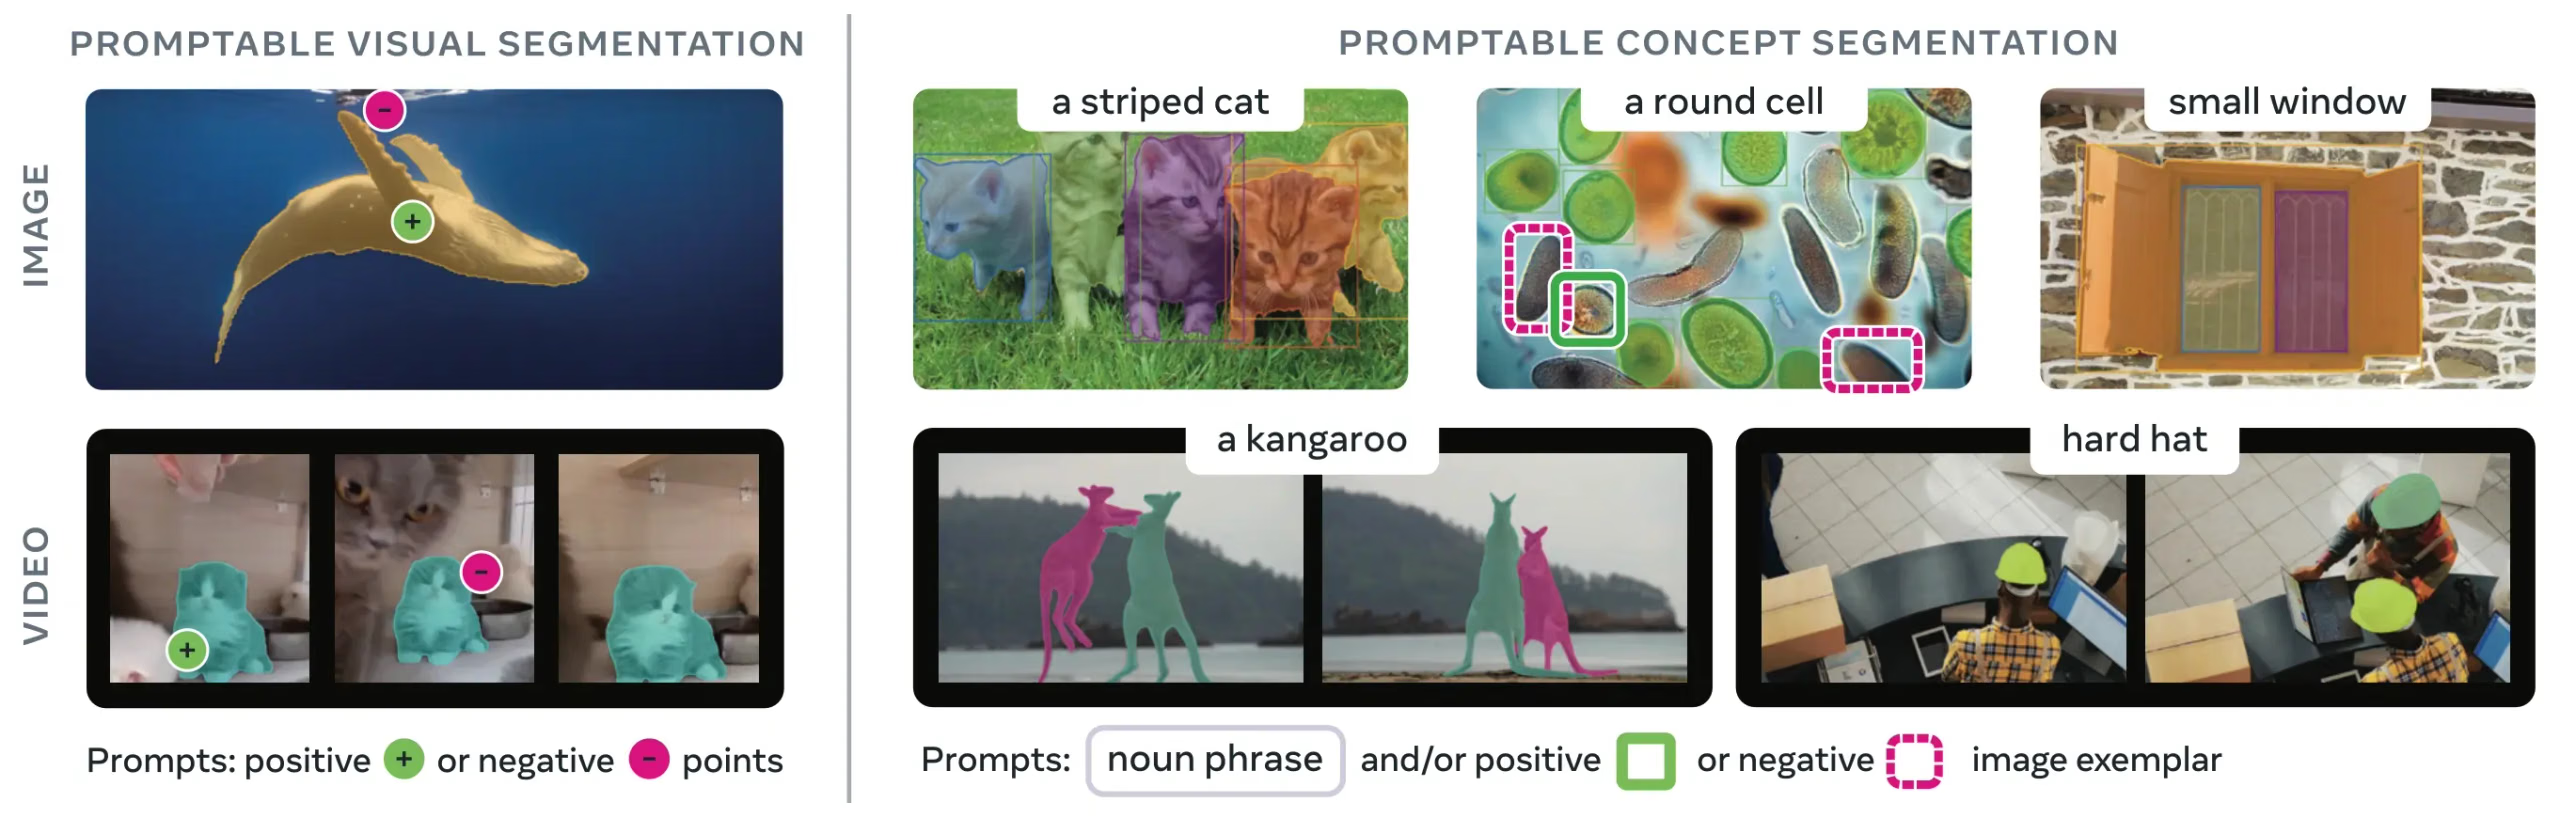
SAM 3 (Her Şeyi Bölütleme Modeli 3), Meta'nın İstemlenebilir Kavram Bölütleme (PCS) için geliştirdiği bir temel modeldir. SAM 2 üzerine kurulan SAM 3, metin istemleri, örnek görüntüler veya her ikisiyle belirtilen bir görsel kavramın tüm örneklerini tespit etme, bölütleme ve izleme yeteneğini sunar. Her istem başına tek bir nesneyi bölütleyen önceki SAM sürümlerinden farklı olarak SAM 3, görüntü veya videoda herhangi bir yerde görünen bir kavramın tüm örneklerini bulup bölütleyebilir; bu yaklaşım, modern örnek bölütleme alanındaki açık söz dağarcığı hedefleriyle uyumludur.
İzle: Ultralytics ile Meta Segment Anything 3 Nasıl Kullanılır | Görüntü ve Videolarda Metin İstemli Segmentasyon
SAM 3, ultralytics paketine bütünüyle entegre edilmiştir ve metin istemleriyle, örnek görüntü istemleriyle kavram bölütleme ve video izleme için yerel destek sunar. Daha yeni SAM 3.1 kontrol noktası, görüntü tahmini için desteklenir.
Genel Bakış#
SAM 3, İstemlenebilir Kavram Bölütleme alanında mevcut sistemlere kıyasla 2 kat performans artışı sağlarken etkileşimli görsel bölütleme için SAM 2'nin yeteneklerini korur ve geliştirir. Model, açık söz dağarcıklı bölütlemede başarılıdır; kullanıcıların basit isim öbekleriyle (ör. "sarı okul otobüsü", "çizgili kedi") kavram belirtmesine veya hedef nesnenin örnek görüntülerini sunmasına olanak tanır. Ultralytics'te SAM 3, predict modunda çalışır ve izleme için özel video tahminleyicileri sunar.
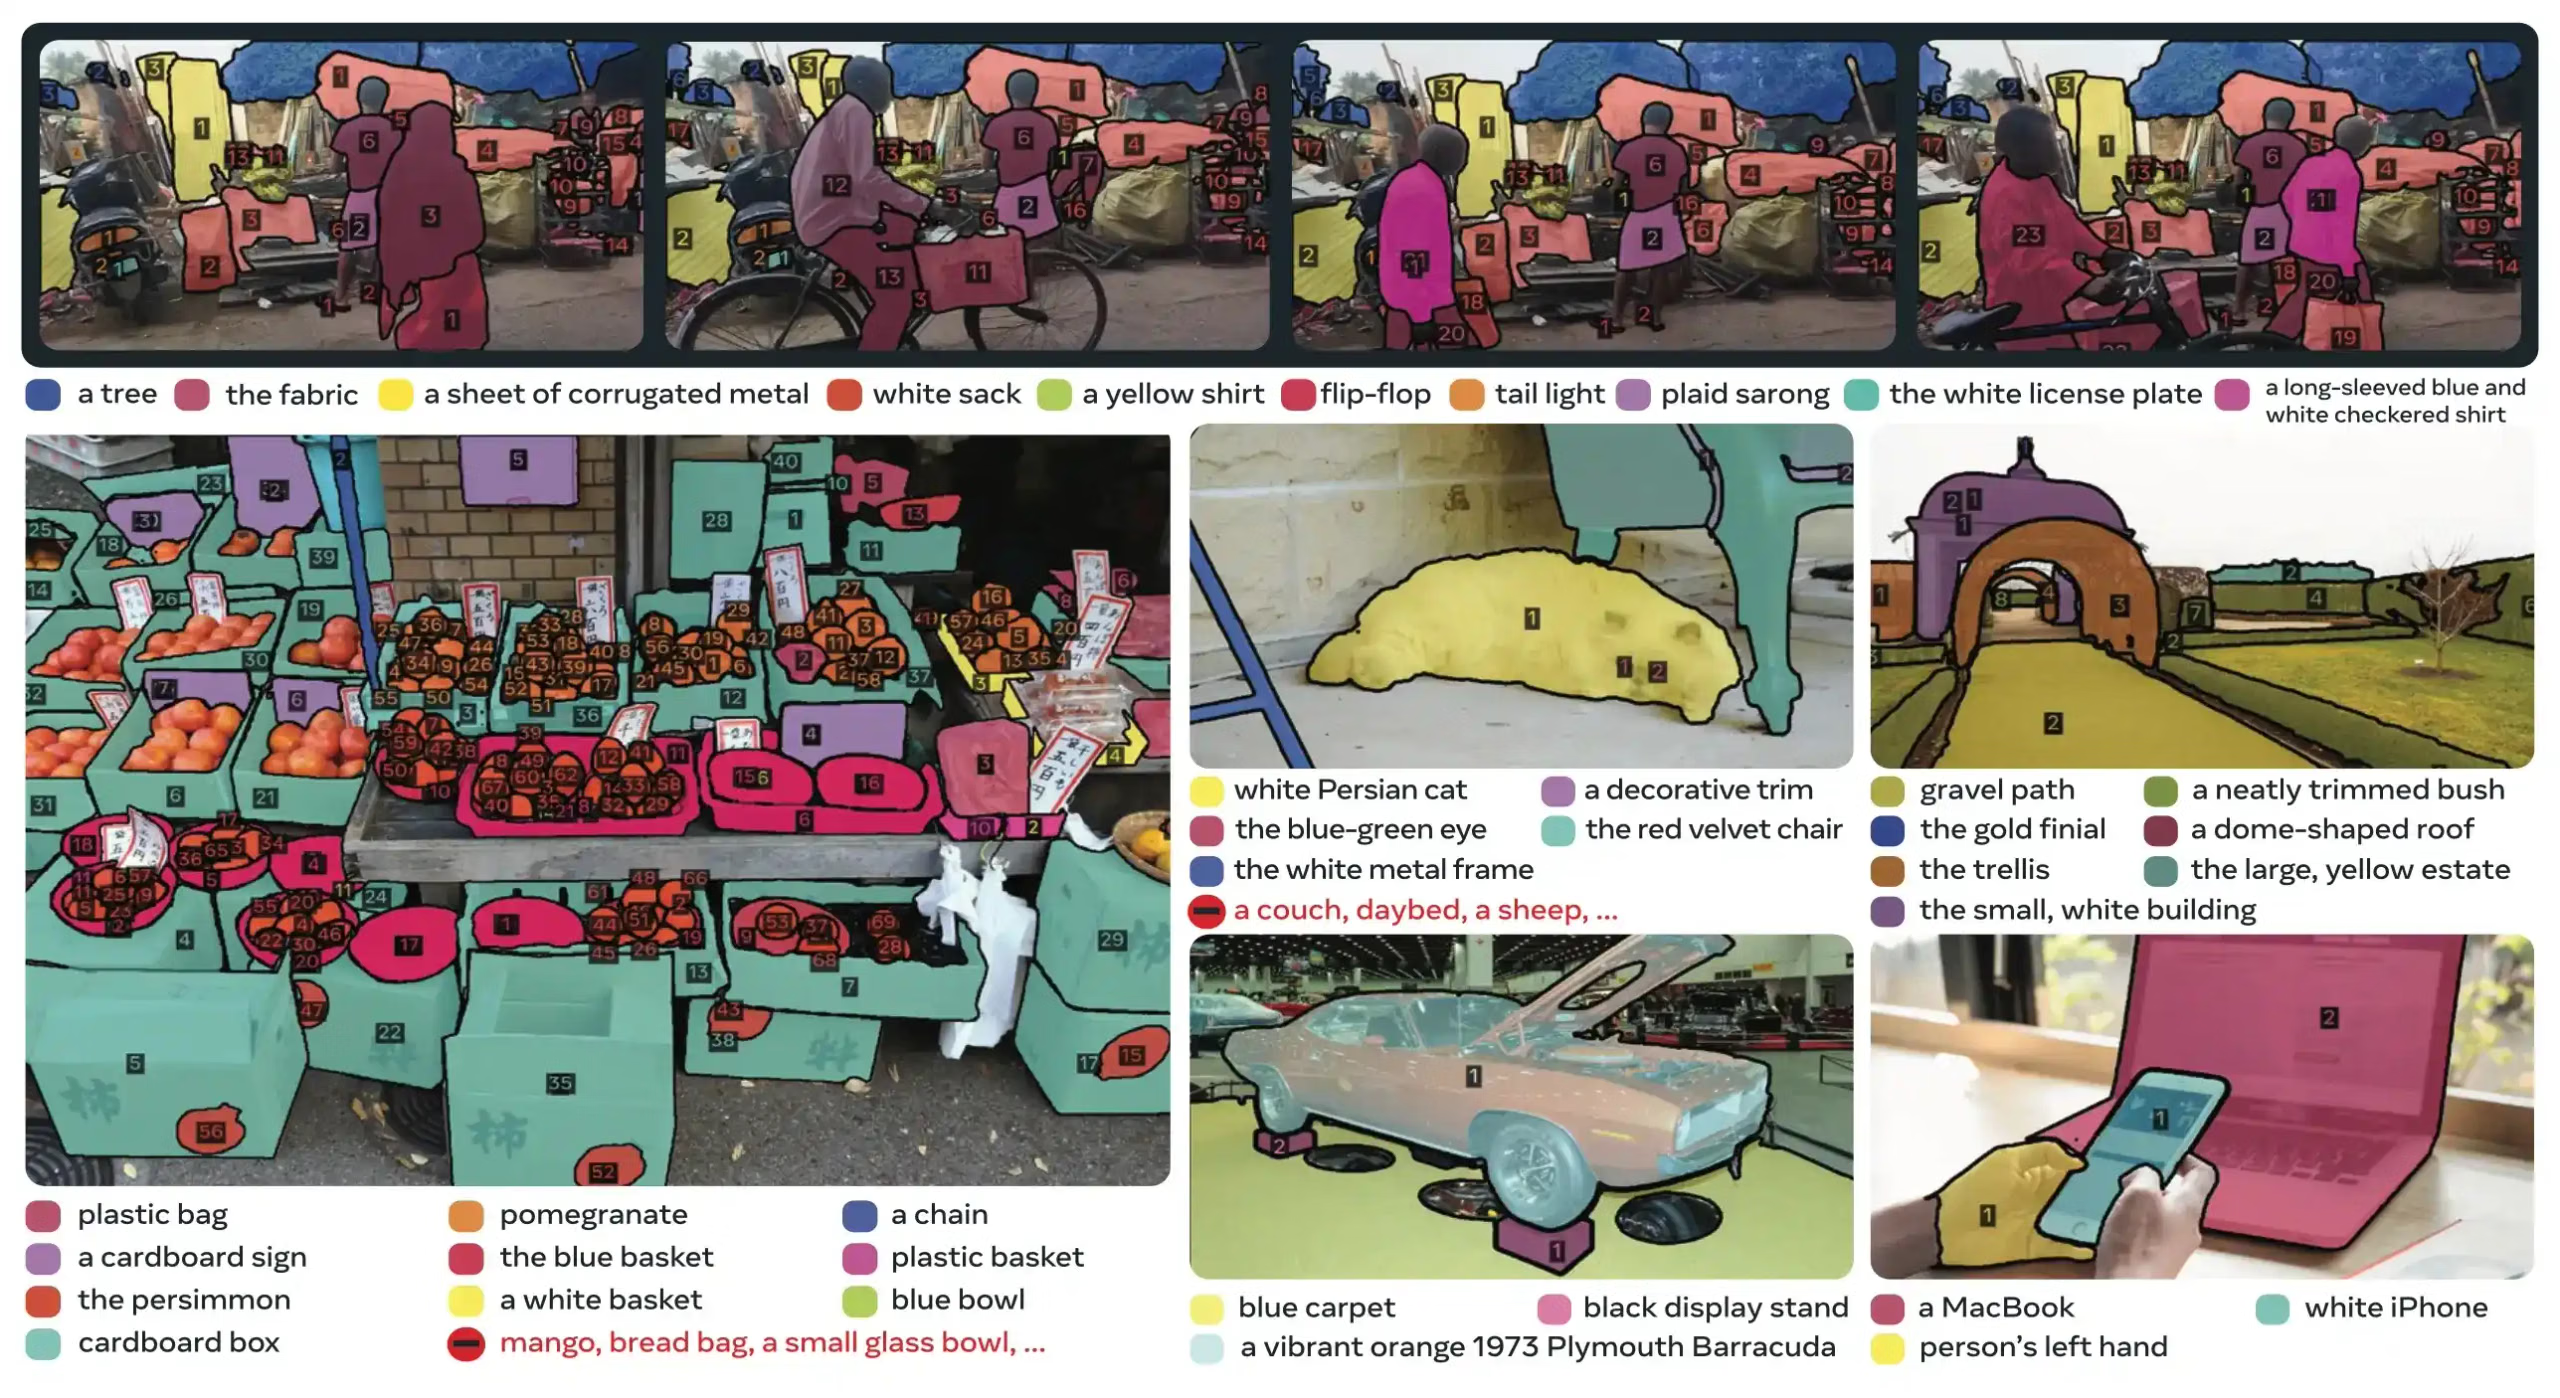
İstemle Yönlendirilebilir Kavram Bölütleme (PCS) nedir?#
PCS görevi, girdi olarak bir kavram istemi alır ve eşleşen tüm nesne örnekleri için benzersiz kimliklere sahip bölütleme maskeleri döndürür. Kavram istemleri şunlar olabilir:
- Metin: Sıfır örnekli öğrenmeye benzer şekilde, "red apple" veya "person wearing a hat" gibi basit isim öbekleri
- Örnek görüntüler: Hızlı genelleme için örnek nesnelerin çevresine çizilen sınırlayıcı kutular (olumlu veya olumsuz)
- Birleşik: Hassas denetim için hem metin hem de örnek görüntüler
Bu yaklaşım, özgün SAM ailesinin yaygınlaştırdığı ve yalnızca tek bir belirli nesne örneğini bölütleyen geleneksel görsel istemlerden (noktalar, kutular, maskeler) farklıdır.
Temel Performans Ölçütleri#
| Ölçüt | SAM 3 Başarımı |
|---|---|
| LVIS Sıfır Örnekli Maske AP | 47.0 (önceki en iyi 38.5'e kıyasla, %22 iyileşme) |
| SA-Co Kıyaslaması | Mevcut sistemlerden 2× daha iyi |
| Çıkarım Hızı (H200 GPU) | 100'den fazla algılanan nesneyle görüntü başına 30 ms |
| Video Performansı | ~5 eşzamanlı nesne için gerçek zamana yakın |
| MOSEv2 VOS Kıyaslaması | 60.1 J&F (SAM 2.1'e kıyasla +%25.5, önceki SOTA'ya kıyasla +%17) |
| Etkileşimli İyileştirme | 3 örnek isteminden sonra +18.6 CGF1 iyileşme |
| İnsan Performans Farkı | SA-Co/Gold için tahmin edilen alt sınırın %88'ine ulaşır |
Üretimdeki model ölçütleri ve ödünleşimler hakkında bağlam için model değerlendirme içgörülerine ve YOLO performans ölçütlerine bak.
SAM 3.1#
Meta'nın 27 Mart 2026'da yayımladığı SAM 3.1, çok nesneli video izleme için paylaşımlı bellek yaklaşımı olan Object Multiplex özelliğini ekleyen yeni bir SAM 3 kontrol noktasıdır. İzlenen her nesneyi ayrı ayrı işlemek yerine SAM 3.1, nesneleri sabit kapasiteli gruplara ayırıp birlikte işler. Meta, tek bir H100 GPU'da 128 nesne için ~7× hızlanma sağlandığını bildiriyor. Görüntü algılayıcısı ve etkileşimli nokta istemi başlığı SAM 3 mimarisini korur.
| Kıyaslama | Ölçüt | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (test) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (test) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (test) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (doğrulama) | J&F | 78.4 | 79.6 |
| DAVIS17 (doğrulama) | J&F | 92.2 | 92.7 |
| SA-V (test) | J&F | 84.4 | 85.1 |
| YTVOS19 (doğrulama) | G | 89.7 | 89.3 |
| MOSEv2 (doğrulama) | J&Ḟ | 60.3 | 62.3 |
Ultralytics, SAM 3.1 kontrol noktasını (sam3.1_multiplex.pt) SAM 3 görüntü tahmincilerine yükler: nokta ve kutu istemleri için SAM("sam3.1_multiplex.pt"), metin ve örnek istemleri için SAM3SemanticPredictor. Object Multiplex video izleme henüz desteklenmediğinden sam3.pt ile SAM3VideoPredictor ve SAM3VideoSemanticPredictor kullanmaya devam et.
Mimari#
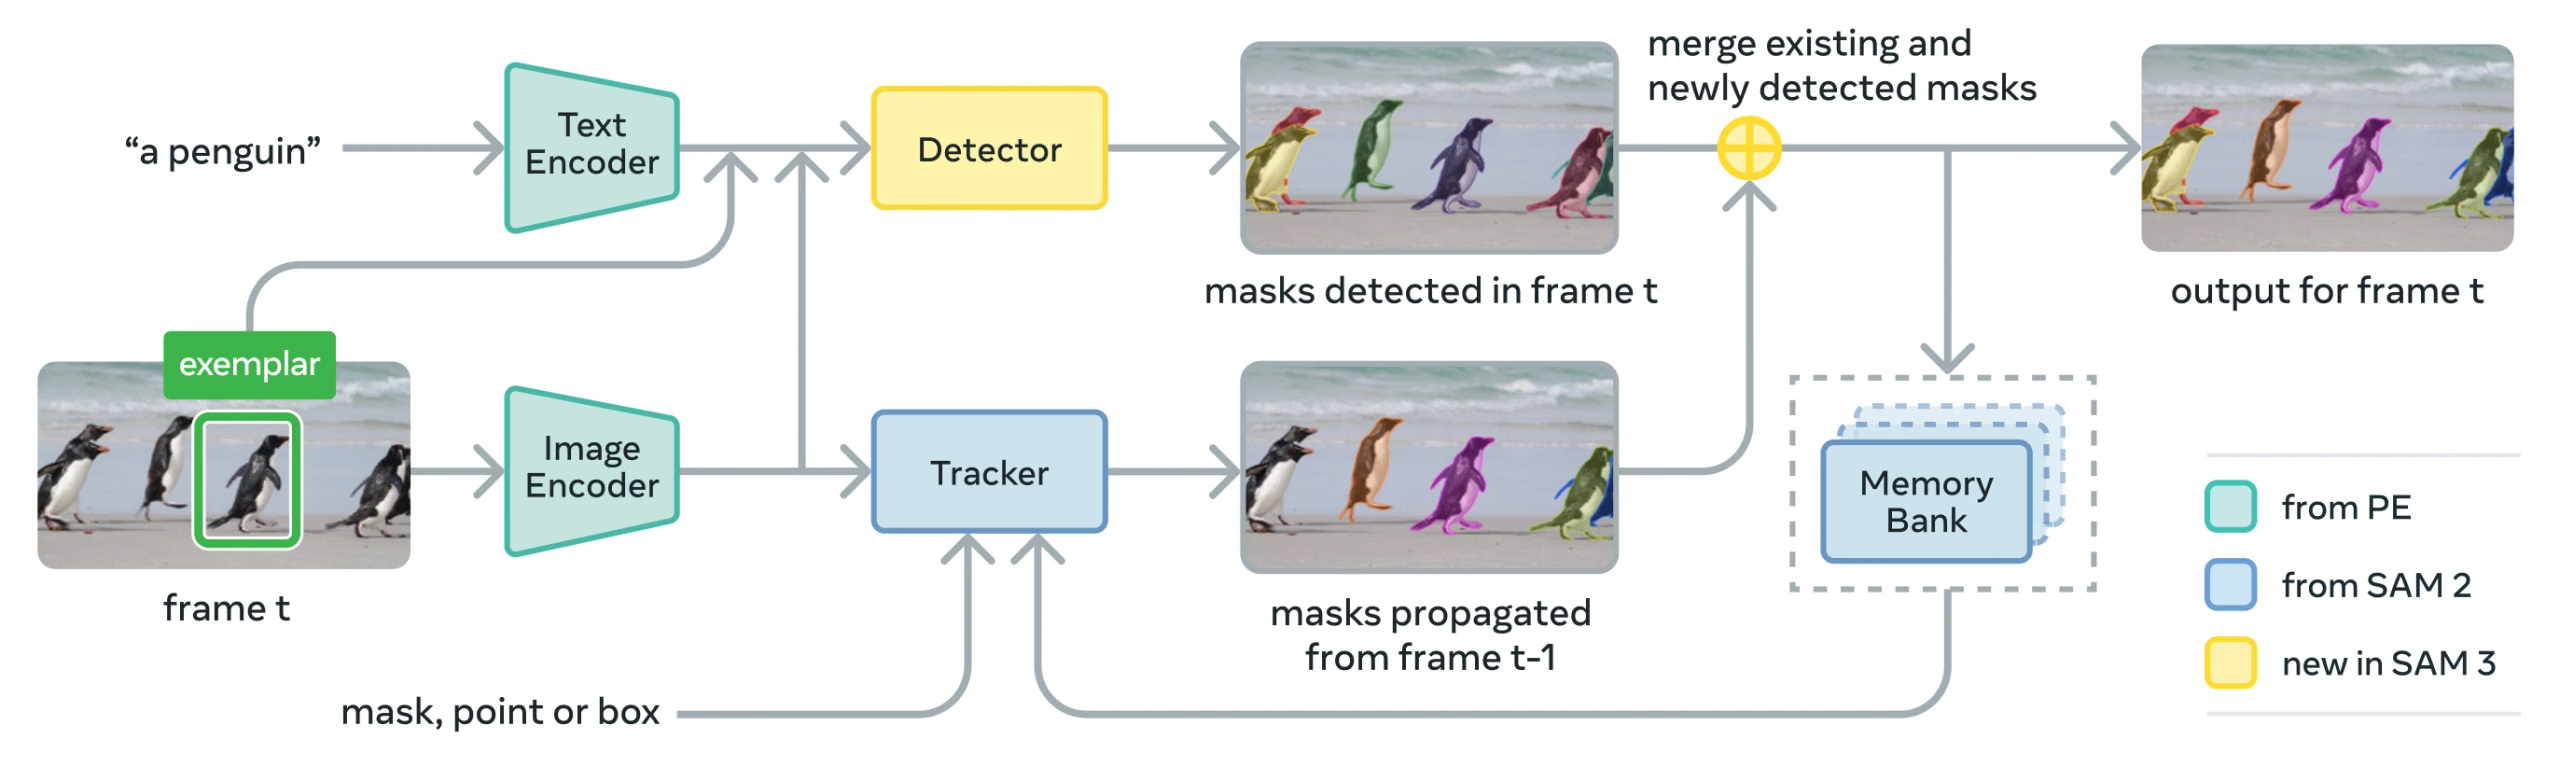
SAM 3, algılayıcı ve izleyici tarafından paylaşılan bir Perception Encoder (PE) görsel omurgasından oluşur. Bu ayrıştırılmış tasarım, görev çatışmalarını önlerken hem görüntü düzeyinde algılamaya hem de video düzeyinde izlemeye olanak tanır ve Ultralytics Python kullanımına ve CLI kullanımına uygun bir arayüz sunar.
Temel Bileşenler#
-
Algılayıcı: Görüntü düzeyinde kavram algılama için DETR tabanlı mimari
- İsim öbeği istemleri için metin kodlayıcı
- Görüntü tabanlı istemler için örnek kodlayıcı
- Görüntü özelliklerini istemlere göre koşullandıran birleştirme kodlayıcısı
- Tanımayı ("ne") konum belirlemeden ("nerede") ayıran yeni varlık başlığı
- Örnek bölütleme maskeleri oluşturan maske başlığı
-
İzleyici: SAM 2'den devralınan, belleğe dayalı video bölütleme
- İstem kodlayıcı, maske çözücü, bellek kodlayıcı
- Nesnelerin görünümünü kareler boyunca depolayan bellek bankası
-
Varlık Belirteci: Hedef kavramın görüntüde/karede bulunup bulunmadığını tahmin eden ve tanımayı konum belirlemeden ayırarak algılamayı iyileştiren, öğrenilmiş genel bir belirteç.
Temel Yenilikler#
- Ayrıştırılmış Tanıma ve Konum Belirleme: Varlık başlığı, kavramın varlığını genel düzeyde tahmin ederken öneri sorguları yalnızca konum belirlemeye odaklanır ve çelişen hedefleri önler.
- Birleşik Kavram ve Görsel İstemler: Tek bir modelde hem PCS'yi (kavram istemleri) hem de PVS'yi (SAM 2'nin tıklama ve kutu gibi görsel istemleri) destekler.
- Etkileşimli Örnek İyileştirme: Kullanıcılar sonuçları yinelemeli olarak iyileştirmek için pozitif veya negatif görüntü örnekleri ekleyebilir; model, yalnızca tek tek örnekleri düzeltmek yerine benzer nesnelere genelleme yapar.
- Zamansal Belirsizliği Giderme: Videodaki örtülmeleri, yoğun sahneleri ve izleme hatalarını ele almak için maskelet algılama puanlarından ve belirli aralıklarla istemleri yeniden vermekten yararlanır; örnek segmentasyonu ve izleme en iyi uygulamalarıyla uyumludur.
SA-Co Veri Kümesi#
SAM 3, bugüne kadarki en büyük ve en çeşitli segmentasyon veri kümesi olan Meta'nın Kavramlarla Her Şeyi Segmentle (SA-Co) veri kümesiyle eğitilmiştir; COCO ve LVIS gibi yaygın kıyaslama veri kümelerinin kapsamını genişletir.
Eğitim Verileri#
| Veri Kümesi Bileşeni | Açıklama | Ölçek |
|---|---|---|
| SA-Co/HQ | 4 aşamalı veri motoruyla oluşturulmuş, insanlar tarafından yüksek kalitede etiketlenmiş görüntü verileri | 5,2 milyon görüntü, 4 milyon benzersiz isim öbeği |
| SA-Co/SYN | İnsan müdahalesi olmadan yapay zekâ tarafından etiketlenmiş sentetik veri kümesi | 38 milyon isim öbeği, 1,4 milyar maske |
| SA-Co/EXT | Zor negatiflerle zenginleştirilmiş 15 harici veri kümesi | Kaynağa göre değişir |
| SA-Co/VIDEO | Zamansal izleme içeren video etiketleri | 52,5 bin video, 24,8 bin benzersiz isim öbeği |
Kıyaslama Verileri#
SA-Co değerlendirme kıyaslama veri kümesi, 126 bin görüntü ve videoda yer alan 214 bin benzersiz öbek içerir ve mevcut kıyaslama veri kümelerinden 50 kattan fazla kavram sunar. Şunları içerir:
- SA-Co/Gold: İnsan performansının sınırlarını ölçmek için üç kez etiketlenmiş 7 alan
- SA-Co/Silver: İnsanlar tarafından bir kez etiketlenmiş 10 alan
- SA-Co/Bronze ve SA-Co/Bio: Kavram segmentasyonuna uyarlanmış 9 mevcut veri kümesi
- SA-Co/VEval: 3 alan içeren video kıyaslama veri kümesi (SA-V, YT-Temporal-1B, SmartGlasses)
Veri Motoru Yenilikleri#
SAM 3'ün ölçeklenebilir, insan ve model döngüde veri motoru şu yöntemlerle 2 kat daha yüksek etiketleme verimliliği sağlar:
- Yapay Zekâ Etiketleyicileri: Llama tabanlı modeller, zor negatifler dahil olmak üzere çeşitli isim öbekleri önerir
- Yapay Zekâ Doğrulayıcıları: İnce ayarlı çok modlu LLM'ler, maske kalitesini ve kapsamlılığını insan performansına yakın düzeyde doğrular.
- Aktif Madencilik: İnsan emeğini, yapay zekânın zorlandığı güç hata örneklerine yönlendirir.
- Ontoloji Odaklı: Kavram kapsamı için Wikidata üzerine temellendirilmiş geniş bir ontoloji kullanır
Kurulum#
ultralytics paketini yükle veya yükselt:
pip install -U ultralyticsDiğer Ultralytics modellerinin aksine SAM 3 ağırlıkları (sam3.pt) otomatik olarak indirilmez. Önce Hugging Face'teki SAM 3 model sayfasından model ağırlıklarına erişim isteğinde bulunmalı ve isteğin onaylandıktan sonra sam3.pt dosyasını bu sayfadan indirmelisin. İndirilen sam3.pt dosyasını çalışma dizinine yerleştir veya modeli yüklerken tam yolu belirt.
SAM 3.1 ağırlıklarına (sam3.1_multiplex.pt) SAM 3.1 model sayfasında aynı şekilde erişim kısıtlaması uygulanır. Aşağıdaki görüntü örneklerinde sam3.pt kullanılan her yerde sam3.1_multiplex.pt değerini kullan.
Tahmin sırasında yukarıdaki hatayı alırsan yanlış clip paketinin yüklü olduğu anlamına gelir. Aşağıdaki komutu çalıştırarak doğru clip paketini yükle:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
SAM 3 Nasıl Kullanılır: Kavram Segmentasyonunda Çok Yönlülük#
SAM 3, farklı tahminci arayüzleriyle hem İstemlenebilir Kavram Segmentasyonu (PCS) hem de İstemlenebilir Görsel Segmentasyon (PVS) görevlerini destekler:
Desteklenen Görevler ve Modeller#
| Görev Türü | İstem Türleri | Çıktı |
|---|---|---|
| Kavram Segmentasyonu (PCS) | Metin (isim öbekleri), görüntü örnekleri | Kavramla eşleşen tüm örnekler |
| Görsel Segmentasyon (PVS) | Noktalar, kutular, maskeler | Tek bir nesne örneği (SAM 2 tarzı) |
| Etkileşimli İyileştirme | Örnekleri veya tıklamaları yinelemeli olarak ekle/kaldır | Daha yüksek doğrulukla iyileştirilmiş segmentasyon |
Kavram Segmentasyonu Örnekleri#
Metin İstemleriyle Segmentasyon#
Bir metin açıklaması kullanarak kavramın tüm örneklerini bul ve segmentlere ayır. Metin istemleri için SAM3SemanticPredictor arayüzü gerekir.
from ultralytics.models.sam import SAM3SemanticPredictor

# Yapılandırmayla tahminciyi başlat
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # Daha hızlı çıkarım için FP16 kullan
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Birden fazla sorgu için görüntüyü bir kez ayarla
predictor.set_image("path/to/image.jpg")

# Birden fazla metin istemiyle sorgula
results = predictor(text=["person", "bus", "glasses"])

# Betimleyici öbeklerle çalışır
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Tek bir kavramla sorgula
results = predictor(text=["a person"])
Görüntü Örnekleriyle Segmentasyon#
Benzer tüm örnekleri bulmak için görsel istem olarak sınırlayıcı kutuları kullan. Kavram tabanlı eşleştirme için de SAM3SemanticPredictor gerekir.
from ultralytics.models.sam import SAM3SemanticPredictor

# Tahminciyi başlat
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Görüntüyü ayarla
predictor.set_image("path/to/image.jpg")

# Benzer nesneleri segmentlere ayırmak için sınırlayıcı kutu örnekleri ver
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Aynı görsel kavramın örnekleri olarak birden fazla sınırlayıcı kutu kullan
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Verimlilik için Özellik Tabanlı Çıkarım#
Verimliliği artırmak için görüntü özelliklerini bir kez çıkar ve birden fazla segmentasyon sorgusunda yeniden kullan.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Tahmincileri başlat
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# İlk tahminciden özellikleri çıkar
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# İkinci tahminciyi ayarla ve özellikleri yeniden kullan
predictor2.setup_model()

# Metin istemiyle paylaşılan özellikleri kullanarak çıkarım yap
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Sınırlayıcı kutu istemiyle paylaşılan özellikleri kullanarak çıkarım yap
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Sonuçları görselleştir
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
Video Kavram Segmentasyonu#
Sınırlayıcı Kutularla Video Boyunca Kavramları İzleme#
Sınırlayıcı kutu istemleriyle nesne örneklerini video kareleri boyunca algıla ve izle.
from ultralytics.models.sam import SAM3VideoPredictor

# Video tahmincisini oluştur
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Nesneleri sınırlayıcı kutu istemleriyle izle
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Sonuçları işle ve görüntüle
for r in results:
    r.show()  # Segmentasyon maskesiyle kareyi görüntüle
Metin İstemleriyle Kavramları İzleme#
Metinde belirtilen kavramların tüm örneklerini video kareleri boyunca izle.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Anlamsal video tahmincisini başlat
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Kavramları metin istemleriyle izle
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# Sonuçları işle
for r in results:
    r.show()  # İzlenen nesnelerle kareyi görüntüle

# Alternatif: Sınırlayıcı kutu istemleriyle izle
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Pozitif etiketler
    stream=True,
)
Görsel İstemler (SAM 2 Uyumluluğu)#
SAM 3, tek nesne segmentasyonu için SAM 2'nin görsel istem özellikleriyle tam geriye dönük uyumluluğu korur:
Temel SAM arayüzü, SAM 2 ile tam olarak aynı şekilde çalışır ve yalnızca görsel istemlerle (noktalar, kutular veya maskeler) belirtilen belirli alanı segmente ayırır.
from ultralytics import SAM

model = SAM("sam3.pt")

# Tek nokta istemi - nesneyi belirli bir konumda segmentlere ayırır
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Birden çok nokta - tek bir nesneyi birden çok nokta ipucuyla segmentlere ayırır
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Kutu istemi - sınırlayıcı kutunun içindeki nesneyi segmentlere ayırır
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()
Görsel istemlerle (noktalar/kutular/maskeler) SAM("sam3.pt") kullanıldığında, tıpkı SAM 2'de olduğu gibi yalnızca o konumdaki belirli nesne segmentlere ayrılır. Bir kavramın tüm örneklerini segmentlere ayırmak için yukarıda gösterildiği gibi metin veya örnek istemleriyle SAM3SemanticPredictor kullan.
Performans Karşılaştırmaları#
Görüntü Segmentasyonu#
SAM 3, LVIS ve bölütleme için COCO gibi gerçek dünya veri kümelerinin de yer aldığı çeşitli kıyaslama testlerinde en gelişmiş sonuçlara ulaşır:
| Kıyaslama | Ölçüt | SAM 3 | Önceki En İyi | İyileşme |
|---|---|---|---|---|
| LVIS (sıfır atışlı) | Maske AP | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34,3 (OWLv2) | +89.5% |
| COCO (sıfır atışlı) | Kutu AP | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (semantik segmentasyon) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (semantik segmentasyon) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Hızlı denemeler için veri kümesi seçeneklerini Ultralytics veri kümelerinde keşfet.
Video Segmentasyonu Performansı#
SAM 3, DAVIS 2017 ve YouTube-VOS gibi video kıyaslamalarında SAM 2'ye ve önceki son teknoloji modellere kıyasla önemli iyileşmeler gösteriyor:
| Kıyaslama | Ölçüt | SAM 3 | SAM 2.1 L | İyileşme |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Az Örnekli Uyarlama#
SAM 3, yeni alanlara az sayıda örnekle uyum sağlar; bu, veri odaklı yapay zekâ iş akışları için önemlidir:
| Kıyaslama | 0 atışlı AP | 10 atışlı AP | Önceki En İyi (10 atışlı) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Etkileşimli İyileştirmenin Etkinliği#
SAM 3'ün örneklerle kavram tabanlı istemleri, görsel istemlerden çok daha hızlı yakınsar:
| Eklenen İstemler | CGF1 Puanı | Yalnızca Metne Göre Kazanç | PVS Temel Değerine Göre Kazanç |
|---|---|---|---|
| Yalnızca metin | 46.4 | temel değer | temel değer |
| +1 örnek | 57.6 | +11.2 | +6.7 |
| +2 örnek | 62.2 | +15.8 | +9.7 |
| +3 örnek | 65.0 | +18.6 | +11.2 |
| +4 örnek | 65.7 | +19.3 | +11.5 (doygunluk) |
Nesne Sayma Doğruluğu#
SAM 3, nesne sayma iş akışlarında sıkça gerektiği gibi tüm örnekleri segmentlere ayırarak doğru sayım sağlar:
| Kıyaslama | Doğruluk | MAE | En İyi MLLM'ye Göre |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
SAM 3 ve SAM 2 ile YOLO Karşılaştırması#
Burada SAM 3'ün yeteneklerini SAM 2 ve YOLO26 modelleriyle karşılaştırıyoruz:
| Yetenek | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Kavram Segmentasyonu | ✅ Metin/örneklerden tüm örnekler | ❌ Desteklenmiyor | ❌ Desteklenmiyor |
| Görsel Segmentasyon | ✅ Tek örnek (SAM 2 ile uyumlu) | ✅ Tek örnek | ✅ Tüm örnekler |
| Sıfır Atış Yeteneği | ✅ Açık kelime dağarcığı | ✅ Geometrik istemler | ❌ Kapalı küme |
| Etkileşimli İyileştirme | ✅ Örnekler + tıklamalar | ✅ Yalnızca tıklamalar | ❌ Desteklenmiyor |
| Video Takibi | ✅ Kimliklerle çoklu nesne | ✅ Çoklu nesne | ✅ Çoklu nesne |
| LVIS Maske AP (sıfır atışlı) | 47.0 | Uygulanamaz | Uygulanamaz |
| MOSEv2 J&F | 60.1 | 47.9 | Uygulanamaz |
| Hız (GPU, ms/görüntü) | 2921 | 857 | 8.4 |
| Model Boyutu | 3.45 GB | 162 MB (temel) | 6.4 MB |
Hız kıyaslaması NVIDIA RTX PRO 6000 üzerinde torch==2.9.1 ve ultralytics==8.4.19 ile yapıldı.
Önemli Çıkarımlar:
- SAM 3: Metin veya örnek istemleriyle bir kavramın tüm örneklerini bulmaya yönelik açık kelime dağarcıklı kavram segmentasyonu için en iyisi
- SAM 2: Geometrik istemlerle görüntü ve videolarda tek nesnenin etkileşimli segmentasyonu için en iyisi
- YOLO26: İsteğe bağlı NMS içermeyen uçtan uca çıkarımla gerçek zamanlı, yüksek hızlı segmentasyon için en iyisi; GPU'lara, CPU'lara ve uç cihazlara dağıtım için birçok biçime aktarılabilir
- YOLOE: Metin veya görsel istemleriyle gerçek zamanlı açık kelime dağarcıklı tespit ve segmentasyon için en iyisi
SAM ve YOLO Karşılaştırması#
Boyut, parametre sayısı ve GPU çıkarım hızı açısından SAM 3, SAM 2, SAM, MobileSAM ve FastSAM modellerini Ultralytics YOLO segmentasyon modelleriyle (YOLOv8, YOLO11, YOLO26) karşılaştırma:
| Model | Boyut (MB) | Parametreler (M) | Hız (GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s ve YOLOv8 omurgası | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (515 kat daha küçük) | 3.4 (139.1 kat daha az) | 17.4 (167 kat daha hızlı) |
| Ultralytics YOLO11n-seg | 5.9 (585 kat daha küçük) | 2.9 (163.1 kat daha az) | 12.6 (231 kat daha hızlı) |
| Ultralytics YOLO26n-seg | 6.4 (539 kat daha küçük) | 2.7 (175.2 kat daha az) | 8.4 (347 kat daha hızlı) |
Bu karşılaştırma, SAM varyantları ile YOLO segmentasyon modelleri arasındaki model boyutu ve hız farklarının ne kadar büyük olduğunu gösteriyor. SAM, kendine özgü otomatik segmentasyon yetenekleri sunarken YOLO modelleri, özellikle YOLOv8n-seg, YOLO11n-seg ve YOLO26n-seg, önemli ölçüde daha küçük, daha hızlı ve hesaplama açısından daha verimlidir.
Testler, 96 GB VRAM'e sahip NVIDIA RTX PRO 6000 üzerinde torch==2.9.1 ve ultralytics==8.4.19 kullanılarak çalıştırıldı. Bu testi yeniden oluşturmak için:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM profili oluştur
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# FastSAM-s profili oluştur
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# YOLO modellerinin profilini oluştur
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # YOLO26 NMS içermeyen başlık; YOLOv8/YOLO11 için işlem yapmaz
Değerlendirme Metrikleri#
SAM 3, PCS görevi için tasarlanmış yeni metrikler sunarak F1 puanı, kesinlik ve duyarlılık gibi bilinen ölçütleri tamamlıyor.
Sınıflandırma Kontrollü F1 (CGF1)#
Yerelleştirme ile sınıflandırmayı birleştiren temel metrik:
CGF1 = 100 × pmF1 × IL_MCC
Burada:
- pmF1 (Pozitif Makro F1): Pozitif örneklerdeki yerelleştirme kalitesini ölçer
- IL_MCC (Görüntü Düzeyinde Matthews Korelasyon Katsayısı): İkili sınıflandırma doğruluğunu ("kavram mevcut mu?") ölçer
Bu Metrikler Neden Kullanılıyor?#
Geleneksel AP ölçümleri kalibrasyonu hesaba katmadığından modelleri pratikte kullanmak zorlaşır. Yalnızca güven puanı 0,5'in üzerindeki tahminleri değerlendirerek SAM 3'ün ölçümleri, iyi kalibrasyonu zorunlu kılar ve etkileşimli tahmin ve izleme döngülerindeki gerçek dünya kullanım örüntülerini taklit eder.
Temel Ablasyonlar ve İçgörüler#
Varlık Başlığının Etkisi#
Varlık başlığı, tanımayı yerelleştirmeden ayırarak önemli iyileştirmeler sağlar:
| Yapılandırma | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Varlık başlığı olmadan | 57.6 | 0.77 | 74.7 |
| Varlık başlığıyla | 63.3 | 0.82 | 77.1 |
Varlık başlığı, başlıca tanıma becerisini iyileştirerek +5.7 CGF1 artışı (+%9.9) sağlar (IL_MCC +%6.5).
Zor Negatiflerin Etkisi#
| Görüntü Başına Zor Negatif Sayısı | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Zor negatifler açık kelime dağarcıklı tanıma için kritik önem taşır ve IL_MCC'yi %54.5 (0.44 → 0.68) artırır.
Eğitim Verisinin Ölçeklendirilmesi#
| Veri Kaynakları | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Yalnızca harici | 30.9 | 0.46 | 66.3 |
| Harici + Sentetik | 39.7 | 0.57 | 70.6 |
| Harici + Yüksek Kaliteli | 51.8 | 0.71 | 73.2 |
| Üçü Birden | 54.3 | 0.74 | 73.5 |
Yüksek kaliteli insan açıklamaları, yalnızca sentetik veya harici veriye kıyasla büyük kazanımlar sağlar. Veri kalitesi uygulamalarının arka planı için veri toplama ve açıklama ekleme sayfasına bak.
Uygulamalar#
SAM 3'ün kavram segmentasyonu yeteneği yeni kullanım alanları sağlar:
- İçerik Moderasyonu: Medya arşivlerindeki belirli içerik türlerinin tüm örneklerini bul
- E-ticaret: Katalog görüntülerindeki belirli türdeki tüm ürünleri segmentlere ayırarak otomatik açıklama eklemeyi destekle
- Tıbbi Görüntüleme: Belirli doku türlerinin veya anormalliklerin tüm örneklerini belirleme
- Otonom Sistemler: Trafik işaretleri, yayalar veya araçların tüm örneklerini kategorilerine göre izle
- Video Analitiği: Belirli kıyafetleri giyen veya belirli eylemleri gerçekleştiren tüm kişileri say ve izle
- Veri Kümesi Açıklaması: Nadir nesne kategorilerinin tüm örneklerine hızla açıklama ekle
- Bilimsel Araştırma: Belirli ölçütlere uyan tüm örnekleri ölç ve analiz et
SAM 3 Agent: Genişletilmiş Dilsel Akıl Yürütme#
SAM 3, akıl yürütme gerektiren karmaşık sorguları işlemek için, OWLv2 ve T-Rex gibi açık kelime dağarcıklı sistemlere benzer şekilde Çok Modlu Büyük Dil Modelleri (MLLMs) ile birleştirilebilir.
Akıl Yürütme Görevlerindeki Performans#
| Kıyaslama | Ölçüt | SAM 3 Agent (Gemini 2.5 Pro) | Önceki En İyi |
|---|---|---|---|
| ReasonSeg (doğrulama) | gIoU | 76.0 | 65.0 (son teknoloji) |
| ReasonSeg (test) | gIoU | 73.8 | 61.3 (son teknoloji) |
| OmniLabel (doğrulama) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Doğruluk | 91.2 | 89.3 (LISA) |
Karmaşık Sorgu Örnekleri#
SAM 3 Agent, akıl yürütme gerektiren sorguları işleyebilir:
- "Oturmuş ancak ellerinde hediye kutusu tutmayan kişiler"
- "Kameraya en yakın, tasma takmayan köpek"
- "Kişinin elinden daha büyük kırmızı nesneler"
MLLM, SAM 3'e basit isim tamlaması sorguları önerir, döndürülen maskeleri analiz eder ve sonuçtan memnun kalana kadar yineler.
Sınırlamalar#
SAM 3'ün şu sınırlamaları vardır:
- İfade Karmaşıklığı: Basit isim tamlamaları için en uygunudur; uzun gönderim ifadeleri veya karmaşık akıl yürütme MLLM entegrasyonu gerektirebilir
- Belirsizlikleri Ele Alma: Bazı kavramlar doğası gereği belirsiz kalır (ör. "küçük pencere", "rahat oda")
- Hesaplama Gereksinimleri: YOLO gibi uzmanlaşmış tespit modellerinden daha büyük ve daha yavaştır
- Kelime Dağarcığı Kapsamı: Atomik görsel kavramlara odaklanır; MLLM desteği olmadan bileşimsel akıl yürütme sınırlıdır
- Nadir Kavramlar: Eğitim verisinde iyi temsil edilmeyen son derece nadir veya ince ayrıntılı kavramlarda performans düşebilir
Atıf#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
Sık Sorulan Sorular#
SAM 3, Meta tarafından 19 Kasım 2025 tarihinde yayımlandı ve
ultralyticspaketine tamamen entegre edildi; özel tahminleyiciler aracılığıyla görüntü tahmini ve video izleme desteği sunar.Evet. SAM 3, kavram bölütleme, SAM 2 tarzı görsel istemler ve çok nesneli video izleme dahil Ultralytics Python paketine tamamen entegre edilmiştir. SAM 3 ve SAM 3.1, Ultralytics Platform üzerindeki akıllı etiketleme özelliğine de güç verir; burada varsayılan model SAM 3.1'dir ve görüntüleri yalnızca birkaç tıklamayla etiketleyebilirsin. 1–200 sınıflı tespit veri kümelerinde SAM 3 Text ve SAM 3.1 Text de sınıf adlarından otomatik etiketleme yapar; VLM Sıralama Tablosu ise doğruluklarını görsel dil modelleriyle karşılaştırır.
Evet, görüntü tahmini için destekliyor. Bu sayfadaki görüntü örneklerinde
sam3.ptkullanılan her yerdesam3.1_multiplex.ptyükle: nokta ve kutu istemleri içinSAM("sam3.1_multiplex.pt"), metin ve örnek istemleri içinSAM3SemanticPredictor. Nesne Çoklama video izleme henüz desteklenmiyor; bu nedenle video tahmincileriylesam3.ptkullanmaya devam et. Meta'nın kıyaslamaları için SAM 3.1 sayfasına bak.PCS, SAM 3'te sunulan ve bir görüntü veya videodaki görsel bir kavramın tüm örneklerini segmentlere ayıran yeni bir görevdir. Belirli bir nesne örneğini hedefleyen geleneksel segmentasyonun aksine PCS, bir kategorinin her örneğini bulur. Örneğin:
- Metin istemi: "sarı okul otobüsü" → sahnedeki tüm sarı okul otobüslerini segmentlere ayırır
- Görsel örneği: Bir köpeğin etrafına kutu çiz → görseldeki tüm köpekleri segmentlere ayırır
- Birleşik: "çizgili kedi" + örnek kutusu → örneğe uyan tüm çizgili kedileri segmentlere ayırır
Özellik SAM 2 SAM 3 Görev İstem başına tek nesne Bir kavramın tüm örnekleri İstem Türleri Noktalar, kutular, maskeler + Metin ifadeleri, görsel örnekleri Algılama Yeteneği Harici algılayıcı gerektirir Yerleşik açık kelime dağarcıklı algılayıcı Tanıma Yalnızca geometriye dayalı Metin ve görsel tanıma Mimari Yalnızca izleyici Varlık başlığına sahip algılayıcı + izleyici Sıfır Örnekli Performans Uygulanamaz (görsel istemler gerektirir) LVIS'te 47.0 AP, SA-Co'da 2× daha iyi Etkileşimli İyileştirme Yalnızca tıklamalar Tıklamalar + örnek genellemesi SAM 3, kavram tabanlı yetenekler eklerken SAM 2 görsel istemleriyle geriye dönük uyumluluğu korur.
SAM 3, Segment Anything with Concepts (SA-Co) veri kümesiyle eğitilir:
Eğitim Verileri:
- 5.2M görsel ve 4M benzersiz isim öbeği (SA-Co/HQ) - yüksek kaliteli insan anotasyonları
- 52.5K video ve 24.8K benzersiz isim öbeği (SA-Co/VIDEO)
- 38M isim öbeği genelinde 1.4B sentetik maske (SA-Co/SYN)
- Zor negatif örneklerle zenginleştirilmiş 15 harici veri kümesi (SA-Co/EXT)
Kıyaslama Verileri:
- 126K görsel/video genelinde 214K benzersiz kavram
- Mevcut kıyaslamalardan 50× daha fazla kavram (ör. LVIS'te ~4K kavram var)
- İnsan performansının sınırlarını ölçmek için SA-Co/Gold üzerinde üçlü anotasyon
Bu ölçek ve çeşitlilik, SAM 3'ün açık söz dağarcıklı kavramlarda sıfır örnekli genelleme yapmasını sağlar.
SAM 3 ve YOLO26 farklı kullanım alanlarına hitap eder:
SAM 3'ün Avantajları:
- Açık kelime dağarcıklı: Eğitim gerektirmeden metin istemleriyle her kavramı segmentlere ayırır
- Sıfır örnekli: Yeni kategorilerde hemen çalışır
- Etkileşimli: Örnek tabanlı iyileştirme, benzer nesnelere genellenir
- Kavram tabanlı: Bir kategorinin tüm örneklerini otomatik olarak bulur
- Doğruluk: LVIS sıfır örnekli örnek segmentasyonunda 47.0 AP
YOLO26'nın Avantajları:
- Hız: İsteğe bağlı, NMS gerektirmeyen uçtan uca bir başlıkla çıkarım çok daha hızlıdır
- Verimlilik: 539× daha küçük modeller (6.4MB'ye karşı 3.45GB)
- Kaynak dostu: Uç cihazlarda ve mobil cihazlarda çalışır
- Gerçek zamanlı: Üretim ortamlarında kullanıma göre optimize edilmiştir
Öneri:
- Metinle veya örneklerle tanımlanan kavramların tüm örneklerini bulman gereken esnek, açık kelime dağarcıklı segmentasyon için SAM 3'ü kullan
- Kategorilerin önceden bilindiği yüksek hızlı üretim ortamları için YOLO26'yı kullan
- Geometrik istemlerle etkileşimli, tek nesne segmentasyonu için SAM 2'yi kullan
SAM 3, basit isim öbekleri için tasarlanmıştır (ör. "kırmızı elma", "şapka takan kişi"). Akıl yürütme gerektiren karmaşık sorgular için SAM 3'ü bir MLLM ile SAM 3 Agent olarak birlikte kullan:
Basit sorgular (yerel SAM 3):
- "sarı okul otobüsü"
- "çizgili kedi"
- "kırmızı şapka takan kişi"
Karmaşık sorgular (MLLM ile SAM 3 Agent):
- "Hediye kutusu tutmayan, oturmuş kişiler"
- "Tasması olmayan, kameraya en yakın köpek"
- "Kişinin elinden daha büyük kırmızı nesneler"
SAM 3 Agent, SAM 3'ün segmentasyonunu MLLM akıl yürütme yetenekleriyle birleştirerek ReasonSeg doğrulama kümesinde 76.0 gIoU elde eder (önceki en iyi 65.0 değerine kıyasla %16.9 iyileşme).
Üçlü insan anotasyonuna sahip SA-Co/Gold kıyaslamasında:
- İnsan performansının alt sınırı: 74.2 CGF1 (en ihtiyatlı anotatör)
- SAM 3 performansı: 65.0 CGF1
- Başarı: Tahmini insan performansı alt sınırının %88'i
- İnsan performansının üst sınırı: 81.4 CGF1 (en hoşgörülü anotatör)
SAM 3, açık kelime dağarcıklı kavram segmentasyonunda insan düzeyindeki doğruluğa yaklaşan güçlü bir performans sergiler; aradaki fark esas olarak belirsiz veya öznel kavramlarda (ör. "küçük pencere", "rahat oda") görülür.


Yorumlar105
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
 Glenn JocherUltralytics(düzenlendi)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(düzenlendi)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(düzenlendi)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(düzenlendi)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(düzenlendi)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.