Cách kiểm thử các model thị giác máy tính#
Giới thiệu#
Kiểm thử model kiểm tra hiệu suất của một model đã được huấn luyện trên dữ liệu thực tế chưa từng thấy — các đối tượng đang chuyển động, thiếu sáng hoặc bị che khuất một phần, thay vì một benchmark được tuyển chọn. Trong khi đánh giá model đo lường các chỉ số trên một dataset được gắn nhãn, kiểm thử xác minh rằng hành vi model đã học phù hợp với mục tiêu của ứng dụng trước khi triển khai. Hướng dẫn này trình bày cách chuẩn bị dữ liệu kiểm thử, kiểm thử các model Ultralytics YOLO26 và phát hiện overfitting, underfitting cũng như rò rỉ dữ liệu.
Watch: How to Test Machine Learning Models | Avoid Data Leakage in Computer Vision 🚀
Kiểm thử model và đánh giá model#
Kiểm thử model và đánh giá model là hai bước riêng biệt trong một dự án thị giác máy tính. Đánh giá đo lường hiệu suất bằng các chỉ số trên một dataset được gắn nhãn; kiểm thử xác minh liệu hành vi model đã học có được duy trì trong các điều kiện tương tự môi trường triển khai hay không.
Giả sử bạn đã huấn luyện một model thị giác máy tính để nhận diện mèo và chó, đồng thời muốn triển khai model này tại một cửa hàng thú cưng để theo dõi các con vật. Trong giai đoạn đánh giá model, bạn sử dụng một dataset được gắn nhãn để tính các chỉ số như accuracy, precision và recall. Chẳng hạn, model có thể đạt accuracy 98% trong việc phân biệt mèo và chó trên một dataset nhất định.
Sau khi đánh giá, bạn kiểm thử model bằng hình ảnh từ một cửa hàng thú cưng để xem model nhận diện mèo và chó tốt đến đâu trong các điều kiện đa dạng và thực tế hơn. Bạn kiểm tra xem model có thể gắn nhãn chính xác cho mèo và chó khi chúng đang di chuyển, trong các điều kiện ánh sáng khác nhau hoặc bị che khuất một phần bởi những vật như đồ chơi hay đồ nội thất hay không. Kiểm thử model xác minh rằng model hoạt động như kỳ vọng bên ngoài môi trường đánh giá được kiểm soát.
Chuẩn bị kiểm thử model#
Các dataset thị giác máy tính thường được chia thành tập huấn luyện và tập kiểm thử để mô phỏng các điều kiện thực tế: dữ liệu huấn luyện giúp model học, còn dữ liệu kiểm thử xác minh hành vi của model trên những ví dụ model chưa từng thấy. Ultralytics Platform tập trung việc tổ chức dataset và gắn annotation tại một nơi, hỗ trợ xây dựng một tập kiểm thử được gắn nhãn.
- Tính đại diện thực tế: Dữ liệu kiểm thử chưa từng thấy nên tương tự dữ liệu mà model sẽ xử lý khi được triển khai. Điều này cung cấp bức tranh thực tế về khả năng của model.
- Kích thước đầy đủ: Dataset kiểm thử cần đủ lớn để cung cấp thông tin đáng tin cậy về hiệu suất của model.
Cách kiểm thử model YOLO26#
Kiểm thử một model YOLO26 đã huấn luyện gồm hai workflow bổ trợ cho nhau: validation trên một phần kiểm thử được gắn nhãn để thu được các chỉ số định lượng và prediction trên các hình ảnh mới để kiểm tra hành vi theo cách định tính.
Validation trên phần kiểm thử được gắn nhãn#
Chế độ validation so sánh các prediction của model với nhãn ground truth và báo cáo precision, recall, mAP50 và mAP50-95 cho các model detection. Chế độ này cũng lưu các công cụ trực quan như confusion matrix và đường cong precision-recall, giúp bạn phát hiện những khu vực cụ thể mà model có thể hoạt động chưa tốt.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Validate; add split="test" if your dataset YAML defines a test split
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
Theo mặc định, validation chạy trên phần val của dataset. Để đo hiệu suất trên một tập kiểm thử được giữ riêng, hãy định nghĩa phần test: trong YAML của dataset và truyền split="test".
Prediction trên hình ảnh mới#
Chế độ prediction chạy model trên dữ liệu mới, chưa từng thấy mà không yêu cầu nhãn. Chế độ này không tạo ra các chỉ số hiệu suất, nhưng việc lưu các output có annotation cho phép bạn xem xét cách model hoạt động trên hình ảnh thực tế — chẳng hạn như xử lý toàn bộ một thư mục hình ảnh kiểm thử trong một lần.
from ultralytics import YOLO

# Load a pretrained model or your own trained checkpoint, e.g. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Run predictions on a folder of test images and save annotated results
results = model.predict(source="path/to/test_images", save=True)Để kiểm tra liệu YOLO26 có phù hợp với ứng dụng của bạn trước khi đầu tư vào huấn luyện tùy chỉnh hay không, hãy chạy chế độ prediction với một checkpoint pretrained trên các hình ảnh của riêng bạn. Các model được pretrained trên những dataset như COCO, vì vậy kết quả cung cấp đánh giá nhanh về mức độ model có thể hoạt động tốt trong ngữ cảnh cụ thể của bạn.
Chế độ validation và prediction#
| Chế độ | Mục đích | Yêu cầu nhãn | Đầu ra |
|---|---|---|---|
| Validation | Định lượng hiệu suất so với ground truth | Có | Precision, recall, mAP50, mAP50-95, confusion matrix, các đường cong PR |
| Prediction | Kiểm tra hành vi của model trên dữ liệu mới, chưa được gắn nhãn | Không | Hình ảnh có annotation và kết quả prediction, không có các chỉ số |
Cách phân tích kết quả kiểm thử#
Khi đã có prediction và các chỉ số, hãy đi sâu vào những điểm model thất bại và nguyên nhân:
- Hình ảnh bị phân loại sai: Xác định và xem xét các hình ảnh mà model phân loại sai để hiểu model đang gặp lỗi ở đâu.
- Phân tích lỗi: Thực hiện phân tích lỗi kỹ lưỡng để hiểu các loại lỗi (ví dụ: false positive so với false negative) và nguyên nhân tiềm ẩn của chúng.
- Bias và tính công bằng: Kiểm tra các bias trong prediction của model. Đảm bảo model hoạt động tốt như nhau trên các tập con dữ liệu khác nhau, đặc biệt khi dữ liệu bao gồm các thuộc tính nhạy cảm như chủng tộc, giới tính hoặc độ tuổi.
Overfitting và underfitting trong machine learning#
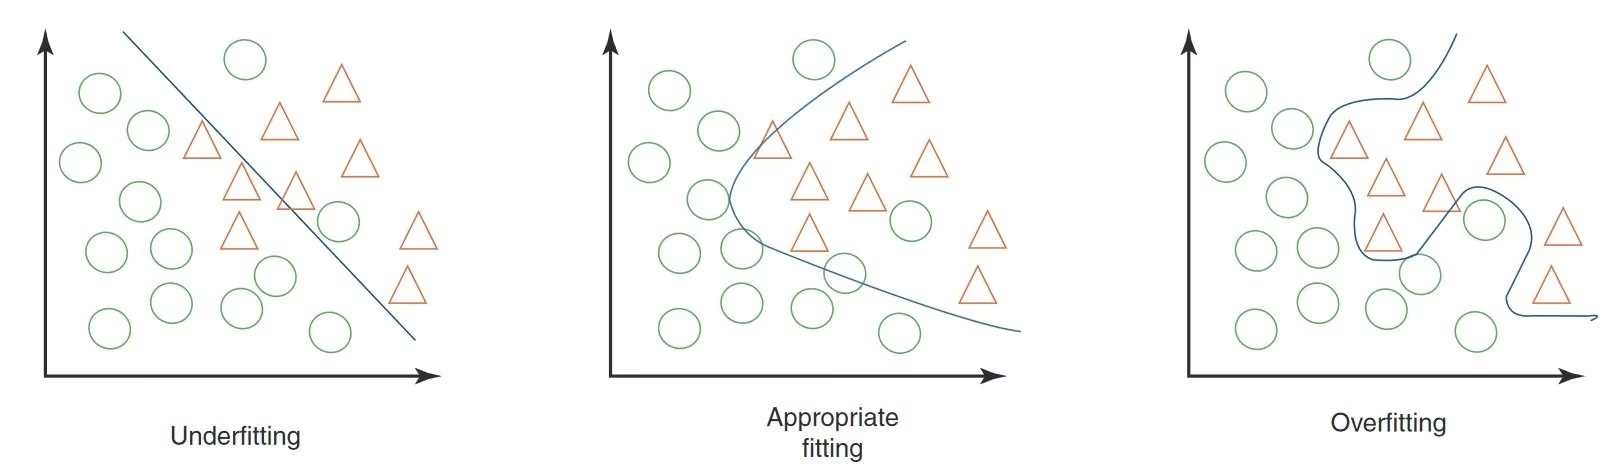
Khi kiểm thử một model machine learning, đặc biệt trong thị giác máy tính, điều quan trọng là phải theo dõi hiện tượng overfitting và underfitting. Các vấn đề này có thể ảnh hưởng đáng kể đến khả năng hoạt động của model trên dữ liệu mới.
| Vấn đề | Dấu hiệu thường gặp | Cách xử lý |
|---|---|---|
| Overfitting | Accuracy trên tập huấn luyện cao nhưng accuracy trên tập validation thấp; quá nhạy với những thay đổi nhỏ hoặc các chi tiết không liên quan trong hình ảnh | Áp dụng regularization như dropout, tăng kích thước dataset huấn luyện, đơn giản hóa kiến trúc model |
| Underfitting | Accuracy thấp ngay cả trên tập huấn luyện; liên tục không nhận diện được các đặc trưng hoặc đối tượng rõ ràng | Sử dụng model phức tạp hơn, cung cấp nhiều đặc trưng phù hợp hơn, tăng số epoch huấn luyện |
Điều quan trọng là tìm được sự cân bằng để model hoạt động tốt trên cả dataset huấn luyện và validation. Thường xuyên theo dõi các chỉ số và kiểm tra trực quan prediction trong quá trình kiểm thử giúp bạn phát hiện model đang lệch về một trong hai thái cực.
Rò rỉ dữ liệu trong thị giác máy tính và cách phòng tránh#
Rò rỉ dữ liệu xảy ra khi thông tin bên ngoài dataset huấn luyện vô tình được sử dụng để huấn luyện model. Model có thể có vẻ rất chính xác trong quá trình huấn luyện, nhưng sẽ không hoạt động tốt trên dữ liệu mới, chưa từng thấy khi xảy ra rò rỉ dữ liệu.
Rò rỉ có thể khó phát hiện và thường bắt nguồn từ các bias ẩn trong dữ liệu huấn luyện:
| Loại bias | Biểu hiện |
|---|---|
| Bias camera | Các góc chụp, điều kiện ánh sáng, bóng đổ và chuyển động camera khác nhau tạo ra những pattern không mong muốn |
| Bias overlay | Logo, timestamp hoặc các overlay khác trong hình ảnh khiến model bị đánh lạc hướng |
| Bias font và đối tượng | Các font hoặc đối tượng cụ thể thường xuyên xuất hiện trong một số class nhất định làm sai lệch quá trình học của model |
| Bias không gian | Sự mất cân bằng giữa tiền cảnh và hậu cảnh, phân bố bounding box và vị trí đối tượng ảnh hưởng đến quá trình huấn luyện |
| Bias nhãn và miền dữ liệu | Nhãn không chính xác hoặc sự dịch chuyển giữa các loại dữ liệu dẫn đến rò rỉ |
Cách phát hiện và phòng tránh rò rỉ dữ liệu#
Để phát hiện rò rỉ dữ liệu, hãy kiểm tra xem kết quả của model có tốt một cách bất ngờ hay không, xem liệu một feature có quan trọng hơn nhiều so với các feature khác không, kiểm tra lại xem các quyết định của model có hợp lý về mặt trực giác không, và xác minh rằng dữ liệu đã được chia đúng cách trước mọi bước xử lý.
Để phòng tránh, hãy sử dụng một dataset đa dạng với hình ảnh hoặc video từ các camera và môi trường khác nhau, đồng thời xem xét cẩn thận dữ liệu để tìm các bias ẩn — chẳng hạn như tất cả sample positive đều được thu thập vào một thời điểm cụ thể trong ngày. Phòng tránh rò rỉ dữ liệu giúp các model thị giác máy tính của bạn đáng tin cậy hơn trong các tình huống thực tế.
Điều gì xảy ra sau khi kiểm thử model#
Sau khi kiểm thử model, các bước tiếp theo phụ thuộc vào kết quả. Nếu model hoạt động tốt, bạn có thể triển khai model trong môi trường thực tế. Nếu kết quả chưa đạt yêu cầu, bạn cần cải thiện model. Việc này có thể bao gồm phân tích lỗi, thu thập thêm dữ liệu, cải thiện chất lượng dữ liệu, điều chỉnh hyperparameter và huấn luyện lại model.
Kết luận#
Kiểm thử model nghiêm ngặt — validation trên một phần kiểm thử được giữ riêng, prediction trên hình ảnh thực tế và kiểm tra overfitting cũng như rò rỉ dữ liệu — là yếu tố biến một model được đánh giá tốt thành một model đáng tin cậy. Hãy xử lý các vấn đề được phát hiện trong quá trình kiểm thử trước khi triển khai; khi đó model có nhiều khả năng hoạt động đúng như dự kiến trong môi trường production hơn. Nếu có câu hỏi trong quá trình này, hãy hỏi cộng đồng trên repository Ultralytics GitHub hoặc server Ultralytics Discord.
FAQ#
Đánh giá model đo lường hiệu suất bằng các chỉ số trên một dataset được gắn nhãn, trong khi kiểm thử model kiểm tra cách model hoạt động trên dữ liệu mới, chưa từng thấy và tương tự các điều kiện triển khai. Đánh giá tạo ra các con số như precision và mAP từ một dataset được kiểm soát; kiểm thử cho biết liệu hành vi đã học có được duy trì trong điều kiện ánh sáng, chuyển động hoặc che khuất đa dạng hay không. Xem Kiểm thử model và đánh giá model để biết ví dụ minh họa.
Sử dụng chế độ prediction và truyền đường dẫn thư mục làm
source— YOLO26 sẽ chạy trên mọi hình ảnh trong thư mục và có thể lưu các kết quả có annotation để xem xét. Chế độ prediction không tính các chỉ số; để định lượng hiệu suất trên một tập được gắn nhãn, hãy sử dụng chế độ validation. Cả hai workflow đều được trình bày trong Cách kiểm thử model YOLO26.Đối với các model detection, validation báo cáo precision, recall, mAP50 và mAP50-95, đồng thời lưu các biểu đồ bao gồm confusion matrix và đường cong precision-recall. Để validation trên một phần kiểm thử chuyên dụng thay vì phần
valmặc định, hãy định nghĩatest:trong YAML của dataset và truyềnsplit="test". Xem hướng dẫn về các chỉ số hiệu suất để biết cách diễn giải từng chỉ số.Đối với overfitting, hãy áp dụng các kỹ thuật regularization như dropout, tăng kích thước dataset huấn luyện hoặc đơn giản hóa kiến trúc model. Đối với underfitting, hãy sử dụng model phức tạp hơn, cung cấp nhiều feature phù hợp hơn hoặc huấn luyện thêm epoch. Các dấu hiệu của từng vấn đề và cách khắc phục tương ứng được tóm tắt trong Overfitting và underfitting trong machine learning.
Hãy nghi ngờ có rò rỉ dữ liệu khi hiệu suất trên tập kiểm thử tốt một cách bất ngờ, một feature duy nhất chi phối các prediction hoặc các quyết định của model không hợp lý về mặt trực giác. Phòng tránh bằng cách sử dụng các dataset đa dạng từ nhiều camera và môi trường khác nhau, xem xét dữ liệu để tìm các bias ẩn và xác minh rằng việc chia tập huấn luyện/kiểm thử được thực hiện trước mọi bước xử lý. Xem Rò rỉ dữ liệu trong thị giác máy tính để biết các loại bias thường gặp.
Nếu kết quả đáp ứng mục tiêu dự án, hãy triển khai model; nếu không, hãy cải thiện model trước khi triển khai. Việc này có thể bao gồm phân tích lỗi, thu thập thêm dữ liệu đa dạng, cải thiện chất lượng dữ liệu, tinh chỉnh hyperparameter và huấn luyện lại. Lặp lại quá trình kiểm thử sau mỗi vòng thay đổi để xác nhận các vấn đề đã được khắc phục.